AMR1.0数据集介绍,LDC2014T12

基于DeepSig RadioML 2018.01A的AMR数据集高效预处理与信噪比筛选实战 本文详细介绍了针对DeepSig RadioML 2018.01A这一经典AMR(自动调制识别)数据集的实战预处理方法。文章深入剖析了数据集的内部索引结构,并提供了两种高效提取特定信噪比(如10dB)数据子集的Python方案,包括循环拼接法与布尔索引法。此外,还分享了可直接用于模型训练的、支持信噪比筛选的PyTorch Dataset类构建技巧与性能优化指南,帮助读者从庞大的数据金矿中精准、高效地获取所需样本。 阅读详情

AMR1.0数据集,全称为Abstract Meaning Representation 1.0,是一种用于自然语言处理(NLP)的语义表示方法。AMR的目标是提供一种简洁、明确、与人类理解方式相近的语义表示,以支持各种NLP任务,如问答、机器翻译、文本摘要等。

AMR1.0数据集包含了大量的句子及其对应的AMR标注。这些标注详细描述了句子中的语义信息,包括实体、事件、属性等,并以图的形式进行表示。这种表示方式能够清晰地展现句子中的语义结构,帮助研究人员更深入地理解句子的含义。

AMR1.0数据集的特点在于其语义表示的丰富性和灵活性。与传统的基于规则或模板的语义表示方法相比,AMR能够更准确地描述句子中的复杂语义关系,并且具有较好的可扩展性和可解释性。这使得AMR在自然语言处理领域具有广泛的应用前景。

此外,AMR1.0数据集还提供了丰富的标注信息和工具,方便研究人员进行模型的训练和评估。研究人员可以利用AMR数据集进行各种NLP任务的实验,如语义角色标注、实体链接、情感分析等。通过在这些任务上应用AMR,研究人员可以构建出更加准确、鲁棒的NLP模型,推动自然语言处理技术的发展。

总的来说,AMR1.0数据集是一种重要的自然语言处理资源,为研究人员提供了丰富的语义表示和标注信息。通过利用AMR数据集,研究人员可以深入探索句子的语义结构,推动自然语言处理技术的发展。其文件结构如下:
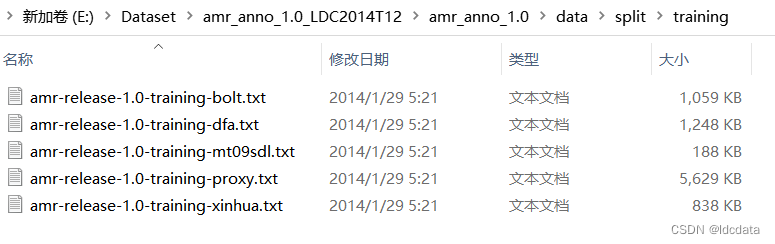
 获取方法:

方法1:注册LDC账号并加入组织获取数据,官网链接:LDC官网

方法2:关注公众号,回复AMR 1.0LDC语料小助手icon-default.png?t=N7T8https://mp.weixin.qq.com/s/8GgZFh9XAr7FYwivQ_ajRg


全网首讲最详细AMR系统介绍(1):Abstract Meaning Representation(AMR) 的基础表示逻辑;附英文版原 pdf 资料 AMR全称,是对语言的一种表示方法,他并不表示单个的句子,而是着重表示句子中的逻辑,也就是说他不存在语法和单词的概念,只有和concept的概念,多个concept之间被连接起来,当然为了方便理解,你也可以认为concept就充当了单词的角色,而充当了语法的角色,但是不要仅限于这种想法,否则不利于后面的理解。AMR在句子中捕捉“谁在对谁做什么”。每个句子都表示为一个有根、有向、无环的图(graph),在边(每条边代表一个语义关系) 和叶(每个叶子节点代表一个concept) 都有标签。 阅读详情

相关推荐

NLP 自然语言处理数据集 粗略

收集匆忙,并不保证准确 dataset index dataset Abbreviation task note 1 LiBriSpeech Automatic speech recogniton 2 WSJ Automatic speech recogniton 3 Hub5’00 Evaluation Automatic speech recogniton ...

DarrenXf的专栏 3841

ACL 2019 - AMR Parsing as Sequence-to-Graph Transduction

我们提出了一个基于注意力的模型,将AMR解析视为序列到图的转导。与大多数依赖于预训练的对齐器、外部语义资源或数据扩充的AMR解析器不同,我们提出的解析器是无对齐器的,并且可以用有限的标记AMR数据对其进行有效训练。我们的实验结果在AMR 2.0(LDC2017T10上为76.3%F1)和AMR 1.0(LDC2014T12上为70.2%F1)方面均优于所有先前报道的SMATCH评分。

qq_45041871的博客 1398

AMR解析器:CAMR的使用

1.28行左右的变量path_to_model改为'./bllip-parser/models'创建输入数据文件input.txt。执行以下文件得到input的预处理文件。需要修改camr-master/depparser.py代码的两个地方。2.在第二行插入# -*- coding: utf-8 -*-会缺少部分依赖,逐个安装即可。这里需要下载一个预处理模型。

m0_62487034的博客 470

大型语言模型的新挑战:AMR语义表示的神秘力量

1. AMRCOT的概念和设计原理AMRCOT是一种基于抽象意义表示(AMR)的NLP任务提示方法。AMR通过提取文本中的关键语义信息(如实体、关系等),为语言模型提供了一种中间语义表示。这种表示旨在帮助语言模型更有效地理解和处理复杂的语言任务。AMRCOT方法通过将输入文本与其对应的AMR一起呈现给预训练的大型语言模型(LLM),来探索AMR在没有模型训练的情况下,对LLM性能的潜在影响。2. 选择的五个NLP任务和数据集:使用PAWS数据集,测试模型是否能识别两个句子是否为同义重述。

math_bearrr的博客 2904

调制信号识别数据集RML2016.10A

调制信号识别数据集RML2016.10A

amr-tutorial:抽象意义表示(AMR)教程幻灯片

amr-tutorial:抽象意义表示(AMR)教程幻灯片

AMR2.0数据集介绍,编号LDC2017T10

AMR2.0数据集常用于文本任务,其文件结构如下:

ldcdata的博客 320

Windows系统下LaTeX环境搭建与编辑器配置全攻略

本文详细介绍了在Windows系统下搭建LaTeX环境的完整流程,包括TeX Live的安装、TeXStudio编辑器的配置优化以及常见问题排查。特别针对中文用户推荐使用清华镜像源加速下载,并提供了XeLaTeX编译器配置、中文支持等实用技巧,帮助用户快速上手LaTeX文档编写。

weixin_42554408的博客 449

深入解析AMR系统(1):Abstract Meaning Representation(AMR) 的图结构与语义关系构建

本文深入解析了抽象语义表示(AMR)的核心机制,重点阐述了其如何通过有向无环图结构,剥离表层句法,构建深层语义关系网络。文章以OntoNotes项目为基础,详细剖析了概念节点、语义关系边(如:ARG0、:ARG1)以及变量共享等关键要素,揭示了AMR在表示句子逻辑骨架和事件链方面的强大能力,为自然语言理解提供了本质视角。

vodka的博客 878

超实用!VS Code配置C/C++开发环境全攻略

本文提供了一份详细的VS Code配置C/C++开发环境全攻略。从MinGW-w64编译器的选择与安装,到VS Code核心扩展的配置,再到tasks.json构建任务与launch.json调试环境的设置,手把手指导初学者完成从环境搭建到高效开发与调试的全过程,帮助开发者快速上手C/C++项目。

weixin_28829479的博客 184

线性代数——(期末突击)行列式(上)-行列式计算、行列式的性质

简单解释一下:4213原本的顺序应为1234,对于‘4’而言,‘2’、‘1’、‘3’都应该排在它的前面,所以此处记逆序数为3;对于‘2’而言,‘1’应该排在它的前面,而‘3’排在它之后 是合理的,所以此处只有一个逆序数;最后看‘1’,其后面的‘3’排在后面显然也是合理的,故而4213的逆序数为4.一般我们使用这个性质来计算四阶行列式,也就是将其变换成三角行列式,再计算对角线的值;以主对角线为分界线的就为正三角,反之则为反三角行列式。若行列式某一行(列)为0,则该行列式=0.将和的那一行分开,其余行。

li13437542099的博客 1万+

利用AMR进行摘要式文本综述

Toward Abstractive Summarization Using Semantic Representations Liu, F. , Flanigan, J. , Thomson, S. , Sadeh, N. , & Smith, N. A. . (2018). Toward abstractive summarization using semantic represe...

易火九天的博客 4874

AI应用架构师:引领半导体良率AI预测的变革浪潮

在半导体行业这个技术密集、资本密集且竞争异常激烈的领域,良率是决定企业盈利能力的关键指标。每提升1%的良率可能意味着数亿美元的利润增长。然而,随着制程节点不断缩小至3nm、2nm甚至更先进水平,传统的良率管理方法已难以应对日益复杂的制造流程和指数级增长的数据量。本文将深入探讨AI应用架构师如何成为这场变革的核心驱动力,通过设计和实施先进的AI预测系统,将半导体良率预测从传统的"事后分析"转变为"事前预测"和"实时优化"。

AI大模型应用之禅 403

论文阅读之:基于序列列到到序列的中文AMR解析;Chinese AMR Parsing based on Sequence-to-Sequence Modeling

本文使用中文 AMR 语料库 CAMR1.0 采用 seq2seq(Transformer)的方法进行中文AMR语义解析本文中文AMR语义解析方法最优性能达到了70.29的Smatch F1值。本文是第一次在该数据集上报告实验结果。

qq_42902997的博客 1105

一文告诉你:如何在trae中编译运行STM32程序,并让AI帮你修改代码

本文详细介绍了如何将STM32程序从Keil迁移到国产免费工具Trae,并利用AI进行代码修改的全过程。

水滴爬呀爬 4881

用 C# 快速构建一套可扩展的上位机框架(实战+源码思想)

本文介绍了一套基于C#的工业上位机开发框架设计方案。该框架通过模块化设计解决了上位机开发中的常见痛点,包括协议适配、通信管理、UI绑定等问题。核心架构采用分层设计,包含协议接口层、调度器层、通信抽象层和UI层,支持MVVM模式。框架提供了协议插件化扩展能力,通过JSON配置实现设备协议定义,同时封装了日志管理、异常处理等基础功能。该方案具有快速搭建、协议驱动、UI分离等特点,可显著提升上位机开发效率,适用于串口、TCP等多种通信场景,并能快速适配新设备协议。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 884

AMR 3.0数据集,官网编号LDC2020T02

同时,AMR 3.0还引入了一些新的数据源,如来自《伊索寓言》的句子、LDC为DARPA LORELEI计划开发的并行文本和情境框架数据集,以及维基百科中有关命名实体的文章的主要句子等,进一步丰富了数据集的语义内容。这个数据集的目的是提供一个统一的、跨语言的语义表示框架,以便更好地理解和分析自然语言文本的含义。在标注方式上,AMR 3.0采用了一种基于图的表示方法,将文本中的概念、关系和属性等信息以图的形式进行表示。需要注意的是,AMR 3.0数据集的使用需要遵守相关的授权和许可协议。

2301_78524903的博客 558

工业级C#+YOLOv8缺陷检测系统:准确率98.5%、延迟<50ms的完整实现

本文分享了基于C#和YOLOv8的工业级表面缺陷检测系统实现方案。针对汽车零部件冲压件检测需求(60件/分钟,准确率>98%,延迟<100ms),作者对比了多种技术方案后选择了C#+YOLOv8+ONNX Runtime的组合,最终实现98.5%准确率和42ms延迟。 系统采用分层模块化架构,包含硬件层、采集层、推理层、业务层和控制层。核心优势包括:1)C#在工业环境下的稳定性和集成便利性;2)YOLOv8对复杂缺陷的泛化能力;3)ONNX Runtime GPU加速提升性能。文章详细介绍了硬件

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1138

NLP语义技术演进:从DP依存句法到SDP依存语义再到AMR抽象语义分析概述与开源实现...

每天给你送来NLP技术干货!作者:刘焕勇来自:老刘说NLP在上一篇文章《事件Schema生成必读:一种基于AMR与聚类、映射的事件模式生成框架浅析》中,我们讲到了AMR以及依存句法分析在分析触发词与论元之间的关系时所发挥的作用。当前,语义分析正在从浅层分析到深层分析转变,与此对应的语义分析技术也逐步发生变化,从最开始到句子成分分析,到依存句法分析,到语义角色标注再到依存语...

zenRRan的博客 3451

RAG面试内容整理-8. 文档分块策略(滑动窗口、语义切分)

RAG系统通常面对长文档或整篇知识库资料的检索需求,但大模型一次处理的文本长度有限,向量索引也需固定大小的文本片段。因此,将长文档拆分成合适片段是必不可少的步骤,被称为文档分块(chunking)策略。

不务正业的猿 690

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

CAMR1.0数据集介绍,编号LDC2019T07

AMR是一种基于图的语义表示方法,旨在捕获句子的完整意义,而不仅仅是其句法结构。CAMR1.0数据集为中文的自然语言处理研究,尤其是语义理解和生成任务,提供了宝贵的资源。通过在该数据集上进行模型训练和评估,可以验证和改进语义理解和生成技术,推动中文自然语言处理技术的发展。同时,CAMR1.0数据集也为其他相关任务,如问答系统、信息抽取等提供了有价值的语义资源。每个AMR标注都是一个有向无环图(DAG),图中的节点代表概念(如实体、事件、属性等),边代表这些概念之间的关系。

ldcdata的博客 224

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

基于深度学习的自动调制识别(含代码链接)

AMR领域具有代表性的和新模型在四个不同的数据集(RML2016.10a, RML2016.10b, RML2018.01a, HisarMod2019.1)上的实现,为感兴趣的研究人员提供统一的参考。

qq_40935157的博客 2万+

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

AMR音频格式分析

AMR音频格式分析

健健的博客 2574

amr 数据格式

参考文章 大牛博客 转载于:https://www.cnblogs.com/eat-too-much/p/8315721.html

weixin_34159110的博客 409

数据集和预训练模型

ImageNet曾是一个计算机视觉研究项目:(人工)打标签并分类成22000个不同物品种类。然而,当我们在讨论深度学习和CNN的时候,“ImageNet”意味着ImageNetLarge Scale Visual Recognition Challenge,图像网络大规模的视觉识别挑战,简写为ILSVRC。   ILSVRC的目的是训练一个能够正确识别图像并分类(1000种)的模型:模型使用约120万张图像用作训练,5万张图像用作验证,10万张图像用作测试。

小麦粒的Python 6787

AMR 文件解析及编解码流程

CONTENT:         *  AMR简介          * AMR 话音质量评定           * AMR 文件结构解析            * AMR 帧结构解析             * AMR 帧读取算法              * AMR 解码原理及流程               * AMR 模式选择自适应机制               一、A

xiangjai的专栏 3523
上一篇: SWB数据集介绍,编号LDC97S62
下一篇: CAMR1.0数据集介绍,编号LDC2019T07
ldcdata
博客等级 码龄3年 81粉丝 26原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值