用Dynamic chunk去干掉tokenizer?

大模型架构实战解剖:MLA、动态剪枝与协议感知Tokenizer 大型语言模型(LLM)架构已从单纯堆叠参数转向深度适配应用场景的技术范式。其核心原理在于对计算路径、内存访问模式与应用协议接口的协同优化:MLA通过分层KV缓存降低显存压力,Dynamic Token Pruning以重要性评分实现推理时的实时注意力裁剪,而协议感知Tokenizer则将Tool Call、RAG锚点等业务语义直接编译进词表。这类设计显著提升长文本处理效率、工具调用鲁棒性与RAG召回精度,广泛应用于智能客服、金融研报生成、工业故障诊断等需高确定性交互的生产场景。本文聚焦可落地的架构细节,解析 阅读详情

Image

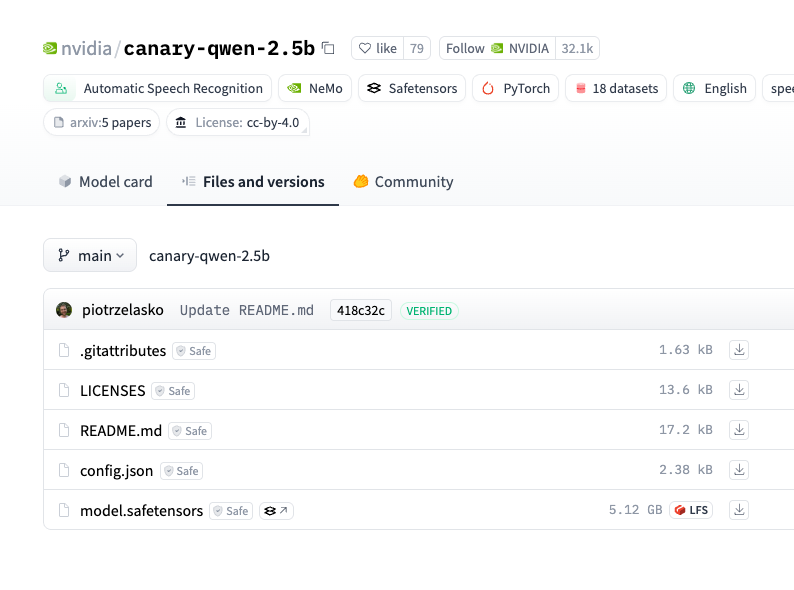
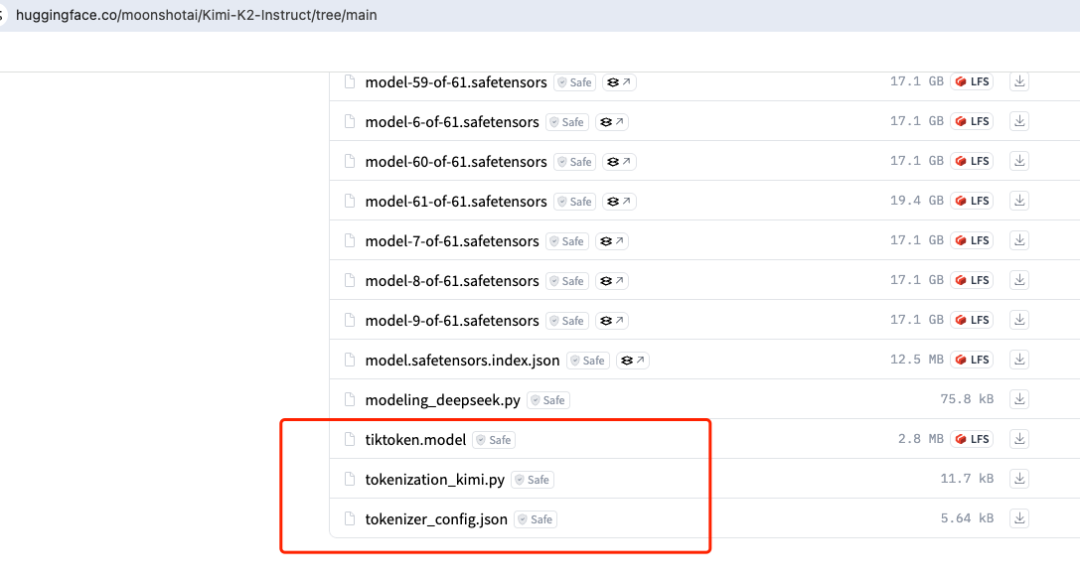
一般你们下AR模型的时候,都有这个,也就是tokenzier,tokenizer是干啥的,其实就是你的分词字典
Image

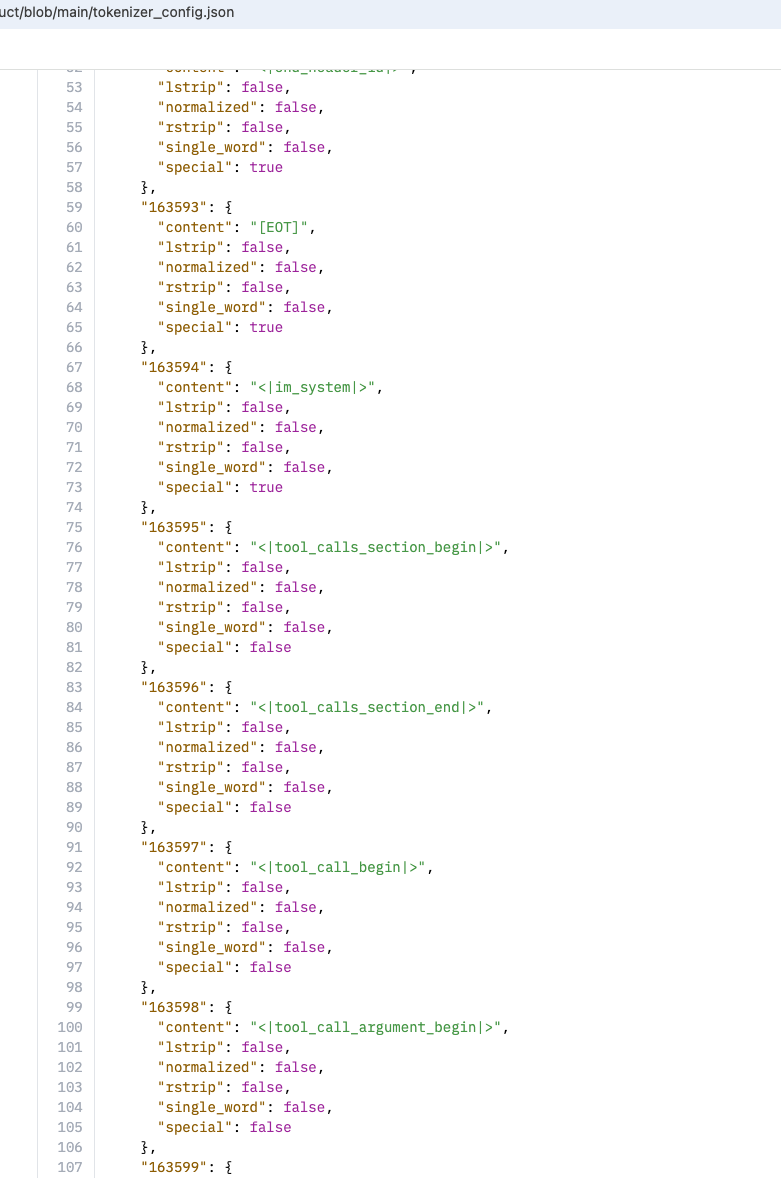
不光有specal的token对应的还有实际的对应的分词对应的代码,比如:
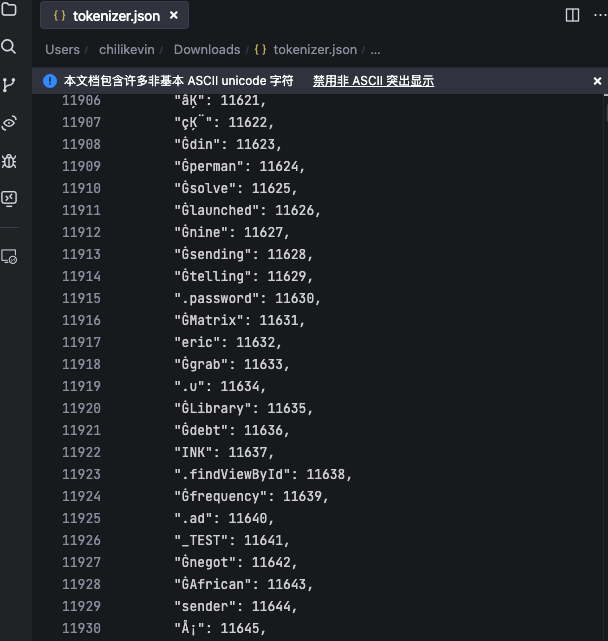
Image

也有tokenzier没显示的,比如,

Image

为什么呢?

因为它不是文本模型

Image

,人家输入是声音,因为它是ASR

扯远了,回归主题

tokenizer之所以总是个独立的model,因为它和transformer

不是一个网络,它也不参与transformer训练时候的反向传播(和embedding层两回事,embedding参与BP和学习),也不共享参数(其实问你为什么没关系,你记住这点就够了)

一个正常的流程是这样的

传统自回归文本模型(如GPT/Llama)

训练时流程:
原始文本 → tokenizer切分 → token id序列 → embedding → Transformer → 输出概率/预测下一个token

推理时流程:
文本 → tokenizer → token id → embedding → 模型生成token id → detokenizer(还原文本)

这个沿用了多少年的架构的有什么问题吗?

其实是有的

静态分词:只能预定义/规则分割,不随语境、下游任务改变;

词表对非英文、代码、特殊字符等不友好,多语言/新词适应性差;

字符错位/扰动很容易破坏下游表现(比如 misspell、空格丢失等,鲁棒性差);

tokenizer/vocab词表一旦定型,后期无法弥补缺失、替换麻烦。

造车上面那几个问题的原因:

1. 词表构建机制决定的“偏见”和局限

  • 大部分主流tokenizer(BPE、WordPiece等)是基于英文语料统计频率自动生成“片段” (tokens/subwords),词表中每个条目是按常见性排序和合并出来的。

  • 这会导致词表里绝大多数都是英语常用词、前缀、后缀,以及特殊分隔符,对别的语言(中文、阿拉伯文、俄语)、编程代码、emoji、数学符号等覆盖不全,兼容性低。

2. 非英文/多语言适应困难

  • 词表是静态的且容量有限,比如GPT-2的vocab仅5万-6万个而已

    。英文组成大都在其中,其他语种即便包含,也非常零散或拆分得特别碎。

  • 比如中文,往往被拆成单字(明/天/去/看/书),或者出现大量 UNK(未登录词)或‘##’前缀的生僻合成,而不是自然分词和表达。

  • 罕见符号/扩展字符/emoji/古文字等,因为词表没收录,只能用char级别或fallback(拆为u8字节)编码成很多token,表达效率极低。

3. 新词/热词/代码/专业类token的弱势

  • 领域专有名词(如新科技名词、代码单词、化学式等)未进入初始词表时,只能被拆为很多“字符”或“常出现的前缀/后缀”碎片,模型难以捕捉其整体语义;

  • 代码文本常见变量、内置语法结构、斜杠点等符号,传统tokenizer未专门优化,往往拆的四分五裂,远不如直接字符/字节级处理。

4. 多语言词表扩展的工程复杂性

  • 为了多语言LLM,多数方案要显式加大词表,或多人手动挑选token,但词表容量越大,embedding参数爆炸,推理速度也会下降,说到扩词表,比如4o当时上市的时候都干到15万左右了,大家还觉得它整挺好,它其实非常无奈,完了为了维护多模态,又得压缩,导致一个长词对应一个token id,才有了那时候的一些小bug,感兴趣的各位自己去找当年的新闻。

  • 有些词永远用不上,冗余空间浪费;而新加入的热词又需要重新训练embedding才能学出属性。

这时候如果有兄弟玩过LSTM可能会一起来,早起是没有tokenizer,也没BPE这玩意的,最早是char-level来建模(注意是最早,LSTM也有token level)

char-level (字符级) 建模,是指模型的输入输出都是“字符”,比如 ["m", "o", "d", "e", "l"],或者直接处理字节(每个字节一个embedding),其实就是字符映射为 embedding index,适用于玩具任务、OOV高风险任务、小数据集、很早期的英文句子生成等

  • 特点是词表极小(只需覆盖所有常见字符或字节),无须分词器,OOV问题天然不存在,对语种/符号极友好,即使所有中文字、标点都可编码进固定的小字表(7000常用汉字以内都能轻松搞定)

  • 旧的LSTM/char-RNN/ByT5等都是纯char-level(或byte-level)。

那为啥都转去token level去了呢?

语义表达效率低:

汉语一个字的信息含量比英文小,随便一个新词(如“码农”)只能靠“码”、“农”两个单字序列表达,捕捉组合语义难,长依赖seqlen变长。

序列极长:

同长度内容,char-level序列会远比token-level长,计算/内存/推理慢(transformer类模型自注意力时间、显存正比于N^2,当然这个和LSTM没啥关系,线性注意力一直是N)。

模型收敛慢,捕捉高阶结构难:

大段话、句子、专业词都被拆为单字或字节,模型要学会组合成“自然语言片段”需要更多层、更多数据,效率和泛化难度高于“合理分块”的token-level或动态chunking方案。

但是最近有CMU的人给字符level编码翻案
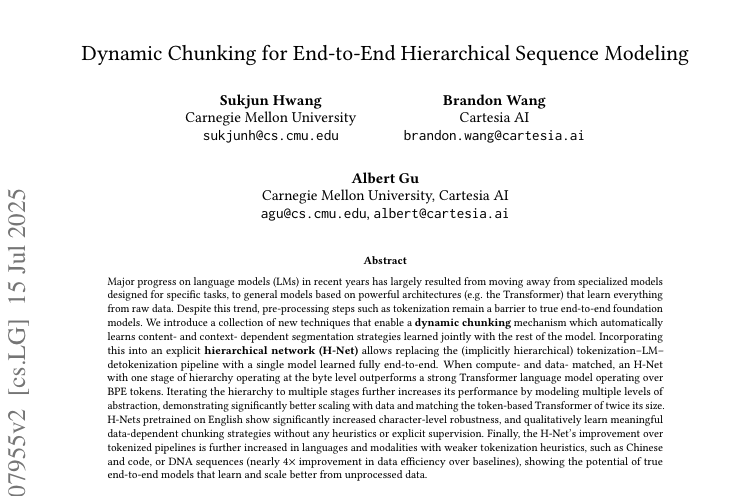
Image

这论文针对的场景就是刚才我们说的tokenizer的问题

分词器本身是手工预处理,对语义、语境缺乏自适应,“一刀切”方式不适合所有语种/信息结构(比如中文/代码/DNA等)。

静态Token也导致模型易受拼写噪声、字符级扰动破坏;跨领域迁移也更难。支持多语言费劲。

所以诞生了dynamic chunk机制(和我自己做的项目dc不是一回事,我那个不是分词和char level的)和H-net
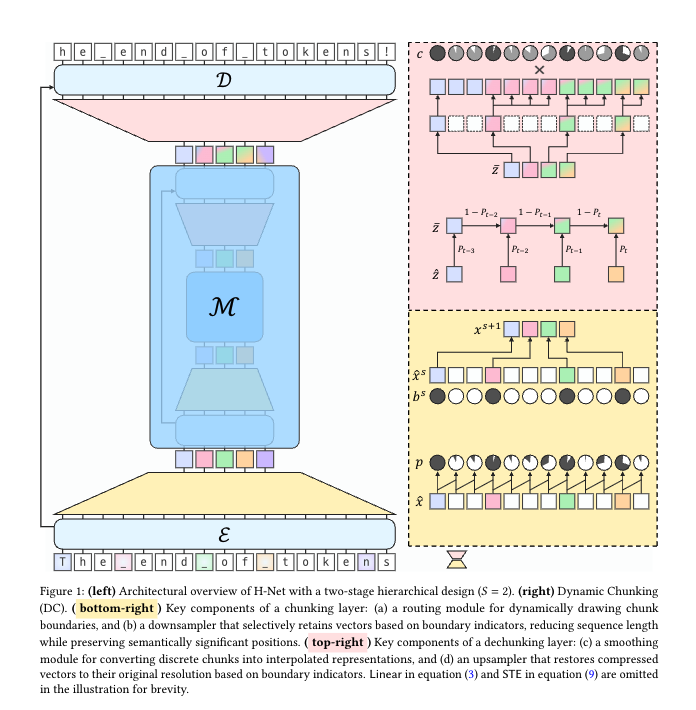
Image

H-Net总体架构

核心思想:创造支持“动态分块机制”(Dynamic Chunking, DC)的层次化神经网络(H-Net),让模型自己端到端学会:哪里是有意义的边界,该怎么自动分段、压缩和聚合输入序列。

1. 架构图如上面的图

流程:

    1. 原始字节输入 (从下面网上面看)→ 编码器(Encoder)做初步字节级embedding(这也可以用Mamba SSM层,线性注意力,当然也可以transformer);

    2. 动态分块模块(DC)

      模型自适应“切片”输入序列,按上下文/内容决定block(被分词的)位置。

    3. 主干网络(Main Network):主要参数集中于此,对已被压缩的chunk序列做深度建模(高语义、长距离依赖捕获)。

    4. 解分块(Dechunking):用上采样/smoothing等方法,将高层chunk输出重新映射回细粒度token,供解码器(Decoder)输出。

2. “分块”与常规分词对比:

常规 Tokenizer:全靠规则/人工预设,只能一分到底。

动态分块DC:模型自动检测上下文变化处(如语法/语义转换),预测边界概率→下采样成chunk embedding序列,高效又自适应。

我们用一个具体例子来说明H-Net的动态分块(Dynamic Chunking,DC)机制是怎么“自动检测上下文变化”并形成chunk的。

示例文本

假设输入文本为:"The end of tokens."

1. 传统tokenizer分割

例如使用BPE等,会直接把它分为
["The", "end", "of", "tokens", "."]

2. H-Net动态分块的流程与输出

第一步:编码各字节/字符

输入会转成:["T", "h", "e", " ", "e", "n", "d", " ", "o", "f", " ", "t", "o", "k", "e", "n", "s", "."]

每个字符/空格/符号作为一个输入位置,初步embedding。

第二步:模型自动“判别”边界概率

H-Net的routing module会对每两个相邻embedding进行相似度测量(比如用余弦相似度),如果发现:

如 ["d", " "](即“单词结束后是空格”)、["s", "."](单词结束遇到句号)等位置,embedding变化大(语法/语义上有明显切换),相似度低,边界概率高!

而像["e", "n"]、“["o", "f"]”等(单词内部连续字母),相似度高,边界概率低。

这样,模型经过训练后,会在如下位置分块边界概率最高(比如):

T   h  e   _   e  n  d   _   o  f   _   t   o  k  e  n  s   .
↑        ↑         ↑             ↑             ↑           ↑
0         0          1             0              0           1

下划线和句号后的边界概率更高

第三步:根据概率做动态分块

H-Net的downsampler会筛选出边界概率超过一定阈值的位置,比如:

  • “The end”作为一个chunk

  • “of”作为一个chunk

  • “tokens.”作为一个chunk

最终分块方式可能是:
["The end", "of", "tokens."]

或者更细粒度:
["The", "end", "of", "tokens", "."](这么分和BPE就一样了)

chunk的大小、边界完全由数据和上下文(而不是手工规则)自动学到,且不同上下文还能灵活变化。

第四步:聚合chunk embedding并继续建模

被判定为一个chunk的所有原始字节embedding会聚合(池化/加权等方法),形成一个chunk级higher-level embedding,进入主干网络进行高抽象推理,这快就不用讲了,因为已经进transformer了

打个比方:

  • 像是在读句子的时候,你发现“这里信息切换了,和下文关联对有区分了”就自动切一刀,把前面的归为一个高抽象信息块。如果连续的内容没变化(比如单词内),就不分块。
  • 你给模型的任何输入,不论语言、结构、符号,只要数据里有“信息变化点”,就可能自动形成chunk。

再举极端对照例子

  1. "I love applepie"

    普通tokenizer:["I", "love", "apple", "pie"],这就分错了呗,分成了 apple and pie

    H-Net:可能["I", "love", "applepie"] 或 ["I love", "applepie"](因为"applepie"常一起出现),这两个分都没毛病

  2. 代码场景:"def run_fast(x):"

    普通tokenizer:["def", "run", "_", "fast", "(", "x", ")", ":"],这么分也比较扯了(当然你们大多数看不见这么差的,是因为代码量大,special token和辅助字符机制让你们不止于碰到这么离谱的,我就是举个例子)

    H-Net:可能["def", "run_fast", "(", "x", "):"],甚至整个函数名+参数合成chunk

所以,动态分块DC让模型“自动发现结构”,而不是简单、固定地分词或分字,大大增强了理解、压缩和表达的能力。

我们最后再做一下流程对比
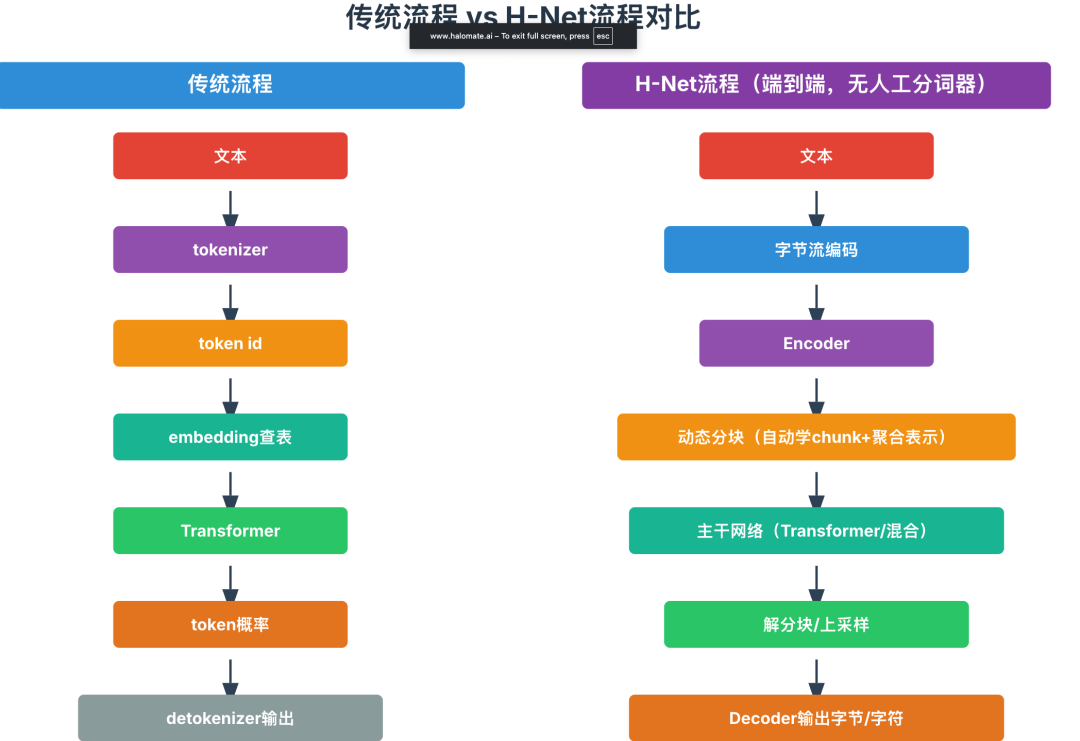
Image

总结一下就是其实就是encoder+dc做了tokenizer的事了,然后上采样+decoder做了softmax到词表的logit

这么一上图就没那么抽象了,至于主干那块其实愿意用trasformer还是ssm,或者mamba甚至混着来(现在不都流行这样吗,隔一层一遍,确实能省掉一部分因为指数注意力造成的算力压力),就看你想怎么折腾了

最后看一下效果:

A. 语言建模主任务(英文+多语言)

1. 验证困惑度/压缩效率(BPB)

H-Net(动态分块)在相同训练数据和算力预算下

1-stage结构已可匹配传统BPE-Transformer的困惑度;

2-stage递归结构大幅超越:

    • H-Net (1-stage): BPB ≈ BPE Transformer

    • H-Net (2-stage): BPB 显著低于同算力BPE Transformer

    • 训练曲线显示,H-Net随数据量增加,性能提升更快,最终收敛值更低(见下图)。
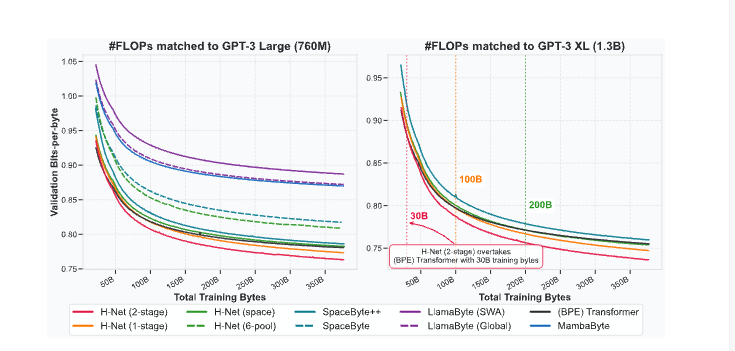
      Image

2. 多语言与代码/DNA建模
  • H-Net对中文、代码、DNA等特殊输入类型展现强大优势,尤其是没有自然token边界的文本数据。

  • 中文建模时,BPB显著优于Llama3/Transformer等多语支持模型。

  • 代码建模同理,chunk压缩率更高,表现优于词表法。

  • DNA建模 性能提升极大,数据效率比等参数Transformer高3.6倍(可用更少数据达到同样困惑度)。

B. 下游通用任务表现

大规模zero-shot评测在LAMBADA、HellaSwag、PIQA、ARC-e、ARC-c、Winograd、OpenBook等七大benchmark任务上,H-Net(2-stage)平均分比传统BPE Transformer高2%~3% 
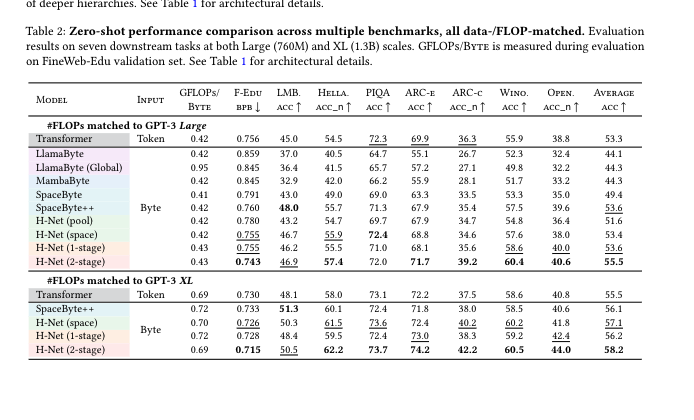
Image

对比Mix-of-Experts(MoE) 、SpaceByte、LlamaByte等各种优化方法,H-Net也依然表现胜出,这里吐槽作者为什么方MOE,不过页能理解,虽然不是一个层面的,但是,也都是优化手段,姑且理解为主干(FFN)稀疏vs压缩冗余吧, 反正它敢比,我就敢把这个也粘过来了

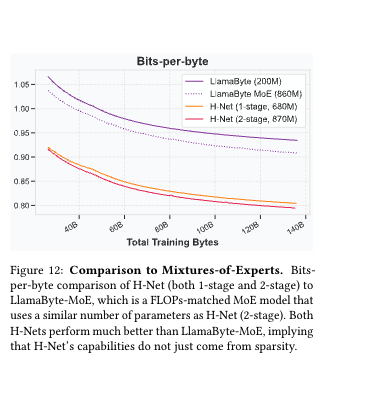
Image

Image

C. 鲁棒性和泛化能力

抗文本扰动鲁棒性:在HellaSwag的五种perturbation(如随机大小写、字符重复、丢drop、混乱语法)测试下,H-Net鲁棒性-平均准确度远超过BPE Transformer和所有对照组。

可解释性更强:Chunk边界分布可视化表明模型学出的边界多能对应词/短语/语法块,而不是简单机械分词。
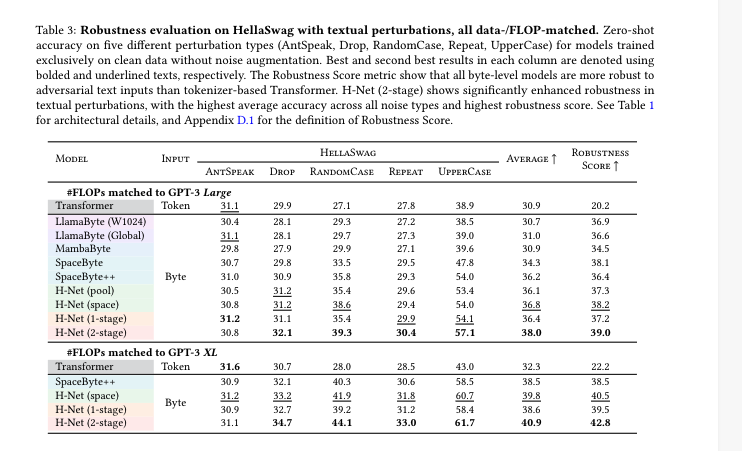
Image

D. 数据/计算效率

同样训练数据和FLOPs下,H-Net能用更少数据、更少算力达到等同或更优效果,尤其在"hardcase"领域(如代码/DNA/多语种)差距巨大。

总之还成,我为什么讲这个呢,因为现在大家都在反transformer架构,但是也不能光喊口号,这个至少做出了一部分的关键工作(虽然tokenizer不属于transformer,但是它也是现在网络的基础啊),如果你把主干全换成ssm类的比如mamba,那就彻底告别现在的网络了,不过我觉得从主流视角看,这类的工作至少还要5年,因为transformer本身也都在外围进行线性化的优化,而transformer非线性的部分的attention短期我没看到能被取代的可能性。

DeepSeek-V3-0324推理全链路实战:Tokenizer校验、vLLM定制与OpenAI兼容服务 大语言模型推理服务不是简单调用generate(),而是涉及模型加载、分词器对齐、推理引擎适配、流式响应与监控的系统工程。DeepSeek-V3作为典型MoE架构大模型,其0324版本在expert routing(top-k gating)、rope_theta(1000000)、eot_token_id(128049)等关键参数上存在细微但决定性差异,直接导致token错位、语义断裂与静默错误。本文聚焦开源大模型本地化部署的核心痛点,以DeepSeek-V3-0324为实例,详解tokenizer深度验 阅读详情

相关推荐

Jamba混合架构:SSM+Transformer长上下文高效推理方案

长上下文大模型推理面临显存爆炸、延迟高、成本不可控等核心瓶颈,其根源在于传统Transformer的O(n²)全局注意力在长文本中存在大量低贡献计算。结构化状态空间模型(SSM)凭借O(n)线性复杂度与强序列建模能力,成为优化长程依赖的关键技术路径;而Transformer在局部精细交互上的优势仍不可替代。Jamba通过分层路由、状态缓存与动态卸载等工程设计,实现SSM主干道与Transformer立交桥的工业级协同,在128K上下文任务中显著降低显存占用与推理延迟。该范式不仅适用于法律、金融、医疗等专业长

cumo7370的博客 629

RAG中chunk size设计实战:从文档类型到检索精度的工程化决策

在RAG(检索增强生成)系统中,chunk size并非简单调参项,而是直接影响retrieval accuracy、latency与fault tolerance的核心预处理参数。其本质是平衡语义完整性与信息密度的技术选择:过小导致embedding稀疏、召回噪音多;过大则淹没关键特征、破坏上下文连贯性。真实生产环境要求摒弃‘通用最优值’幻觉,转而基于文档类型谱系(如定义型、流程型、规则型)、用户查询模式(原子/组合/模糊查询)、LLM上下文窗口约束及基础设施硬限(向量库内存、batch推理效率)进行场景

weixin_30938149的博客 382

Gemma 4架构深度解析:字节级访存优化与端侧推理新范式

大语言模型的推理效率瓶颈正从算力转向内存带宽与缓存局部性——这是Transformer架构演进进入编译器级、指令集级重构阶段的核心标志。Gemma 4通过字节对齐的KV Cache调度、动态稀疏注意力(DSR)和BytePair Tokenizer++等底层创新,显著降低显存占用与长序列延迟,使INT4甚至2-bit量化在边缘设备上具备工程可行性。其技术价值不仅体现于树莓派5跑通4B模型、Jetson Orin token生成提速80%等实测指标,更在于为教育硬件、工业质检、本地知识库等低资源场景提供了可落

weixin_33704234的博客 596

LSTM项目中tokenizer分词器优化实践:提升NLP模型性能的关键技术

在自然语言处理(NLP)领域,文本分词是预处理的核心环节,直接影响模型对语义的理解能力。分词器(tokenizer)的工作原理是将原始文本切分为有意义的单元,如词、字或子词,为后续的序列编码提供基础。通过优化分词器,能够显著提升模型在特定领域的表现,特别是在处理专业术语、网络用语等复杂场景时。LSTM作为经典的序列模型,对分词质量高度敏感。本文基于Hugging Face Tokenizers等工具,详细演示了如何通过定制化分词器来改善LSTM模型在文本分类和情感分析任务中的性能,涵盖分词粒度选择、词汇表管

weixin_34221036的博客 573

DeepSeek V4生产避坑指南:DMXAPI五大默认陷阱与实战对策

大语言模型API升级不是简单替换模型,而是涉及token计费逻辑、system prompt处理机制、流式响应解析、function call Schema校验和会话缓存一致性等底层协议变革。DeepSeek V4通过DMXAPI暴露了这些关键差异,其语义块加权计费、独立system字段、JSON流式chunk、强Schema预验证及session-aware缓存等特性,显著区别于OpenAI兼容接口。这些变化直接影响成本控制、角色设定稳定性、前端解析健壮性、工具调用成功率和长流程响应延迟。本文聚焦真实生产

weixin_30530339的博客 787

TOON vs JSON:LLM时代的数据序列化新范式

序列化是大模型数据流的关键协议层,其设计直接影响推理延迟、部署鲁棒性与系统可观测性。JSON作为通用结构化格式,在LLM场景中面临token语义丢失、注意力掩码歧义、位置编码隐式推导等结构性失配;而TOON(Token-Oriented Object Notation)以token为一等公民,通过tids版本化ID序列、mask行为化掩码定义、pos显式位置契约等机制,实现‘解包即用’的低开销解析。该范式显著降低首token延迟(TTFT)、增强RAG与量化部署一致性,并支撑trace_id驱动的端到端故障

weixin_30628801的博客 342

Claude Opus 4.7升级深度解析:Tokenizer重构、Effort控制与视觉能力跃迁

大语言模型的推理能力演进正从‘更聪明’转向‘更严谨’——这背后是底层tokenizer编码逻辑、认知资源调度机制(effort/task budgets)和多模态理解能力的系统性升级。以Claude Opus 4.7为代表的新一代模型,通过细粒度语义切分提升中文与代码理解精度,引入可编程的effort档位实现推理深度可控,并支持2576像素级图像输入,使AI首次具备像素级诊断与跨模态因果推断能力。这些变化不仅影响API调用成本与延迟,更重塑了提示工程、代码审查、UI缺陷追踪等核心开发工作流。本文聚焦Opus

weixin_33728268的博客 396

Ubuntu图形界面崩溃?从tty到GUI的终极修复指南

本文提供了Ubuntu图形界面崩溃后进入tty的终极修复指南。详细介绍了如何诊断显示管理器(如LightDM或GDM3)状态,并通过重装、切换显示管理器、修复依赖、系统升级及排查显卡驱动等核心方案,逐步恢复GUI。帮助用户从命令行界面高效修复桌面环境,避免数据丢失。

vulkan6gpu的博客 778

RAG系统文本分割优化与LangChain分割器实战指南

文本分割是构建高效RAG(检索增强生成)系统的关键技术,直接影响检索精度与生成质量。其核心原理是通过合理划分文本块,平衡语义完整性与检索效率。在LLM处理中,过大的文本块会超出模型上下文窗口限制,而过小的碎片则丢失关键上下文。LangChain提供的CharacterTextSplitter、RecursiveCharacterTextSplitter和TokenTextSplitter等工具,可针对不同场景实现智能分割。其中RecursiveCharacterTextSplitter通过分层递归策略,在保

weixin_30780649的博客 367

51单片机IAP在线升级

51单片机IAP在线升级 爱矽半导体E85F3325单片机IAP在线升级教程,此处可查看更新及demo下载 文章目录前言一、ROM资源二、KEIL有关知识1.BL51连接器:2.LX51连接器:三、Keil其他相关项说明:四、MCU启动文件说明:五、例程BOOTLOADER使用说明六、例程使用可更改说明:七、程序使用通信方式:XMODEM八、APP程序说明九、APP代码升级说明十、代码合并烧写 前言 扩展-IAP 主要用于产品出厂后应用程序的更新作用 ,类似于其他引导装载升级程序的方法,在系统中必须始终

qq_42415953的博客 6666

从标准到实战:详解IEC 61000-4-2下的ESD电路防护设计

本文深入解析IEC 61000-4-2标准下的ESD电路防护设计,从静电防护的基础原理到实战应用。详细介绍了接触放电与空气放电的区别、防护器件选型要点(如TVS管和压敏电阻)以及PCB布局的黄金法则,帮助工程师有效提升电子产品的抗静电能力,确保设备在严苛环境下的稳定运行。

weixin_33704234的博客 512

Unsloth Dynamic 3.0:动态优化GGUF推理,让大模型本地部署更高效

大语言模型(LLM)的本地部署常面临显存不足和推理效率的挑战,量化技术通过降低模型精度来减少内存占用,是实现本地运行的关键。其原理是将模型权重从高精度浮点数转换为低精度整数,在保持模型能力的同时大幅压缩体积。这项技术的核心价值在于让消费级硬件也能运行数十亿参数的大模型,推动了AI应用的普惠化。在实际工程中,量化模型(如GGUF格式)需要与高效的推理运行时结合,才能发挥最大效能。Unsloth Dynamic 3.0框架正是针对这一痛点,它通过动态层卸载、自适应批处理等机制,智能管理GPU与CPU内存,根据硬

weixin_34117211的博客 423

从网格划分到端口接地:一份给ADS新手的Momentum RF仿真避坑实操指南

本文为ADS新手提供Momentum RF仿真的实用指南,涵盖网格划分、端口接地、特殊结构处理等关键设置技巧。通过30-50 cells/λ原则、1/10波长限制等黄金法则,帮助用户平衡仿真精度与效率,避免常见错误,提升电磁仿真结果的准确性。

weixin_33692284的博客 505

DeepSeek-V4工程落地实操指南:MoE架构与长上下文部署优化

大语言模型的工程可用性是决定其能否进入生产环境的核心门槛。从基础概念看,MoE(Mixture of Experts)通过稀疏激活提升计算效率,而长上下文支持则依赖于Attention机制的显存与计算边界重构;其技术价值在于平衡高参数量与低延迟、高吞吐与低显存占用;典型应用场景涵盖金融合同审查、制造业知识库、多语言客服及代码智能重构等对中文理解、语义稳定性与实时性有严苛要求的领域。本文聚焦deepseek-v4在真实业务中验证的MoE路由均衡策略、Dynamic Chunked Attention机制及AW

Envisage123 429

【STK】手把手教你利用STK进行进行光电红外仿真02-STK/EOIR模块属性之一 传感器选项设置

EOIR传感器可以从空间几何属性、光谱属性、光学属性、辐射属性四个方面进行设置,并且可以设置信号传播路径中的大气特性,包括大气模型、气溶胶模型、气象学可见性和大气湿度。在定义EOIR传感器时,需要Sensor——Definition属性页中,将Sensor Type设置为EOIR。单击下面的按钮打开传感器的EOIR配置页,可以对传感器的属性进行配置,此外,还可以在场景中视情况添加相关的中心体。路径辐射损耗影响上述特性的计算,计算的结果考虑了传感器、目标位置的影响,但是还没考虑地球临边背景的影响。

weixin_44184852的博客 3199

【AI智能体】Spring AI Tool 从使用到实战详解

Spring AI Tool

congge 5864

大模型文本分块技术:原理、实践与优化

文本分块(Chunking)是自然语言处理中的基础技术,通过将长文本分割为语义完整的段落单元,解决大模型上下文窗口限制问题。其核心原理基于token计数与语义边界检测,需平衡模型计算效率与信息完整性。在工程实践中,分块技术直接影响检索增强生成(RAG)等应用效果,典型场景包括金融文档分析、法律合同审查等长文本处理任务。通过动态调整分块大小、重叠率等参数,结合BERT等预训练模型,可显著提升知识库问答等下游任务准确率。当前前沿发展聚焦语义分块和动态分块算法,工具链涵盖LangChain、NLTK等开源方案。

weixin_30892889的博客 398

基于MUSIC算法的DOA估计Matlab仿真

特别需要指出的是:通道与阵元并不是一一对应,通道是由空间的一个、几个或所有阵元合成的,当然空间某个特定的阵元可包含在不同的通道内。空间谱估计侧重于研究空间多传感器阵列所构成的处理系统对感兴趣的空间信号的多种参数进行准确估计的能力,其主要目的是估计信号的空域参数或信源位置,这也是雷达、通信、声纳等许多领域的重要任务之一。从系统框图中可以清晰的看出,估计空间相当于是对目标空间的一个重构过程,这个重构的精度由众多因素决定,如环境的复杂性、空间阵元的互耦、通道不一致、频带不一致等。

FPGA/MATLAB学习教程/源码/项目合作开发 1747

Qwen3.5-35B-A3B本地部署实战:35B大模型离线推理全链路指南

大语言模型本地部署是保障数据安全、降低延迟、实现可控推理的关键路径。其核心在于平衡显存占用、上下文长度与量化精度三大技术维度。Qwen3.5-35B-A3B作为支持32K上下文的工业级模型,依托A3B自适应分块量化与PagedAttention机制,在消费级双卡4090上实现高吞吐稳定推理,显著优于llama.cpp等传统方案。该模型特别适配医疗合规、教育科研、政企内网等对数据不出域、推理可审计有强需求的场景。本文聚焦真实硬件约束下的部署落地,涵盖FlashAttention-3适配、kv-cache-fp

Envisage123 564

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Qwen3.6-27B为何比Qwen2.5-397B推理更快更稳?

大语言模型推理性能不仅取决于参数量,更由模型架构、KV缓存机制与推理引擎协同决定。稀疏混合专家(MoE)结构通过动态路由大幅降低实际计算量,而KV Cache压缩与RoPE位置编码优化则显著缓解显存带宽压力。vLLM和SGLang等现代推理引擎需针对性适配这些硬件感知设计,否则默认配置反而引发延迟飙升、OOM或token解析错误。本文聚焦Qwen3.6这一典型稀疏大模型,深入解析其MoE激活策略、Tokenizer控制符工程陷阱及长上下文RoPE动态缩放机制,并提供vLLM/SGLang双路径的生产级部署调

weixin_34161083的博客 469

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 蒸馏出个MCP工具箱
下一篇: Agentic-R1 与 Dual-Strategy Reasoning
周博洋K
博客等级 码龄9年 2005粉丝 156原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值