多模态MLLM都是怎么实现的(13)如何保持text2video的连续一致性

CVPR2026l论文整理 来源:筛选日期: 2026-06-13说明: 按标题关键词自动筛选, 同一论文可能命中多个分类。共 511 篇。 阅读详情

这个系列好就不更新了,因为一直也没太惊艳的技术出来,直到这个论文出来:

https://arxiv.org/pdf/2504.16078

感兴趣的读者可以从第一章开始:

https://mp.weixin.qq.com/s?__biz=MzkwMTU3NjYwOA==&mid=2247484530&idx=1&sn=4ac57a2e851c868502c2a965847f5d81&chksm=c0b3e6bdf7c46faba14c0068f09267e0be1bc29fd0929d3da00ae0a79de1104a69160bf1c9b5&token=1015028219&lang=en_US&scene=21#wechat_redirect

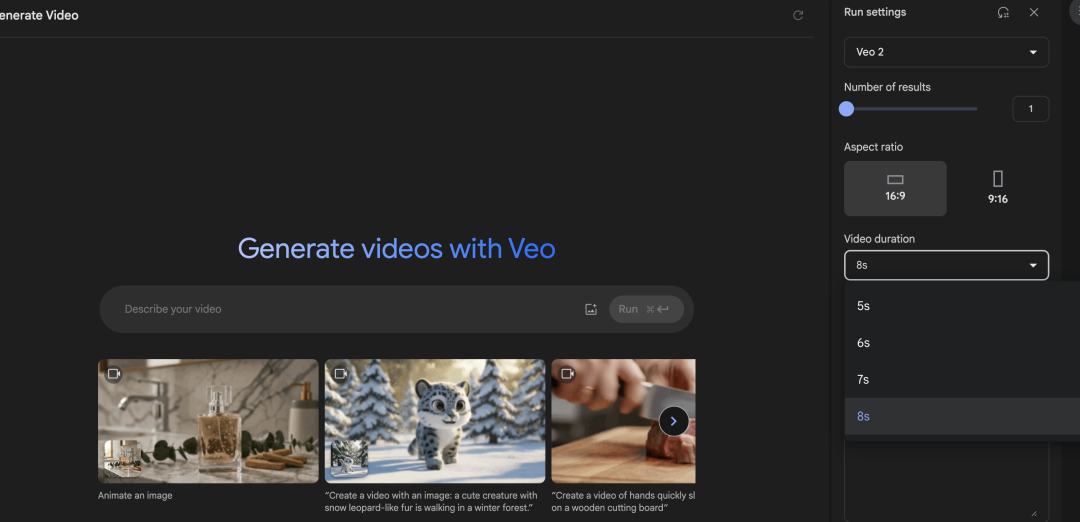
如果你玩过开源的Text2video,也就是文生视频,也会感慨AI越来越能整活儿了,但是如果你好奇去各大平台看一圈,基本上视频最大就是在8-10秒左右,甚至有3-5秒的。(sora能到20秒)
Image

Image

当然有兄弟说是算力的问题,这个确实是一个问题,生成视频diffusion的算力确实要比纯text多,但是这个如果有钱也不是问题(后文我们发现其实就算有钱也是问题),但是现在我们谈论的是钱解决不了的问题,一致性

这个一致性指的是多帧一致性
Image

Image

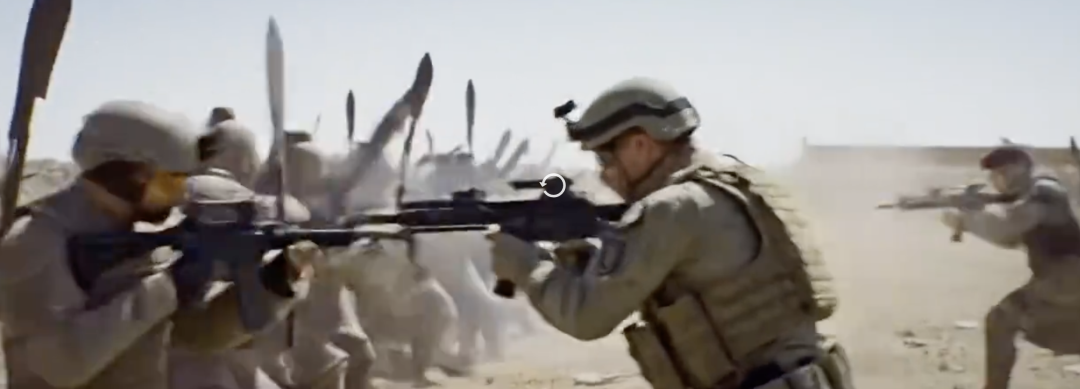
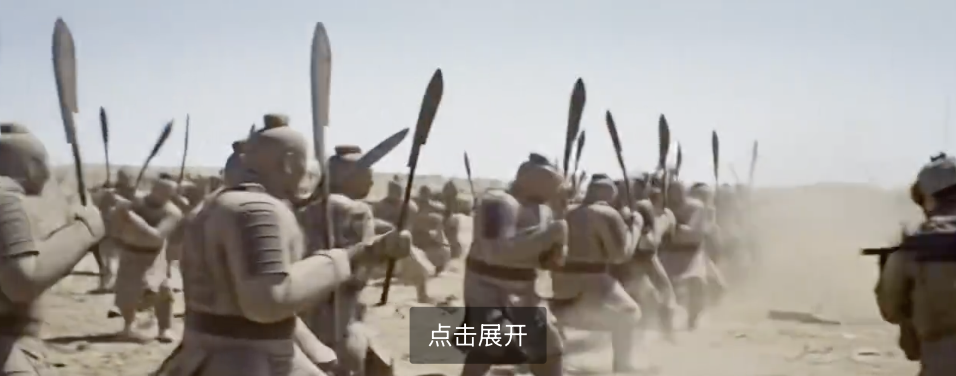
比如这个视频,兵马俑大战美军,打着打着,兵马俑就突然叛变变成美军了

Image

造成这个问题的原因是什么?

首先Diffusion网络是没时间概念的

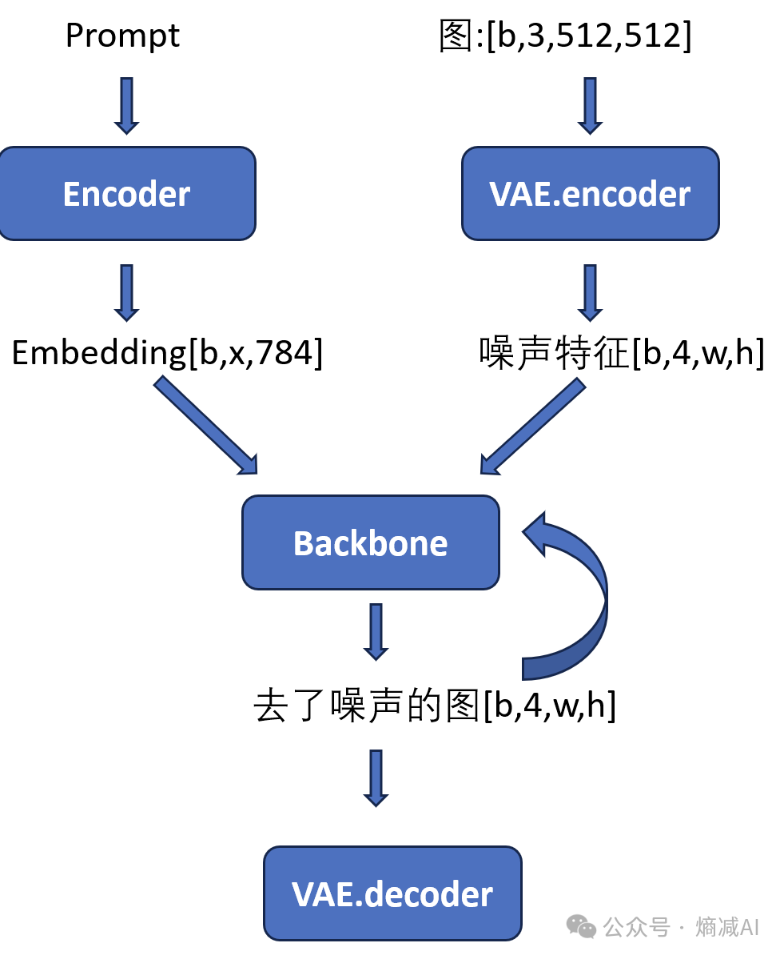
如果是生图可能还行,我们以一个简单的生图的流程来看
Image

这就是一个典型的SD生图流程,通过对比训练的clip embeddding能力,让text的输入隐式包含很多图像的相似性,很好的配合vae编码的latent,这时latent 相当于Q,被clip embedding的text相当于kv,latent再不断去噪声的过程,把text当作参照,也就是按着prompt的指令来生成相应图片位置的object

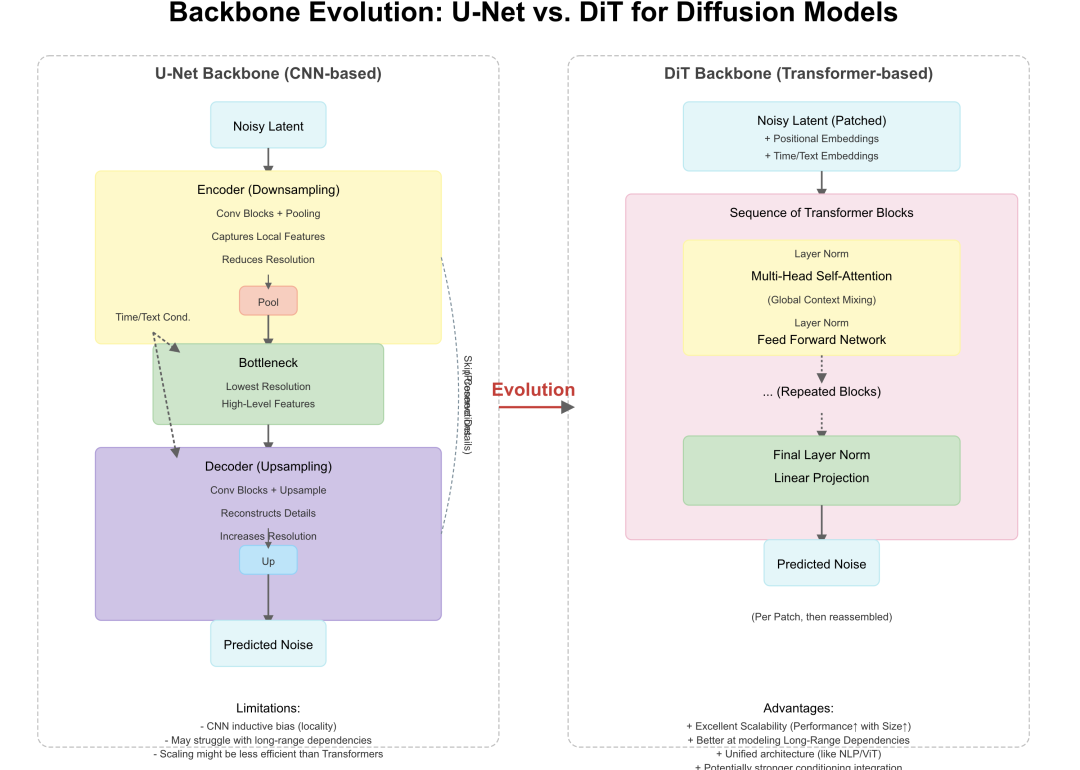
上图的backbone从SD早期的unet一直演化到sd3的Dit,除了扩展性和网络架构变了以外,但是本质并没有改变,文生图的领域是不需要时序信息的
Image

上图由halomate.ai,通过prompt直出

Image

但是这个网络面对生视频怎么办呢?

视频的构成是一系列连续的帧,每一帧之间的动作差距很小,但是一致性是要求强一致的,这就要求网络能感知帧的序列关联性,也可以延伸认为是时许关联性。

可是传统的difussion解决方案,从vae到backbone这两部分的网路都没有时间模块

于是人们考虑先从VAE动手

简单的思路

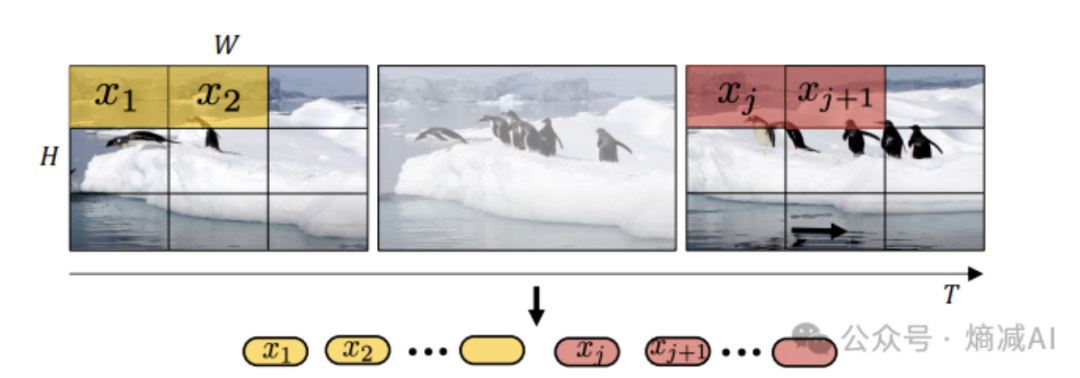
Uniform frame sampling
Image

  1. 原始视频数据 (Top Row): 视频由一系列按时间顺序排列的帧组成(时间轴 T 从左到右)。图中展示了视频中的三帧,但实际上视频包含更多帧。

  2. 帧采样 (Implicit Step): 虽然没有明确画出“丢弃”的帧,但“Uniform Frame Sampling”这个名字意味着我们不是使用视频中的所有帧。而是按照一个固定的时间间隔(比如每隔 k 帧取一帧,或者每秒取 f 帧)来选择一部分帧。图中展示的第一帧和最后一帧(包含 x1, x2 和 xj, xj+1 的那两帧)就是被采样出来的帧,中间的那帧可能就被跳过了(或者它也是被采样出来的,只是没有突出显示其 patch 而已,但均匀采样的核心在于选择帧的间隔是固定的)。

  3. 空间分块 (Spatial Patching): 对于每一个被采样出来的帧,将其在空间上分割成 H x W 个不重叠的小块 (patches)。这与 Vision Transformer (ViT) 处理图像的方式类似。图中的 x1, x2, xj, xj+1 就代表这些从对应采样帧中提取出的小块。

  4. 序列化/展平 (Flattening into Sequence - Bottom Row): 将所有采样帧提取出的空间小块,按照时间和空间的顺序(通常是先时间,再空间,即第一帧的所有块,然后第二帧的所有块...)拼接成一个一维的序列。这个序列 x1, x2, ..., xj, xj+1, ... 就是最终输入给 Transformer 模型的 token 序列。

总结就是个帧采样,然后按着时间顺序给展平称一维的向量了。

成熟的思路

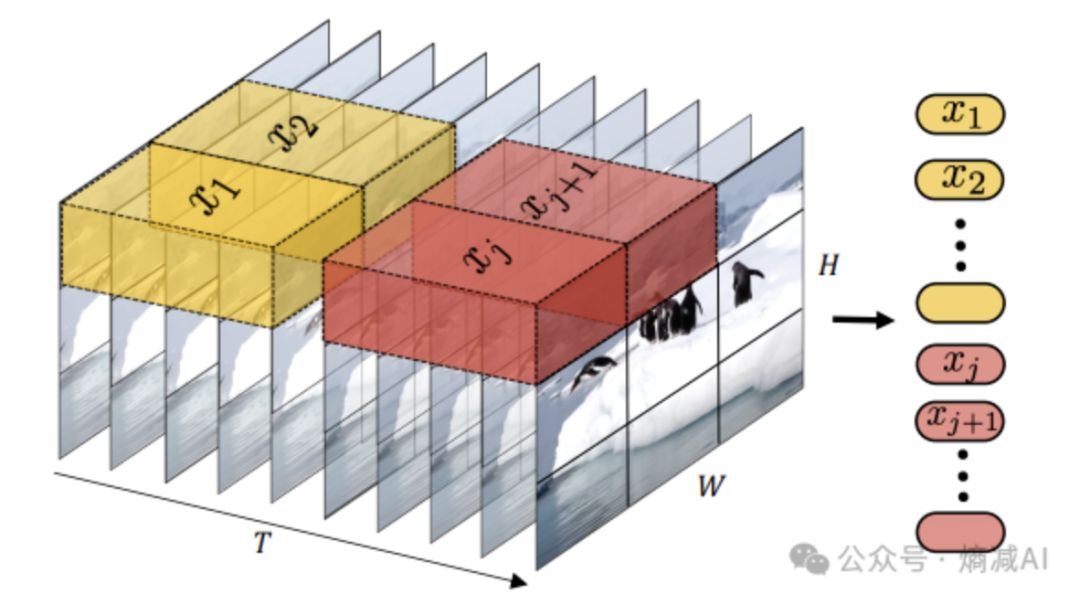
Tubelet embedding
Image

    不同于uniform frame sampling,tubelet embedding可是实打实的每一帧都给利用上

    令牌基础: 令牌 (x1, x2, ...) 是从视频中提取的三维时空块 (3D spatio-temporal patch),通常称为 "Tubelet"。

    • 时间处理:

      • 将视频看作一个 3D 数据体(高度 H x 宽度 W x 时间 T)。

      • 同时在空间(H, W)和时间(T)维度上进行分块。

      • 因此,每个 Tubelet (x1, x2) 本身就跨越了多个连续的帧,并覆盖了一个特定的空间区域。

      • 时间信息不仅体现在令牌的顺序上,还内嵌在每个令牌内部,因为它直接捕捉了短时间窗口内的变化。

    信息单元: 每个令牌携带的是一个短时间段内(Tubelet 的时间深度),某个空间区域的时空视觉信息。它能直接编码局部运动或变化,又因为它是全量的信息,不是采样的,所以效果好。

    但是光靠vae能就能解决时序问题吗?那显然不是啊,因为vae它只管把视频(其实是序列帧,比如clip1,clip2,clip3,每个clip比如15帧,实际上我们训练视频模型也都是把视频切好序列帧喂给模型的)给编解码,它不管加噪去噪啊,这个操作都在backbone来做(目前基本都是DIT变种)

    所以backbone必须有时序感知能力,这是通过什么体现出来的?
    Image

    图片由halomate.ai生成

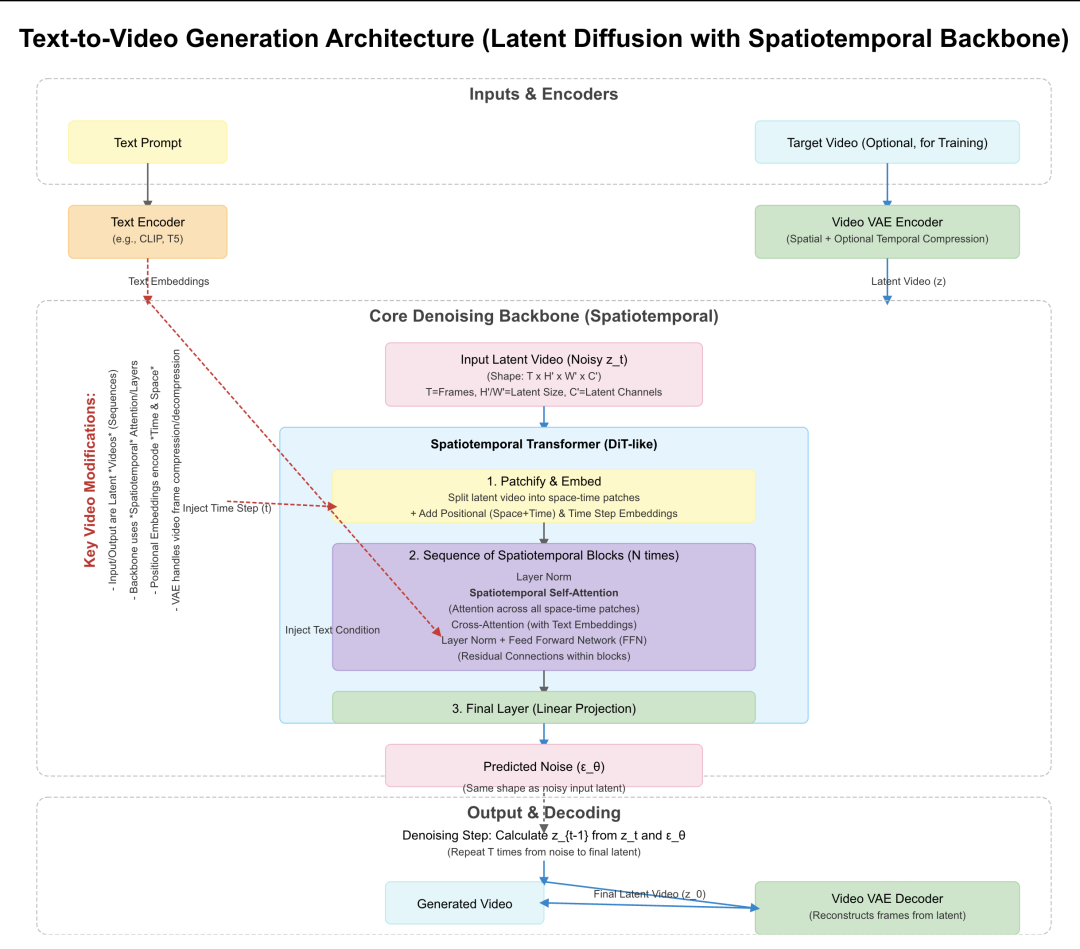
    上图是一个基于 Latent Diffusion Model 思想,并采用 Spatiotemporal Transformer (类似 DiT) 作为核心 Backbone 的文生视频网络架构

    1. 核心思想:Latent Diffusion for Video

     与 Stable Diffusion (文生图) 类似,我们在潜在空间 (Latent Space) 中进行扩散和去噪过程,以大幅降低计算复杂度。

     首先需要一个 Video VAE (Variational Autoencoder用我刚才讲的两种编码方式都可以,但是现在大部分都用tubelet的方式),它能将视频帧序列压缩成低维的潜在表示 (Latent Video),并能从潜在表示中解码回视频帧。这个 VAE 需要在大量视频数据上预训练。

    2. 输入处理:

     Text Prompt: 输入的文本描述通过一个强大的 Text Encoder (如 CLIP 或 T5 的变体,高端的模型来做指令跟随基本都用T5来替代clip了) 转换成文本嵌入 (Text Embeddings)。这些嵌入包含了文本的语义信息,将用于指导视频内容的生成。

     Noisy Latent Video (z\_t): 在扩散过程的每一步 `t`,输入是加了噪声的潜在视频 `z_t`。在生成开始时 (t=T),这是一个纯高斯噪声,其形状与 VAE 输出的潜在视频一致 (`NumFrames x LatentHeight x LatentWidth x LatentChannels`,也就是我刚才说的tubelet,然后再加个RGB通道)。

     Time Step Embedding: 当前的时间步 `t` 被编码成一个嵌入向量,告知网络当前的噪声水平。

    3. 核心 Backbone: Spatiotemporal Transformer (DiT-like)

     关键区别: 与处理静态图像的 Backbone (如标准 U-Net 或 ViT/DiT) 不同,视频 Backbone 必须同时处理空间信息 (每帧的内容) 和时间信息 (帧之间的变化和连贯性)。

     Patchify 和 Embed: 将输入的潜在视频 `z_t` (T x H' x W' x C') 分割成一系列 时空块 (Spatiotemporal Patches)。例如,每个 Patch 可以是 `p x p` 空间区域跨越 `k` 帧。

     Embeddings: 

    1- 为每个 Patch 添加Spatiotemporal Positional Embeddings 来编码每个 Patch 在原始视频中的空间位置 和 时间位置。这是捕捉时空结构的关键。

    2- Time Step Embedding: 告知网络当前去噪阶段,在这就和时序基本彻底关联上了。

    Spatiotemporal Transformer Blocks部分:

    1) Spatiotemporal Self-Attention: 这是核心。注意力机制作用于所有时空 Patch 序列。这使得模型能够同时关注:

    同一帧内不同空间区域的关系 (Spatial Context)。

    同一空间区域在不同时间帧的关系 (Temporal Dynamics)。

    不同空间区域在不同时间帧的关系 (Complex Motion & Interactions)。

    2) Cross-Attention: 将 Text Embeddings 通过交叉注意力机制注入到 Transformer 块中,使得模型能够根据文本描述生成内容和动态。

    3)FFN: 这没啥可说的了,就特征转换用的。

    4)Output: Backbone 输出预测的噪声 `ε_θ`,其形状与输入的 `z_t` 相同。

    4. 去噪过程与输出:

     使用预测的噪声 `ε_θ` 和当前的噪声潜在视频 `z_t`,通过扩散模型的采样算法(如 DDPM, DDIM)计算出稍微去噪的潜在视频 `z_{t-1}`。

     重复这个过程 T 步,从纯噪声 `z_T` 开始,逐步去噪得到最终的清晰潜在视频 `z_0`。

     Video VAE Decoder: 将最终的潜在视频 `z_0` 输入预训练好的 VAE 解码器,重建出像素空间的视频帧序列,即生成的视频。

    5. 处理时间维度: Spatiotemporal Transformer 通过其自注意力机制能够显式地建模长距离的时空依赖关系,对于生成连贯、动态符合描述的视频至关重要。当然 也可以使用基于 3D U-Net 的 Backbone,其中卷积层替换为 3D 卷积(同时处理空间和时间维度),并可能加入 Temporal Attention 模块。但目前 Transformer 在建模长距离依赖和可扩展性方面展现出更强的潜力,而且没人用3D unet来做视频,我们也就不解释了。

    好了现在一个正常的文生视频的流程我们就讲完了,其实以前我也讲过,相当于在让大家复习一遍。

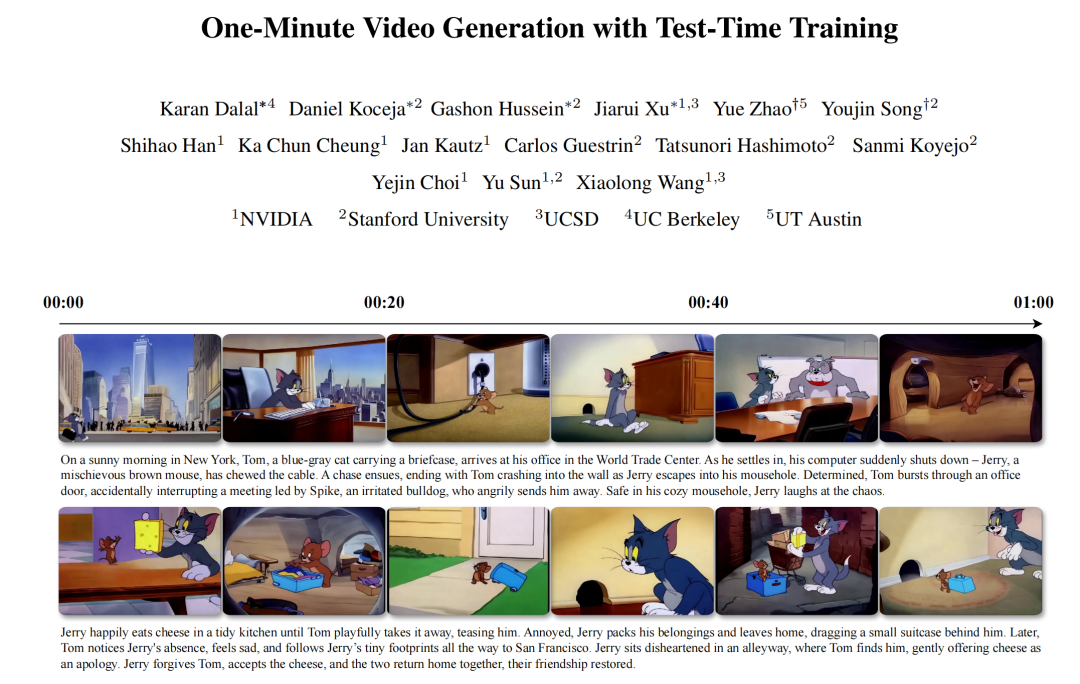
    那我们今天讲的论文有什么过人之处呢?
    Image

    最大的不同是,它能生成一分钟的视频,同时这个视频有着丰富的情节变化,不想现在的视频,即使10秒20秒也是相对简单的动作和拍摄视角的变化。

    但是这个论文的视频我是看过的,非常惊艳就根一个普通的动画片没有任何区别,角色的多帧运动和串场的一致性上,是基本现在所有的模型都无法做到的。

    我们刚才讲了在一个现在大部分的text2video的实现方案中,是扩展了self-attention层,让它有时空感知能力也就是所说的

    Spatiotemporal Transformer Blocks

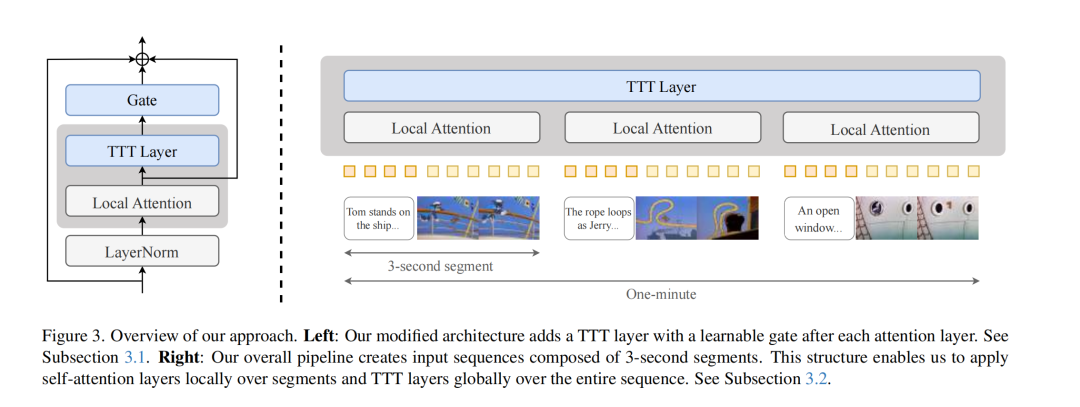
    它这个论文里的网络相当于另辟蹊径,是这样实现的。
    Image

    解释一下这个图

    1. 标准 Transformer 结构: 通常包含交替的attention层+MLP(叫FFN页性)。

      • 一个典型的序列建模块大致是:输入 X -> LayerNorm -> Self-Attention -> 输出 X' -> 残差连接 (X' + X) -> 输出 Y_attn。

      • 一个典型的 MLP 块大致是:输入 Y_attn -> LayerNorm -> FFN -> 输出 Y_ffn' -> 残差连接 (Y_ffn' + Y_attn) -> 输出 Y_final。

    2. 论文把架构给改了,从attn层出来以后不给MLP,中间差了一个类似bi-lstm的rnn

      • 输入 X

      • X' = self_attn(LN(X))

         (自注意力层的输出,注意这里已经包含了 LayerNorm)

      • Z = gate(TTT, X'; α)

         (前向 TTT 层处理 X')

      • Z' = gate(TTT', Z; β)

         (反向 TTT 层处理 Z)

      • Y = Z' + X

         (最终的残差连接,注意是 TTT 的输出 Z' 与块的原始输入 X 相加)

      这个双向RNN就是TTT层

      Image

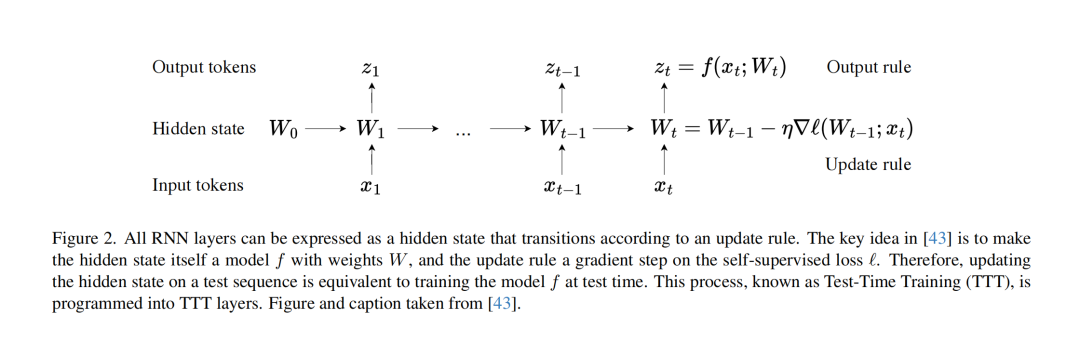
      这张图展示了 测试时训练 (Test-Time Training, TTT) 层 的核心工作原理,并将其与通用 RNN(循环神经网络)的概念联系起来。

      1. 基本结构: 图示了一个按时间步处理序列的过程(从 t=1 到 t)。它有三个主要部分:

        • Input tokens (输入标记):

           x_1, ..., x_{t-1}, x_t,代表按顺序输入的序列元素。

        • Hidden state (隐藏状态):

           W_0, W_1, ..., W_{t-1}, W_t,代表在每个时间步传递的“记忆”或状态。W_0 是初始状态。

        • Output tokens (输出标记):

           z_1, ..., z_{t-1}, z_t,代表在每个时间步生成的输出。

      2. 与 RNN 的相似之处: 像所有 RNN 一样,当前隐藏状态 W_t 依赖于前一个隐藏状态 W_{t-1} 和当前输入 x_t。当前输出 z_t 则由当前隐藏状态 W_t (可能也结合 x_t) 决定。

      3. TTT 的核心创新 (关键区别):

        • W_{t-1}

          上一步的模型权重(即上一个隐藏状态)。

        • η

          学习率。

        • ∇ℓ(W_{t-1}; x_t)

          这是一个 梯度。它是根据当前输入 x_t 计算的一个 自监督损失函数 ℓ (self-supervised loss),然后对 上一步的权重 W_{t-1} 求导得到的。

        • 隐藏状态是模型权重 (Hidden state is model weights)

           TTT 层最关键的思想是,这里的隐藏状态 W_t 不再仅仅是一个状态向量,而是代表了一个内部神经网络模型 f 的权重 (weights)。这就是为什么用 W (通常代表权重) 而不是 h (通常代表隐藏状态向量) 来表示。

        • 更新规则是梯度下降 (Update rule is gradient descent)

           隐藏状态的更新方式 W_t = W_{t-1} - η ∇ℓ(W_{t-1}; x_t) 不是 传统 RNN 的矩阵运算和激活函数,而是 一步梯度下降。

        • 输出规则 (Output rule)

           输出 z_t = f(x_t; W_t) 是使用 刚刚更新过的模型 f (其权重为 W_t) 对当前输入 x_t 进行预测(或处理)得到的结果。

      所有 RNN 层都可以看作是一个根据更新规则进行转换的隐藏状态。

      TTT 的关键思想是:让隐藏状态本身成为一个带有权重 W 的模型 f,并且 更新规则是在自监督损失 ℓ 上进行的一步梯度下降。

      因此,在一个测试序列上更新隐藏状态,就 等同于在测试时训练模型 f。

      这个过程被称为 测试时训练 (Test-Time Training, TTT),并被编程到 TTT 层中。

      与标准 Transformer 的全局注意力(一次性看到所有输入)或局部注意力(只看到一小段)不同,TTT 层像 RNN 一样,按顺序处理输入序列的各个部分。它一步一步地“读”过整个视频序列。所以对时序建模理论上比传统transformer更有优势,RNN本身对时序感知尤其上下文理解就有优势,只是长程依赖的理解比较差,再加上训不大,所以退出了历史舞台,现在页有RWKV和mamba给rnn招魂,所以TTT不是第一个也不是最后一个,毕竟RNN有自己的时序优势,transformer不成。

      另外一个非常重要的因素,就说到我们开头聊的算力的问题

      核心区别:如何处理长序列(长上下文)

      1. 我上文之前描述的架构 (理想化的时空 Transformer):

        机制

        依赖于 全局的时空自注意力 (Global Spatiotemporal Self-Attention)。这意味着整个视频序列中的每一个时空块(Token)都可以直接关注(Attend to)所有其他的时空块。

        优点

        理论上能够完美地捕捉所有时空依赖关系。

        缺点 (致命)

         标准自注意力的计算复杂度与序列长度 N 呈 平方关系 (O(N²))。对于一分钟的视频(论文提到可能超过 30 万个 Token),这种平方复杂度的计算成本对于目前的硬件来说是难以承受的,无论是训练还是推理都过于缓慢且消耗内存,基本就不太实现,其实再有卡你也要考虑是否可商用。

      2. 论文中的架构 (TTT 增强的 Transformer)


        局部自注意力(Local Self-Attention)

      预训练 Transformer (CogVideo-X) 中的标准自注意力机制被限制 在视频的短的、独立的 3 秒片段 内运行。这使得每个注意力计算的序列长度可控,避免了全局注意力带来的平方复杂度爆炸。

      全局测试时训练 (TTT) 层

      在局部注意力层之后 插入了新的 TTT 层。这些 TTT 层作用于 整个 由 3 秒片段拼接而成的 完整序列。关键在于,TTT 层的功能类似于高级的 RNN,其计算复杂度与序列长度 N 呈 线性关系 (O(N)),这和memba的思路也差不多。所以它可以利用rnn的这部分优势,节省计算复杂度,可以生成更长的视频。

      这么写大家可能有歧义,这不和现在市面上生成的3秒一个视频然后拼接20个视频成1分钟没区别吗?当然不是,处理/生成片段 1 (0-3秒),模型处理(或开始生成)第一个 3 秒片段。在这个过程中,局部注意力处理片段内部细节,同时TTT 层开始建立它的内部状态 W_0(可以想象成对这 3 秒内容的“总结”或“模型理解”)。处理/生成片段 2 (3-6秒),模型接着处理(或生成)第二个 3 秒片段。 它不是独立进行的。局部注意力处理片段 2 的内部细节,但 TTT 层接收了来自片段 1 的状态 W_0,并结合片段 2 的信息,通过自监督学习更新其状态,得到 W_1 (W_1 = W_0 - η ∇_{W_0} ℓ(X_2; W_0))。这意味着,处理片段 2 时,模型“知道”片段 1 发生了什么,这个“知道”就编码在状态 W_0 里,并影响着 W_1 的形成以及片段 2 的生成/处理。以此类推,就能实现了局部一致性和全局一致性的完美统一。

      优势:时序一致性:因为信息(通过 TTT 层的状态 W)在片段间传递,模型被强制要求保持连贯性。它会倾向于让物体、背景、风格等在片段过渡时保持一致或平滑变化,有记忆: TTT 层提供了跨片段的“记忆”。

      类比:就像你写一个故事,写第二段时,你会记得第一段写了什么,并在此基础上继续写,确保情节连贯。或者一个动画师一帧一帧地画,确保动作流畅、人物状态一致。

      到此,在transformer层加入了TTT层,对文生视频一致性增强的能力解释,基本就告一段落了。于此同时,其实controlnet的作者张吕敏也发了一个新的技术framepack,他从首帧全程attention的思路来解决长视频一致性的问题(多少有点controlnet的思路),这个技术实现解读下一篇来写

      视觉特征-自监督-掩码特征预测【2025-06】:V-JEPA-2附录【样本帧数=16;FPS=4;空间掩码比例=[0.15, 0.7];时间掩码比例=[1.0, 1.0];管状片段大小=2】 图14 展示了在实验室1中,使用杯子进行抓取操作任务的起始和目标框架示例。对于抓取和带物体到达任务,模型仅看到一个目标图像。对于拾取-放置任务,除了最终目标外,我们还向模型展示两个子目标图像。第一个目标图像显示物体被抓取,第二个目标图像显示物体在目标位置附近。模型首先针对第一个子目标优化动作4个时间步,然后自动切换到第二个子目标进行接下来的10个时间步,最后针对第三个目标进行最后4个时间步。 阅读详情

      相关推荐

      视觉特征-自监督-掩码特征预测【2025-06】:V-JEPA-2【100万小时互联网视频,每样本:4秒×4➜16帧】【Stage1:表征学习⮕Stage2:V-JEPA2-AC(自回归下一帧预测)】

      图14 展示了在实验室1中,使用杯子进行抓取操作任务的起始和目标框架示例。对于抓取和带物体到达任务,模型仅看到一个目标图像。对于拾取-放置任务,除了最终目标外,我们还向模型展示两个子目标图像。第一个目标图像显示物体被抓取,第二个目标图像显示物体在目标位置附近。模型首先针对第一个子目标优化动作4个时间步,然后自动切换到第二个子目标进行接下来的10个时间步,最后针对第三个目标进行最后4个时间步。

      u013250861的博客 97

      All in one 的 AI tool Chain “Halomate”

      2- Deepseek 有非常好的文学造诣和情商,用它来进行创作简直无敌,在deepseek这么火的今天,大家使用的很多endpoint其实服务的并不是完整的600B,而是其他蒸馏版本,在这里你可以使用到原生的deepseek的古灵精怪能力。我刚才的mate就默认开启了 高级visualization强化的能力,让AI给你的答案不光是答案,还会以具像化的图标来呈现,有更强的表现能力。WC,这个悲伤又亢奋的曲子就被谱写出来了,虽然是mid的,但是能家族对抗的味道。6、Preview产品原型?

      周博洋的博客 2463

      具身智能【2026-01】:Being-H0.5【VLA + Flow Matching】【MoT+MoE架构】【UniHand2.0数据集:4 亿个样本/35000小时 】

      BeingBeyond Teamhttps://research.beingbeyond.com/being-h05Real-World Deployment Figure 1: Being-H0.5 at a Glance. We scale human-centric robot learning with Being-H0.5 toward cross-embodiment generalization. We introduce UniHand-2.0, a large-scale corpus

      u013250861的博客 246

      揭秘9个顶尖AI镜像网站

      9个私藏的AI镜像多模态网站,通过任意网站,你就可以使用ChatGPT4.5、Claude 3.7 sonnet、Grok 3、Gemini 2.5 Pro、DeepSeek-R1、Midjourney(v7)、Flux Dev 1.0、Kling1.6、Runway Gen-3等模型,每个网站都有免费套餐。

      2402_82616859的博客 1万+

      使用VNC可视化Docker容器

      Docker容器可视化

      Robert_Q的博客 1万+

      运动目标成像必学:5分钟搞懂keystone变换原理与避坑指南

      本文深入浅出地解析了雷达信号处理中的Keystone变换原理,它是解决运动目标距离徙动问题的关键技术。文章通过直观比喻和简化公式,阐述了该变换如何通过变量代换实现距离与慢时间的解耦合,将倾斜轨迹“掰直”,从而提升成像与检测性能。同时,文中重点指出了实际应用中关于大速度场景、插值误差、多目标处理及高阶运动补偿等关键避坑点,为工程实践提供了宝贵指南。

      ios99的博客 403

      Strands Evals 多模态图像转文本评估:MultimodalOutputEvaluator 与 MLLM-as-a-Judge 的设计与实战指南

      `MultimodalOutputEvaluator` 是 Strands Evals 为「图片/文档输入、文本输出」类任务引入的 MLLM-as-a-Judge 评估器,它让 Agent 的输出可以直接携带图片数据交给多模态大模型评判,从而覆盖文本评判器无法察觉的视觉幻觉、事实错误与指令违背。本文基于 [设计文档](https://link.gitcode.com/i/32dd4ec47595f

      gitblog_00580的博客 428

      避开SiC MOSFET驱动设计的3个大坑:电流/电阻/电压配置全指南

      本文深入解析SiC MOSFET驱动设计中的三大关键参数:驱动电流、栅极电阻和工作电压,揭示常见设计误区与优化方案。通过实际案例与数据对比,指导工程师避开第三代电力电子半导体应用中的典型陷阱,提升系统可靠性与效率。特别针对驱动电源配置、栅极电阻选型等核心问题提供可落地的解决方案。

      weixin_29214199的博客 383

      【Video Agent 11】(Arxiv2504)VideoExpert: Augmented LLM for Temporal-Sensitive Video Understanding

      本文介绍VideoExpert,一种增强型多模态大语言模型(MLLM),用于时间敏感的视频理解任务。现有MLLM在时序定位等任务上表现不佳,主要依赖语言模式而非视觉线索生成时间戳。VideoExpert创新性地集成两个并行专家模块:Temporal Expert处理高帧率压缩特征以捕捉动态变化并实现精确事件定位;Spatial Expert专注于内容细节分析和指令跟随。通过特殊token <LOC>实现协作,参数解耦设计避免相互干扰。此外,引入Spatial Compress模块筛选压缩patc

      做cv的小昊的博客 511

      Python 爬虫 + 数据分析:社会调查数据抓取与结果可视化分析

      在当今数字化时代,数据已成为推动社会发展的关键资源之一。无论是市场调研、学术研究还是政策制定,社会调查数据都扮演着至关重要的角色。通过 Python 爬虫技术,我们可以高效地获取这些数据,并结合数据分析与可视化工具,深入挖掘数据背后的价值。本文将通过一个完整的实战项目,带你掌握如何使用 Python 爬虫抓取社会调查数据,并进行可视化分析。

      yansideyucsdn的博客 126

      4.2 多智能体系统的严格隔离机制:防止上下文污染与隐私数据脱敏实战

      本文探讨了多智能体系统中上下文信息共享带来的安全风险与解决方案。研究发现,随着Agent数量增加,上下文信息泄露概率呈指数级上升,可能导致跨Agent错误传播、隐私泄露等问题。文章提出分层隔离架构,将上下文划分为全局共享和本地私有两部分,并通过命名空间隔离、递归压缩和隐私过滤技术确保数据安全。技术实现上,建议为每个子Agent创建独立状态空间,采用原子化更新和读写锁控制避免状态竞争。隐私保护方面,结合正则匹配和命名实体识别技术进行敏感数据过滤,确保符合GDPR等法规要求。这些措施共同构建了可靠、安全且合规的

      公众号:AI前沿侦探 225

      3分钟上手:手机端最强多模态大模型MiniCPM-V完全指南

      想要在手机上运行媲美GPT-4V的多模态AI吗?MiniCPM-V系列正是为你量身打造的"口袋级"多模态大模型!作为目前最轻量、最高效的端侧视觉语言模型,MiniCPM-V不仅能在iPhone、Android和HarmonyOS上流畅运行,还能处理图像、视频、文档等多种复杂任务。无论你是开发者还是普通用户,这份完整指南将带你快速掌握MiniCPM-V的核心功能和使用方法。 ## 为什么选择Min

      gitblog_00596的博客 458

      华为OD技术面八股_C++_05

      汇总华为OD技术面C++方向技术面八股文,提供详细解答。

      qq_45776114的博客 413

      AI推介-多模态视觉语言模型VLMs论文速览(arXiv方向):2024.06.01-2024.06.05

      大型视觉语言模型(VLM)可以学习丰富的图像-文本联合表征,从而在相关的下游任务中表现出色。然而,它们未能展示出对物体的定量理解,也缺乏良好的计数感知表征。本文对 “教CLIP数到十”(Paiss等人,2023年)进行了可重复性研究,该研究提出了一种微调CLIP模型(Radford等人,2021年)的方法,通过引入计数对比损失项来提高图像中零点计数的准确性,同时保持零点分类的性能。我们利用较少的计算资源,在其训练数据的较小子集上提高了模型的性能。我们用自己的代码重现了他们的研究,从而验证了这些说法。

      小小帅 1644

      交货单冲销发货过账的正确姿势:用 VL09 与 ABAP 批量反冲 Goods Issue

      摘要 本文详细解析了SAP系统中VL09事务码的技术实现与业务应用。VL09用于反冲发货的货物移动,通过标准冲销路径(移动类型602冲销601)确保单据链路一致、状态机正确回退和业务规则生效。文章对比了经典VL09与Fiori应用在不同SAP产品形态中的位置,并针对STO场景提供了ME23N验证方法。核心内容包括WS_REVERSE_GOODS_ISSUE函数模块的调用要点、必须COMMIT的原因(SAP LUW机制),以及处理Handling Unit等限制条件的注意事项。最后给出了将VL09工程化的项目

      2007 年 ~ 2025 年,深耕 SAP 技术 18 年 588

      AutoSAR配置视频讲解:新建DaVinci工程

      AutoSAR实验视频讲解:闪烁一颗LED实验【新建DaVinci工程】 上一篇 | 下一篇 | 总目录 实验架构图 视频本频放在了文末,下图描述了本次实验配置内容在AutoSAR架构中的位置,供大家参考 实验内容 本节课程讲解新建DaVinci工程,听上去新建工程很简单,但是还是需要很多的准备工作和细节。主要内容是新建工程和导入dbc文件和导入arxml文件的方法 主要步骤 新建DaVinci工程 导入.dbc通信矩阵文件 导入Mcal的arxml文件 实验视频2:Mcal配置 提示:版权所在,违

      雪云飞星的博客 6275

      HunyuanVideo 开源文生视频大模型实战指南:架构解析、环境部署与推理调优

      HunyuanVideo 是腾讯混元团队开源的文生视频(Text-to-Video)大模型,其推理代码、模型权重与配套工具链全部沉淀在本仓库中。本文以 [README_zh.md](https://link.gitcode.com/i/dc346b96936fe714a8c0e7040e2a50ee) 为主体骨架,结合仓库内的源码实现(`hyvideo/` 模块、`sample_video.py`

      gitblog_00429的博客 171

      VC中sqlite的使用

      在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

      5个必知技巧:让你的MiniCPM-V多模态AI在本地完美运行

      MiniCPM-V是一款专为移动设备设计的口袋级多模态大语言模型,能够在iOS、安卓和鸿蒙系统上实现极致高效的图像与视频理解。无论你是AI开发者还是普通用户,掌握正确的部署方法都能让你充分发挥这款强大模型的潜力。 ## 🔍 为什么MiniCPM-V如此特别? MiniCPM-V系列模型采用创新的视觉编码技术,能够在保持高性能的同时大幅降低计算开销。最新版本MiniCPM-V 4.6通过**V

      gitblog_00999的博客 977

      win10 跳过U8环境检测的IE WebControls.rar

      win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

      jdk-8u144-linux-x64.tar.gz.

      该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

      KTransformers 异构 VLM LoRA 微调实战指南:基于 LLaMA-Factory 训练 Qwen3-VL MoE 多模态模型

      本文是一份完整的实操指南,讲解如何在 LLaMA-Factory 微调框架中接入 KTransformers(KT)的 CPU/GPU 异构执行能力,对 **MoE 架构的多模态大模型(VLM)** 进行 LoRA SFT(有监督微调)。工作流已在 Qwen3-VL-30B-A3B-Instruct 与 Qwen3.5-35B-A3B 上完成验证:视觉编码与注意力等非专家模块留在 GPU,MoE

      gitblog_00822的博客 193

      visio安装包

      Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

      如何在10分钟内上手VideoChat3-4B:视频多模态大模型安装与加载完整教程

      VideoChat3-4B 是一个 4B 参数、完全开源的视频多模态大语言模型(Video MLLM),擅长视频理解、图像理解与流式视频分析。本教程面向新手,带你完成 VideoChat3-4B 视频多模态大模型的安装、模型加载与首次推理,10 分钟即可跑通第一个视频问答 Demo。 ## VideoChat3-4B 是什么?它能做什么? VideoChat3-4B 由 MCG-NJU(南京大

      gitblog_00073的博客 476

      51c大模型~合集111

      OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

      whaosoft~aiotの开发板商城 2316

      Ultralytics 中的 SAM 3:概念提示分割(PCS)架构解析与完整实战指南

      SAM 3(Segment Anything Model 3)是 Meta 于 2025 年 11 月发布的基础分割模型,其核心创新在于引入 **Promptable Concept Segmentation(PCS,可提示概念分割)**:不再局限于"分割单个实例",而是能用一句文本短语或一张示例图片,分割出图像/视频中**所有**匹配该视觉概念的实例。本文基于当前仓库中 `ultralytics

      gitblog_01109的博客 1145

      一文读懂SAM 3图像分割大模型核心基础知识

      SAM 3:从“点一下分割”到“按概念理解世界”的视觉基础设施

      Rocky Ding相信人工智能、数据科学、商业逻辑、金融工具、终身成长以及顺应时代的潮流会赋予我们超能力。 775

      【论文阅读】VideoArgus:用「样本专属评分表」统一评测视频生成与编辑

      不用固定指标去评所有视频,而是先为每一条输入单独写一份评分表(rubric),冻结后复用给所有候选模型,再由 agent 调 CV 工具逐条取证打分。

      weixin_47505105的博客 423

      MiniCPM-V 4.6 如何完成视频推理并配置帧采样与下采样参数?

      这篇文章解决一个具体问题:在本地 GPU 上用 Transformers 加载 `openbmb/MiniCPM-V-4.6` 模型,对一个视频文件完成推理,并正确配置帧采样(`max_num_frames`、`stack_frames`)与视觉 token 下采样(`downsample_mode`)参数。前提是你已具备 Python 环境和可用 GPU(文档 Model Zoo 标注该模型 G

      gitblog_00235的博客 842

      CNEquity数据源深潜:TDX协议、东财、Baostock主备源路由与历史限制完整指南

      CNEquity 是面向量化研究与回测的中国 A 股数据与金融数据基础设施开源项目,55 个日更数据集全部来自免费公开渠道,自托管、零注册、零 API Token。这篇文章带你深潜它的**数据源层**:TDX 协议、东财(EastMoney)、Baostock 三大免费数据源各自负责什么,**主备源路由**如何调度,以及每个源的**历史限制**边界在哪里——搞清楚这三点,你才能正确规划数据回填窗口

      gitblog_00668的博客 407
      上一篇: Col开头的模型能给RAG带来啥新算法
      下一篇: RL+search = Deep research
      周博洋K
      博客等级 码龄9年 2005粉丝 156原创
      评论
      成就一亿技术人!
      拼手气红包6.0元
      还能输入1000个字符
       
       条评论被折叠 查看
      添加红包

      请填写红包祝福语或标题

      个

      红包个数最小为10个

      元

      红包金额最低5元

      当前余额3.43元 前往充值 >
      需支付:10.00元
      成就一亿技术人!
      领取后你会自动成为博主和红包主的粉丝 规则
      hope_wisdom
      发出的红包
      实付元
      使用余额支付
      点击重新获取
      扫码支付
      钱包余额 0

      抵扣说明:

      1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
      2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

      余额充值