


🏭博文导航-四阶段学习路径版(持续更新) 关于【智联工坊】那些事
【文章摘要】
针对制造业设备数据质量差导致 OEE 失真、人工排查效率低、不可复现的痛点,本文基于智联工坊 50 万行真实压测数据,演示从人工 2 天排查升级为 AI 自动巡检的完整落地方案。采用接入层 + 检测层 + 编排层 + 兜底层的四层架构,覆盖空值、重复、异常、延迟、结构五类检测,配套 Agent 工具调用双兜底防线,附 9 类脏数据场景压测结果、选型权衡与边界局限,所有结论均有注入基准可验证,可直接复用到生产场景。
目录
6.1 langchain 1.x 大版本漂移:依赖只写下界,pip 一升全红
7.1 大模型:本地 Ollama + Qwen2.5 vs 云 API
7.2 调度:APScheduler vs DolphinScheduler
开篇:一个让 OEE 失真的真问题
本系列所有案例来自通用离散制造虚拟工厂——智联工坊。所有数据已脱敏,不映射任何真实企业。
上个月智联工坊的班组长小刘拿着一份 OEE 报表问我:「老蒋,设备上月停了两次、每次两小时,OEE 怎么还能有 86%?」
我去翻底层数据,发现传感器温度里混着 200℃ 和 -50℃ 的异常值,振动数据有大段空值,还有记录重复上报。用这样的数据算 OEE,谁敢信?
发现这些问题靠数据工程师小张手动拉数据、Excel 筛空值、查重复、算标准差,一轮下来快两天。本文要解决的是一个工程问题:把数据质量巡检从「人工逐项排查」变成「Agent 标准化自动巡检」,可复现、可定时、可审计。
V1 版当时只有 1010 行的链路验证。这一版是完整实战收官:工程从 1010 行跑到了 50 万行,主动注入了编码乱码、时间戳混乱、字段错位等 9 类「脏上加脏」场景做压力测试,还揪出并修掉了小模型多工具编排的真实缺陷。全文所有数字都有注入基准可核对。
【📊核心成果速览】
・效率提升:50 万行数据完整巡检从人工 2 天缩短至自动 26 秒
・覆盖范围:5 大类检测 + 9 类工业脏数据场景,结构与内容分层处理
・准确率验证:注入基准与实跑检出 1:1 匹配,结果可复现、可核对
・生产级加固:提示词硬约束 + 代码级兜底双防线,解决 Agent 漏调工具问题
一、数据质量的代价:业务问题
| 数据质量问题 | 业务后果 |
|---|---|
| 温度异常(200℃/-50℃) | OEE 失真,设备健康度误判 |
| 振动整段空值 | 预测性维护模型失效,故障漏报 |
| 工单重复上报 | 产量统计虚高,排产决策被误导 |
| 上报延迟超阈值 | 实时监控失效,异常响应滞后 |
| 编码乱码 / 字段错位 | 数据接入即失真,下游全错 |
数据仓库和 AI 模型建得再好,地基不牢都是空中楼阁。制造企业尤其要命:这些数据直接进经营决策。
二、人工排查的真实成本
小张的手动流程,单轮排查大致是这样分配的:
| 步骤 | 操作 | 大致耗时 |
|---|---|---|
| 1 | SCADA 导出三天传感器数据 | 1h |
| 2 | Excel 分列逐列查空值 | 3h |
| 3 | 条件格式标重复行 | 2h |
| 4 | 手算均值标准差标异常 | 4h |
| 5 | 查时间戳间隔找延迟 | 2h |
| 6 | 汇总问题写报告 | 2h |
说明:这是场景化估算,用来说明「人力瓶颈」在哪。真正的问题不在 14 小时这个数字,而在于不可复现、不持续、依赖个人经验——换个工程师换个手法,结论可能不一样。
三、方案架构:五项检测 + Agent 编排 + 分层容错
架构在一句话里:接入层管结构,检测层管内容,Agent 管编排,兜底层管完整性。
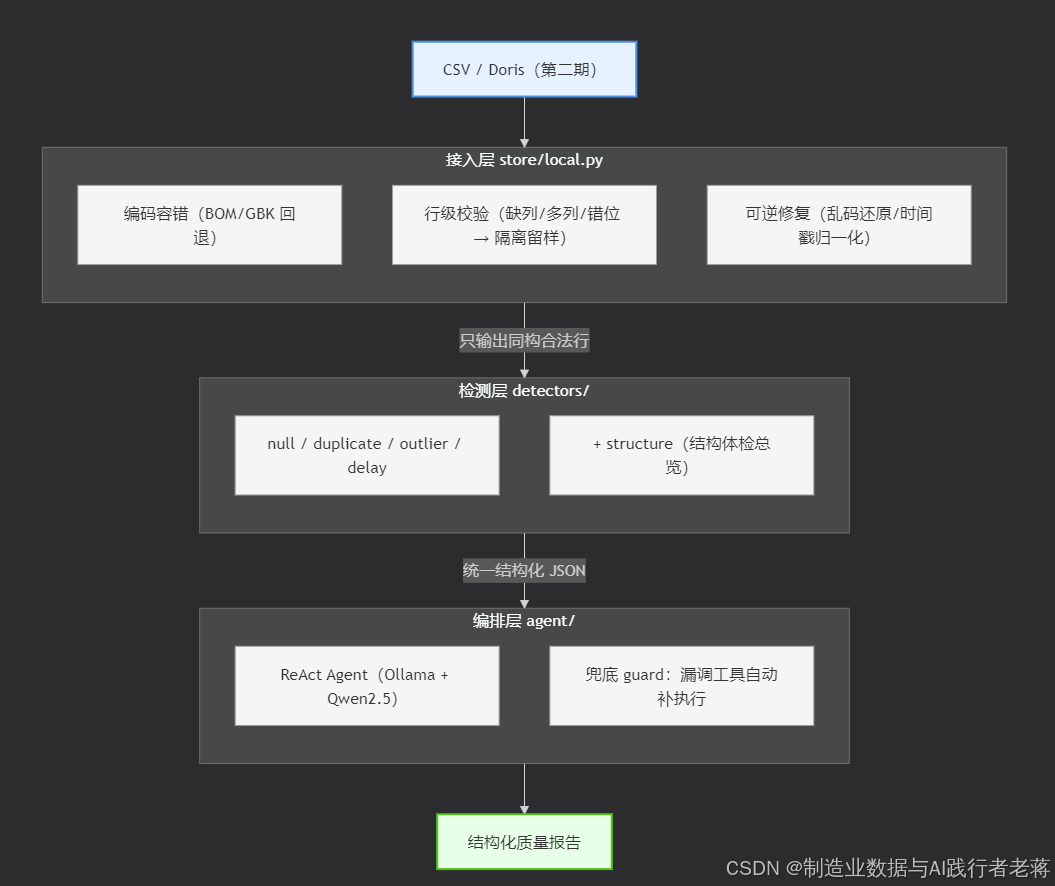
五项检测的分工:
| 检测项 | 检测逻辑 | 工具 | 层级 |
|---|---|---|---|
| 结构体检 | 编码/BOM/列数/时间戳格式 | structure_checker | 接入层 |
| 空值检测 | 各列空值率超阈值报警 | null_checker | 检测层 |
| 重复检测 | 完全重复行占比超阈值报警 | duplicate_checker | 检测层 |
| 异常值检测 | 数值列 3σ 越界标记 | outlier_checker | 检测层 |
| 延迟检测 | 相邻时间戳间隔超 60s 报警 | delay_checker | 检测层 |
为什么要分层? 压测时验证过的关键设计:结构脏行(编码错乱、缺列、错位)发生在「读取」层,空值、异常发生在「内容」层,混在一起处理会同时误报与漏报(比如 float("") 会把空值行误判成错位行)。分层之后,可修复的修复留痕,不可修复的隔离留样,内容检测只吃同构的合法行。
异常值检测是「模型侧判定」的代表:把数值列按 3σ 规则标记越界,任何一列命中即报警。下面是 detectors/outlier_checker.py 的核心实现(标准库实现,零第三方依赖),列集合与 σ 值都从 config 注入,换成 IQR/MAD 只需改判定段:
# detectors/outlier_checker.py(节选)
def check_outlier(csv_path: str, sigma: float = OUTLIER_SIGMA) -> Dict[str, Any]:
    """基于 3σ 原则检测数值列异常值。

    功能描述: 对数值列按 3σ 规则标记越界值,汇总异常总数。
    设计思路: 先用 float 安全解析收集有效样本,再按样本标准差判定越界;标准差为 0 跳过。
    Returns:
        含 status / total_outliers / sigma / columns / message 的结构化字典;
        文件缺失时返回 {error, suggestion}(V2.0 §二)。
    """
    try:
        rows = load_rows(csv_path)
    except FileNotFoundError:
        logger.error("异常值检测失败:文件不存在 %s", csv_path)
        return file_error(csv_path)

    total_outliers = 0
    columns: List[Dict[str, Any]] = []
    for col in NUMERIC_COLUMNS:                    # 列集合来自 config
        values: List[float] = []
        for r in rows:
            raw = str(r.get(col, "")).strip()
            if raw == "":
                continue
            try:
                values.append(float(raw))
            except ValueError:
                continue
        if len(values) < 2:
            continue
        mean = statistics.mean(values)
        std = statistics.stdev(values)
        if std == 0:
            continue
        lower = mean - sigma * std
        upper = mean + sigma * std
        outliers = [v for v in values if v < lower or v > upper]
        total_outliers += len(outliers)
        columns.append(
            {
                "column": col,
                "count": len(outliers),
                "mean": round(mean, 4),
                "std": round(std, 4),
                "lower": round(lower, 4),     # 上下界一并返回,便于回溯判定依据
                "upper": round(upper, 4),
            }
        )

    status = "warning" if total_outliers > 0 else "ok"
    message = f"发现 {total_outliers} 个异常值"
    logger.info("异常值检测完成:total_outliers=%d", total_outliers)
    return {
        "status": status,
        "total_outliers": total_outliers,
        "sigma": sigma,
        "columns": columns,
        "message": message,
    }
注意两个细节:检测列只取 NUMERIC_COLUMNS,不做全表扫描;返回里带 mean/std/lower/upper,运维看到「温度 10096 个」时能直接判断是判定口径问题还是真故障。这也是 5.2 节误报分析能定量展开的前提。
检测层之外,模型调用与提示词也做了单点收口——工程里只有 core/llm.py 知道怎么连 Ollama,只有 core/prompt.py 知道当前用哪版提示词,业务代码不直接碰 SDK 与提示词文本:
# core/llm.py(节选):模型调用单点
try:  # langchain-community >= 0.4:ChatOllama 拆到独立包
    from langchain_ollama import ChatOllama
except ImportError:  # pragma: no cover - 旧版本回退路径
    from langchain_community.chat_models import ChatOllama  # type: ignore[no-redef]


def get_llm() -> Any:
    """返回统一配置的 ChatOllama 实例(模型调用单点)。

    功能描述: 收口大模型构建,所有 Agent 经此获取 LLM。
    设计思路: 参数全部来自 config,便于在 .env 切换模型与温度而不改代码;
              ChatOllama 导入做新旧路径兼容,防止 langchain 大版本升级直接 ImportError。
    Returns:
        已配置的 ChatOllama 实例。
    """
    logger.debug("构建 ChatOllama: model=%s, base_url=%s", LLM_MODEL_NAME, OLLAMA_BASE_URL)
    return ChatOllama(
        base_url=OLLAMA_BASE_URL,
        model=LLM_MODEL_NAME,
        temperature=LLM_TEMPERATURE,
        request_timeout=LLM_REQUEST_TIMEOUT,
    )


# core/prompt.py(节选):提示词单一来源,按版本文件装配
SYSTEM_PROMPT_FILE: Path = PROMPT_DIR / "system_prompt_v1.0.1.md"


def build_react_prompt() -> PromptTemplate:
    """装配 ReAct 系统提示词(提示词单一来源 + 版本管理)。"""
    if not SYSTEM_PROMPT_FILE.exists():
        raise FileNotFoundError(
            f"系统提示词缺失: {SYSTEM_PROMPT_FILE};请确认 prompts/case05_data_quality/ 目录完整"
        )
    template = SYSTEM_PROMPT_FILE.read_text(encoding="utf-8")
    return PromptTemplate.from_template(template)
temperature 固定为 0 是刻意的:巡检是「按数据说话」的任务,报告需要可复现,不能让模型每次措辞都飘。提示词则放在 prompts/case05_data_quality/ 下按版本号管理,变更走 CHANGELOG,调用方不动代码。
【💡 适用边界说明】
・适配场景:离散制造业设备时序数据、工单数据的质量巡检,可直接用于数仓 ODS 层前置校验;
・算法说明:演示采用 3σ 原则,生产环境建议替换为 IQR/MAD 稳健统计算法,降低误报率;
・扩展说明:本期为文件级巡检,第二期可对接 Doris 数仓实现 SQL 级批量巡检。
四、三步走实施:一天落地
没搞八周大排期,三步走,一天完成。环境完全复用已有资产:Ollama + Qwen2.5 零改动,配置集中在 config.py,敏感参数走 .env 注入。
# config.py(节选):所有配置一处收口,支持环境变量覆盖
OLLAMA_BASE_URL: str = os.getenv("OLLAMA_BASE_URL", "http://localhost:11434")
LLM_MODEL_NAME: str = os.getenv("LLM_MODEL_NAME", "qwen2.5:7b")
NULL_THRESHOLD: float = float(os.getenv("NULL_THRESHOLD", "0.01"))    # 演示口径,生产 >5%
MOCK_N_ROWS: int = int(os.getenv("MOCK_N_ROWS", "1000"))            # 数据量一行配置切换
| 步骤 | 产出 | 耗时 | 验证方式 |
|---|---|---|---|
| 1. 数据就绪 + 检测工具 | 01_generate_mock_data.py + 五个检测工具 | 2~3h | 手动调用,与注入基准核对 |
| 2. Agent 组装 + CLI 测试 | agent/builder.py + 02_test_cli.py | 2h | 一句话触发全量巡检 |
| 3. 定时巡检 + 报告落盘 | 03_scheduled_check.py(APScheduler) | 1~2h | --once 单次验证 + 定时触发 |
一键复现命令:
python 01_generate_mock_data.py          # 生成含脏数据的传感器 CSV
python tests/eval_script.py              # 检测基准回归(注入基准 vs 实跑检出)
python 02_test_cli.py                    # 对话式巡检,Agent 编排五工具
python 03_scheduled_check.py --once      # 定时巡检单次验证,报告落盘 reports/
这套「配置收口 + 三步走」的回报马上就能看到:后面从 1000 行扩到 50 万行,零代码改动,环境变量一盖就跑。
五、真实数据验证:从 1010 行到 50 万行
5.1 基线验证:1010 行,注入基准 1:1 命中
固定种子(42)生成 1010 行脱敏传感器数据,刻意注入四类脏数据作为基准(ground truth):
| 检测项 | 注入基准 | 实跑检出 | 结论 |
|---|---|---|---|
| 空值 | temperature 20 行 | 20 行 / 1.98% | 命中 |
| 重复 | 10 行完全重复 | 10 行 / 0.99% | 命中 |
| 异常值 | 20 个极端温度 | 23 个(20 注入 + 3 个高斯尾部) | 命中,含 3 个统计尾部 |
| 延迟 | 3 处时间 gap | 3 处 / 最大 120s | 命中 |
关键交叉验证:Agent 对话式巡检输出的四个数字与四工具独立检测结果完全一致,证明 Agent 只做编排,没有引入数值偏差。(此处是基线阶段的四个内容检测工具;结构体检是 50 万行阶段才加入的第五项,见 5.3。)
5.2 规模验证 ×50:3σ 误报的定量实锤
数据量从 1000 行扩到 50500 行,出现了一个比「跑通」值钱得多的发现:
异常值误报从 3 个暴涨到 256 个。这不是 bug,是统计规律:高斯分布 |z|>3 理论占比 0.27%,50000×0.27%≈135/列,与实测(振动 120 + 电流 136)吻合。
5.3 压力验证:50 万行「脏上加脏」,9 类场景逐项过
50 万行规模下,主动注入 9 类真实世界的脏数据场景:
| 场景 | 注入量 | 管线处理 | 实测结果 |
|---|---|---|---|
| UTF-8 BOM 头 | 全文件 | BOM 识别剥离 | ✅ 507,500 行全读出 |
| GBK 编码分片 | 5,000 行 | UTF-8 失败→回退 GBK | ✅ 回退路径真实触发 |
| 时间戳格式变体 | 10,000 行 | 归一化,时间值不变 | ✅ 全部修复 |
| 非法时间戳(13月45日等) | 1,000 行 | 解析失败→隔离留样 | ✅ 隔离 1,000 |
| 物理缺列 / 多列 / 字段错位 | 各 500 行 | 列数/数值校验→隔离 | ✅ 各隔离 500 |
| 乱码产线名(Latin-1 误码) | 1,000 行 | Latin-1 往返还原 | ✅ 全部还原 |
| 四项内容检测(隔离修复后的干净输入上) | 见 5.1 口径 | 标准检测 | ✅ 合法行 505,000 精确、重复 5,000 精确、延迟 3 精确 |
同构性验证:结构脏行全部追加注入、接入层隔离后,内容检测的输入与纯净场景完全一致,基准回归一行测试没改、全绿通过。隔离层若多删一行,回归立刻报错。
性能数据:
| 环节 | 耗时 |
|---|---|
| 生成 50 万行 + GBK 分片 | ~5s |
| 单次读取 + 结构校验 | ~4.5s |
| 一次完整巡检(5 项检测 + 报告落盘) | ~26s |
| Agent 对话式巡检 | 2m48s(LLM 推理占 90% 以上) |
结论:检测不是瓶颈,LLM 才是。定时巡检链路不调 LLM,26 秒跑完;对话式巡检才走 Agent。更大规模时应把检测层下沉到 Doris SQL(第二期方案)。
六、实践踩坑与生产级加固
这部分是整个实践里最有含金量的,三个坑都有完整排坑笔记(文末链接)。
| 坑点 | 核心后果 | 一句话解法 |
|---|---|---|
| LangChain 版本漂移 | 依赖只写下界,升级后全量 ImportError | 版本锁上下界 + 代码侧兼容导入双保险 |
| 小模型漏调工具 | 结构检测被跳过,输入数据不可信 | 提示词硬约束 + 编排层代码兜底双防线 |
| 压测假覆盖 | 测试全绿但实际未检测 | 关闭注入逻辑,对应断言必须变红验证 |
6.1 langchain 1.x 大版本漂移:依赖只写下界,pip 一升全红
requirements.txt 只写 langchain>=0.2,pip 直接拉到 1.4.2,两处 ImportError:create_react_agent 迁到 langchain_classic.agents,ChatOllama 移出 community 包。修法双保险:版本锁上下界 + 代码侧兼容导入。详见排坑笔记 1(待发布)。
6.2 小模型漏调工具:Agent「交卷」前没做完题
50 万行实测,qwen2.5:7b 拿到 4 项内容检测结果就直接输出 Final Answer,跳过了 structure_check。而结构问题恰恰发生在内容检测之前,漏掉它意味着整条管线的输入都不可信。
生产级修法分两层。第一道防线写在系统提示词 v1.0.1 里,把「必须调齐五个工具」变成硬约束:
【硬性约束】必须依次调用全部工具各一次:
null_check、
duplicate_check、
outlier_check、
delay_check、
structure_check。
五个工具全部返回结果之前,禁止输出 Final Answer。
structure_check 负责编码/BOM/列结构/时间戳格式的结构体检,
与内容检测同等重要,绝不可跳过。
第二道防线在编排层,代码保证、不靠模型自觉。三个设计点值得留意:补执行失败不中断主流程,而是留 {error, suggestion} 占位,保证报告维度齐全可审计;合并走 LLM 但失败自动降级为原文追加;无论是否触发都写 fallback_executed 留痕,便于事后统计漏调率。加固后 50 万行实跑 5 工具全调齐,报告含结构体检且数字与独立检测一致。详见排坑笔记 2(待发布)。
6.3 压测造数的假覆盖:测试全绿,其实什么都没测到
第一版压测造数有三个盲区:缺列行被 dict.get(col,"") 补成空串、ASCII 产线名让乱码注入恒等、纯 ASCII 的「GBK 文件」与 UTF-8 字节完全相同。四个坑的共同本质:测试看起来在测,实际什么都没测到。判定标准就一条:把注入逻辑关掉,对应断言必须变红。详见排坑笔记 3(待发布)。
七、工具选型 trade-off
7.1 大模型:本地 Ollama + Qwen2.5 vs 云 API
| 维度 | 本地 Ollama + Qwen2.5:7b | 云 API |
|---|---|---|
| 成本 | 一次性拉取,本地推理零边际成本 | 按 token 持续计费 |
| 数据 | 不出域,符合制造数据安全要求 | 出域,敏感数据需脱敏 |
| 能力 | 7b 对复杂推理有限 | 强 |
| 适用 | 工具编排 / 结构化输出足够 | 复杂生成、长上下文 |
取舍结论:数据敏感 + 成本敏感 + 场景是「工具编排+结构化汇总」,本地模型够用,数据不出域是制造业硬约束。实测也暴露了 7b 的边界(漏调工具),所以编排层兜底是必选项,不是可选项。
7.2 调度:APScheduler vs DolphinScheduler
| 维度 | APScheduler(本期) | DolphinScheduler(第二期) |
|---|---|---|
| 部署 | 进程内,零独立部署 | 独立集群 |
| 持久化 | SQLAlchemyJobStore | 原生分布式调度 |
| 对接成本 | 直接 import 即用 | 需开发 HTTP 调用接口 |
| 适用 | 单任务定时巡检 | 多任务企业级编排 |
取舍结论:本期是「每小时巡检一次」的单点需求,APScheduler 足够。第二期把巡检注册为 DS 工作流节点即可。
八、两个必须说清的局限
- 3σ 对高斯尾部会误报,且随数据量线性放大。实测三级对照:1000 行误报 3 个 → 50500 行 256 个 → 50 万行 2,734 个(振动 1,339 + 电流 1,395),占比从 13% 升到 21%。生产口径应换 IQR/MAD 稳健统计量 + 滑动窗口基线 + 按列聚合报警。日增百万行的产线不处理,运维会被假警报淹没。
- 演示阈值刻意低于生产阈值。本文空值 1%、重复 0.5% 是为直观看到报警;生产口径是空值 >5%、重复 >2%(见《制造数据治理巡检-设计方案》),切换只改
config.py一处。本地 demo 仅验证链路,生产数据量级对接 Doris 取数是第二期。
九、实践成果与标准对标
| 维度 | 人工方式 | Agent 方式(V2.0 实测) |
|---|---|---|
| 巡检机制 | 出问题才查 | 定时常态化(26s/次,50 万行) |
| 可复现性 | 依赖个人经验 | 固定种子 + 注入基准 1:1 核对 |
| 脏数据覆盖 | 四类内容问题 | 四类 + 9 类结构边缘场景 |
| 编排可靠性 | 无 | 提示词约束 + 编排层兜底双防线 |
| 报告 | 手动整理 | 自动结构化报告(JSON + 中文摘要) |
最核心的价值:从被动排查变成主动巡检,且每一条检出都可溯源到注入基准。
本方案对应 GB/T 39116-2020「数据资源」能力域(辅域):实现数据质量自动化巡检与问题预警,为智能制造的数据驱动决策打地基。
总结:可复用的方法论
- 五个检测项分两层:结构体检管接入,四项内容检测管数据本体,互不重叠。
- 结构化返回:所有工具返回统一字典,Agent 才能稳定识别与汇总。
- 阈值与参数集中配置:
.env覆盖 +config.py收口,从 1000 行到 50 万行零代码改动。 - 流程完整性由代码保证:凡是靠模型自觉的环节都要有兜底,Agent 漏调工具就是实测教训。
- 选型讲 trade-off:数据不出域优先于能力上限,单点需求不上重型调度。
- 案例数字必须可溯源:注入基准 + 固定种子,局限主动说清,不假装完美。
【有感而发】
做了二十多年制造业数据,最深的感受是:数据质量从来都不是一劳永逸的事。把检测分层、把阈值收口、把兜底做足,工具才能真正跑起来,而不是摆样子给领导看。
📎 系列导航
关于作者:制造业数据与AI践行者老蒋,23 年 IT 老兵。聚焦离散制造业数据治理、工业数仓、AI Agent 工程化落地。只写自己跑通过的东西。全系列导航台账
交流互动:你在制造企业数据质量管理中遇到过哪些脏数据?空值、重复、异常、延迟之外,编码乱码和字段错位是不是也踩过?欢迎评论区交流,我会逐一回复。
标签:#制造业数据 #数据质量巡检 #AI Agent #数据治理 #工业大数据 #Python实战 #智能工厂 #脏数据检测

 408


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


