logstash7.0.1将数据从mysql5.7同步至es7.0.1大数据量下同步慢的问题

【elasticsearch专题】:Logstash从入门到同步MySQL数据 日志处理对于任何现代IT系统都是关键部分,本教程专为新手设计,通过详细解释Logstash的三大核心组件,为您展示如何从零开始搭建强大的日志处理系统。您还将学习如何同步MySQL数据到Elasticsearch,并通过一个"Hello World"示例快速入门。无论您是完全的新手还是有一些基础,本教程都将引导您顺利掌握Logstash的基本操作和高级应用。 阅读详情

先说结论

博主不比比,先说结论
首先我们分为两种情况
全量导库:以主键id的方式写sql语句分页导入es
增量倒库:按数据修改时间的时间字段进行到库

按时间字段进行增量导库

原因:如果我们按修改时间的字段来进行全量倒库,那么logstash的sql语句在大数据量的时候会非常慢,因为logstash在我们的sql之外又套了一层
如:logstash里的mysql.conf文件里的sql

SELECT * FROM article_lib WHERE update_time >= '2021-01-01 10:06:00'

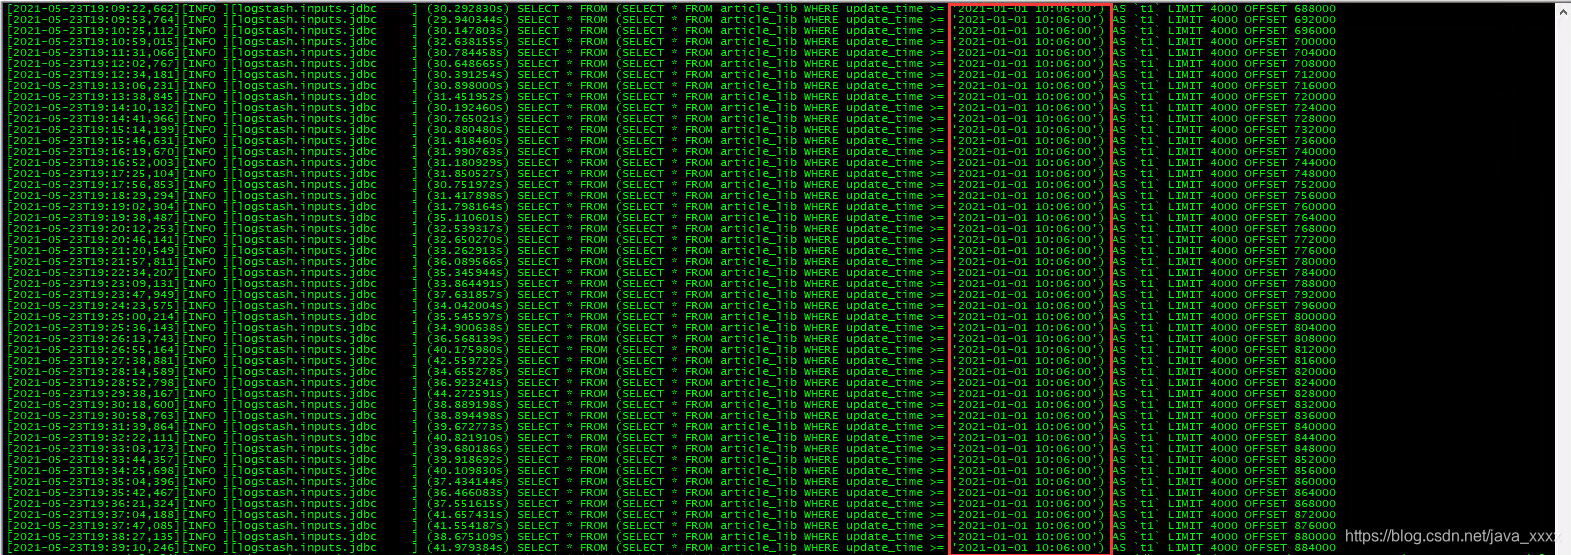
但是logstash执行的时候又给我们套了一层。这样的话当数据量大的时候offset偏移量也越来越大,导致sql的查询效率太低,在下亲测在导入到200w条数据的时候查询一次需要30min左右。

SELECT * FROM (SELECT * FROM article_lib WHERE update_time >= '2021-01-01 10:06:00') AS `t1` LIMIT 4000 OFFSET 884000

比如在200w的数据库全量导入到es,此时如果按照时间字段的方式导入,例如在配置文件中初始时间设置为’2000-01-01’那么它将查询大于该时间的所有的数据,然后再自己慢慢分页,于是就查询就特别慢,而且这是一次定时器的执行,也就是说在这次定时器未执行完毕之前,logstash的sql_last_value是不会更新值的。
在这里插入图片描述

优点:按时间字段适合增量导库,在全量导库之后再进行增量导库,此时给logstash指定一个上次运行时间,因为进行过增量导库,于是指定最新的时间即可,数据也就不会太多,也就避免了mysqlsql深度分页瓶颈,mysql数据库的表里需要维护一个时间字段,当程序里的数据进行修改的时候,也要修改该时间字段的值。而且优点在于,每当数据库里得数据有修改,在程序中mysql里该条数据得时间字段也得修改,此时logstash就可以将所有修改或者新增得数据同步至es。达到几乎实时同步的效果。
缺点:如果数据量太大,那么logstash自动在我们配置文件的sql语句外再加一个分页,会有mysql的深度分页瓶颈,效率相当之低。博主吐血亲测。。。300w的数据,用了48个小时还多。。。。

按主键id进行全量导库

全量导入按照id来进行导入,mysql.conf里的sql语句
sql语句

SELECT * from article_lib where article_id > 390 limit 10

logstash执行的时候sql

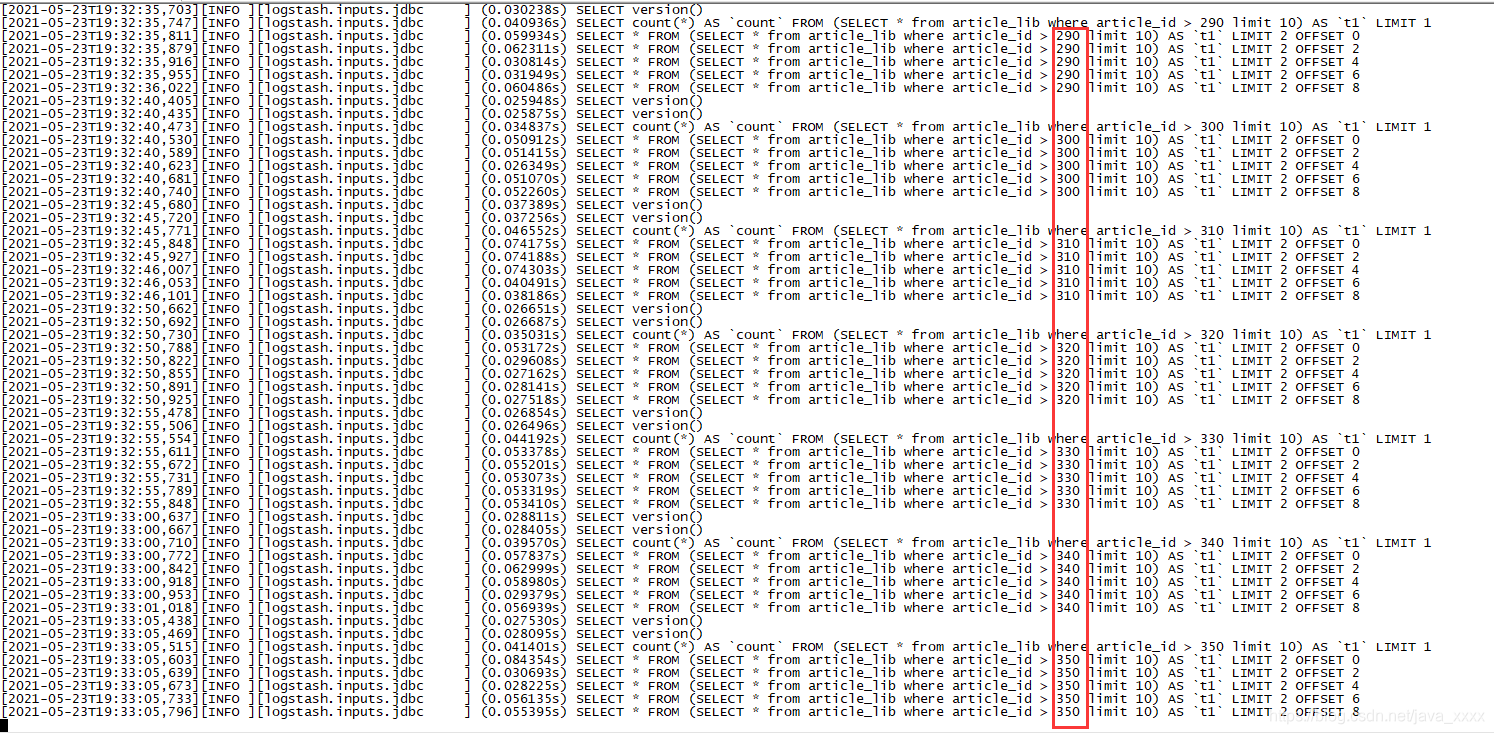
SELECT * FROM (SELECT * from article_lib where article_id > 390 limit 10) AS `t1` LIMIT 2 OFFSET 4

这样的好处在于每次执行完毕,就将本次执行的最后的id记录进sql_last_value,然后下次再按照该值进行分页查询,这种方式的效率比 按时间来进行全量导库 就快在它有分页,按时间来进行全量导库是全量全查出来,然后logstash再自己分页,这样的查询是很慢的。
在这里插入图片描述

如果是按时间增量导入,但是我们也在sql语句里分页呢,答案是不行的,
例如下面,logstash查询完只是查询了4000条数据,然后本次定时器执行完毕,将时间写入last_run_metadata_path配置的文件中,坑比的事来了,它写入的是当前执行时间,即当前时间“2021-05-23”,而不是上一条数据里记录时间字段记录的修改时间,于是下次执行就读取2021-05-23这个时间往下去执行,中间的所有数据全部都被跳过了。。。

优点:可以自己分页,加快的查询的速度,大大降低了mysql的深度分页瓶颈
缺点:当在程序里有数据被修改时,没法同步更新到es里。因为是按id,只会同步id越来越大的。

SELECT * FROM article_lib WHERE update_time >= '2021-01-01 10:06:00' limit 4000

总结,就算是一张卫生纸,一条内裤都有它本身的用处。没有什么方法是多余的,每种方法都有它对应的场景,在合适的场景下利用合适的方法,会达到事半功倍的效果。

附加上两种情况下的配置

按id全量导入

全量导入:
last_run_metadata_path配置文件last_id.txt

配置想要开始导库的id值

0

mysql_all.conf

input {

  jdbc {

    jdbc_driver_library => "/root/logstash7.0.1/mysql-connector-java-5.1.18.jar"

    jdbc_driver_class => "com.mysql.jdbc.Driver"

    jdbc_connection_string => "jdbc:mysql://rm-bp1ud1aqb980hj62i9o.mysql.rds.aliyuncs.com:3306/web-monitor"

    jdbc_user => "account"

    jdbc_password => "password"

    tracking_column => article_id

    record_last_run => true

    tracking_column_type => "numeric"
	#按id导入的时候一定要开启,否则字段类型就是默认的timestamp
    use_column_value => true

    clean_run => false

    jdbc_paging_enabled => "true"

    jdbc_page_size => "4000"

    last_run_metadata_path => "/root/logstash7.0.1/logstash-7.0.1/config/last_id.txt"

    schedule => "*/5 * * * * *"

    statement => "SELECT * from article_lib where article_id > :sql_last_value limit 4000"

  }

}


output {

  #stdout { codec =>  "rubydebug"}

  elasticsearch {

	  hosts => "127.0.0.1:9201"

      index => "idx_article"

      document_id => "%{article_id}"

  }

}


按时间增量导入

last_run_metadata_path配置文件last_time.txt

--- 2021-05-23 10:55:00.788057000 Z

mysql.conf配置文件

input {

  jdbc {

    jdbc_driver_library => "/root/logstash7.0.1/mysql-connector-java-5.1.18.jar"

    jdbc_driver_class => "com.mysql.jdbc.Driver"

    jdbc_connection_string => "jdbc:mysql://rm-bp1ud1aqb980hj62i9o.mysql.rds.aliyuncs.com:3306/web-monitor"

    jdbc_user => "account"

    jdbc_password => "password"

    tracking_column => publish_time

    record_last_run => true

    tracking_column_type => "timestamp"

    #use_column_value => true

    clean_run => false

    jdbc_paging_enabled => "true"

    jdbc_page_size => "2"

    last_run_metadata_path => "/root/logstash7.0.1/logstash-7.0.1/config/last_time.txt"

    schedule => "*/5 * * * * *"

    statement => "SELECT * from article_lib where publish_time > :sql_last_value"

  }

}


output {

  #stdout { codec =>  "rubydebug"}

  elasticsearch {

	  hosts => "127.0.0.1:9201"

      index => "idx_article"

      document_id => "%{article_id}"

  }

}


logstash后台启动命令

启动logstash

nohup ./logstash -f /root/logstash-7.0.1/config/mysql.conf &

总结

总结:全量倒库,或者第一次将所有数据通过logstash将mysql的数据导入es的时候采用按id的方式导入。当导入完毕之后,再采用增量导入的方式同步数据。
其实本质的问题还是logstash对mysql的语句优化不够导致查询mysql数据太慢。

就算是一张卫生纸,一条内裤都有它本身的用处。没有什么方法是多余的,每种方法都有它对应的场景,在合适的场景下利用合适的方法,会达到事半功倍的效果。

Ubuntu 18.04 部署 Elastic Stack 实战指南:Elasticsearch 7.17.22 稳态部署 Elastic Stack 是一套以 Elasticsearch 为核心、Logstash 为数据管道、Kibana 为可视化界面的开源可观测性平台,其本质是基于倒排索引与分布式搜索原理构建的实时数据分析系统。技术价值在于统一日志、指标与追踪数据的采集、处理与呈现能力,广泛应用于应用性能监控(APM)、安全信息与事件管理(SIEM)及运维故障诊断等场景。在 Ubuntu 18.04 这类已进入 EOL 的旧系统上,部署难点集中于 JVM 兼容性、内核参数限制(如 vm.max_map_count)及 sys 阅读详情

相关推荐

定期重启Logstash,并清除last_run_metadata_path数据。

使用find命令结合grep命令:find命令用于在指定目录及其子目录中查找文件,而grep可以在找到的文件中查找匹配内容。这条命令会在/path/to/directory目录下的所有文件中查找包含关键词"keyword"的文件。使用该参数后,grep命令将只显示包含匹配字符串的文件名,而不显示具体匹配内容。将只显示包含关键字”keyword”的文件名。:结束-exec命令,批量处理匹配到的文件。:对找到的每个文件执行后面的命令。:代表find命令找到的文件名。:仅选择类型为普通文件的项。

专注于计算机研发知识和资讯分享 518

Logstash导入mysql数据到es慢的解决方法

有一个千万级别的数据库存放在Mysql中,由于直接在Mysql中使用语句查询,一次的时间要十几分钟,无法满足应用的需求,因此考虑将其导入到elasticsearch中进行倒排索引查询。 使用的工具是Logstash,但是Logstash的导入速度随着导入数据量的增大变得越来越慢。查询后发现在数据量增大时变慢的原因是因为mysql的深度分页达到了瓶颈。因为logstash在我们自己写的的sql上又加了一层作为封装 在logstash的导入conf配置文件中的statement代码 SELECT * F

qq_38798909的博客 2825

ES数据同步:定时重启Logstash,并清除相关数据。

crontab 文件是一个用于定时执行任务的文件,其中包含了一系列的命令和任务,系统会按照预定的时间间隔来执行这些任务。-x [num]:设置 crontab 文件的加密级别,默认为 0,不加密。crontab 文件中的命令会在后台执行,不会在终端中显示输出结果,如果需要查看输出结果可以使用日志文件记录。使用 crontab -e 可以编辑当前用户的 crontab 文件,可以添加、删除和修改定时任务。-u user:指定要编辑的用户的 crontab 文件,默认为当前用户。

专注于计算机研发知识和资讯分享 1070

Logstash读取数据库表数据同步存储到指定的ES索引

如果linux不可联外网,从官网https://www.elastic.co/cn/downloads/past-releases#logstash 下载所需要对应的linux版本的logstash压缩包到本地,然后使用rz命令上传压缩文件到linux服务器上 或者使用wget命令直接在服务器上下载压缩包 wgethttps://artifacts.elastic.co/downloads/logstash/logstash-7.9.2.zip ...

m0_37845840的博客 2130

载波同步技术(一):BPSK的Costas Loop 载波同步

Author:McCrocodile 2010/11/04          载波的提取在相干解调中往往比较重要,根据信号中是否包含载频分量,载波同步一般也可以分为两种方法。包含载频分量的可以采用窄带滤波或者基本的锁相环环路来实现,不包含的则比较麻烦需要采用特殊的环路实现载波的同步。这里介绍的BPSK的载波恢复就属于后面一种。 对于不包含载频分量的信号载波同步一般有:同相-正交环(就是常说的Costas环)、判决反馈环(几乎可以适用所有调制方式)、同相-正交环衍生环(QPSK松尾环、N相同相-正交环)。

McCrocodile Blog 1万+

告别爆显存!手把手教你为ComfyUI+华为Atlas 300I Duo配置wan2.1视频生成工作流(含CPU-VAE参数)

本文详细介绍了华为Atlas 300I Duo与ComfyUI的深度适配实战,重点优化wan2.1视频生成工作流。从硬件散热改造到软件栈配置,再到ComfyUI专项优化,提供完整的解决方案,显著提升视频生成效率与稳定性,特别适合需要高效文生视频的应用场景。

weixin_26812607的博客 456

利用Logstash将MySQL/MairaDB 数据导入或同步到 Elasticsearch

利用Logstash将MySQL/MairaDB 数据导入或同步到 Elasticsearch

u013007181的博客 1313

ms17-010 永恒之蓝漏洞利用+抓包分析过程

一、实验环境: 1、攻击机:Kali 1)攻击工具:msf 2)分析工具:wireshark 3)IP地址:192.168.204.157(自动获得) 2、靶 机:Windows7 1)版本:SP1 2)开启网络共享(SMB协议) 3)关闭防火墙 4)IP地址:192.168.204.150(自动获得) 3、网卡连接方式:Vmnet8(NAT) 二、实验步骤: ...

qq_41976183的博客 6947

MySQL同步数据到Elasticsearch

MySQL同步数据到Elasticsearch

iiopsd的博客 4434

招标文件智能解析系统开发文档

本系统是一个基于OCR与大语言模型的招标文件智能解析平台,专门用于处理和分析招标文件,自动提取关键信息并进行结构化展示。

警世龙的技术博客 1925

合肥工业大学操作系统实验8

依据操作系统课程所介绍的地址映射与内存共享的原理,本实验的目的是深入理解物理内存的分页管理方式。 深入理解操作系统的段、页式内存管理。包括理解段表、二级页表,以及逻辑地址、线性地址、 物理地址的映射过程。编程实现段、页式内存管理上的内存共享,从而深入理解操作系统的内存管理。从而加深对教材上地址映射与内存共享的理解。

Martin-share的博客 1720

mysql-elasticsearch数据同步方案

mysql数据同步至elasticsearch方案,logstash、canal、MQ

zwjzone的博客 3547

全网首发--Unet3+改进16:在不同位置添加RepLKBlock超大卷积核

本文提出了一种基于大核卷积的神经网络架构RepLKNet,旨在缩小CNN与ViTs之间的性能差距。通过重新审视CNN中的大核设计,研究证明使用少量大卷积核替代多个小核能获得更强大的性能。提出的RepLKNet采用31×31大卷积核,在ImageNet和下游任务上取得了与SwinTransformer相当或更好的结果,同时具有更低延迟。文章详细介绍了实现步骤:(1)创建RepLKBlock模块文件;(2)在模型层中添加注意力机制;(3)在UNet模型中集成RepLKBlock;(4)完成训练流程。该方法展现了

AIcurator的博客 613

logstash增量同步mysql数据到es

本篇本章地址:https://www.cnblogs.com/Thehorse/p/11601013.html 今天我们来讲一下logstash同步mysql数据到es 我认为呢,logstash是众多同步mysql数据到es的插件中,最稳定并且最容易配置的一个。 input { stdin { } jdbc { type => "xxx" ...

weixin_30679823的博客 1171

AUTOSAR进阶图解==>AUTOSAR_SWS_BSWGeneral

本文详细解析AUTOSAR基础软件(BSW)模块的通用规范,涵盖其分层架构、配置管理、初始化流程和状态转换机制。AUTOSAR采用清晰的分层设计,包括应用层、服务层、ECU抽象层和微控制器抽象层,各层模块通过标准化接口交互。BSW模块配置采用类型化定义,支持预初始化、初始化和后期构建配置。文档还阐述了模块初始化流程中的依赖管理,以及运行时的状态转换与错误处理机制,为汽车电子控制单元的标准化开发提供规范指导。

一名留德华的,康德的信徒的,专注于汽车电子领域的博客 1125

在 SAP 中,Primary Cost Element(初级成本要素)与Secondary Cost Element(次级成本要素)的核心区别、作用及业务含义可归纳如下

摘要:SAP中初级成本要素与次级成本要素的核心区别在于:初级要素必须关联FI模块的损益科目,直接影响财务报表,用于记录外部成本(如电费、薪酬);次级要素仅存在于CO模块,用于内部成本分配(如分摊、作业分配),不影响外部报表。初级要素是"外部成本入口",次级要素是"内部成本搬运工",二者共同实现成本的多维度追踪与管理。

金牌架构师 759

MySQL到ES数据同步:Logstash增量同步的5个实战避坑技巧

本文深入剖析了使用Logstash实现MySQL到Elasticsearch增量数据同步的实战技巧。针对生产环境中常见的数据丢失、重复、延迟等痛点,重点分享了临界值处理、分页优化、事务延迟应对、性能调优及故障排查等5个核心避坑方案,帮助开发者构建稳定高效的数据同步管道。

pandas7gardener的博客 585

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Logstash同步MySQL数据到ES的5种实战方案对比:从定时轮询到Binlog监听

本文深入对比了使用Logstash将MySQL数据同步到Elasticsearch的五种实战方案,涵盖从简单的定时全量同步到高效的增量同步,再到基于Binlog监听的准实时同步。文章详细解析了每种方案的实现原理、配置细节、性能表现与适用场景,并提供了清晰的决策框架,帮助开发者根据数据规模、实时性要求等业务特点选择最优的增量同步策略。

lilh34434的博客 198

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

logstash7.8同步mysql数据

参考文章 https://www.cnblogs.com/wueryuan/p/13230849.html logstash下载 参考之前ES文章开头有地址 mysql驱动下载 在Logstash目录下新建mysql文件夹并进入 mkdir mysql cd mysql 下载mysql驱动并解压缩 mysql驱动官网 点Archives找到想要的版本,5.x以上一般都可以,复制路径,在linxu里wget wget https://downloads.mysql.com/archives/get/

酒剑仙的技术心得 634

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

ELK(Elasticsearch、Kibana、Logstash)以及向ES导入mysql数据库数据或CSV文件数据,创建索引和可视化数据

在Products和version处分别选择需要下载的产品和版本,E(elasticsearch)L(logstash)K(kibana)三者版本必须相同将下载好的elk分别解压到相同路径下。

超级无敌王大侠的博客 4333

从Oracle到Elasticsearch:手把手教你用Logstash JDBC同步业务日志(含增量同步避坑指南)

本文详细介绍了如何使用Logstash JDBC将Oracle业务日志高效同步到Elasticsearch,包含增量同步的优化策略和常见问题解决方案。通过版本管理、驱动配置、核心参数调优等实战技巧,帮助企业构建稳定的日志监控分析平台,提升ELK生态下的日志处理效率。

weixin_30530939的博客 404

ES不同服务器间数据迁移

ES数据迁移

h1403635700的博客 2074

ElasticSearch与spring boot的集成使用

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_33861800的博客 393

ElasticSearch与SpringBoot的集成使用

一、ElasticSearch了解 ElasticSearch是一个基于lucene的分布式检索服务器。相对于solr搜索,在大数据量和数据并发量上更有优势,同时,也有数据库的数据存储功能,但提供了比数据库更多的存储功能,如分词搜索、关联度搜索等,同时搜索速度也不是一个级别,达到百万数据/秒的查询数据。总结优点为:实时搜索、稳定、可靠、快速、安装方便等。 ElasticSearch中的概念(或叫做结构)和数据库中进行对比: (1)index:索引,相当于...

cb_hw_18的博客 805

elasticsearch7.3介绍 安装 简单使用

** elasticsearch介绍 ** 有道云笔记 文档:elasticsearch.note 链接:http://note.youdao.com/noteshare?id=dbcad48557e3f29ba1757efa9855b1cd&sub=9D16FADECB714D0092CA85888AECB6C6 Elasticsearch 是一个分布式、高扩展、高实时的搜索与数据分析引擎。它能很方便的使大量数据具有搜索、分析和探索的能力。 Elasticsearch是与名为Logstash的数

问心.心问的博客 405

电商搜索架构实战:从数据库LIKE到Elasticsearch高性能检索服务设计

在互联网应用中,高效的数据检索是提升用户体验和商业效率的核心技术。其基本原理是通过倒排索引等数据结构,将非结构化的文本信息转化为可快速查询的格式,从而实现毫秒级的响应速度。这项技术的核心价值在于能够处理海量数据,支持复杂的过滤、排序和聚合操作,广泛应用于电商、内容平台、日志分析等场景。以电商平台为例,商品搜索服务需要解决“快、准、灵、智、稳”五大痛点,传统数据库的LIKE查询或简单全文索引在数据量增长后会遇到性能瓶颈和功能限制。通过引入Elasticsearch分布式搜索引擎,并结合Canal实现MySQL

weixin_34320159的博客 335
上一篇: 并发编程之四:并发之共享问题、线程安全、synchronized关键字
下一篇: 并发编程之五:synchronized底层原理、monitor、轻量级锁、偏向锁、wati/notify/notifyAll、join、状态转换
java_xxxx
博客等级 码龄9年 127粉丝 99原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值