小米发布MiMo-V2-Pro,在人工智能分析指数中得分为49,介于Kimi K2.5和GLM-5之间

MIMO2.6、GLM5.3、deepseek4.1实测:工作流模型选型指南 在自动化工作流中,模型选型直接影响任务稳定性。长上下文保持、结构化输出与语气保留是复合任务的常见挑战。不同模型在语义理解、去重能力和格式稳定性上存在差异,需根据任务形态匹配。例如,MIMO2.6 FLASH在短文本抽取中高效,GLM5.3FLASH擅长规整化改写,而deepseek4.1flash在长上下文和语气平衡上表现突出。合理选型可提升工作流效率,减少返工。本文基于实测,分析三个模型在电商内容生成等场景的适配性,为开发者提供选型参考。 阅读详情

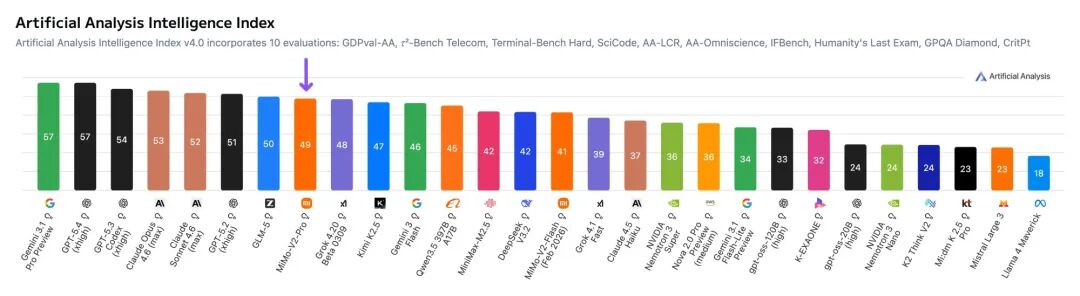
小米发布了MiMo-V2-Pro,在人工智能分析指数中得分为49,介于Kimi K2.5和GLM-5之间
XiaomiMiMo-V2-Pro是一款新的推理型号,较其之前的开放重量版本MiMo-V2-Flash(总309B/15B活跃,MIT许可)有了显著升级,后者在智能指数中得分为41。小米尚未公布该型号的重量,目前仅通过小米的第一方API提供。

主要要点:

在人工智能分析指数中,MiMo-V2-Pro得分仅次于GLM-5(Reasoning,50)。

它领先于Kimi K2.5(推理,47)和Qwen3.5 397B A17B(推理,45)。

在整体排行榜上,它排名第10,仅次于GPT-5.2 Codex(xhigh,49),高于Grok 4.20 Beta(Reasoning,48)

  • 在GDPval-AA(代理性现实世界工作任务)上以1426的Elo领先,领先于同类模型:在GDPval-AA上,MiMo-V2-Pro领先GLM-5(推理,1406)、Kimi K2.5(推理,1283)和Qwen3.5 397B A17B(推理,1209)。GPT-5.4(xhigh)和Claude Sonnet 4.6(适应性推理,最大努力)分别拥有1667和1633的Elo。

  • 由低幻觉驱动的竞争性AA-全知指数:MiMo-V2-Pro得分为+5,领先GLM-5(推理+2)、Kimi K2.5(推理,-8)和Qwen3.5 397B A17B(推理,-30)。作为背景介绍,Claude Opus 4.6(自适应推理,最大努力,+14)和Gemini 3.1 Pro Preview(+33)依然领先

  • MiMo-V2-Pro 比同类更高效。它使用了7700万个输出令牌来运行人工智能指数,远低于GLM-5(推理,109M)和Kimi K2.5(推理,89M)

  • MiMo-V2-Pro 运行人工智能分析智能指数的成本为348美元,每100万个输入/输出代币售价为1/3美元。尽管GLM-5在智力指数中得分仅低1分,但其价格仍低于GLM-5。作为对比,GPT-5.2(xhigh)售价为2304美元,Claude Opus 4.6(适应性推理,最大努力)售价为2486美元
Image

关键型号信息:

  • 上下文窗口:100万个代币

  • 定价:每100万个输入/输出代币1美元/3美元,25.6万代币输入;每100万输入/输出代币2美元/6美元,100万代币输入

  • 可用性:仅支持小米第一方 API

  • 模态:仅输入和输出文本(无多模态)

模型链接,目前免费使用:https://mimo.xiaomi.com

OpenRouter 周榜实证:用真实流量数据做国产大模型选型决策(2026.6 第 3 周) 这一期的最大焦点是 DeepSeek-V4-Flash 连续第 5 周登顶。但很多评论文章漏掉了一个细节——DeepSeek 旗下还有一款定位"旗舰"的 DeepSeek-V4-Pro,为什么挂在头版的是 Flash 而不是 Pro?这个问题的答案,就是 OpenRouter 这种"路由层 + 比价"场景下选型逻辑的最佳样本。先看产品参数。根据DeepSeek V4 发布公告和DeepSeek-V4-Flash 官方介绍维度总参数 / 激活参数1.6T / 49B284B / 13B上下文窗口。 阅读详情

相关推荐

2026大模型能力分层与实战选型指南

大模型已从单一通用能力演进为按任务切片的专业化能力体系。其核心原理在于通过模型架构解耦(如MoE稀疏激活、动态推理路径)、能力模块化(代码理解、OCR、物理仿真)与硬件亲和优化,实现精度、延迟、成本的精准平衡。这种技术价值直接支撑智能体编程、实时客服、工业数字孪生等工程落地场景。本文聚焦2026年主流开源与闭源模型的能力矩阵、混合推理机制及世界模型工业应用,提供可复用的选型方法论与系统集成避坑实践。

abcyan1235的博客 378

测一波MiMo 2.5 Pro,看看真实实力!

小米MiMo 2.5Pro大模型测评:速度亮眼但智力稍逊 近期小米推出MiMo 2.5Pro大模型并配套营销活动引发关注。测试显示该模型在速度方面表现突出:端到端速度、解码速度和Token消耗效率均领先国内同类产品,在Claw-Eval榜单上性价比排名数一数二。基准数据显示其通用智能体能力国内最强,编程智能体表现尚可。 但在实际测试中,MiMo 2.5Pro展现出明显短板:在空间推理、帽子逻辑等智力测试中出现错误,正确率仅60%,而DeepSeekV4Pro保持全对。实战项目中,MiMo完成代码升级任务用时

jarvisuni的博客 1244

2026国产大模型硬核深度对比:从技术参数、实测能力到场景选型全解析

核心优势:百万级超长上下文、全球开源第一的Agent能力、行业顶尖Token推理效率、端侧云端协同、完全开源商用;致命短板:通用科学推理、通识知识能力偏科严重,学术、复杂科研场景表现拉胯;精准适配场景:AI自动化工作流、超长文档批量处理、端侧AI部署、多步骤Agent任务开发。1.彻底告别全能内卷:所有头部模型均聚焦单点专精,场景化、垂直化成为核心竞争力,通用全能模型不再是主流;2.技术架构定型:MoE混合专家架构全面普及,参数效率持续提升,推理成本大幅下降,商用落地门槛持续降低;3.能力局部反超海外。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 510

小米的MiMo-V2-Flash,谷歌味挺浓

小米的风格是这样:当别人做得火热时,它先开始观望,等大家把路线探得差不多之后,它开始下场超车了。手机是如此,汽车是如此,MiMo亦是如此。总体来看,它不像是DeepSeek,能整新鲜的想法,它更多是把人家已经比较成熟的想法拼装起来。拼装的技术也是技术,就像是开源方案那么多,能整合用好,解决问题的仍然不多。MiMo-V2-Flash 一下子成绩追上来,速度还极快,确实有点超乎预期。这个模型当前仅支持文本输入,按照它的风格,下一步估计是扩展规模或者加入多模态,可以起名为 MiMo-V2-Pro了。

兴趣使然的创作者 2115

手把手教你用Apple Developer App完成苹果开发者账号注册(含证件验证失败解决方案)

本文详细指导如何通过Apple Developer App完成苹果开发者账号注册,特别针对证件验证失败问题提供解决方案。从准备工作到注册流程,再到验证失败的处理方法,帮助开发者顺利完成注册,避免常见错误。

moss5的博客 1161

STM32移植LVGL(LittleVGL)

**STM32移植LVGL(LittleVGL)**

qq_53000374的博客 1万+

这一波MiMo2.5pro被DeepSeek V4 完虐了!

MiMo 送了我 16 亿 tokens,我很开心,所以我决定好好测一测!我说过,一旦我认真测,总是很容易发现问题!为了测试最新的 MiMo 2.5 Pro 的实力,我专门让 Claude Opus 4.7 出了一个题目!而且还拉上了国内的主流模型,比如 DeepSeek V4 Pro、GLM5.1、Kimi K2.6、MiniMax M2.7。我还专门为它升级了我的测试系统!下面就来看一下具体的情况吧。

jarvisuni的博客 1202

Nsight Compute内存图表实战:如何快速定位CUDA内核的内存瓶颈(附配置截图)

本文详细介绍了如何使用Nsight Compute的Memory Chart功能快速定位和诊断CUDA内核中的内存性能瓶颈。通过解析内存图表中的逻辑与物理单元节点、连线颜色含义,并结合实战案例(如低L1缓存命中率、共享内存Bank冲突、全局内存访问未合并),指导开发者从可视化数据回溯至源代码,进行精准有效的内存访问优化,从而提升GPU程序性能。

zeta9的博客 482

阿里云百炼Coding Plan显示售罄、Lite版本停售、Pro版本买不到,怎么办?

短期:定闹钟每天 9:30 抢 Pro 版本。长期或体验:改用百炼 API 直调模型,功能上没有区别,只是成本结构和计费方式不同,价格相对贵一些吧。如果用量大且稳定,也可关注后续是否有新的套餐或活动推出。我自己购买的是Lite版本的,然后续了一个月。

2403_89345764的博客 1735

无网络环境部署:手动获取并安装OneNote for Windows 10完整指南

本文提供了一份详尽的OneNote for Windows 10离线安装指南。针对无网络或内网隔离环境,详细介绍了如何从官方渠道获取正确的产品ID,利用第三方工具下载纯净的.appxbundle安装包,并解决系统兼容性与依赖框架问题。最后,通过PowerShell管理员命令完成安全部署,是IT管理员和高级用户在离线环境下部署UWP应用的实用参考。

loss4bartender的博客 496

SAP MD09 事务码中的物料需求追溯详解

物料需求追溯是指在物料需求计划中,追踪特定物料的需求来源和满足方式的过程。它帮助企业确定每个需求(如销售订单、独立需求、预留等)是由哪些供应元素(如库存、生产订单、采购订单等)来满足的。通过这种追溯,企业可以了解需求和供应之间的关系,从而优化生产和采购计划,减少库存积压,提升供应链效率。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1197

DeepSeek V4-Pro vs MiMo-V2.5-Pro:全面深度对比

摘要 2026年4月,DeepSeek V4-Pro和MiMo-V2.5-Pro两款开源MoE大模型相继发布。第三方评测显示:MiMo-V2.5-Pro在Artificial Analysis Intelligence Index以54分与Kimi K2.6并列开源第一,而DeepSeek V4-Pro以52分紧随其后;在GDPval-AA Agent测试中两者并列开源榜首。SuperCLUE中文评测中V4-Pro总分70.98大幅领先MiMo-V2-Pro的60.67,尤其在指令遵循和智能体规划优势明显。

qq_68247957的博客 6832

UNet 改进(3):CBAM模块的融合创新

CBAM模块可以灵活地添加到网络的不同位置,本实现选择在初始卷积后添加,既提升了性能又不过度增加计算负担。UNet_CBAM通过集成注意力机制,使网络能够自动聚焦于图像中最相关的区域和特征通道,从而提升了分割性能。然而,传统的UNet在处理复杂场景时,对所有空间位置和通道特征一视同仁,这可能导致对重要特征的关注不足。在实际应用中,特别是在医学图像分析等需要精确分割的场景中,UNet_CBAM展现出了优异的性能。:CBAM添加的计算量很小,却能带来显著的性能提升,具有很好的性价比。

2401_82355416的博客 1645

小米深夜认领榜一神秘大模型,MiMo-V2-Pro重磅发布!雷军直言:已超马斯克的Grok

➤ 在 GDPval-AA(面向真实世界任务的智能体基准)中,MiMo-V2-Pro 以 1426 Elo 领先同类模型,包括 GLM-5(1406)、Kimi K2.5(1283)和 Qwen3.5 397B A17B(1209)。➤ 凭借较低的幻觉率,MiMo-V2-Pro 在 AA 全知指数(Omniscience Index)中获得 +5,领先 GLM-5(+2)、Kimi K2.5(-8)和 Qwen3.5(-30)。如果说过去的竞争是“谁更会对话”,那么接下来的竞争,可能会变成——谁更能行动。

优快云资讯 4824

地球引擎初级教程:Python API 的安装和介绍

地球引擎的 Python API 提供了许多功能和工具,用于访问和处理地理空间数据。连接到地球引擎在编写地球引擎的 Python 脚本时,首先需要连接到地球引擎服务器。import ee # 初始化地球引擎 ee . Initialize()这将初始化地球引擎并建立与服务器的连接。加载和显示图像使用地球引擎的 Python API,您可以加载和显示卫星图像。import ee# 初始化地球引擎# 加载 Landsat 8 影像# 显示影像print('影像 URL:', url)

UePostscript的博客 1008

【生产实践】PostgreSQL高可用Patroni安装(超详细已踩坑)

一 安装Patroni 0 Patroni 对Python的版本要求 我安装的是Patroni最新版本 :4.0.3,Patroni 对Python 版本有要求,没有具体的版本矩阵,但是根据每个版本发布信息可以得到以下信息 Patroni 4.0 需要 Python 3.8 以上(可以根据下面发布版本信息推理出) Version 3.0.2 Version 3.0.2 dropped support of Python older than 3.6. 版本3.0.2不再支持3.6版本以下的P

DBA之路的博客 1742

国内 AI Coding Plan 指南:高性价比套餐对比 × 榨干GLM × 套餐选择

本人从 2023 年 2 月开始接触 AI 工具辅助编程,近 3 年 AI IDE(Cursor、Trae、Qoder)和 1 年终端 Agent(CC、OpenCode)的使用经验,国内外基本所有套餐都用过,各厂商的政策变动都很熟悉。最近很多在国企工作的朋友都在问我国内有没有好的推荐,因为国企只报销国产模型,打工人谁会自愿付费上班呢,问的人多了就有了这篇文章,希望这篇文章能帮到囊中羞涩的个人开发者和打工族,当然还有我们可爱的学生党。

qq_44781343的博客 6423

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

2026年4月中国AI大模型全景报告:九大模型密集发布,国产AI迎来“Agent爆发周”

回顾整个4月,从月之暗面的Kimi K2.6全球首度登顶,到阿里云盘踞国产最强综合AI模型,再到DeepSeek以1.6万亿参数+昇腾适配震撼业界——国产AI正从比拼参数的“内卷”转向关注Agent能力的“团战”。一个清晰的趋势已经浮现:中国即将在2026年出现数以万计的AI Agent自主执行各类编程、数据分析、多模态生成任务。AI将真正从“聊天对话界面的枯燥输出”变成能独立工作一整天的企业数字员工。而早期做出选择、抢先融入生态的中小开发者团队,有望在明年Agent为王的爆发浪潮中脱颖而出。

nmdbbzcl的博客 5378

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Agentic RAG 自动修正闭环:5 国产旗舰打分屠夫

本文介绍了Agentic RAG(自主修正检索增强生成)系统的核心原理与实践经验。作者通过5款国产大模型(qwen3.7-max、glm-5.2等)在真实工单场景下的测试,揭示了不同模型在相关性打分(relevance)和信息覆盖度(coverage)上的显著差异(最高与最低相差一个数量级)。文章详细阐述了自动修正闭环的状态机设计,包括查询改写、检索、打分和重试机制,并分享了生产环境中的路由策略、监控指标和容灾方案。最后指出了Agentic RAG的适用边界(文档量、实时性要求等场景)

gl366的博客 355

1:大模型全景图 | 谁在领跑,谁在追赶

如果你还停留在“OpenAI遥遥领先、国产在追赶”的旧认知里,是时候刷新一下了。 2026年7月的真实图景是:海外“交替领先、终局未定”,国产从“跟随者”蜕变为“规则重构者” -1。开源模型与闭源模型的差距已缩小至3.3% ,而在API调用量前五名中,全部为开源模型——其中DeepSeek V4 Flash凭借月均18.4T Tokens登顶全球榜首。

骥龙信息的博客 483

当AI大模型开始内卷 普通人该怎么办?

小米MiMo系列有三款上榜(V2-Pro第2、V2-Flash第5、7B-RL第10),阿里Qwen3系列从6亿到2350亿参数全覆盖,DeepSeek-R1在代码能力上依然强悍,月之暗面的Kimi K2.5更是拿到了AIME 96.10的成绩——这已经是闭源顶级模型的水准。对我们普通人来说,这种"神仙打架"的直接感受是:工具变好了,但选择变难了。MiMo-V2-Pro提供了足够强的大脑,OpenClaw提供了足够简单的接口——两者的结合,让"人人有AI助手"不再是一句口号,而是正在发生的现实。

weixin_44347185的博客 432

【AI前沿】2026年7月14日-中国大模型11周霸榜全球,算电协同引爆分布式算力革命

AI推理负载规模将达到训练的十亿倍。随着AI Agent、多模态生成、实时交互类应用全面铺开,传统集中式数据中心的延迟、成本和合规问题开始暴露。应用场景首Token时延要求传统数据中心瓶颈游戏实时交互<15ms网络延迟不可突破电商推荐~20ms跨域传输开销大AI Agent多轮对话<50ms集中式调度拥堵自动驾驶边缘推理<10ms安全合规限制"算力下沉、边缘优先"已成为全行业共识。

求知若渴、虚心若愚 215

【AI前沿】2026.08.12 英伟达万亿参数Nemotron 4开源+5000亿AI基建基金+Claude隐形水印全球推行

第一层:算力基建进入"资本密集型"阶段。5000亿美元基建基金+8000亿元Terafab工厂+高盛预测万亿投资,标志着AI算力建设已从企业级投入升级为国家/金融资本级战略。对工程师而言,算力获取方式将从"自建为主"转向"租赁+按需调用为主",云原生AI基础设施工程能力成为刚需。第二层:开源模型进入"万亿参数"时代。Nemotron 4开源万亿基座+中国模型霸榜调用榜,说明开源模型已从"追赶者"变为"引领者"。工程师选型时需要重新评估开源vs闭源的TCO,开源模型的微调、部署、运维工程能力价值凸显。

求知若渴、虚心若愚 223

Wand-Enhancer 免费解锁完整教程:如何本地给 Wand(WeMod)修改器打上零成本高级补丁

Wand-Enhancer 是一款开源的 Wand(WeMod)修改器本地补丁工具,它能在你的电脑上免费解锁原本要 Pro 订阅才能用的能力——AI 智能修改、手机远程控制面板、去广告去限制。整个过程不经过任何外部服务器,只要按下面顺序走一遍,今天就能跑通。 ## 💬 动手之前,先把大家最担心的几件事说透 **「这玩意儿算不算破解,会不会有法律或封号风险?」** 它没有改任何服务端逻辑,也不

gitblog_00491的博客 192

开源模型盛宴:【Gemma 4、DeepSeek V4、Kimi K2.6、MiMo 2.5、GLM-5.1 深度评测】——开源 AI 的“寒武纪大爆发“

2026年4-5月,开源AI领域迎来"寒武纪大爆发",五大旗舰模型同期发布:Google的Gemma 4提供从手机到工作站的全尺寸覆盖;DeepSeek V4以1.6T参数成为规模之王;Kimi K2.6具备4000+工具调用能力;MiMo V2.5实现全模态理解;GLM-5.1专注8小时自主编码。CAISI V4评估显示,Kimi K2.6和MiMo V2.5 Pro以54分并列开源第一,DeepSeek V4 Pro以52分紧随其后。MoE架构成为主流,能以1/3-1/30的推理成本实现同等性能。开源A

小李同学_LSH的博客 2877

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 352
上一篇: 月薪4万的研发天天喊内耗想裸辞,我只问了他一个问题,他立马就老实了
下一篇: 37岁,公司要裁他,赔偿金20万不肯给,这哥们儿就硬坐着不走。每天按时打卡上班,活照干,月薪2.6万照领,一坐就是8个月。
Java思维导图
博客等级 码龄10年 306粉丝 71原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值