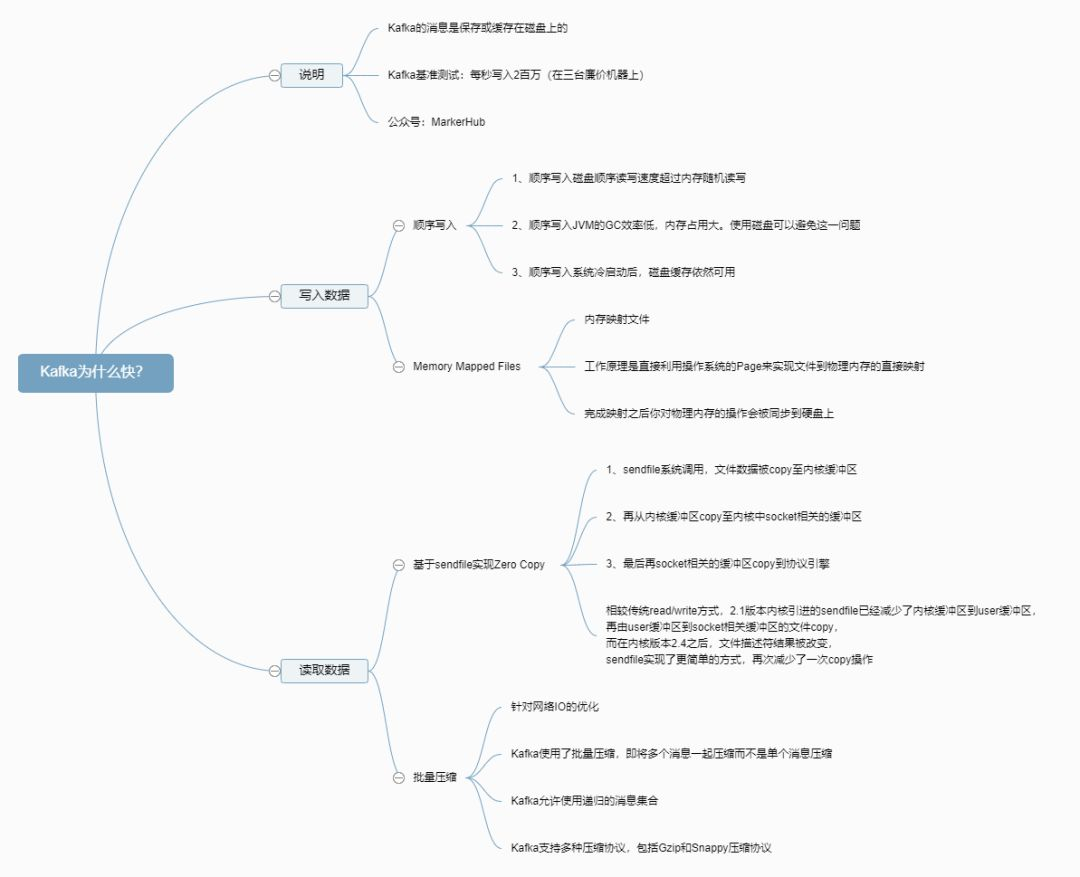
Kafka为什么速度那么快?

快手面试题详解: Kafka为什么能那么快的6个原因 无论 kafka 作为 MQ 也好,作为存储层也罢,无非就是两个功能(好简单的样子),一是 Producer 生产的数据存到 broker,二是 Consumer 从 broker 读取数据。那 Kafka 的快也就体现在读写两个方面了,下面我们就聊聊 Kafka 快的原因。 1. 利用 Partition 实现并行处理 我们都知道 Kafka 是一个 Pub-Sub 的消息系统,无论是发布还是订阅,都要指定 Topic。 Topic 只是一个逻辑的概念。每个 Topic 都包含一个或多个 . 阅读详情

  • 作者:邴越

  • 来源:cnblogs.com/binyue/p/10308754.html

Kafka 的消息是保存或缓存在磁盘上的,一般认为在磁盘上读写数据是会降低性能的,因为寻址会比较消耗时间,但是实际上,Kafka 的特性之一就是高吞吐率。

即使是普通的服务器,Kafka 也可以轻松支持每秒百万级的写入请求,超过了大部分的消息中间件,这种特性也使得 Kafka 在日志处理等海量数据场景广泛应用。

针对 Kafka 的基准测试可以参考,Apache Kafka 基准测试:每秒写入 2 百万(在三台廉价机器上)

下面从数据写入和读取两方面分析,为什么 Kafka 速度这么快。

一、写入数据

Kafka 会把收到的消息都写入到硬盘中,它绝对不会丢失数据。为了优化写入速度 Kafka 采用了两个技术, 顺序写入和 MMFile 。

1、顺序写入

磁盘读写的快慢取决于你怎么使用它,也就是顺序读写或者随机读写。在顺序读写的情况下,磁盘的顺序读写速度和内存持平。

因为硬盘是机械结构,每次读写都会寻址 -> 写入,其中寻址是一个 “机械动作”,它是最耗时的。所以硬盘最讨厌随机 I/O,最喜欢顺序 I/O。为了提高读写硬盘的速度,Kafka 就是使用顺序 I/O。

而且 Linux 对于磁盘的读写优化也比较多,包括 read-ahead 和 write-behind,磁盘缓存等。如果在内存做这些操作的时候,一个是 JAVA 对象的内存开销很大,另一个是随着堆内存数据的增多,JAVA 的 GC 时间会变得很长,使用磁盘操作有以下几个好处:

1、顺序写入磁盘顺序读写速度超过内存随机读写

2、顺序写入 JVM 的 GC 效率低,内存占用大。使用磁盘可以避免这一问题

3、顺序写入系统冷启动后,磁盘缓存依然可用

下图就展示了 Kafka 是如何写入数据的, 每一个 Partition 其实都是一个文件 ,收到消息后 Kafka 会把数据插入到文件末尾(虚框部分):
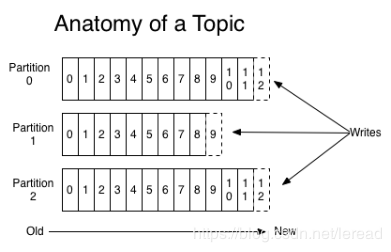
这种方法有一个缺陷——没有办法删除数据 ,所以 Kafka 是不会删除数据的,它会把所有的数据都保留下来,每个消费者(Consumer)对每个 Topic 都有一个 offset 用来表示读取到了第几条数据 。
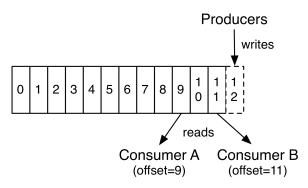
两个消费者:

1、顺序写入 Consumer1 有两个 offset 分别对应 Partition0、Partition1(假设每一个 Topic 一个 Partition);

2、顺序写入 Consumer2 有一个 offset 对应 Partition2。

这个 offset 是由客户端 SDK 负责保存的,Kafka 的 Broker 完全无视这个东西的存在;一般情况下 SDK 会把它保存到 Zookeeper 里面,所以需要给 Consumer 提供 zookeeper 的地址。

如果不删除硬盘肯定会被撑满,所以 Kakfa 提供了两种策略来删除数据:

1、顺序写入一是基于时间。

2、顺序写入二是基于 partition 文件大小。

具体配置可以参看它的配置文档

2、Memory Mapped Files

即便是顺序写入硬盘,硬盘的访问速度还是不可能追上内存。所以 Kafka 的数据并不是实时的写入硬盘 ,它充分利用了现代操作系统分页存储来利用内存提高 I/O 效率。

Memory Mapped Files(后面简称 mmap) 也被翻译成 内存映射文件 ,在 64 位操作系统中一般可以表示 20G 的数据文件,它的工作原理是直接利用操作系统的 Page 来实现文件到物理内存的直接映射。

完成映射之后你对物理内存的操作会被同步到硬盘上(操作系统在适当的时候)。

通过 mmap,进程像读写硬盘一样读写内存(当然是虚拟机内存),也不必关心内存的大小有虚拟内存为我们兜底。

使用这种方式可以获取很大的 I/O 提升,省去了用户空间到内核空间复制的开销(调用文件的 read 会把数据先放到内核空间的内存中,然后再复制到用户空间的内存中。)

但也有一个很明显的缺陷——不可靠,写到 mmap 中的数据并没有被真正的写到硬盘,操作系统会在程序主动调用 flush 的时候才把数据真正的写到硬盘。

Kafka 提供了一个参数——producer.type 来控制是不是主动 flush,如果 Kafka 写入到 mmap 之后就立即 flush 然后再返回 Producer 叫 同步 (sync);写入 mmap 之后立即返回 Producer 不调用 flush 叫异步 (async)。

二、读取数据

Kafka 在读取磁盘时做了哪些优化?

1、基于 sendfile 实现 Zero Copy

传统模式下,当需要对一个文件进行传输的时候,其具体流程细节如下:

1、基于 sendfile 实现 Zero Copy 调用 read 函数,文件数据被 copy 到内核缓冲区

2、read 函数返回,文件数据从内核缓冲区 copy 到用户缓冲区

3、write 函数调用,将文件数据从用户缓冲区 copy 到内核与 socket 相关的缓冲区。

4、数据从 socket 缓冲区 copy 到相关协议引擎。

以上细节是传统 read/write 方式进行网络文件传输的方式,我们可以看到,在这个过程当中,文件数据实际上是经过了四次 copy 操作:

硬盘—> 内核 buf—> 用户 buf—>socket 相关缓冲区—> 协议引擎

而 sendfile 系统调用则提供了一种减少以上多次 copy,提升文件传输性能的方法。

在内核版本 2.1 中,引入了 sendfile 系统调用,以简化网络上和两个本地文件之间的数据传输。sendfile 的引入不仅减少了数据复制,还减少了上下文切换。

sendfile(socket, file, len);

运行流程如下:

1、sendfile 系统调用,文件数据被 copy 至内核缓冲区

2、再从内核缓冲区 copy 至内核中 socket 相关的缓冲区

3、最后再 socket 相关的缓冲区 copy 到协议引擎

相较传统 read/write 方式,2.1 版本内核引进的 sendfile 已经减少了内核缓冲区到 user 缓冲区,再由 user 缓冲区到 socket 相关缓冲区的文件 copy,而在内核版本 2.4 之后,文件描述符结果被改变,sendfile 实现了更简单的方式,再次减少了一次 copy 操作。

在 Apache、Nginx、lighttpd 等 web 服务器当中,都有一项 sendfile 相关的配置,使用 sendfile 可以大幅提升文件传输性能。

Kafka 把所有的消息都存放在一个一个的文件中,当消费者需要数据的时候 Kafka 直接把文件发送给消费者,配合 mmap 作为文件读写方式,直接把它传给 sendfile。

2、批量压缩

在很多情况下,系统的瓶颈不是 CPU 或磁盘,而是网络 IO,对于需要在广域网上的数据中心之间发送消息的数据流水线尤其如此。进行数据压缩会消耗少量的 CPU 资源, 不过对于 kafka 而言, 网络 IO 更应该需要考虑。

1、如果每个消息都压缩,但是压缩率相对很低,所以 Kafka 使用了批量压缩,即将多个消息一起压缩而不是单个消息压缩

2、Kafka 允许使用递归的消息集合,批量的消息可以通过压缩的形式传输并且在日志中也可以保持压缩格式,直到被消费者解压缩

3、Kafka 支持多种压缩协议,包括 Gzip 和 Snappy 压缩协议

三、总结

Kafka 速度的秘诀在于,它把所有的消息都变成一个批量的文件,并且进行合理的批量压缩,减少网络 IO 损耗,通过 mmap 提高 I/O 速度,写入数据的时候由于单个 Partion 是末尾添加所以速度最优;读取数据的时候配合 sendfile 直接暴力输出。

(完)

(java思维导图)

长按关注,每天java一下,成就架构师

我就知道你在看!

利用Python实现纬度加权平均(即NCL中的wgt_areaave) 当处理全球数据的时候,最常见的分析就是全球、北半球平均了,这时候一定要注意要根据纬度等信息进行加权,求加权平均,要不然结果肯定会不准。但是对于Python中,常规的计算包里面是没有的,或许现在有其他包可以实现,也可以告诉我~。 阅读详情

相关推荐

CAN收发器TJA1145A休眠唤醒应用

TJA1145的唤醒工作原理主要依赖于其内部的唤醒机制和外部硬件的配合,主要涉及低功耗状态、选择性唤醒功能。TJA1145是一款CAN收发器,它支持多种工作模式,包括NormalStandbySleep等。在这些模式中,Sleep模式是最低功耗状态,而Normal模式则是最活跃的状态,其中Standby模式处于两者之间,允许一定的功能操作但功耗较低。TJA1145可以通过接收特定的唤醒源从Sleep或Standby模式唤醒到Standby或Normal模式。唤醒源的检测与处理。

radix关于mcu的博客,持续更新中... 5957

Kafka为什么性能这么快?4大核心原因详解

通过这种分区分段的设计,Kafka 的 message 消息实际上是分布式存储在一个一个小的 segment 中的,每次文件操作也是直接操作的 segment。这种分区分段+索引的设计,不仅提升了数据读取的效率,同时也提高了数据操作的并行度。另一个主要功能是 kafka 写数据的时候,是以磁盘顺序写的方式来写的,也就是说仅仅将数据追加到文件的末尾,不是在文件的随机位置来修改数据。即采用磁盘顺序写,这样就不需要寻道时间,只需很少的旋转时间,将数据追加到文件的末尾,不是在文件的随机位置来修改数据。

延宝小白马的博客 1354

为什么我把「大模型Clouder认证:基于百炼平台构建智能体应用」作为大模型学习的第一站?从 0 到拿证全流程经验分享

【摘要】作为一个刚拿下「大模型 Clouder 认证:基于百炼平台构建智能体应用」的过来人,想在开头就和大家聊聊这个认证的特殊意义 —— 在企业加速 AI 落地的今天,能用低代码快速构建智能体应用,已经成为 AI 从业者的核心竞争力。无论是企业微信客服提效、钉钉机器人自动化办公,还是网站智能助手升级,这些场景化能力正是当下数字化转型的刚需。

davidkorhenn的博客 1531

kafka为什么这么快?

下面从数据写入和读取两方面分析,为什么Kafka速度这么快。 一、写入数据 1. 利用 Partition 实现并行处理 我们都知道 Kafka 是一个 Pub-Sub 的消息系统,无论是发布还是订阅,都要指定 Topic。 Topic 只是一个逻辑的概念。每个 Topic 都包含一个或多个 Partition,不同 Partition 可位于不同节点。 一方面,由于不同 Partition 可位于不同机器,因此可以充分利用集群优势,实现机器间的并行处理。另一方面,由于 Partition 在物理上对应一个

xsjzn的博客 510

【推荐100个unity插件】unity易于使用模块化设计的天空、体积云和天气系统——Enviro 3

Enviro 3是一款功能强大的Unity天空与天气系统插件,提供动态天空、体积云、天气模拟等丰富功能。安装时需将预制体拖入场景并配置主相机,URP支持需激活深度纹理和添加渲染特性。模块化设计允许自由添加/移除时间、光照、雾效等模块,并通过API控制参数。推荐配合色调映射(如ACES模式)获得最佳视觉效果。插件支持季节、温湿度模拟及闪电风暴等特效,适用于需要逼真环境渲染的Unity项目。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 2096

OTA 升级失败/回滚策略设计:打造安全可靠的双分区/断点续传/签名校验方案

双分区机制(A/B Partitioning)是OTA升级的“保险箱”。简单来说,设备存储分为两个分区:A分区(当前运行)和B分区(备用)。升级时,新固件写入B分区,A分区保持不变。如果升级成功,系统切换到B分区运行;如果失败,设备直接回滚到A分区,完全不受影响。这就像玩游戏存档:你打Boss前存了个档,万一挂了还能读档重来。双分区就是设备的“读档”机制,避免了变砖的尴尬。以Android设备为例,Google从Android 7.0开始强制引入A/B分区机制(Seamless Updates)。

大模型大数据攻城狮的专栏 1235

Kafka 为什么这么快?

Kafka 为什么这么快? 顺序读写、零拷贝、分区并发、批量、压缩、稀疏索引

杨宇昌的博客 777

LVGL iPhone Duo 开合过渡

环境:LVGL 9.x(需要软件模糊),窗口建议 1280×800。界面文案英文(默认 Montserrat 无 CJK)。

摸鱼专家 153

kafka为什么速度快总结

kafka被广泛运用在各个系统中,被用来充当消息的中间件与数据总线的功能。而且我们都知道,kafka是基于磁盘存储的,但是描述kafka的形容词,最常见的经常有诸如速度快,延时小,吞吐量大这些,吞吐量能达到几十w甚至上百万每秒。而这些形容词,却与磁盘来说是格格不入的。所以kafka为什么快就成了一个经典的问题,下面我们就来进行初步总结。

bitcarmanlee的博客 2293

基于反事实的因果推理Causal inference based on counterfactuals--一万六千字文献详细解读(因果关系的推理应用)【全文总结】

基于反事实的因果推理Causal inference based on counterfactuals--一万六千字文献详细解读(因果关系的推理应用)【全文总结】---来自一位即将入学的准研一,也希望这篇文章能够激励自己不断走下去!!

qq_46044325的博客 4442

Proxmox VE 9 更换源

创建一键更换Proxmox VE 9.0源的Bash脚本,实现快速替换软件源。脚本需包含订阅提醒关闭功能,兼容Proxmox VE 9.0系统,执行命令为bash /proxmox_9.0_Repo.sh。该工具可简化源配置过程,自动处理系统更新源替换及订阅提示屏蔽,适合需要快速配置Proxmox环境的用户使用。

极致,细节 4989

为什么kafka速度这么快

Kafka的消息是保存或缓存在磁盘上的,一般认为在磁盘上读写数据是会降低性能的,因为寻址会比较消耗时间,但是实际上,Kafka的特性之一就是高吞吐率。 即使是普通的服务器,Kafka也可以轻松支持每秒百万级的写入请求,超过了大部分的消息中间件,这种特性也使得Kafka在日志处理等海量数据场景广泛应用。 针对Kafka的基准测试可以参考,Apache Kafka基准测试:每秒写入2百万(在三台廉...

疯一样的女子 625

31.华为路由器:PPPOE配置模拟实验及NAT配置

实验环境 pppoe-client上面的接口信息 [AR1]dis ip interface brief *down: administratively down ^down: standby (l): loopback (s): spoofing The number of interface that is UP in Physical is 2 The number of interface that is DOWN in Physical is 1 The number of interface

迷逝 8118

为什么 Kafka 速度那么快?

作者:架构进化论 https://www.cnblogs.com/binyue/p/10308754.html Kafka的消息是保存或缓存在磁盘上的,一般认为在磁盘上读写数据是会降低性能的,因为寻址会比较消耗时间,但是实际上,Kafka的特性之一就是高吞吐率。 即使是普通的服务器,Kafka也可以轻松支持每秒百万级的写入请求,超过了大部分的消息中间件,这种特性也使得Kafka在日志处理等海...

Java技术栈,分享最主流的Java技术 1034

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Kafka速度为什么快

在之前的《Kafka基本概念整理》文章中曾经说过,Kafka中一个Topic会分成多个Partition,并且每个Partition都有一个leader和零或多个followers。所有的读写操作都由leader处理,一般分区的数量都比broker的数量多的多,各分区的leader均匀的分布在brokers中。 本篇文章来说明下Kafka速度为什么这么快的原因,核心就是Memor...

淡定一生2333的博客 1069

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

为什么Kafka速度那么快

为什么Kafka使用磁盘比内存快 Kafka的消息是保存或缓存在磁盘上的,你可能会认为:在磁盘上读写数据是会降低性能的,因为寻址会比较消耗时间。事实上,磁盘读写的快慢取决于你怎么使用它(顺序读写、随机读写)。 在顺序读写的情况下,磁盘的顺序读写速度和内存持平。 而且Linux对于磁盘的读写优化也比较多,包括read-ahead和write-behind,磁盘缓存等。如果在内存做这些操作的时候,一个...

互联网架构师笔记 1870

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Kafka 什么速度那么快

Kafka 采用了批量发送消息的方式,通过将多条消息按照分区进行分组,然后每次发送一个消息集合,看似很平常的一个手段,其实它大大提升了 Kafka 的吞吐量。

旷野历程 1587

kafka为什么速度这么快

原文链接:toutiao.com/a6762044417072169485我们都知道Kafka非常快,比绝大多数的市场上其他消息中间件都要快。这里来研究下那么为什么Kafka那么快(当然...

程序员闪充宝 224

Kafka 为什么速度那么快?

Kafka的消息是保存或缓存在磁盘上的,一般认为在磁盘上读写数据是会降低性能的,因为寻址会比较消耗时间,但是实际上,Kafka的特性之一就是高吞吐率。 即使是普通的服务器,Kafka也可以轻松支持每秒百万级的写入请求,超过了大部分的消息中间件,这种特性也使得Kafka在日志处理等海量数据场景广泛应用。 针对Kafka的基准测试可以参考,Apache Kafka基准测试:每秒写入2百万(在三台廉价机器上) 下面从数据写入和读取两方面分析,为什么Kafka速度这么快。 一、写入数据 Kafka会把收到

weixin_42073629的博客 162

Kafka为什么速度这么快?

目录 数据写入 顺序写入 Memory Mapped Files 读取数据 传统模式 Zero Copy 批量压缩 总结 数据写入 Kafka消息是保存在磁盘上的。 As you can see, it’s not that different. But still, sequential memory access is faster than ...

幸爷的博客 1294
上一篇: 面试了一个10年的老Java,结果连幂等性都不会!
下一篇: 梳理Java知识,解析开源项目
Java思维导图
博客等级 码龄10年 306粉丝 71原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值