LSTM 原理详解手动编写LSTM模型代码

【机器学习】LSTM(长短期记忆网络)详解 长短期记忆网络(Long Short-Term Memory, LSTM)是一种特殊的循环神经网络(RNN)架构,旨在解决传统RNN在处理长序列时容易出现的梯度消失/爆炸问题。LSTM通过精心设计的门控机制,能够更好地捕捉长期依赖关系,在自然语言处理、语音识别、时间序列预测等领域取得了卓越的成绩。本文将详细介绍LSTM的工作原理、前向传播过程以及在实际任务中的应用。 阅读详情

b站手把手编写lstm模型

为什么要有 LSTM?

普通 RNN 有长依赖遗忘问题:
序列很长时,梯度反向传播会梯度消失/梯度爆炸,RNN 记不住很早之前的信息,就像鱼的记忆只有7秒。
LSTM(长短期记忆网络) 就是为了解决:长序列记忆、梯度消失 问题,就像添加一个日记本,将记忆写到本子上。


核心思想

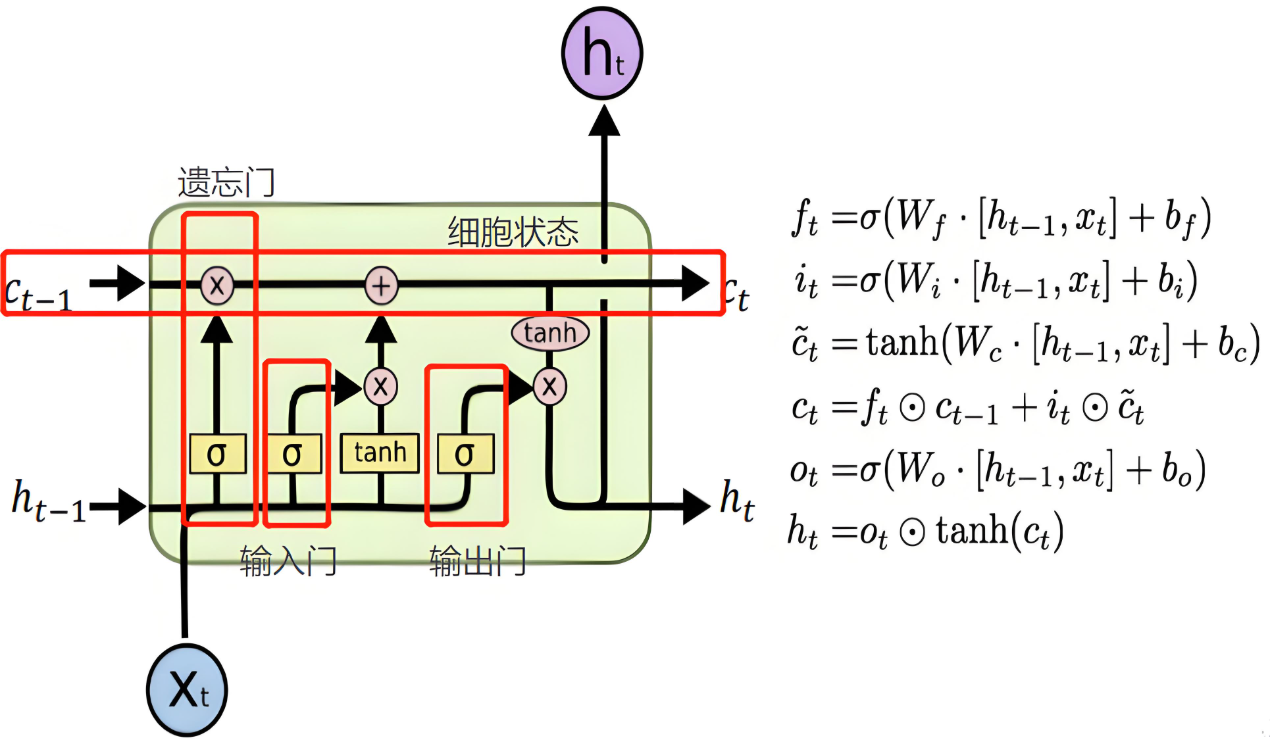
LSTM 相比普通 RNN,多了一个细胞状态 Cell State(日记本)

  • 细胞状态 C t C_t Ct​:长期记忆,像一个日记本,信息改动很小
  • 隐藏状态 h t h_t ht​:短期记忆,当前时刻输出 或者是人的记忆

LSTM 靠三个门控制信息流动:

  1. 遗忘门 Forget Gate:丢掉旧记忆
  2. 输入门 Input Gate:存入新记忆
  3. 输出门 Output Gate:把记忆输出

门结构

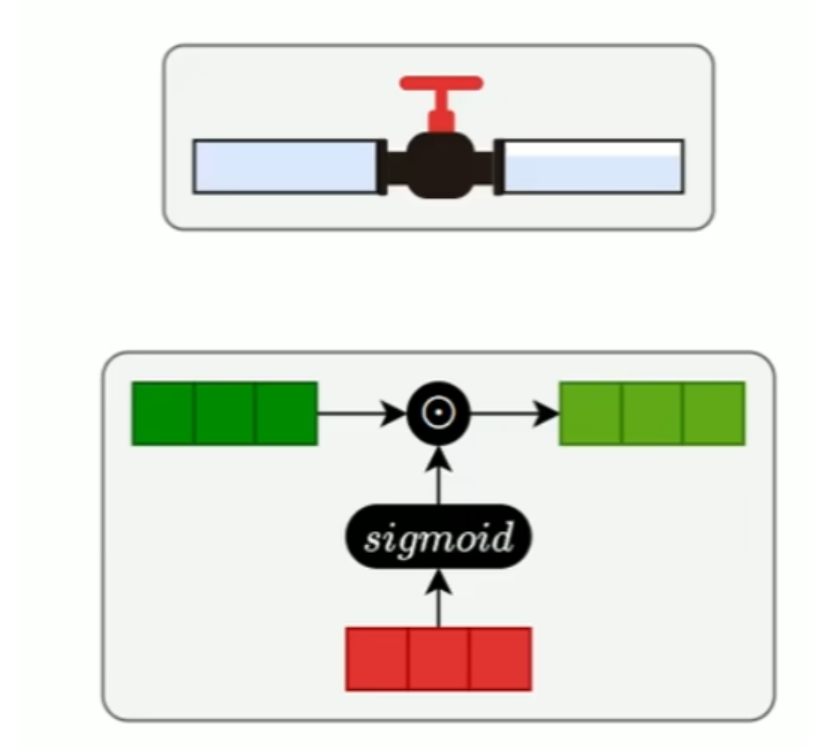
所有门都是 Sigmoid + 权重矩阵,输出 0~1:

  • 1:完全保留信息
  • 0:完全丢弃信息
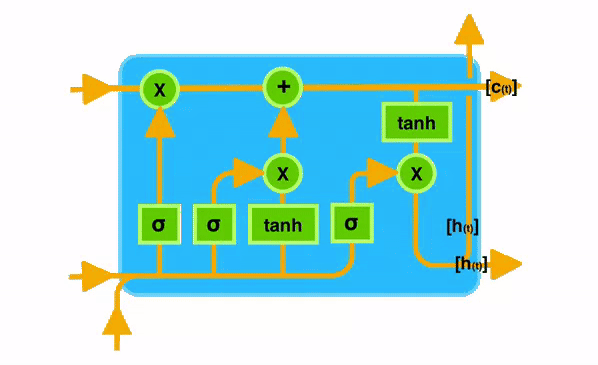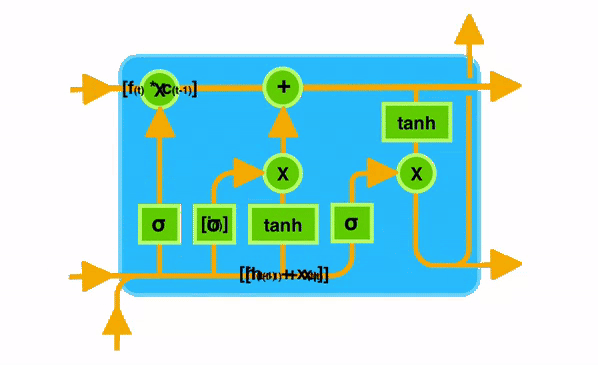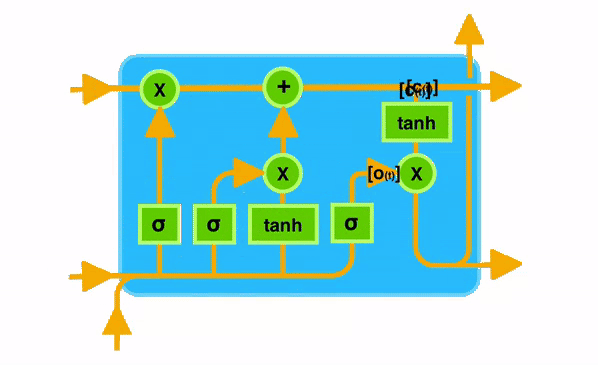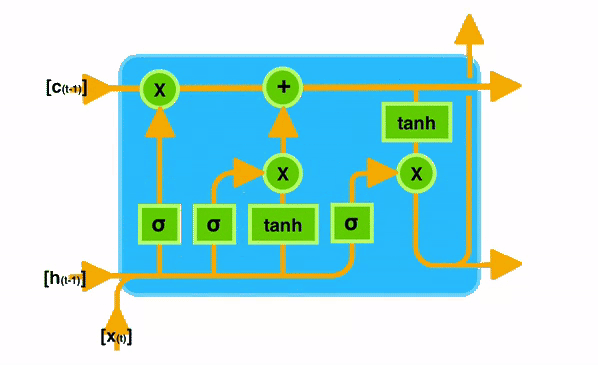
    在这里插入图片描述

逐模块拆解(公式+白话)

符号说明:

  • x t x_t xt​:当前时刻输入
  • h t − 1 h_{t-1} ht−1​:上一时刻隐藏状态
  • C t − 1 C_{t-1} Ct−1​:上一时刻细胞状态

在这里插入图片描述

遗忘门 Forget Gate

作用:决定从上一时刻的长期记忆里丢掉哪些信息
σ \sigma σ:sigmoid 输出 0~1 和 旧细胞状态 C t − 1 C_{t-1} Ct−1​ 逐元素相乘,决定保留多少旧记忆
f t = σ ( W x f x t + b x f + W h f h t − 1 + b h f ) \Large f_t = \sigma(W_{xf}x_t + b_{xf} + W_{hf}h_{t-1} + b_{hf}) ft​=σ(Wxf​xt​+bxf​+Whf​ht−1​+bhf​)

输入门 Input Gate 存入新信息

输入门:决定哪些新信息要存入长期记忆
i t = σ ( W x i x t + b x i + W h i h t − 1 + b h i ) \Large i_t = \sigma(W_{xi}x_t + b_{xi} + W_{hi}h_{t-1} + b_{hi}) it​=σ(Wxi​xt​+bxi​+Whi​ht−1​+bhi​)

候选记忆 C ~ t \tilde{C}_t C~t​:当前新生成的候选内容 用 tanh 把值缩放到 [-1,1]
C ~ t = tanh ⁡ ( W x c x t + b x c + W h c h t − 1 + b h c ) \Large \tilde{C}_t = \tanh(W_{xc}x_t + b_{xc} + W_{hc}h_{t-1} + b_{hc}) C~t​=tanh(Wxc​xt​+bxc​+Whc​ht−1​+bhc​)

更新细胞状态(核心传送带更新)

旧记忆过滤 + 新记忆写入
C t = f t ⊙ c t − 1 + i t ⊙ C ~ t \Large {C}_t = f_t \odot c_{t-1} + i_t \odot \tilde{C}_t Ct​=ft​⊙ct−1​+it​⊙C~t​

  • ⊙ \odot ⊙:逐元素相乘
  • 左边:保留的旧记忆
  • 右边:新增的新记忆

输出门 Output Gate

作用:决定把长期记忆哪部分输出给当前隐藏状态
输出门控制
o t = σ ( W x o x t + b x o + W h o h t − 1 + b h o ) \Large o_t = \sigma(W_{xo}x_t + b_{xo} + W_{ho}h_{t-1} + b_{ho}) ot​=σ(Wxo​xt​+bxo​+Who​ht−1​+bho​)
当前时刻隐藏状态输出
h t = o t ⊙ tanh ⁡ ( C t ) \Large h_t = o_t \odot \tanh(C_t) ht​=ot​⊙tanh(Ct​)


极简流程

在这里插入图片描述

代码看不懂的???----> b站手把手编写lstm模型

代码

import torch
import torch.nn as nn

# 固定随机种子,保证可复现
torch.manual_seed(42)

# 创建官方 LSTM 和自定义 LSTM
model = nn.LSTM(input_size=10, hidden_size=20, num_layers=1)


class MyLSTM(nn.Module):
    def __init__(self, input_size, hidden_size, num_layers=1):
        super().__init__()
        self.input_size = input_size
        self.hidden_size = hidden_size
        # LSTM 权重:4*hidden_size 对应 遗忘门(f)/输入门(i)/细胞候选(g)/输出门(o)
        # W_ix: (input_size, hidden_size),输入到隐藏层的权重
        self.W_ix = model.weight_ih_l0  # 转置以匹配矩阵乘法维度
        self.b_ix = model.bias_ih_l0  # 输入到隐藏层的偏置 (hidden_size,)
        # W_hh: (hidden_size, hidden_size),隐藏层到自身的权重
        self.W_hh = model.weight_hh_l0  # 转置以匹配矩阵乘法维度
        self.b_hh = model.bias_hh_l0  # 隐藏层到自身的偏置 (hidden_size,)

    def forward(self, x, hc):
        # 获取记忆,获取笔记
        h0, c0 = hc
        h0 = h0.squeeze(0)
        c0 = c0.squeeze(0)
        # 词语一个个的循环处理
        h_all = []
        for i in range(x.shape[0]):
            x_t = x[i]
            # 输入和记忆 w 和 b
            xi = x_t @ self.W_ix.t() + self.b_ix
            hh = h0 @ self.W_hh.t() + self.b_hh
            # 根据隐藏层,进行分割,获取四个门,获取四个门的输入
            hx_h = xi + hh
            i_hx, f_hx, g_hx, o_hx = torch.split(hx_h, self.hidden_size, dim=1)
            # 处理4个门
            # 输入门
            i = torch.sigmoid(i_hx)
            # 遗忘门
            f = torch.sigmoid(f_hx)
            # 候选细胞状态
            g = torch.tanh(g_hx)
            # 输出门
            o = torch.sigmoid(o_hx)
            # 笔记的只要一半
            f0 = f * c0
            # 需要记忆多少
            ih = i * g
            # 新笔记
            c1 = f0 + ih
            # 需要唤醒多少沉睡的记忆
            h1 = o * torch.tanh(c1)
            # 需要重新编程c0 和 h0,给下一个循环的单词使用
            c0 = c1
            h0 = h1
            h_all.append(h1)
        # 列表变张量
        h_all_t = torch.stack(h_all, dim=0)
        c1_t = c1.unsqueeze(0)
        h1_t = h1.unsqueeze(0)
        return h_all_t, (h1_t, c1_t)


mymodel = MyLSTM(input_size=10, hidden_size=20)
# 5个单词,3句话,10个维度
x = torch.randn(5, 3, 10)
# 1层,3句话 batch ,20隐藏层,,,第一个代表记忆,代表笔记本
hc = (torch.zeros(1, 3, 20), torch.zeros(1, 3, 20))
# 自己写的
mh_all, mhc = mymodel.forward(x, hc)
# 官方的结果
h_all, hc = model.forward(x, hc)

print(mh_all.shape)
print(h_all.shape)
print(mhc[0])
print(hc[0])

cha = torch.sum(torch.abs(mhc[0]- hc[0]))
print(cha)

总结

LSTM 用遗忘门、输入门、输出门三条开关,控制一条长期记忆传送带,有选择地忘记旧信息、存入新信息、输出有用信息,从而能处理长时序、记住久远依赖。


时序模型:长短期记忆网络(LSTM) 时序模型:长度记忆循环神经网络(LSTM) 阅读详情

相关推荐

四、长短期记忆网络(LSTM)数据驱动模型

长短期记忆网络(LSTM)数据驱动模型 5.1 基本原理 长短时记忆网络(Long Short Term Memory Network, LSTM),是一种改进之后的循环神经网络,可以解决RNN无法处理长距离的依赖的问题。在原始的 RNN 模型中,隐藏层只有一个状态,即h,RNN对于短期的输入非常敏感。如果此时再增加一个状态c,让它来保存长期的状态,那么则称之为称为单元状态(cell state)。 按照时间维度展开:在 t 时刻,LSTM 的输入有三个:分别是当前时刻网络的输入值 X_t、上一时刻

记录自己的成长 4191

LSTM原理详解

LSTM 长短时记忆网络(Long Short Term Memory Network, LSTM),是一种改进之后的循环神经网络,可以解决RNN无法处理长距离的依赖的问题,目前比较流行。 长短时记忆网络的思路: 原始 RNN 的隐藏层只有一个状态,即h,它对于短期的输入非常敏感。 再增加一个状态,即c,让它来保存长期的状态,称为单元状态(cell state)。 把上图按照时间维度展...

积累 沉淀 博学 广思 4万+

六、长短时记忆网络语言模型(LSTM)

用 tanh 函数层将当前时刻向量中的有效信息提取出来压缩映射到区间 (-1, 1) 中创造了一个当前单元状态的候选 C'(t),然后使用图中 tanh 函数层左侧的 sigmoid 函数来控制这些记忆要放“多少”进入单元状态(为每个分量做出评级 (0, 1),评级越高的会有越多的记忆进入单元状态)遗忘门 forget gate:LSTM会先根据新的输入和上一时刻的输出决定遗忘掉之前的哪些记忆——输入和上一步的输出会整合为一个单独的向量,然后通过sigmoid神经层,最后点对点的乘在单元状态上。

contributed_l的博客 2197

深度学习模型:BiLSTM (Bidirectional LSTM) - 双向长短时记忆网络详解

以股票价格预测为例,正向 LSTM 可以分析过去的价格走势对当前价格的影响,反向 LSTM 可以从未来的价格变化趋势中反推当前价格的潜在因素,两者结合可以更全面地预测股票价格的未来走势,提高预测的准确性和可靠性。例如,常见的做法是简单的拼接操作:,这样得到的隐藏状态 就同时包含了序列正向和反向的信息,能够更全面地捕捉序列的特征和上下文关系。BiLSTM 是在 LSTM 的基础上构建的,它在每个时间步上同时运行两个 LSTM,一个按照序列的正向顺序处理数据,另一个按照反向顺序处理数据。

池央的博客 1万+

LSTM(长短期记忆网络)详解

LSTM看了你就懂

一去不复返的通信er 2126

长短时记忆网络LSTM原理与代码实例讲解

长短时记忆网络LSTM原理与代码实例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 1. 背景介绍 1.1 问题的由来 随着自然语言处理、语音识别、机

AI天才研究院 1347

长短时记忆网络(Long Short Term Memory,LSTM)详解

长短时记忆网络(LSTM)基本原理与基于Pytorch的实现方法。

weixin_60737527的博客 1万+

长短时记忆网络 (LSTM) 原理与代码实例讲解

长短时记忆网络 (LSTM) 原理与代码实例讲解 关键词:长短时记忆网络(LSTM), 循环神经网络(RNN), 序列建模, 梯度消失, 细胞状态, 门控机制 1. 背景介绍 在深度学习中,循环神经网络(Rec

欢迎来到我的优快云空间!这里聚焦AI大模型应用实战,分享前沿技术、实战案例与开发经验。 1031

LSTM的手动推导与代码逐行实现

LSTM

peaunt1的博客 4880

SimpleFOC STM32实战:基于F103与HAL库,剖析速度环与电流环的协同控制

本文详细介绍了基于STM32F103与HAL库的SimpleFOC实战应用,重点剖析速度闭环控制与电流环的协同工作原理。通过开发环境搭建、参数调试技巧及性能优化方案,帮助开发者高效实现无刷电机精准控制,适用于机器人、无人机等高精度应用场景。

weixin_29170327的博客 478

AF驱动调试日志全解析:从配置到问题排查

本文全面解析AF驱动调试日志的配置、抓取与分析方法。从内核驱动与HAL层配置入手,确保日志正常输出,并详细解读开机初始化、马达识别、I2C通信等关键日志节点。通过多个实战案例,如对焦失败、前摄无功能、参数不生效及I2C报错等,系统性地展示了如何利用日志定位并解决AF对焦问题,是摄像头模组开发与调试的实用指南。

weixin_28285943的博客 307

LSTM原理详解及keras代码实现

LSTM原理及实现 RNN LSTM 实现 RNN基本原理 前言 当我们处理与事件发生的时间轴有关系的问题时,比如自然语言处理,文本处理,文字的上下文是有一定的关联性的;时间序列数据,如连续几天的天气状况,当日的天气情况与过去的几天有某些联系;又比如语音识别,机器翻译等。在考虑这些和时间轴相关的问题时,传统的神经网络就无能为力了,因此就有了RNN(recurrent neural network,循环神经网络),了解RNN先了解DNN基本原理。同样这里介绍RNN基本原理,也是为了铺垫我们的重点LSTM网络

weixin_42046792的博客 5797

数学建模国赛B题保姆级攻略:从选题到代码实现的完整流程(2024最新版)

本文提供2024年数学建模国赛B题的保姆级实战攻略,涵盖从赛题解构、模型构建到算法实现与论文撰写的完整流程。文章详细解析了如何快速抓住问题核心、建立数学模型、进行算法求解与结果可视化,并分享了高效团队协作与专业论文写作的关键技巧,助力参赛者系统性地完成从选题到代码实现的全过程。

weixin_29089057的博客 145

【机器学习】长短时记忆网络(LSTM)

文章目录1. 基本概念2. 长短时记忆网络的前向计算2.1 门2.2 遗忘门 1. 基本概念 长短时记忆网络(Long Short Term Memory Network, LSTM),它成功的解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多领域中成功应用。 原始RNN无法处理长距离依赖,原始RNN的隐藏层只有一个状态,即h,它对于短期的输入非常敏感。 长短时记忆网络在RNN的基础上再增加一个状态c,让它来保存长期的状态。 新增加的状态c,称为单元状态(cel

weixin_42301220的博客 8463

Multisim 11.0的安装破解汉化步骤

15:打开注册机,选择管理员运行,默认第一项,选择生成文件路径,这里不要随意选择,要找到你安装Multisim安装路径下Shard下的License Manager路径下,否则会报错,破解失败。14:后面会出现一个更新提示,选择否,然后选择重启电脑后,先不要选择重启电脑,在这里出现了问题(可能敲击回车,默认去重启电脑了),所以我说不要重启电脑,重启破解时右下角出现这,点击否。17:重启电脑,如果前面重启过,那可以跳过重启,应用程序下找到下图所示,启动。16:点击确认覆盖,路径下生成了该文件。

qq_53260940的博客 2377

OSG三维渲染引擎编程学习之一:“第一章:OSG介绍” 之 “1.1 OSG简介”

第一章:OSG介绍; 1.1 OSG简介。

LuckyHanMo的博客 3224

长短期记忆网络(LSTM)详解

和问题。LSTM通过引入独特的和,能够捕捉长时间跨度的依赖关系,成为自然语言处理、语音识别、时间序列预测等任务中的核心模型。以下将详细说明LSTM的结构、运作原理、门控机制及其相对于传统RNN的优势。

m0_73640344的博客 3881

某验SVG图标验证码识别思路(非训练)

本文提出了一种无需训练的某验SVG图标验证码识别方法。通过分析SVG文件结构,使用正则表达式提取静态图标数据,并借助CairoSVG库转换为PNG格式。随后采用坐标定位方式裁剪出12个固定位置的图标,最后利用ResNet50提取特征,通过余弦相似度匹配目标图标。该方法避免了训练目标检测模型,实现了高效准确的验证码识别。关键步骤包括SVG文件预处理、图标定位裁剪和基于预训练模型的相似度比对。

九月镇灵将的博客 419
上一篇: 时序模型血泪史:GRU 门控拆解 + 数学推导,看完直接避开梯度消失大坑
下一篇: LeNet5模型原理讲解-手写代码解析LeNet5模型
王_teacher
博客等级 码龄9年 118粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值