RedisTemplate同步大数据量性能实测

Redis详解 - SpringBoot整合Redis,RedisTemplate和注解两种方式的使用 本文主要讲 Redis 的使用,如何与 SpringBoot 项目整合,如何使用注解方式和 RedisTemplate 方式实现缓存。最后会给一个用 Redis 实现分布式锁,用在秒杀系统中的案例。 更多 Redis 的实际运用场景请关注开源项目 coderiver 项目地址:https://github.com/cachecats/coderiver 一、NoSQL 概述 什么是 NoSQL ?... 阅读详情

最近项目上有写入大量数据到 redis 中的需求,使用的是 springboot 集成 redis 客户端,就少不了使用 RedisTemplate 来操作。由于数据量比较多,是需要考虑写入性能问题的,如何才能高效写入到 redis 中呢?通过度娘知道了使用 pipelined 方式性能非常好,但是却没有解释为什么?带着这个疑惑进行了这次的实测。

环境

  • redis:使用本机 docker 启动的单节点服务
  • springboot 框架集成 redis 客户端

实测

RedisTemplate 的操作 api 有两种:

  1. 常规操作 API
  2. pipelined 操作 API

对两种操作 API 进行了简单的测试用例来实测,代码如下:

@SpringBootTest
@RunWith(SpringRunner.class)
public class PerformanceTest {

    @Autowired
    private RedisTemplate redisTemplate;


    @Test
    public void performanceTest() {
        // 均执行 2 万次的写入
        int batch = 20000;

        // 常规API
        System.out.println("************ 普通写法 ****************");
        String keyPrefix = "pt/performance_";
        long begin = System.currentTimeMillis();
        for (int i = 0; i < batch; i++) {
            redisTemplate.opsForValue().set(keyPrefix + i, keyPrefix + i);
        }
        System.out.println("普通执行结束,共耗时:" + (System.currentTimeMillis() - begin) + " ms");

        // pipeline API
        RedisSerializer keySerializer = redisTemplate.getKeySerializer();
        RedisSerializer valueSerializer = redisTemplate.getValueSerializer();
        begin = System.currentTimeMillis();
        redisTemplate.executePipelined((RedisCallback<String>) connection -> {
            for (int i = 0; i < batch; i++) {
                connection.stringCommands().set(keySerializer.serialize(keyPrefix + i), valueSerializer.serialize(keyPrefix + i));
            }
            System.out.println("pipeline 结束");
            return null;
        });
        System.out.println("pipeline 执行结束,共耗时:" + (System.currentTimeMillis() - begin) + " ms");
    }
}

两种写法均写入 20000 条数据,且key和value均一致;实测结果耗时如下:
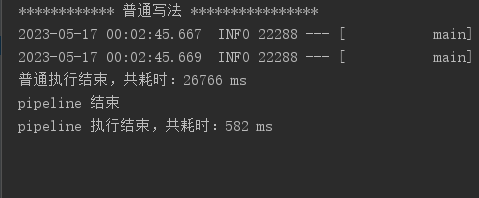
从控制台的输出日志可以看出:普通写法用时 26.76 秒,而 pipeline 只用了 0.58 秒。这性能差了好几个数量级。

why

经过查看源码,发现有两处性能关键点,关键点源代码如下:

1、获取连接的次数不一样。

// redisTemplate.opsForValue().set(...); 调用的 set 方法源码
@Override
public void set(K key, V value) {
    byte[] rawValue = rawValue(value);
    execute(new ValueDeserializingRedisCallback(key) {

        @Override
        protected byte[] inRedis(byte[] rawKey, RedisConnection connection) {
            // 问题:这个方法的 connection 对象从何而来???
            connection.set(rawKey, rawValue);
            return null;
        }
    }, true);
}

// 上面方法的 RedisConnection 从何而来,源码如下:从连接池中获取
@Nullable
public <T> T execute(RedisCallback<T> action, boolean exposeConnection, boolean pipeline) {

    Assert.isTrue(initialized, "template not initialized; call afterPropertiesSet() before using it");
    Assert.notNull(action, "Callback object must not be null");

    RedisConnectionFactory factory = getRequiredConnectionFactory();
    RedisConnection conn = null;
    try {

        if (enableTransactionSupport) {
            // only bind resources in case of potential transaction synchronization
            conn = RedisConnectionUtils.bindConnection(factory, enableTransactionSupport);
        } else {
            conn = RedisConnectionUtils.getConnection(factory);
        }

        ... 省略其他代码 ...
        return postProcessResult(result, connToUse, existingConnection);
    } finally {
        RedisConnectionUtils.releaseConnection(conn, factory, enableTransactionSupport);
    }
}

即每次调用 set 方法时,都会使用 RedisConnectionFactory 来获取一次连接,虽然是从连接池中获取,但是依然需要取 20000 次。 

// redisTemplate.executePipelined(...); 调用的 executePipelined 的源码
@Override
public List<Object> executePipelined(RedisCallback<?> action, @Nullable RedisSerializer<?> resultSerializer) {

    return execute((RedisCallback<List<Object>>) connection -> {
        // 这个 RedisConnection 对象的获取途经与上面一致:从连接池中获取。
        connection.openPipeline();
        boolean pipelinedClosed = false;
        try {
            // 调用函数的回调方法,将 RedisConnection 对象传递进去实现业务操作
            Object result = action.doInRedis(connection);
            if (result != null) {
                throw new InvalidDataAccessApiUsageException(
                        "Callback cannot return a non-null value as it gets overwritten by the pipeline");
            }
            List<Object> closePipeline = connection.closePipeline();
            pipelinedClosed = true;
            return deserializeMixedResults(closePipeline, resultSerializer, hashKeySerializer, hashValueSerializer);
        } finally {
            if (!pipelinedClosed) {
                connection.closePipeline();
            }
        }
    });
}

使用 pipelined 方式只需要获取一次连接对象,因为循环是写在回调函数里面的。这里就形成了一次性能差异。

2、执行的方式不一样

上面两种 API 无论是那种操作,最终调用的都是相同实现类的 set 方法,redis 客户端的实现类代码:

org.springframework.data.redis.connection.lettuce.LettuceStringCommands

@Override
public Boolean set(byte[] key, byte[] value) {
	// 非空校验代码略...

    try {
        if (isPipelined()) {
            // 如果开启了 pipelined 模式,获取的是 异步连接,进行异步操作
            pipeline(
                    connection.newLettuceResult(getAsyncConnection().set(key, value), Converters.stringToBooleanConverter()));
            return null;
        }
        if (isQueueing()) {
            // 如果开启了 队列 模式,通用是异步操作
            transaction(
                    connection.newLettuceResult(getAsyncConnection().set(key, value), Converters.stringToBooleanConverter()));
            return null;
        }
        // 常规模式下,使用的是同步操作
        return Converters.stringToBoolean(getConnection().set(key, value));
    } catch (Exception ex) {
        throw convertLettuceAccessException(ex);
    }
}

这里是性能差异的关键点,普通模式使用的是单线程同步操作(阻塞IO),而 pipelined 模式是使用的单线程异步操作(非阻塞IO)。

原因结论:

  1. 普通模式获取连接的次数就是循环的次数,而 pipelined 只获取一次。
  2. 普通模式是同步阻塞IO写数据,而 pipelined 是异步非阻塞IO写数据。

使用RedisTemplate批量存入数据,100万测试 需要1分钟 参考文档 https://blog.youkuaiyun.com/xiaoliu598906167/article/details/82218525 https://blog.youkuaiyun.com/fouling/article/details/98631144 1需求 将mysql数据库中的上百万数据存入redis中存入的格式为hashMap的形式 即,(hash路径,key, obj)其中的obj为map 封装一条记录信息 并且这些数据在用的时候可以取得到。 难点,普通通过循环hset的方式比较慢,一万条数据需 阅读详情

相关推荐

redis中使用pipeline批量执行命令,提升性能

提交到pipeline中,pipeline一次性的将数据发送给服务器,服务器再逐条执行命令。RedisCallback更接近redis原生命令。SessionCallback对操作进行了封装。,可以根据操作不同的数据类型进行转换,将一批要执行的redis命令。注意:此操作非原子性。将键和值都转换为字节码。中已经提供了对应方法。

小哇 1632

StringRedisTemplate中execute、executePipelined原理及使用

Redis事务本质:一组命令的集合 要么一起成功 要么一起失败,一个事务中的所有命令都会被序列化,在事务执行过程中会按照顺序执行注意:Redis单条命令是保证原子性的,但是事务是不保证原子性的Redis没有隔离级别的概念开启事务:multi执行事务:execRedisTemplate中如何开启并执行事务?更常见的写法仍是采用 RedisTemplate 的默认配置,即不开启事务支持。可以通过使用 SessionCallback,该接口保证其内部所有操作都是在同一个Session中。

qq_40472040的博客 5974

redis set 过大_高并发下Redis可能存在的问题及解决方案(面试问题)

【高并发下Redis可能存在的问题及解决方案】一、缓存穿透(面试问题)在实际开发中,添加缓存工具的目的,减少对数据库的访问次数,增加访问效率。肯定会出现Redis中不存在的缓存数据。例如:访问id=-1的数据。可能出现绕过redis依然频繁访问数据库的情况,称为缓存穿透,多出现在查询为null的情况不被缓存时。解决办法:如果查询出来为null数据,把null数据依然放入到redis缓存中,同时设置...

weixin_35656078的博客 3054

executePipelined

pipelining(管道) Pipeline:redis的管道命令,允许client将多个请求依次发给服务器,过程中而不需要等待请求的回复,在最后再一并读取结果即可,可以改善性能. pipeline不是原子操作 pipelining实例 public void redisPop(List<String> list) { List<Object> keys = redisTemplate.executePipelined(new SessionCallback&lt

CentOS 3268

Spring Boot整合Redis缓存:解决大数据量查询慢问题

接下来,我们将通过具体的示例来展示如何在Spring Boot中整合Redis缓存。跟着我一起,一步步来,你会发现这一切并不难。📋。

java专栏 1172

eDP/DP接口简介

目前,在视频传输协议以及接口领域,外部接口主要是DP与HDMI两分天下,当然之前出现过很多接口-VGA, DVI等等,最新平台基本以这两个为主;笔记本内部接口就基本上使用eDP((Embedded Display Port))作为标准接口来驱动液晶屏了。那么问题来了,eDP和DP,是完全兼容的么?eDP,DP,HDMI,这三种接口的显示器,可以插在同一个接口上使用么?这篇文章,就会从硬件和一部分协议的角度分析一下这三大协议。

weixin_50518899的博客 2万+

在Java中使用redisTemplate操作缓存

背景 在最近的项目中,有一个需求是对一个很大的数据库进行查询,数据量大概在几千万条。但同时对查询速度的要求也比较高。 这个数据库之前在没有使用Presto的情况下,使用的是Hive,使用Hive进行一个简单的查询,速度可能在几分钟。当然几分钟也并不完全是跑SQL的时间,这里面包含发请求,查询数据并且返回数据的时间的总和。但是即使这样,这样的速度明显不能满...

weixin_34221112的博客 455

Seedance 2.5本地部署指南:AI生图与视频生成的完整实践

最近在AI生成内容领域,本地部署方案越来越受到开发者关注。特别是Seedance 2.5的发布,让很多原本依赖云端服务的用户开始转向本地化解决方案。本文将从实际使用角度出发,完整介绍Seedance 2.5的本地部署流程、功能特性对比以及实际应用技巧。 1. Seedance 2.5核心特性解析 1.1 什么是Seedance 2.5 Seedance 2.5是一款开源的AI生图和视频生成工具,支持在本地环境运行,无需联网即可实现高质量的图像和视频生成。相比之前的2.0版本,2.5在生成质量、运行效率和功能

weixin_42566121的博客 1679

还在只用 RedisTemplate 访问 Redis 吗?

来源:juejin.cn/post/7180290294481420348???? 欢迎加入小哈的星球,你将获得:专属的项目实战 / Java 学习路线 /一对一提问 / 学习打卡/ 赠书福利全栈前后端分离博客项目 1.0 版本完结啦,2.0 正在更新中...,演示链接:http://116.62.199.48/,全程手摸手,后端 + 前端全栈开发,从 0 到 1 讲解每个功能点开发步骤,1...

犬小哈 104

使用DeepSeek、MCP和AKShare实现智能金融问答系统技术方案

DeepSeek是由深度求索公司开发的大规模语言模型,最新版本DeepSeek-V3采用混合专家(MoE)架构,拥有671B参数,激活37B参数,在多项基准测试中表现优异3。要使用DeepSeek的API服务:访问DeepSeek平台注册账号获取API Key(形如AKShare是基于Python的金融数据接口库,提供股票、基金、期货、宏观经济等领域的海量数据。主要特点包括:免费开源,数据源丰富支持多种数据格式(DataFrame/JSON)持续更新维护安装命令。

Kin 3174

从零开始理解二极管限幅:5种典型电路设计及实际应用场景解析

本文系统解析了二极管限幅电路的五大经典拓扑,包括串联与并联型上下限幅及双向限幅。通过剖析其核心原理与二极管的单向导电性、正向压降特性,结合ADC输入保护、电源管理、音频处理等实际应用场景,提供了从器件选型到设计陷阱规避的完整实战指南,帮助工程师为信号构建可靠的“安全笼”。

2y3u4i5o6p的博客 1034

关于java中redis操作直接使用jedis和使用springboot封装的RedisTemplate效率对比和主要区别

个人使用总结: 我知道jedis,lettuce是目前用的最多的两个java端的redis客户端,而RedisTemplate则是SpringBoot提供的一个封装模板,为的是可以方便更换redis客户端和支持Spring Cache,SpringBoot2.0以前默认为jedis,2.x以上则换成了lettuce,经过多次的使用和对比,得出如下结论: 个人认为直接使用JedisPool比使用SpringBoot封装的RedisTemplate好用,而且效率高很多(相同的数据量至少5倍以上的差距,本机.

wh445306 1904

vmware虚拟机网络连接问题

主机:ubuntu14.04 Vitual Network Editor

入门虽易,精通不易,且学且珍惜! 1354

RedisTemplate深度解析:从opsForValue与opsForList进阶到高并发实战

在分布式系统与高并发场景中,缓存技术是提升应用性能的核心组件之一。Redis作为高性能键值数据库,通过其丰富的数据结构为各类场景提供支持。Spring Data Redis通过RedisTemplate抽象层,为Java开发者提供了便捷的操作接口,其中opsForValue和opsForList是最常用的两种数据操作视图。理解其底层原理,包括序列化机制、原子性操作实现以及连接管理,是确保系统稳定性的关键。序列化不仅影响数据存储格式,更直接关系到跨服务数据兼容性与可读性;而原子性操作如setIfAbsent结

weixin_34198881的博客 447

SRCNN超分辨率Pytorch实现,代码逐行讲解,附源码

超分辨率,就是把低分辨率(LR, Low Resolution)图片放大为高分辨率(HR, High Resolution)的过程。通过CNN将图像Y 的特征提取出来存到向量中。用一层的CNN以及ReLU去将图像Y 变成一堆堆向量,即feature map。把提取到的特征进一步做非线性映射,加大网络深度,提高网络复杂性。结合了前面得到的补丁来产生最终的高分辨率图像。实验步骤。

weixin_52261094的博客 3万+

Ghidra逆向工具入门:从安装到实战分析baby.exe(附详细配置截图)

本文详细介绍了Ghidra逆向工具的安装配置与实战应用,通过破解CTF题目baby.exe的全过程展示其强大功能。从Java环境搭建到插件配置,再到反编译技巧与动态调试方法,帮助读者快速掌握这款免费开源的反编译神器,有效替代收费的IDA Pro工具。

weixin_29252171的博客 352

还在只用RedisTemplate访问Redis吗

前面两个命令是启动redis docker, 后两个是连接到docker, 在使用redis-cli 去查看redis里面的内容,主要查看我们存在redis里面的数据。

Maisucsdn的博客 179

一文搞定离线环境下的RAG引擎部署

在人工智能浪潮下,技术已成为构建智能问答、文档分析和代码助手等应用的核心。然而,在许多企业场景中,出于数据安全和性能的考虑,服务器往往部署在中,并要求极致的推理效率。这给依赖外部资源的应用部署带来了巨大挑战。如何在这种严苛的环境下,完整、可靠地部署一套包含向量数据库、**高性能推理服务(vLLM)**和Python后台的复杂RAG系统呢?本文将为你提供一个,手把手教你如何使用 Docker 技术,将一套基于 Weaviate 和的 Python RAG 应用完整打包,并在离线环境中一键部署。

木鱼时刻的专栏 1242

5分钟用RedisTemplate搭建点赞功能原型

整个过程中最惊喜的是AI辅助生成基础代码的功能,描述清楚需求后,自动补全了RedisTemplate的配置部分,至少帮我节约了半小时查文档的时间。用RedisTemplate配合Spring Boot,不到5分钟就搭出了核心逻辑,分享下这个轻量级实现方案。通过Spring封装的RedisTemplate,可以避免手动处理序列化等问题,三行代码就能完成基础操作。上测试时,用内置的Redis环境直接运行,省去了本地配置的麻烦。

BlackironLynx23的博客 659

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

java redis 模糊_Java使用RedisTemplate模糊删除key操作

redis模糊匹配批量删除操作,使用redistemplate操作:public void deletebyprex(string prex) {set keys = redistemplate.keys(prex);if (collectionutils.isnotempty(keys)) {redistemplate.delete(keys);}}prex为迷糊匹配的key,如cache:us...

weixin_34266290的博客 4895

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

redisTemplate大数据量的读写造成连接池已满

JedisExhaustedPoolException

weixin_44193732的博客 1000

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

大数据量处理情况下数据库,reids的连接的及时释放

大数据量处理情况下数据库,reids的连接的及时释放,避免超时或连接数过多失败 public void cacheDimessionStatus(String key, String status) { redisService.set(key, status); redisService.getRedisTemplate().getConnectionFactory().getConnection().close(); } try { templateV...

yuhui666666的博客 460
上一篇: JT905实现(一):协议的简单讲解
网上搬砖
博客等级 码龄6年 4粉丝 9原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值