YOLOv4文献阅读笔记

【YOLOv4探讨 之四】标签平滑Label Smoothing YOLOv4中,为了防止分类过拟合,使用了标签平滑Label Smoothing的技术。 Label Smoothing最早源于论文《Rethinking the inception architecture for computer vision》,这里不讨论。基本原理如下:通常YOLO模型中,80个分类标签都是使用0或1进行描述,在训练过程中,如果认为属于第n个分类,则该位置输出1(这种分类标签编码形式也称为one hot编码,即一位(独热)编码)。在数据集为无穷的情况下,可以对所有分类进行训练和标记, 阅读详情

论文: YOLOv4: Optimal Speed and Accuracy of Object Detection
下载地址:https://arxiv.org/pdf/2004.10934.pdf.

1. 引言

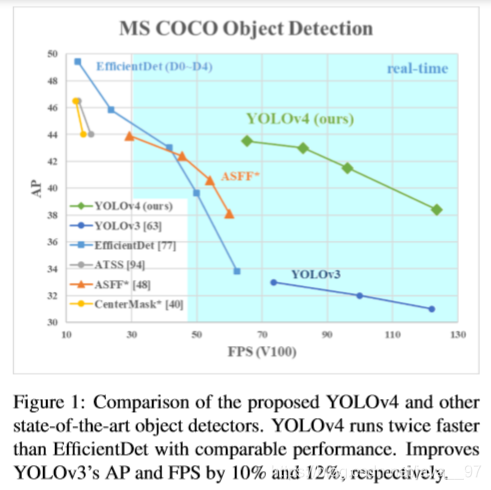
在这里插入图片描述
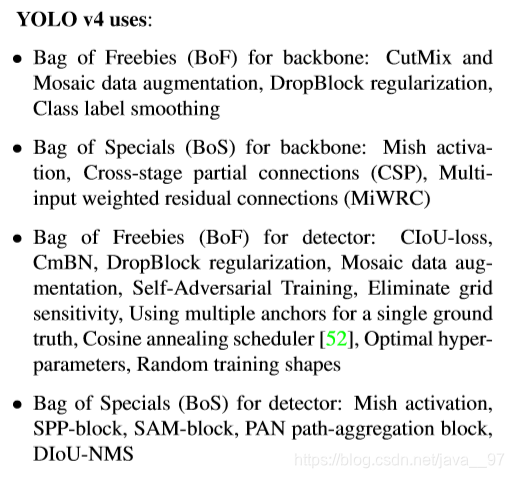
文章主要贡献:

  1. 可以使用1080Ti或者2080Ti GPU来训练超快速和准确的物体检测器。
  2. 在检测器训练过程中验证了当前目标检测的各种SOTA,分为bag of freebies(免费礼包)和 bag of specials(特价礼包)。
  3. 改进了SOTA,如CBN,PAN,SAM等,使它们更有效,更适合单GPU训练。

2. 相关工作

文章首先介绍了检测器的一般架构,然后将YOLOv4所综合的方法分为两部分介绍:bag of freebies 和 bag of specials。

2.1 Object Detectors

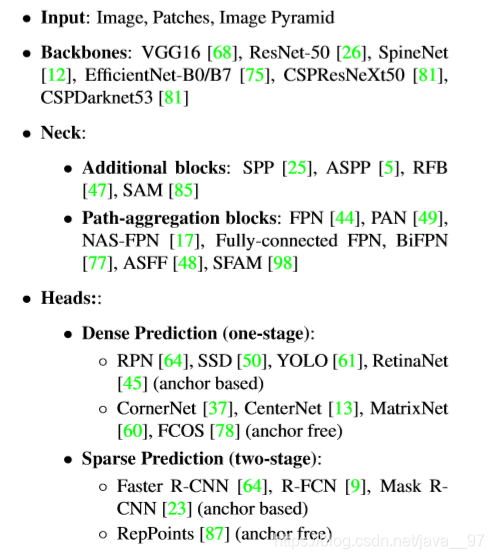
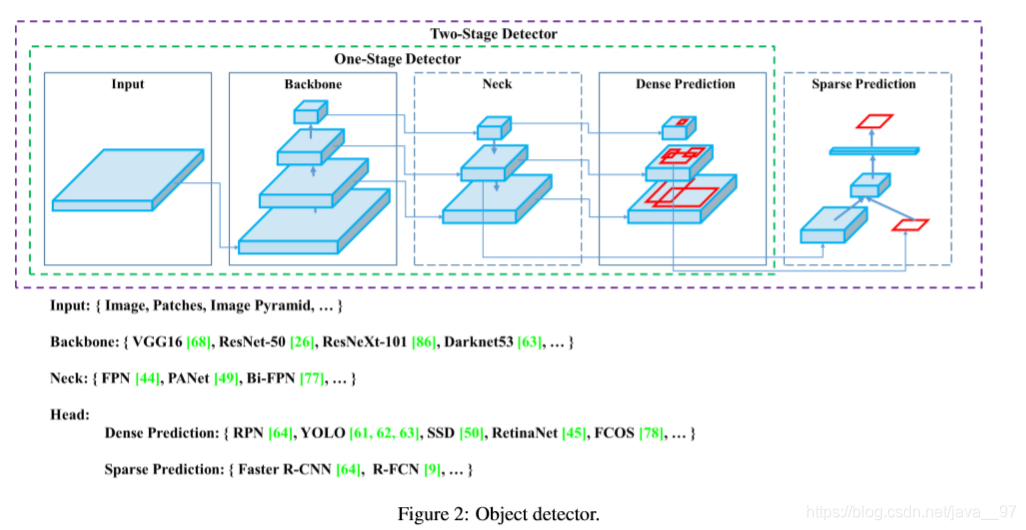
一般可将检测器结构分为以下几个部分:
1. backbone:在ImageNet上进行预训练,一般GPU平台用VGG, ResNet,ResNeXt, DenseNet;CPU用SqueezeNet, MobileNet , ShuffleNet。
2. head :分为两阶段检测器(RCNN系列)和单阶段检测器(YOLO系列,SSD,RetinaNet);
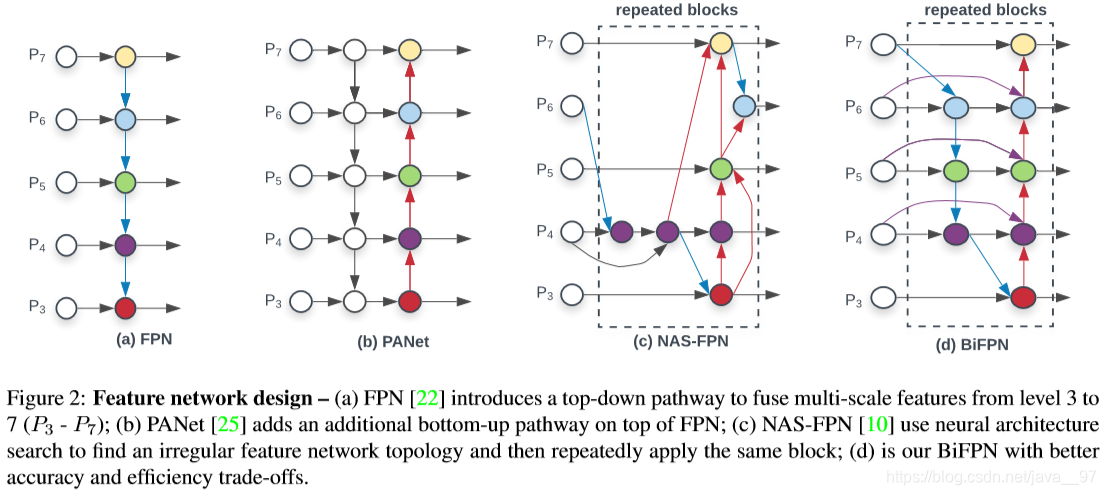
3. neck :位于backbone和head之间,综合不同阶段的特征图,通常由几个自下而上的paths和几个自上而下的paths组成。有 Feature Pyramid Network (FPN) , Path Aggregation Network (PAN) , BiFPN, NAS-FPN。
在这里插入图片描述在这里插入图片描述

2.2 Bag of Freebies(BoF)

bag of freebies字面意思是免费礼包,指那些仅通过改变训练策略或者增加训练成本的方式提高检测精度,并不影响检测inference time的方法。

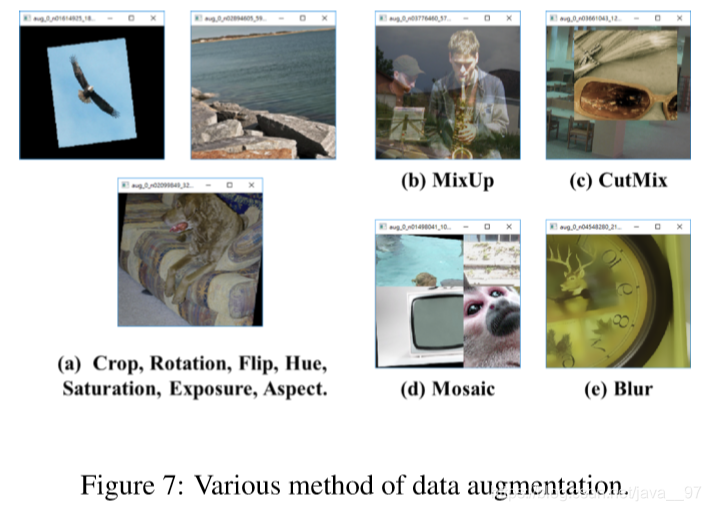
1. 数据增强:增加数据的多样性,提高检测器的鲁棒性和环境适应性。

(1)photometric distortions(光度扭曲):调整亮度、对比度、色相、饱和度和噪点。

(2)geometric distortions(几何扭曲):随机缩放,裁剪,翻转和旋转。

(3)模仿物体遮挡:

  • 对于图像来说,随机擦除或CutOut:随机选择图像中的矩形区域并随机填充或互补值零。
  • 图像掩膜的方法,hide-and-seek and grid mask:随机或平均选择多个图像中的矩形区域全部置零。
  • 对于feature map来说,类似方法是DropOut, DropConnect, DropBlock 。

(4)使用多张图片进行数据增强:

  • Mixup:将两张图片以不同系数比例相乘和叠加,然后用叠加比例调整标签。
  • CutMix:用其他图像填补裁剪掉的矩形区域,根据混合区域大小调整标签。

(5)GAN的风格迁移也可用于数据增强,减少CNN学习的纹理偏差。

2. 解决数据集的语义分布偏差:

  • 类别不平衡:对于两阶段检测器的解决办法是难负例挖掘或在线难例挖掘;对于单阶段检测器的解决办法是focal loss。
  • 使用one-hot hard representation难以表达出不同类别之间的关联程度:解决办法是label smoothing,在训练时将hard label转换为soft label,使训练更鲁棒。还有人提出knowledge distillation(知识蒸馏)的概念来设计label refinement network。

3. 目标边界框回归的损失函数:

  • 传统的MSE损失将 x , y , w , h x, y, w, h x,y,w,h这些点视为独立变量,未考虑目标自身的完整性。
  • IoU考虑了predicted BBox和ground truth BBox的覆盖范围,而且具有尺度不变性,克服了MSE对尺度变化敏感的问题。
  • GIoU除了考虑覆盖范围,还考虑了形状和方向。
  • DIoU还考虑了物体的中心距离。
  • CIoU同时考虑了重叠面积,中心点距离和长宽比。能得到更好的收敛速度和检测精度。

此处贴一下上述损失函数的论文原文以及相关解读的博客文章:

IoU和GIoU:
论文:https://arxiv.org/pdf/1902.09630.pdf
博客:论文笔记:GIoU
DIoU和CIoU:
论文:https://arxiv.org/pdf/1911.08287.pdf
博客:DIoU YOLOv3 | AAAI 2020:更加稳定有效的目标框回归损失

2.3 Bag of Specials(BoS)

bag of specials字面意思是特价礼包,指那些通过增加一点点inference time但带来显著精度提升的方法。

1. 增大感受野

  • SPP:通过max pooling实现,YOLOv3将SPP模块改进为 k × k k×k k×k最大池化输出的级联,YOLOv3-608在MS COCO数据集上AP50提高2.7%,计算量才增加0.5%。

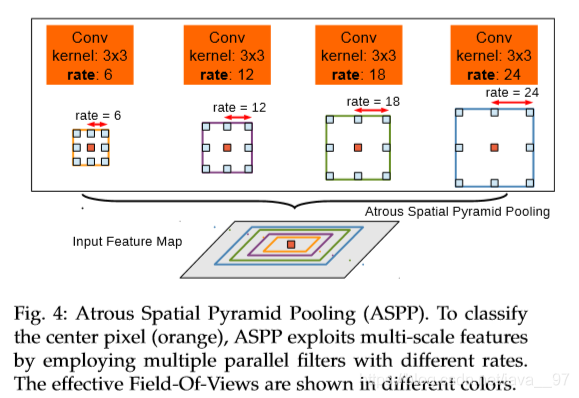
  • ASPP(Atrous Spatial Pyramid Pooling):与改进SPP模块不同之处在于使用多个3×3的最大池化,膨胀比为 k k k,步长为1的膨胀卷积。
    论文下载地址:https://arxiv.org/pdf/1606.00915.pdf
    在这里插入图片描述

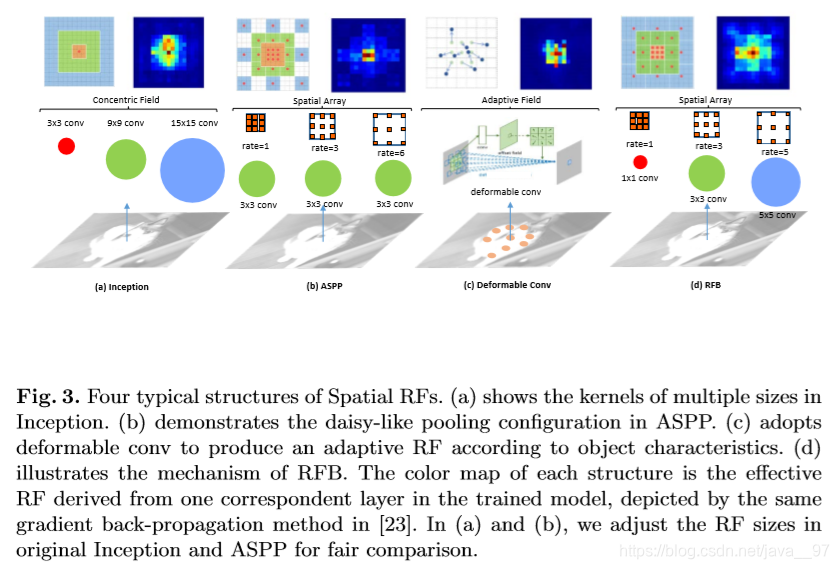
  • RFB(Receptive Field Block):使用多个 k × k k×k k×k的最大池化,膨胀比为 k k k,步长为1的膨胀卷积,比ASPP获得更全面的空间覆盖率。在SSD上增加7%的inference time, AP50提高5.7%。
    论文下载地址:https://arxiv.org/pdf/1711.07767.pdf
    代码:https://github.com/ruinmessi/RFBNet
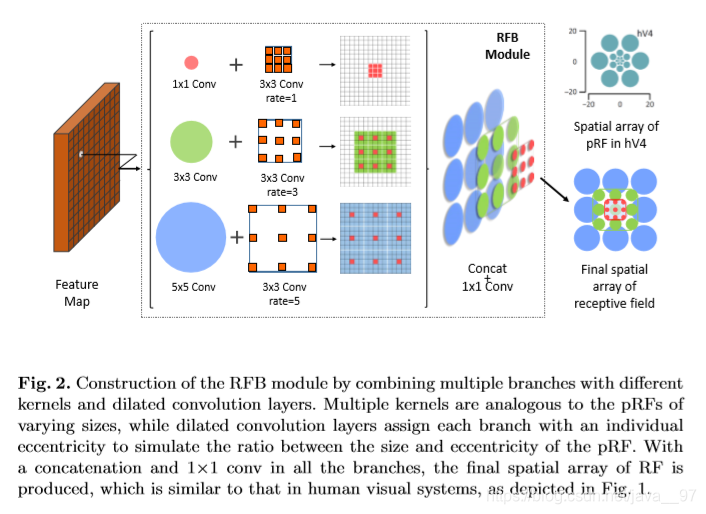
    在这里插入图片描述
    RFB论文给出的CNN中关于感受野的相关研究比较:
    在这里插入图片描述

2. 增加注意力机制

  • channel-wise attention:Squeeze-and-Excitation (SE) ,应用于ResNet-50,可将ImageNet top-1准确率提高1%,计算量只增加2%。但是在GPU上inference time增加10%,更适合移动设备。
  • point-wise attention:Spatial Attention Module (SAM),应用于ResNet50-SE,可将ImageNet top-1准确率提高0.5%,计算量只增加0.1%。基本不影响GPU上的inference time。

3. 增强特征融合能力

(1)skip connection

(2)hyper-column

(3)multi-scale prediction:如FPN,还有以下几种方法:

好的激活函数能使梯度有效传播,同时不增加太多额外的计算量。

  • ReLU
  • LReLU
  • PReLU
  • ReLU6
  • Scaled Exponential Linear Unit (SELU)
  • Swish
  • hard-Swish
  • Mish

LReLU 和 PReLU 是解决当输出小于零时,ReLU的梯度为零。
ReLU6 和 hard-Swish 是专为quantization networks设计的。
SELU 用于 self-normalizing a neural network。
Swish 和 Mish 具有连续微分的激活功能。

贴一篇介绍激活函数很全面的博客:
深度学习—激活函数详解(Sigmoid、tanh、ReLU、ReLU6及变体P-R-Leaky、ELU、SELU、Swish、Mish、Maxout、hard-sigmoid、hard-swish)

5. 后处理筛选模型的预测结果

  • greedy NMS:原始的NMS方法没有考虑context information,R-CNN中采用分类置信度得分作为参考,从高到低排序执行greedy NMS。
  • soft NMS:考虑了物体遮挡会引起greedy NMS中带有IoU评分的置信度得分下降。
  • DIoU NMS:在soft NMS的基础上将中心点距离的信息添加到BBox筛选过程中。

由于上述后处理方法都不直接涉及捕获的图像特征,在后来发展出的anchor-free方法中不再需要后处理。

3. 方法

基本目标是在生产系统中使用神经网络以更快的速度运行,并优化并行计算,而不是使用低计算量理论指标(BFLOP)。文章提出了两种实时神经网络选择:

  • GPU: CSPResNeXt50 / CSPDarknet53
  • VPU(Vision Processing Unit):使用分组卷积,避免使用SE(Squeeze-and-Excitement)模块。EfficientNet-lite / MixNet / GhostNet / MobileNetV3

3.1 网络结构的选择

  1. backbone的选择,作者研究表明:
    在ILSVRC2012上 CSPResNeXt50 好于 CSPDarknet53
    在MS COCO上 CSPDarknet53 好于 CSPResNeXt50
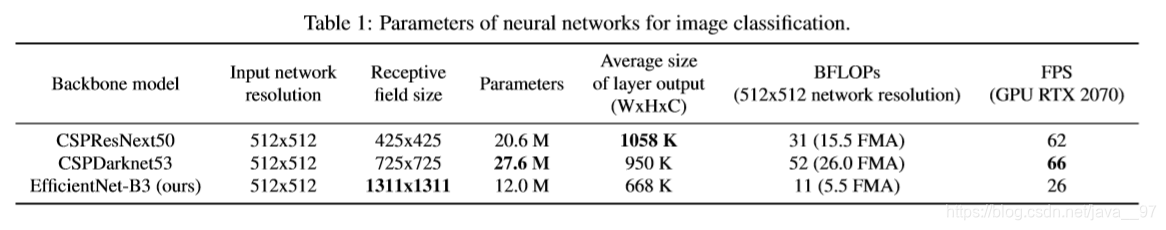
    在这里插入图片描述
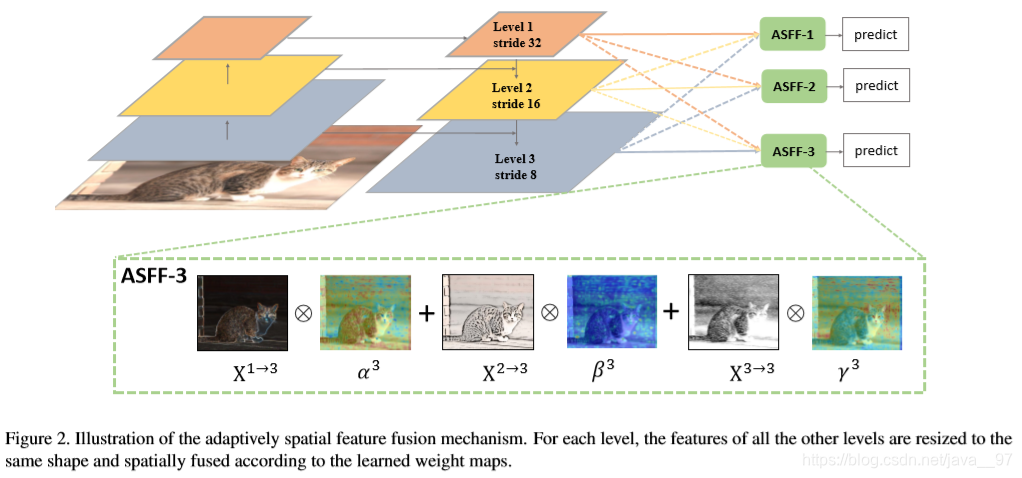
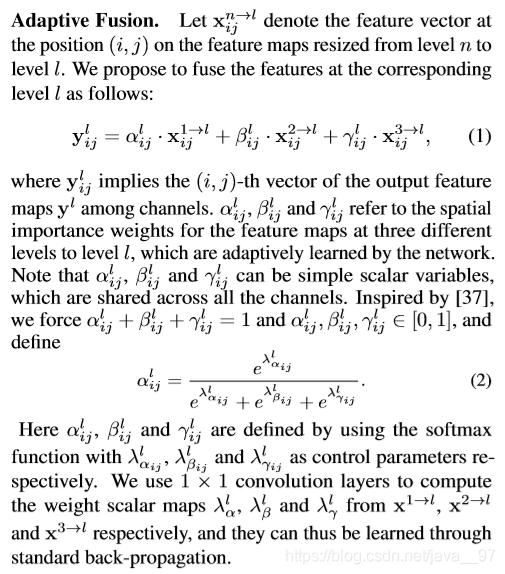
  2. additional blocks的选择,为的是从不同 level 的 backbone 中为不同 level 的检测器选择最佳的增加感受野和参数整合的方法,如FPN, PAN, ASFF, BiFPN。与分类器相比,检测器需要:
  • 更高的输入分辨率——用于检测多个小型物体
  • 更多层——更高的感受野,为能覆盖增加的网络输入尺寸
  • 更多的参数——模型能有更强的检测多尺度多目标的能力

文章还提到感受野大小的影响:
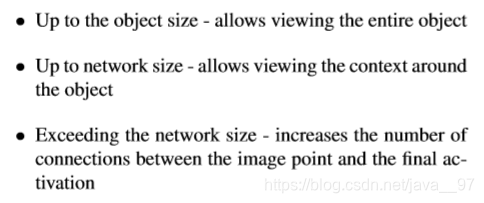
在这里插入图片描述
作者选择在 CSPDarknet53 加入 SPP 模块增大感受野,并使用 PANet 为不同 level 的检测器进行不同 level 的 backbone 的参数整合。

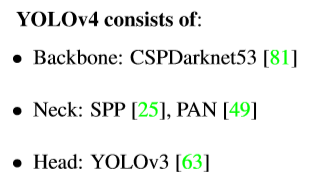
简单说,YOLOv4 = CSPDarknet53 backbone + SPP + PANet neck +YOLOv3 head

3.2 BoF和BoS的选择

为了提高目标检测器的训练效果,一般采用如下策略:
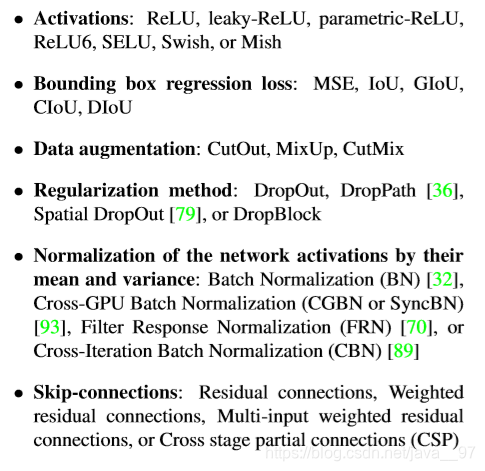
在这里插入图片描述

3.3 其他的改进

作者主要想设计更适合单GPU训练的检测器,做出的额外设计和改进如下:

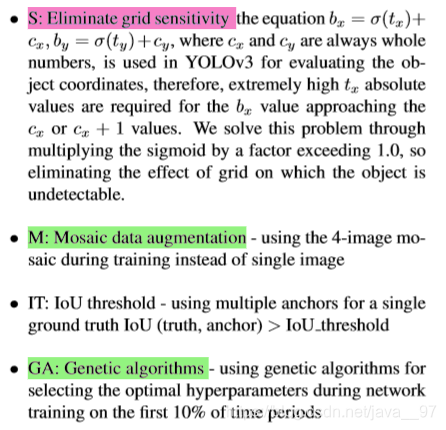
  • Mosaic数据增强:一种新的数据增强方法,该方法混合了4张训练图像,因此混合了4个不同的上下文信息,而CutMix仅混合了2张输入图像。该方法可以检测正常上下文以外的物体。 此外,批量归一化在每层上的从4张不同图像计算激活统计信息,减少了对大mini-batch size的需要。
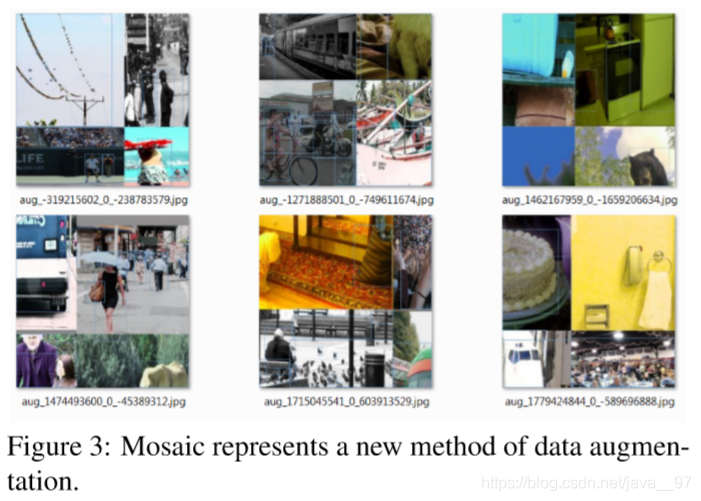
    在这里插入图片描述
  • Self-Adversarial Training (SAT) :也是一种新的数据增强技术。
    在第一阶段,神经网络会更改原始图像而不是网络权重。 这样,神经网络会执行自对抗性攻击,改变原始图像来制造图像上没有目标物体的假象。
    在第二阶段,以正常的方式训练神经网络在修改后的图像上检测目标。
  • 使用遗传算法选择最佳超参数
  • 改进SAM,PAN 和 Cross mini-Batch Normalization (CmBN)
    (1)CmBN
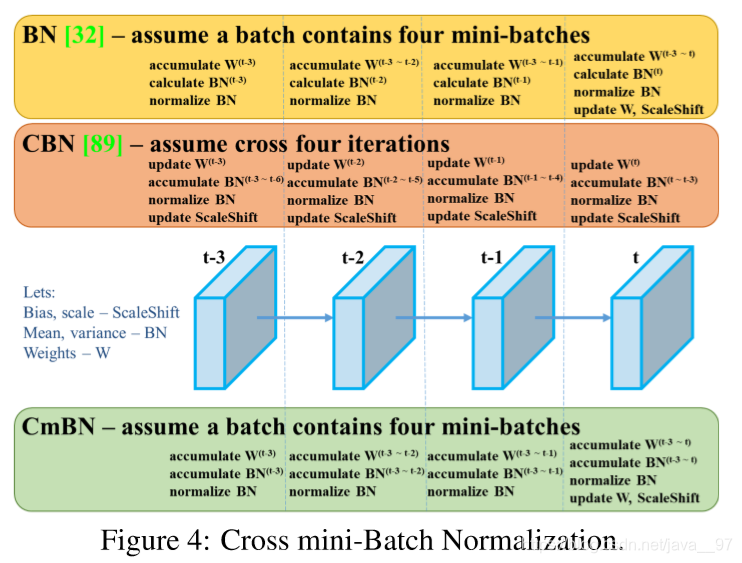
    在这里插入图片描述
    (2)SAM的改进
    将空间注意力机制改为点注意力机制。modified SAM中没有使用pooling, 而是直接用一个卷积得到的特征图直接使用Sigmoid进行激活, 然后对应点相乘。
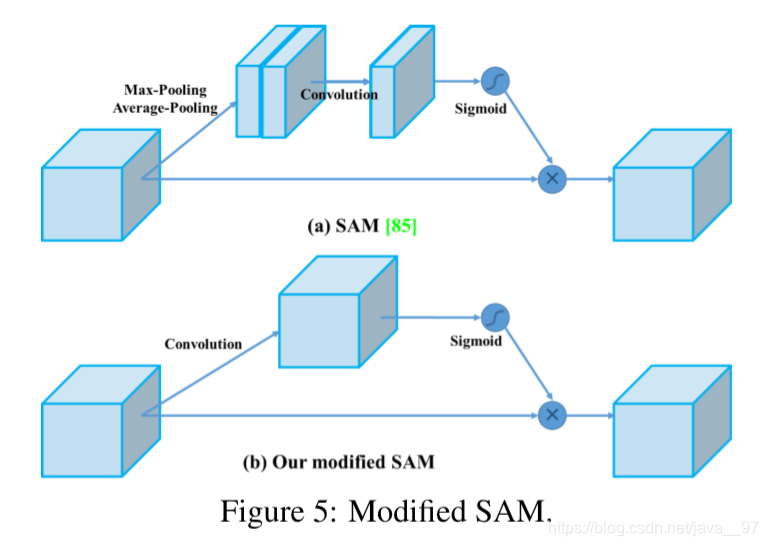
    在这里插入图片描述
    (3)PAN( Path Aggregation Network)的改进
    将跳跃连接改为级联。文章未作详细分析。
    PANet论文下载地址:https://arxiv.org/pdf/1803.01534.pdf
    代码:https://github.com/ShuLiu1993/PANet
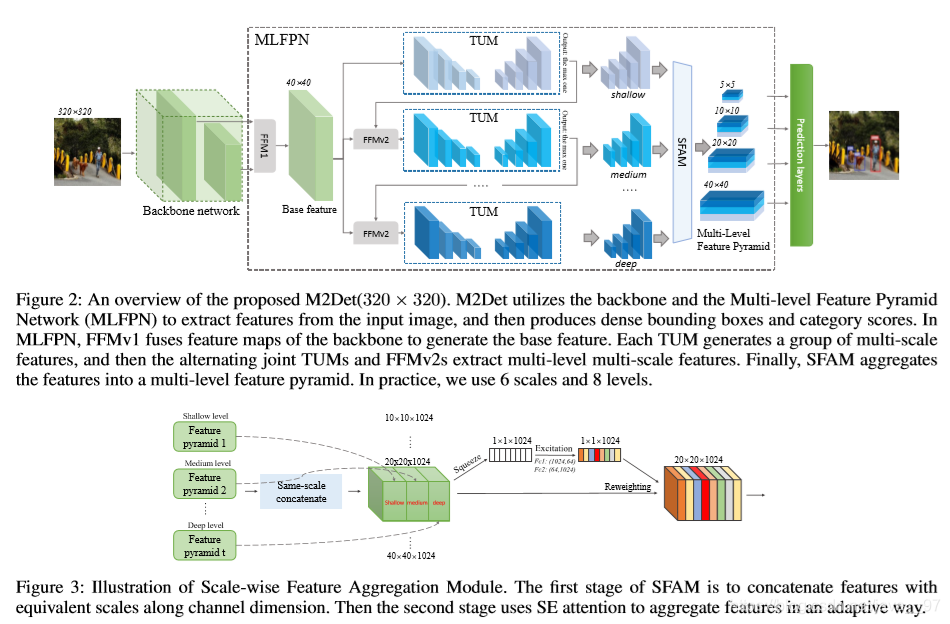
    在看YOLOv4论文过程中,发现在Path-aggregation这方面,基于FPN进行改进的文章还挺多的,如 SFAM,ASFF,BiFPN,NAS-FPN,PANet。前三篇大致看了看方法,前面贴出了几张图,觉得还是挺有新意的,准备接下来重点研读一下这几篇文章,重新开一篇博客总结归纳一下。
    贴一篇PANet解读的博客:
    PANet算法笔记
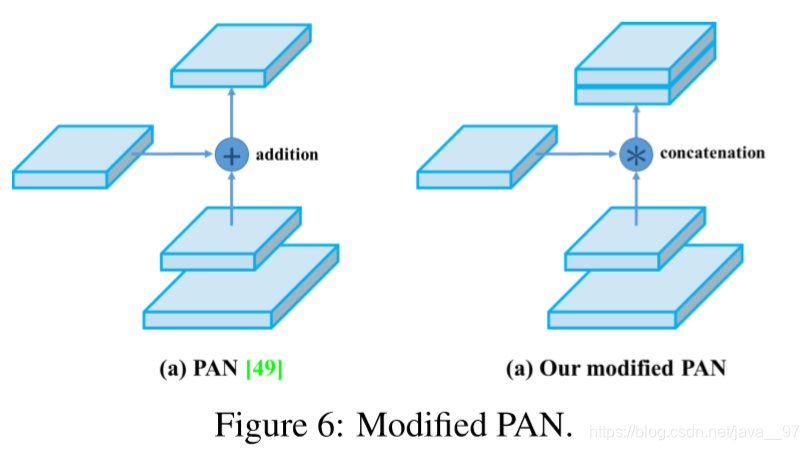
    在这里插入图片描述

3.4 YOLOv4

前面已经说过了YOLOv4的组成:
在这里插入图片描述
具体细节如下:

在这里插入图片描述

4. 实验结果

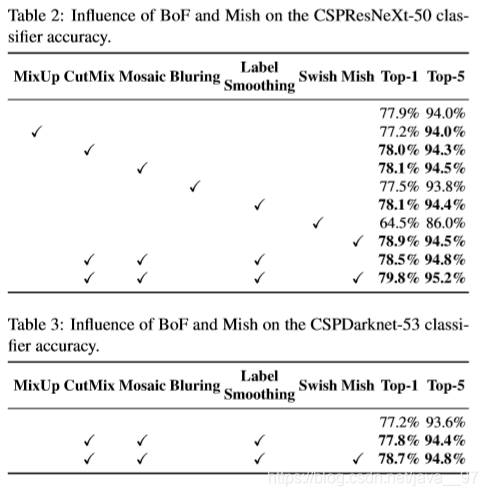
1. 不同BoF对分类器精度的影响。

CutMix 和 Mosaic两种数据增强方式、 Class label smoothing 和 Mish 激活函数在训练过程中能提高分类器的精度。
在这里插入图片描述
在这里插入图片描述
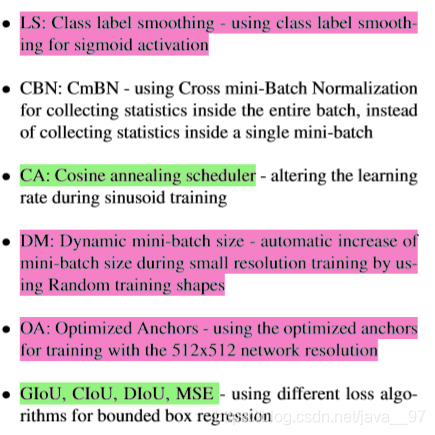
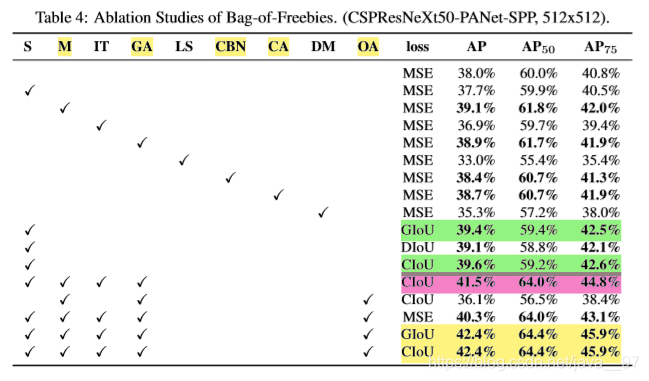
2. (1)不同BoF对检测器精度的影响

标绿色的tricks在U版YOLOv3中已经被采用。
在这里插入图片描述在这里插入图片描述
精度提升效果还是挺可观的。最佳组合到4%、5%了,实属不易。
在这里插入图片描述

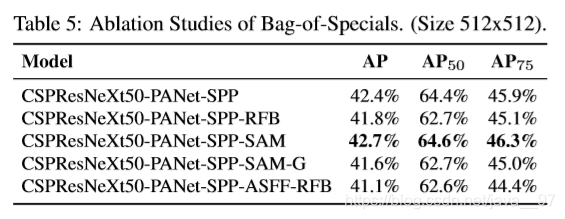
(2)不同BoS对检测器精度的影响

测试了PAN, RFB, SAM, GaussianYOLO(G), and ASFF。最佳组合是PAN-SPP-SAM。
在这里插入图片描述

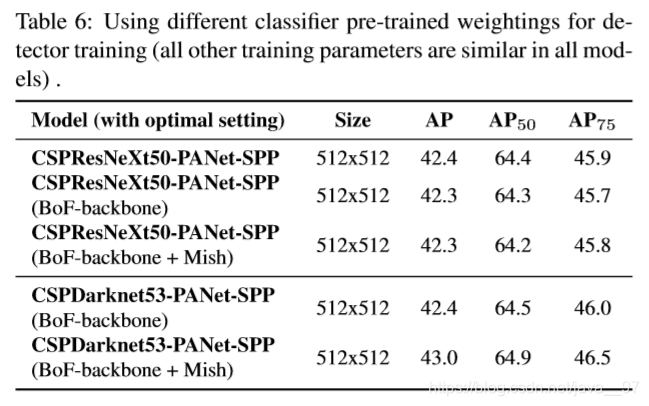
(3)不同backbone和预训练权重的影响

① CSPResNeXt50分类器准确率更高,CSPDarknet53检测器准确率更高。

② BoF+Mish+CSPDarknet53使用预训练分类器权重,能同时提高分类器和检测器的准确率。
在这里插入图片描述

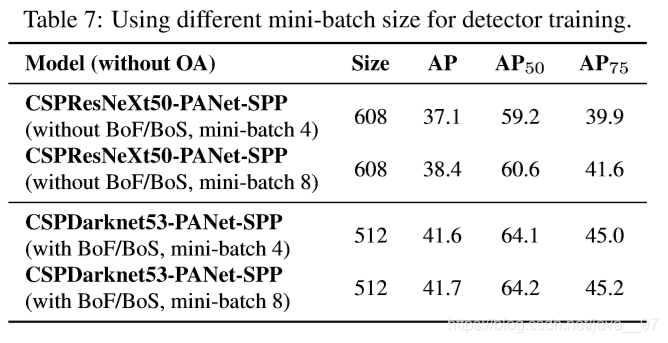
(4)训练检测器过程中不同mini-batch size的影响

增加了BoF和BoS后,mini-batch size对检测器性能几乎没有影响,因此无需使用更昂贵的GPU就可以训练出色的检测模型。
在这里插入图片描述

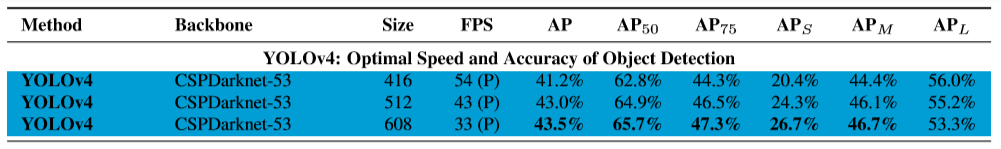
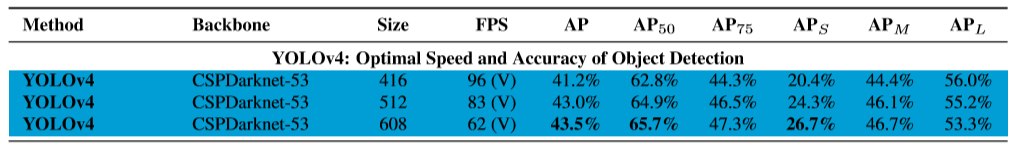
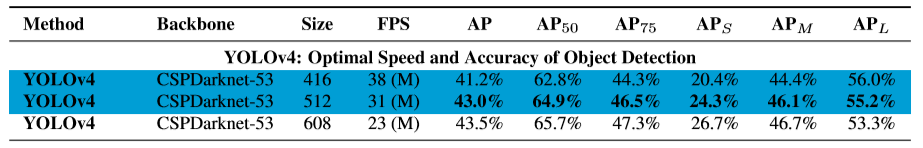
文章最后给出了不同GPU架构上(Maxwell、Pascal、Volta)各算法的性能对比,具体参见论文原文,这里只贴一下YOLOv4
在这里插入图片描述
在这里插入图片描述
在这里插入图片描述

YOLOv4论文阅读(附原文翻译) YOLOv4论文阅读Abstract摘要1.Introduction 引言2.Related work相关工作2.1.Object detection models目标检测模型2.2.Bag of freebies免费礼包2.3.Bag of specials特价礼包 Abstract摘要 There are a huge number of features which are said to improve Convolutional Neural Network (CNN) accuracy. Pra 阅读详情

相关推荐

YOLOv2 论文笔记

论文地址:YOLO9000: Better, Faster, Stronger 项目主页:YOLO: Real-Time Object Detection (最近博客下很多人请求Caffe 代码,受人所托,已经不再提供,且关闭本文评论,望请见谅) 概述 时隔一年,YOLO(You Only Look Once: Unified, Real-Time Object Detection)从v...

Jesse_Mx的博客 9万+

YOLOv4 文献翻译阅读及拓展阅读(附拓展文献下载链接)

先看看效果对比 YOLOv4 的运行速度是 EfficientDet 的两倍。使 YOLOv3 的 AP 和 FPS 分别提高 10%10\%10% 和 12%12\%12%,达到 43.5%43.5%43.5% AP 和 656565 FPS。 一、概览 论文地址:https://arxiv.org/abs/2004.10934 源码地址:https://github.com/AlexeyA...

淋曦的进击手记 2004

超10万,两台Mac Studio在家就能跑满血DeepSeek,网友:这是性价比最高的大模型一体机

在AI计算领域,没有比这更强的个人电脑了。这要从它的架构说起。对于那些有本地部署满血版DeepSeek需求的用户,目前建议的配置是选购512GB统一内存 + 1TB SSD,搭载M3 Ultra芯片的Mac Studio,官网售价74249元,可以叠加国补、教育优惠、12期分期等,这可能是目前门槛最低、性价比最高的满血版DeepSeek本地部署方案。对于企业而言,尽管Mac Studio确实可以部署6000亿参数的大模型,但在内存带宽、模型精调服务等方面,跟专用的大模型一体机仍有差距,采购需要谨慎评估。

2501_90444774的博客 1917

(论文阅读)实例分割之PANet

PANet一、论文简介1.1、论文和代码链接1.2、论文基本信息二、详细解读2.1、摘要2.2、介绍2.3、网络架构2.4、改进与创新2.5、实验结果三、总结与思考 一、论文简介 1.1、论文和代码链接 paper:http://xxx.itp.ac.cn/pdf/1803.01534.pdf code:https://codechina.youkuaiyun.com/mirrors/ShuLiu1993/PANet?utm_source=csdn_github_accelerator 1.2、论文基本信息 发表于C

血狼傲骨 2499

StarRocks慢查询排查实战:从Query Plan到Profile的保姆级调优指南

本文提供StarRocks慢查询排查的实战指南,从Query Plan解析到Profile诊断,详细讲解如何识别执行计划中的危险信号和优化关键指标。通过物化视图优化、分布式执行调整和资源管控方案,帮助DBA快速定位并解决查询性能问题,提升数据库效率。

weixin_42568801的博客 379

百度api爬虫(1)从百度api中爬取地点数据

几句废话———— 百度api就是基于百度地图的开发接口,这么大的地图公司居然给开发接口真的很感激哎! 所以,言归正传。现在项目需求要把乌鲁木齐市内的所有清真寺都用矢量圈出来,然后做点统计啥的,最后做个专题图产品。 怎么把清真寺找出来? 领导的意思是你一个一个上网搜吧,这就是你的工作量。那我当然要想办法啊,边工作边学习工作才有意义嘛! 然后就发现百度api可以实现我的需求。其实可以通过py...

weixin_43105618的博客 8900

YOLOV4用到的一些tricks以及代码实现(3)——Label_smoothing

YOLOV4用到的一些tricks以及代码实现(3)——Label_smoothing Lable Smoothing是分类问题中错误标注的一种解决方法。 对于分类问题,特别是多分类问题,常常把向量转换成one-hot-vector(独热向量) 理论而言,如果标签为1时,模型应该尽力去获得最接近的output,如0.999。而这样真的好吗?如果某些标签错误,那模型拟合的目标反而离我们需要的结果越来越远。因此,使用label_smoothing可以很好的缓解这样的问题。 个人觉得,该原理和focal L

xiaoyang0307的博客 964

领域知识图谱构建的技术流程

因此概念的属性定义十分重要,通常大部分知识库中的概念属性都是采用人工定义等方式生成的,通用知识图谱则可以从开放数据集中获取概念的属性,然后从在线百科中学习实体的属性,并对实体属性进行往上规约从而生成概念的属性。由于百科的分类体系都是经过了百科管理员或是高级编辑人员的校验,其分类系统中的数据可靠性非常高,因此从百科中抽取概念和实体,通常将标题作为实体的候选,而将百科中的分类系统直接作为概念的候选。为了对知识进行合理的组织,更好地描述知识本身与知识之间的关联,需要对知识图谱的模式进行良好的定义。

weixin_43961909的博客 334

如何在YoloV8中添加注意力机制(两种方式)

yolov8添加注意力机制的方法

ITdaka的博客 7361

arkts编译报错-arkts-limited-stdlib错误【Bug已完美解决-鸿蒙开发】

在使用 Deveco Studio 4.0 beta2 开发应用时,报错。ERROR: ArkTS:ERROR File: D:/prRevivw/3792/applications_appsamg优快云o”见台难忘Usage of standardlibrary is restricted (arkts-limited-stdlib)这是 ArkTS 新增的语法规则。

一键难忘的博客 3776

Claude Code 任务编排 头脑风暴与 疯狂拷问:Superpowers vs Grill-me 硬核对比与工程落地

Superpowers和Grill-me是AI编程中的互补工具:Superpowers提供工程化开发流程(从需求梳理到代码审查),确保规范执行;Grill-me通过持续追问帮助厘清需求,避免方向偏差。两者结合形成"构思-拷问-执行"工作流,前者负责方案生成与落地,后者专注需求审查。根据场景选择:个人项目可用Grill-me快速澄清需求,企业项目推荐Superpowers全流程,复杂开发则建议组合使用。它们分别解决"如何落地"和"是否对齐"的问题,共

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 325

经典检测网络文献阅读笔记——YOLOv4

YOLOv4: Optimal Speed and Accuracy of Object Detection 介绍 贡献: 1.开发了一个简单高效的目标检测算法——YOLOv4,该算法可以使用普通的GPU(1080Ti和2080Ti)来训练 2.作者验证了在目标检测算法训练过程中不同的技巧tricks对实验性能的影响,这些trick主要包括Bag-of-Freebies和Bag-of-Specials 3.作者修改了一些SOTA的算法,使得这些算法适用于单GPU上训练,这些算法包括CBN,PAN,SAM

April_Liu的blog 531

【软考】高项论文写作常见模板

本文主要介绍了YYYY年MM月DD日,我所在公司承接了XXXX项目的建设过程,包括了XXX,XXX,XXX内容,涉及到XXX,XXX,XXX技术。本人在项目中承载着项目经理的角色,主要负责了XXX,XXX,XXX方面事宜。此项目时间紧,任务重,实施过程中,我们特别注重了1、XXX 2、XXX 3、XXX几个方面,经过团队的一致努力,本项目按时交付,运行至今,客户反馈良好。但是在实施过程中,也曝露除了一些问题,包括了XXX,XXX等,通过应急处理和协调,这些问题都得到了妥善解决,没有影响到项目进度。

奶爸的编程之路,也就一周冷个三天 1687

文献阅读笔记4——《Contrasting YOLOv5, Transformer, and EfficientDet Detectors...》

《Contrasting YOLOv5, Transformer, and EfficientDet Detectors for Crop Circle Detection in Desert》 摘要 比较了 YOLOv5 、Transformer 和Efficientdet 建立了数据集:埃及和沙特阿拉伯 在域内和跨域场景进行评估 背景介绍 介绍背景应用->做农作物综述->引出麦田检测意义->引出需解决的两个问题 1.没有文献对麦田怪圈进行足够原因是因为缺乏数据集 2.遥感技术 缺乏用

April_Liu的blog 1166

R语言dplyr包recode函数、recode_factor函数数值或因子替换实战

R语言dplyr包recode函数、recode_factor函数数值或因子替换实战 目录 R语言dplyr包recode函数、recode_factor函数数值或因子替换实战 #导入dplyr包 #recode函数进行数值替换 #recode_factor函数对因子变量进行替换 #导入dplyr包 install.packages("dplyr") # Install & load dplyr library("dpl.

data+scenario+science+insight 1590

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

论文阅读笔记 之 YOLOv4 & scaled YOLOv4

一、目标检测框架总结 在YOLOv4论文中,作者首先对当前目标检测领域的模型进行了总结。作者将目标检测模型归纳为下图所示的结构: 作者将模型分为 输入、backbone、neck、预测部分,其中Dense Prediction加前三部分为one-stage检测模型框架,Sparse Predition 加前三部分为two-stage 检测模型框架。这里的Neck部分主要指的是网络中对backbone提取的特征进行多尺度融合(如FPN等)或者进一步处理(注意力机制等)。并且作者也列出来各个部分目前表现较好的

流觞时光 3214

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

YOLOv4网络详解

YOLOv4是2020年Alexey Bochkovskiy等人发表在CVPR上的一篇文章,并不是Darknet的原始作者Joseph Redmon发表的,但这个工作已经被Joseph Redmon大佬认可了。之前我们有聊过YOLOv1~YOLOv3以及Ultralytics版的YOLOv3 SPP网络结构,如果不了解的可以参考之前的视频。

霹雳吧啦Wz 6万+

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

YOLOv4 论文阅读笔记

YOLOv4在结构上没有额外的创新,但是收集了目标检测中各种tricks,并进行实验分析了各种tricks的有效性,相对于对近些年来目标检测领域中从数据,网络结构,和后处理等过程做了很好的总结。最终,在速度和准确性上达到了最好的balance。 论文:《YOLOv4: Optimal Speed and Accuracy of Object Detection》 论文链接:https:...

weixin_40671425的博客 2744

YOLOv5代码阅读笔记及解析

YOLOv5代码阅读笔记 一,backbone 1,Focus ①,原理:把一个nnc的feature map,按步长为2,进行取值下采样。如图一所示,把原始特征图沿x轴、y轴按步长为2进行取值操作,取值后添加到通道里,然后进行一次普通卷积。 图一 Focus原理 ②,代码实现如下: ''' 把输入x分别从(0,0)、(1,0)、(0,1)、(1,1)开始,按步长为2取值。 然后进行一次卷积。 ''' class Focus(nn.Module): # Focus wh infor

xiaoleige0713的博客 8634

yolov5代码阅读笔记

文章目录Yolov5 代码笔记1. train(hyp)函数重点部分1.1 载入图片路径1.2 创建模型1.3 确定训练和测试图片的尺寸1.4 根据参数的形式(是否为weight,是否为bias等)定义模型的不同部分,并为不同部分设置不同的学习率及参数1.5 载入预训练模型(ckpt)及权重(ckpt['model'])1.6 定义学习率变化趋势,这里采用的是Cosine Learning Rate Decay1.7 载入数据集,定义数据集迭代器1.8 定义训练集和验证集的数据读取器(dataloader和

weixin_41153216的博客 2万+

经典文献阅读之--Yolov7

作为22年比较重磅的物体识别算法,作者觉得不得不说一说,虽然作者目前主要方向不是深度学习了,但是里面很多重要的操作还是值得回味的。这里就从想要大致了解Yolo v7同学的眼光来对v7的算法进行介绍。并按照原文《》的顺序,来向读者介绍相较于之前的Yolo算法加了什么操作。与它的前辈一样,Yolo v7的代码是完全开源的,代码在Github上。...

lovely_yoshino的博客 5568

YOLOv4论文阅读笔记整理

YOLOv4论文阅读笔记整理 摘要 作者在YOLOv3基础上使用了 WRC(weighted-Redsidual-Connections)加权残差链接、 CSP(Cross-Stage-Partial-Connections)跨阶部分链接、 CmBN(Cross mini-Batch Normalization) 跨小批量标准化 、 SAT(Self-adversarial-training)自对抗训练、 Mish(Mish-activation )激活函数、 Mosaic(Mosaic data augm

yunxinan的专栏 439

YOLOv2文献阅读笔记

YOLOv2文献阅读笔记 yolo 1. Introduction 问题提出:现有检测方法局限在很少一部分物体上,检测数据集的规模远远小于分类数据集规模。 1.提出一种新方法利用现有的分类数据来扩大现有检测系统的范围。 2.使用目标分类的层次视图,将不同的数据集组合在一起。 3.提出了一种联合训练算法,在检测和分类数据上训练目标检测器。 利用标注的检测图像学习精确地定位物体,利用分类图像提高词汇量...

学习记录分享 406

YOLOv4阅读笔记(附思维导图)!YOLOv4: Optimal Speed and Accuracy of Object Detection

今天刷看到了YOLOv4之时,有点激动和兴奋,等了很久的YOLOv4,你终究还是出现了 论文地址:https://arxiv.org/pdf/2004.10934.pdf GitHub地址:https://github.com/AlexeyAB/darknet 觉得作者很地道,论文附上开源,没有比这更开心的事情了吧! 首先附上对论文总结的思维导图,帮助大家更好的理解! (思维导图和论文译文...

中科院AI算法工程师的博客 4132

【笔记】文献阅读[YOLOV3]-An Incremental Improvement

YOLOv3论文精度

qq_44703886的博客 1871

YOLOv5代码阅读笔记

本来想先总结yolov5的各种知识点,但是看了一位大佬发的博客,瞬间就跪了,链接放上:[深入浅出Yolo系列之Yolov5核心基础知识完整讲解]。(https://blog.youkuaiyun.com/nan355655600/article/details/107852353) 代码看完一遍后,感觉理解还不够深刻,决定近期再把代码过一遍,顺便写个阅读笔记加深记忆。 看代码建议从推理部分开始看。 一、detect.py 由于以前就是用的v5团队写的pytorch版yolov3,detect.py跟v3的代码基本一样,

下大禹了的博客 9408
上一篇: YOLOv2文献阅读笔记
下一篇: Ubuntu18.04安装ROS melodic
早起多学习
博客等级 码龄9年 13粉丝 17原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值