Redis基础

Redis的基础命令 在前面我们讲了redis的搭建和启动,这里直接开始将他的基础命令。 阅读详情

Redis持久化机制

RDB:是Redis默认的持久化方式。按照配置周期性的把内存的数据以快照的形式保存到硬盘的二进制文件中。直接拿文件内容重建。
AOF:Redis会将每一个收到的写命令都以日志的形式记录下来。当Redis重启时会通过按顺序执行文件中保存的写命令来在内存中重建整个数据库的内容。
说明:当两种方式同时开启时,数据恢复Redis会优先选择AOF恢复。
优劣:

  1. 性能:RDB > AOF
  2. 数据一致性:RDB < AOF

Redis为什么这么快

  • 纯内存操作
  • 单线程操作,避免了频繁的上下文切换
  • 采用了非阻塞I/O多路复用机制(最大限度地利用内核资源)

Redis的数据类型
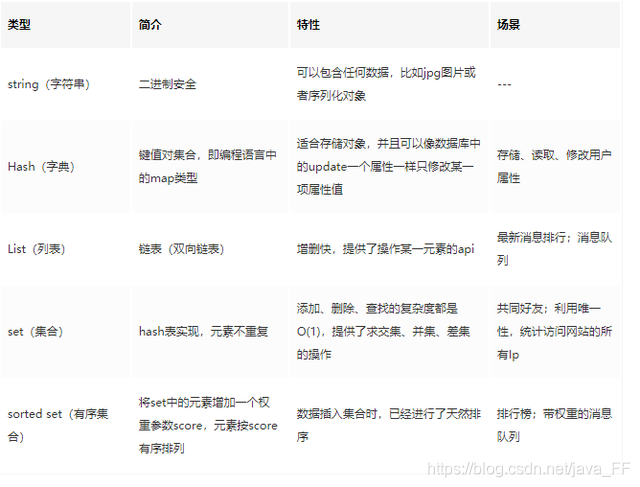
在这里插入图片描述

什么样的数据该设置缓存

热点数据,缓存才有价值。
热点数据:读取频率很高的数据。如导航的定位信息,缓存后可以读取数百万次;如抖音的点赞数,收藏数,读取频率很高,同时更新频率也很高,这样的数据也时热点数据,此时就需要将数据同步保存到Redis缓存,减少数据库压力。

缓存雪崩,缓存击穿,缓存穿透

缓存雪崩:同一时间缓存大面积过期,所有原本应该访问缓存的请求都去查询数据库了,数据库压力增大。
解决方法:1.锁(最常见的方式,单服务可使用线程锁,分布式微服务使用分布式锁)2.将缓存失效时间分散开来(避免大面积过期)。

缓存击穿:某个热点缓存过期,同一时刻大量请求直接去查询数据库,数据库压力增大。
解决方法:1.互斥锁(最常见的方式,单服务可使用线程锁,分布式微服务使用分布式锁)2.永不过期(把过期时间存在key对应的value里,如果发现要过期了,通过一个后台的异步线程进行缓存的构建,也就是“逻辑”过期)。

缓存穿透:查询一条数据库不存在的数据(如id=-1),这样请求每次就绕过缓存直接查数据库,这也是经常提的缓存命中率问题。高并发的情况下数据库压力会很大。
解决方法:1.过滤器,进行参数过滤校验 2.即使数据库不存在,我们也将这个空结果存入到缓存中,可以设置一个比较短的过期时间,这样第二次请求缓存就可以命中了。

总结:缓存雪崩:大面积过期。缓存击穿:热点缓存过期。缓存穿透:缓存未命中。针对缓存过期可以使用互斥锁和重构过期策略来改善,缓存未命中的问题可以通过过滤参数来拦截请求。

缓存预热,缓存更新,缓存降级

缓存预热:就是系统上线后,将相关的缓存数据直接加载到缓存系统。这样就可以避免在用户请求的时候,先查询数据库,然后再将数据缓存的问题。
解决思路:

  • 直接写个缓存刷新页面,上线时手工操作下;
  • 数据量不大,可以在项目启动的时候自动进行加载;
  • 定时刷新缓存;

缓存更新: 除了缓存服务器自带的缓存失效策略之外,我们还可以根据具体的业务需求进行自定义的缓存淘汰。
解决思路:

  • 定时去清理过期的缓存;
  • 当有用户请求过来时,再判断这个请求所用到的缓存是否过期,过期的话就去底层系统得到新数据并更新缓存。

缓存降级: 服务降级的目的,是为了防止Redis服务故障,导致数据库跟着一起发生雪崩问题。因此,对于不重要的缓存数据,可以采取服务降级策略,例如一个比较常见的做法就是,Redis出现问题,不去数据库查询,而是直接返回默认值给用户。

手把手讲解RTX5操作系统在GD32F407上的移植 然后将GD32F4xx_Demo_Suites_V2.6.4\GD32407V_START_Demo_Suites\Projects\01_GPIO_Running_LED下面的main函数复制到我们的项目文件夹中;打开对应GD32407V_START_Demo_Suites的文件夹下面的Utilities,复制gd32f407v_start.c和gd32f407v_start.h文件到一开始项目保存的文件夹下面;为了验证我们的操作系统是否被正确添加,是否能够正确运行,我们需要添加示例文件; 阅读详情

相关推荐

AI驱动全栈开发实战:基于Spec与Codex的规格驱动开发指南

1. 先搞清楚“AI重构前端全栈”到底在解决什么实际问题 最近很多人在聊“AI重构前端全栈”,听起来像是又一个营销概念。但如果你真的拆开看,它核心解决的是一个非常具体且痛苦的问题: 一个开发者,如何从零开始,系统性地、不跑偏地完成一个完整项目,并且保证代码质量和架构一致性。 传统开发流程里,产品经理出PRD,前后端开会对齐,前端画页面,后端写接口,测试再介入。这个过程沟通成本高,文档容易过时,新人上手慢。而“AI重构”的思路,是试图用一套 规范化的指令(Spec) 来驱动AI(比如Codex这类模型)生成代

weixin_30596023的博客 460

Redis基础篇

Redis是一款键值型数据库,由于Redis的开发者并没有开发Windows版本的Redis,只有Linux版本的Redis,当然微软自己开发了Windows版本的Redis,但是一般我们都是直接去学习Linux版本的Redis,它更加原汁原味,就像我们更加喜欢去读官方文档一样,所以在学习Redis之前,推荐大家先去熟悉一下Linux在了解Redis之前,我们需要先对数据库相关概念有一个大致的了解关系型数据库和非关系型数据库关系型数据库:指采用了关系模型。

热爱编程、热爱生活、热爱探索 6492

实战复盘:如何用Frida脚本绕过某书APP的libmsaoaidsec.so检测(附完整Hook代码)

本文深入探讨了如何利用Frida脚本绕过某书APP通过libmsaoaidsec.so实现的反Frida检测机制。通过分析动态链接过程中的关键节点和检测模式,提供了两种实战验证的绕过方案:动态Hook关键链接器函数和静态Patch SO文件。文章还分享了进阶对抗策略和调试技巧,帮助安全研究人员有效应对现代移动安全防护挑战。

weixin_42706667的博客 219

Redis 基础命令大全

Redis 命令速查手册(场景化分类版) 🔑 核心操作篇 键管理 SET token:123 "abc" EX 60 # 设置60秒过期的token DEL user:456 # 删除用户缓存 EXISTS order:789 # 检查订单是否存在 原子计数 INCR article:1001:views # 文章阅读量+1 DECR inventory:item5 # 库存扣减 💾 数据结构实战 用户画像存储(Hash) HSET user:1001 name "王强" age 28 tags "程序

m0_61118741的博客 749

Spark入门:从零到能跑的实战教程

Spark 的强大在于它统一了大数据处理的多种场景,从批处理到流处理,从 SQL 到机器学习。对于初学者来说,理解 Spark 的核心理念——内存计算和分布式抽象,是最重要的一步。接着,学会用 PySpark 搭建环境,能读数据、能写 SQL,基本上就入门了。剩下的路,就是通过实战去加深理解。写到这里,相信你对 Spark 已经有了一个比较完整的认识。下一步,不妨自己动手写几个 PySpark 脚本,跑一跑日志数据,或者尝试用 Spark SQL 做一个统计。

Morpheon的博客 1371

tkinter表格进阶:5分钟实现CSV数据可视化编辑界面(含右键菜单配置)

本文详细介绍了如何使用Python的tkintertable库快速构建CSV数据可视化编辑界面。通过导入导出CSV数据、深度定制右键菜单(如复制、插入行、删除行)以及实现单元格验证等进阶功能,开发者能在5分钟内创建一个可嵌入自动化流程的专业级桌面数据编辑工具,显著提升数据处理效率。

931

Redis 基础数据改造

痛点一:因为基础数据不属于频繁更新的数据,所以每个应用都有自己和缓存,当基础数据更新后,各个应用缓存刷新不及时就会导致应用数据不一致问题。问题点:接口的可靠性(如果接口挂掉就会影响改签和下单流程)和数据的准确性(与数据库数据不一致时,会影响用户形成)。基础数据查询服务:提供航司(5000家)、机场(4000)、票台(40000)、城市(4000)等基础数据信息。,配置化加载核心数据。基础服务模块的功能:保证服务的数据一致性,并达到数据限流的目的。痛点:基础数据使用的是全量的缓存,所以数据量会很大。

程序猿进阶 1万+

GPT-5.5 是真好用!SCI论文润色与学术写作能力上全面提升,全流程指令已整理好!

输出规范:先输出完整的摘要正文,不添加额外说明,以Markdown表格形式提供中文自检说明,表格包含两列,列标题为“检查项”和“说明”,逐项说明是否已覆盖背景、研究问题、方法、结果及贡献,并简要评价摘要结构与表达是否符合要求,除上述内容外不输出其他信息。:你是一位(学术写作专家/期刊审稿人/论文评审专家),精通学术写作规范、逻辑结构、语法准确性及学术表达方式,你的任务是帮助提升论文的质量,包括语言润色、语法检查、逻辑优化和降低重复率。语言需简洁、正式、具有概括性,不展开具体论述,仅提供结构与要点说明。

智能AI让学术科研更容易 289

【Redis基础】初识redis

存储方式关系型数据库基于磁盘进行存储,会有大量的磁盘IO,对性能有一定影响非关系型数据库,他们的操作更多的是依赖于内存来操作,内存的读写速度会非常快,性能自然会好一些扩展性关系型数据库集群模式一般是主从,主从数据一致,起到数据备份的作用,称为垂直扩展。非关系型数据库可以将数据拆分,存储在不同机器上,可以保存海量数据,解决内存大小有限的问题。称为水平扩展。关系型数据库因为表之间存在关联关系,如果做水平扩展会给数据查询带来很多麻烦。

my_banana的博客 462

【WRF理论第十五期】WPS中输入geogrid二进制格式

WPS中输入geogrid二进制格式

WW、forever的博客 1080

lammps剪切模拟的三种实现方法

本文介绍了LAMMPS分子动力学模拟中三种剪切方法:fix deform全局盒子剪切、速度边界剪切和外力加载剪切。fix deform通过改变盒子形状实现均匀剪切,适合宏观力学参数计算;速度边界剪切通过固定边界原子施加速度模拟非均匀剪切,适合界面摩擦研究;外力加载剪切则通过施加恒定力研究材料屈服行为。文章详细说明了每种方法的适用场景、核心原理和关键命令,并强调应根据具体研究目标选择合适方法。这些方法为金属、聚合物等材料的剪切模拟提供了实用解决方案,可直接套用文中命令进行建模计算。

lammps_jiayou的博客 66

redis基础

redis基础

d1906989080的博客 1004

纯方位观测下的三维定位,IV-PLKF(Inverse Velocity-Weighted Pseudo-Linear Kalman Filter)

在现代定位系统中,纯方位观测因其无需测距设备的优势,在无线通信、无人机导航和室内定位等领域备受关注。本文深入探讨基于算法的三维定位方法,并提供完整的MATLAB仿真例程。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 673

Redis(Redis基础,SpringCache,SpringDataRedis)

本文详细讲解了redis基础内容,以及Spring Cache,Spring Data Redis技术的使用

qq_49474843的博客 2942

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【Redis】Redis基础

Redis安装及配置,10大数据类型,持久化,事务及管道,主从复制,哨兵,集群,SpringBoot集成Redis

比尔高特的博客 1278

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

【Redis】 Redis 基础命令和原理

Redis 本质上是一个 Key-Value(键值对,KV)数据库,在它丰富多样的数据结构底层,都基于一种统一的键值对存储结构来进行数据的管理和操作 Redis 使用一个全局的哈希表来管理所有的键值对,这个哈希表就像是一个大字典,通过键(Key)能快速定位到对应的值(Value)。

Antonio915的博客 1248

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

Redis基础命令

简单讲一下Redis的基础命令‍。

2401_87853424的博客 755

Redis 基础使用

Redis 是单线程+多路 IO 复用技术Redis读写性能极高, Redis能读的速度是11万次/s,写的速度是8.1万次/s。是已知性能最快的Key-Value数据库Redis 为什么会用单线程?怎么理解单线程+多路 IO 复用技术?在 Redis 6.0 以前,Redis的核心网络模型选择用单线程来实现。对于一个 DB 来说,CPU 通常不会是瓶颈,因为大多数请求不会是 CPU 密集型的,而是I/O 密集型。

奇妙的代码 1197

Redis基础入门

简单介绍一下redis:redis是一种键值类型的数据库,我们之前学过mysql,mysql也是数据库,他们之间的区别是,redis把数据存储在磁盘中,redis把数据存储在内存中,mysql是二维表类型的数据库;leftPush向头部插入一个数据,leftPushAll插入多个,range获取指定范围的元素,rightPop删除尾部的元素,size获取列表的长度。put就是hset,delete就是hdel,get就是hget,keys,values就是hkeys,hvalues;del:删除key;

2301_79748665的博客 1554

Redis的基础通用命令

Redis是一个在内存中存储数据的中间件,可用于作为数据库,也可作为数据缓存。适用于分布式系统。Redis的一些特性:1、主要通过“键值对”的方式存储数据,是一种“非关系型”数据库。2、可编程的:针对Redis的操作,可以直接通过简单的交互式命令进行操作。也可以通过一些脚本的方式,批量执行一些操作(可以带有一些逻辑)。3、拓展性:可以在Redis原有的基础功能上再进行拓展。Redis提供了一组API,可以通过C,C++等语言编写Redis拓展。4、持久化。

m0_73629312的博客 1078

Redis的基础使用

本文介绍了Redis的基础知识和Redis中的数据类型。

cwtlw的博客 1240
上一篇: XML&SQL细节
下一篇: Spring事务管理之@Transactional注解
fufucen
博客等级 码龄8年 2粉丝 36原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值