Kafka入门教程

kafka菜鸟教程 是一个的,能够处理大规模的数据流,并提供低延迟的数据传输,它能够以每秒数十万条消息的速度进行读写操作。 阅读详情

1 Kafka安装

1.1 压缩包安装

1.1.1 JDK环境安装

Kafka是依赖JDK环境的,所以需要事先安装好JDK

  1. 下载JDK安装包: Oracle JDK8下载
  2. SSH上传到想要安装的目录,比如 /opt.然后使用tar -zxvf jdk-8u351-linux-x64.tar.gz命令解压
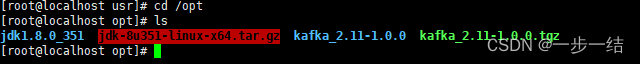
    在这里插入图片描述
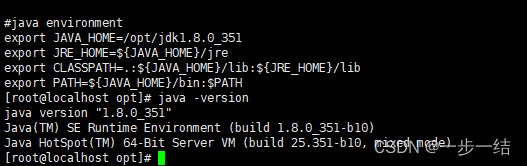
  3. 添加环境变量 vi /etc/profile,输入如下内容保存后,记得source /etc/profile刷新一下
    #java environment
    export JAVA_HOME=/opt/jdk1.8.0_351
    export JRE_HOME=${JAVA_HOME}/jre  
    export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib  
    export PATH=${JAVA_HOME}/bin:$PATH
    
  4. 输入java -version命令,显示版本号即安装成功
    在这里插入图片描述

1.1.2 Kafka安装

  1. 下载安装包,并解压到所需目录: kafka下载地址
  2. 根据如下文档操作即可: kafka中文文档–快速开始

1.2 Docker compose安装

  1. 事先安装docker,docker-compose服务
  2. 编辑docker-componse.yml配置文件
version: '3.2'
services:
  zookeeper:
    image: wurstmeister/zookeeper
    volumes:
      - ./data:/data
    ports:
      - 2182:2181
       
  kafka9094:
    image: wurstmeister/kafka
    ports:
      - 9092:9092
    environment:
      KAFKA_BROKER_ID: 0
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://47.118.83.142:9092
      KAFKA_CREATE_TOPICS: "kafeidou:2:0"   #kafka启动后初始化一个有2个partition(分区)0个副本名叫kafeidou的topic 
      KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
      KAFKA_LISTENERS: PLAINTEXT://0.0.0.0:9092
    volumes:
      - ./kafka-logs:/kafka
    depends_on:
      - zookeeper
  1. 使用docker-compose up -d --build启动服务
  2. 使用docker exec -it kakfa /bin/bash进入docker容器,后续验证操作同安装包安装

如下提供命令实操截图
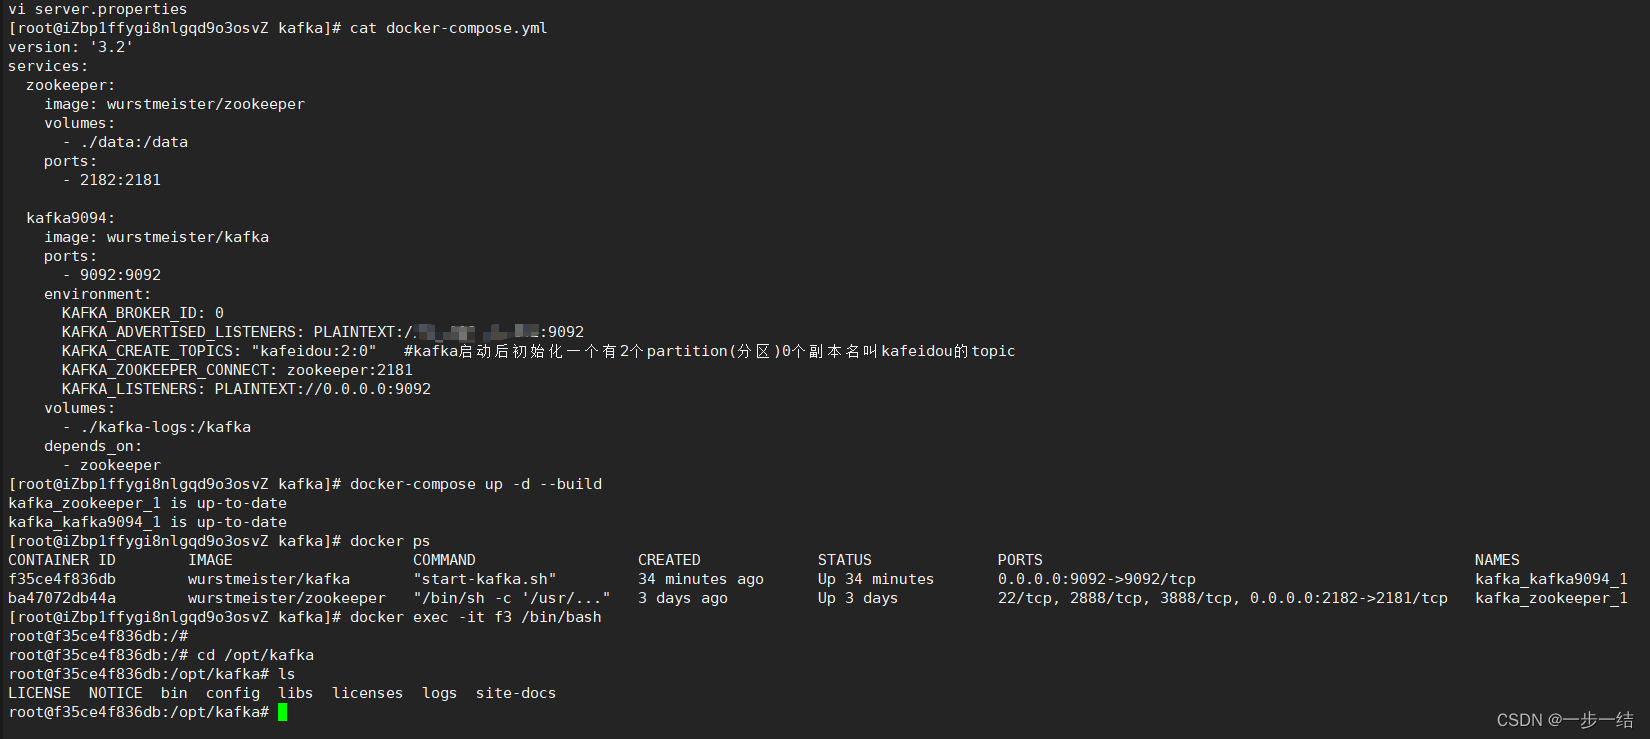
在这里插入图片描述

1.3 关于Kafka配置

kafka 配置一般在config/server.properties中,一般可能要修改的几个配置如下

    # 集群-broker唯一标识,多个broker记得修改
    broker.id=1
    # 端口号
    listeners=PLAINTEXT://0.0.0.0:9092
    # 日志地址,多个broker记得修改
    log.dir=/tmp/kafka-logs-1
    # 对外暴露的地址,docker记得填宿主机地址
    advertised.listeners=PLAINTEXT://xx:9092

如果linux操作没问题,但是外部连接不上kafka,检查advertised.listeners配置

2. Kafka API

2.1 概述

Kafka常用的API可以分为5类,包括admin,producer,consumer,stream,connect

2.1.1 Admin

实际就包含了topic的增删查功能

2.2.2 Producer

发放方式

  1. 异步非阻塞发送
  2. 异步阻塞发送
  3. 异步回调发送

注意:

  1. Producer是线程安全的,使用多线程操作同一个producer是没问题的
  2. Producer内部是批量发送的,虽然看起来是一条一条发送,但其内部是按批次来发送的

2.2.3 Consumer

  1. consumer不是线程安全的,多线程消费会有两种处理
    a. 每个线程都创建一个consumer,保证线程安全: 可以维护offset,相对更常用一点
    b. 只创建一个consumer,将消息异步处理: 无法保证offset,但是性能好
  2. consumer组内的消费者数量最好是和partition数量一致,绝对不能比partition多
  3. 手动控制offset起始位置: consumer.seek
  4. 限流: consumer.assign();consumer.pause();consumer.resume()
  5. Rabalance

2.3.4 Stream

一般结合spark或者flink等大数据引擎一起用
source processor->processor->stream->processor-> sink processor

2.3.5 Connect

目前来说是比较鸡肋的,不看也罢.主要应用常见就是导入导出数据,比如从A数据源导入B数据源

2.2 实战

实战方面建议从SE API开始进行,如果直接从Springboot开始,容易陷入Spring框架谜团中,不够纯粹.当SE API熟悉后,再整合Springboot会更得心应手.

2.2.1 创建Maven项目

新建空白Maven项目,然后引入Kakfa Client依赖

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>xyz.yq56</groupId>
    <artifactId>kafka_se</artifactId>
    <version>1.0-SNAPSHOT</version>

    <parent>
        <artifactId>spring-boot-parent</artifactId>
        <groupId>org.springframework.boot</groupId>
        <version>2.2.5.RELEASE</version>
    </parent>

    <dependencies>
        <dependency>
            <groupId>org.apache.kafka</groupId>
            <artifactId>kafka-clients</artifactId>
            <version>2.8.1</version>
        </dependency>
        <dependency>
            <groupId>org.apache.kafka</groupId>
            <artifactId>kafka-streams</artifactId>
            <version>2.8.1</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter</artifactId>
        </dependency>
    </dependencies>

</project>

2.2.2 Admin

创建和查询topic

public class AdminSample {

    public static final String TOPIC_NAME = "yq_topic";

    private static AdminClient client;

    public static AdminClient adminClient() {
        Properties props = new Properties();
        props.setProperty(AdminClientConfig.BOOTSTRAP_SERVERS_CONFIG, "192.168.1.103:9092");
        props.setProperty(AdminClientConfig.RECEIVE_BUFFER_CONFIG, String.valueOf(104857600));

        return AdminClient.create(props);
    }

    public static void main(String[] args) throws ExecutionException, InterruptedException {
        client = adminClient();
        System.out.println(client);

        createTopic();

        listTopics();
    }

    public static void createTopic() {
        short rs = 1;
        NewTopic newTopic = new NewTopic(TOPIC_NAME, 1, rs);
        CreateTopicsResult topics = client.createTopics(Collections.singletonList(newTopic));
        System.out.println("topics:" + topics);
    }

    public static void listTopics() throws ExecutionException, InterruptedException {
        ListTopicsResult topics = client.listTopics();
        Set<String> names = topics.names().get();
        names.forEach(System.out::println);
    }
}

3 Kafka面试题

3.1 Kafka如何保证有序性

  1. Kafka的特性只支持单Partition有序(不建议)
  2. key+offset保证业务有序

3.2 Kafka为什么吞吐量大

  1. 日志顺序读写和快速检索
  2. 零拷贝: sendfile
  3. Partition机制
  4. 批量发送接收和数据压缩机制

4 Kafka原理

4.1 日志

  1. 日志以Partition为单位保存
  2. 目录格式: Topic+数字
  3. 文件格式: 日志条目 序列
  4. 消息: 4字节头+N字节消息(消息长度,版本号 ,CRC校验码,具体消息)

4.1.1 日志分段

  1. 每个partition日志分成n个大小相等的segment
  2. 每个segment中消息数量不一定相等
  3. 每个partition只支持顺序读写

4.1.2 Segment存储结构

  1. Partiton将消息添加到最后一个segment中
  2. Segment达到一定阈值才会flush到磁盘
  3. Segment分为两部分: index和log

4.1.3 日志读操作

  1. 查找segment
  2. 全局offset,计算segment的offset
  3. 通过index的offset查找具体数据

4.1.4 日志写操作

  1. 串行追加消息到文件最后
  2. 文件达到阈值,则滚动到新文件中

4.2 零拷贝

sendfile

Kafka 入门教程(超详细) 文章目录1. Kafka 概述1.1 定义1.2 消息队列1.2.1 传统消息队列的应用场景1.2.2 消息队列的两种形式 1. Kafka 概述 1.1 定义    Kafka 是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。 1.2 消息队列 1.2.1 传统消息队列的应用场景 使用消息队列的好处: 解耦 允许独立的扩展或修改两边... 阅读详情

相关推荐

kafka入门教程,介绍全面

kafka 最简单的kafka入门教程

u013558123的博客 1523

kafka安装及入门

kafka入门教程

q704013673的博客 8992

Spark Streaming连接Kafka入门教程

转载请务必注明原创地址为:https://dongkelun.com/2018/05/17/sparkKafka/ 前言 首先要安装好kafka,这里不做kafka安装的介绍,本文是Spark Streaming入门教程,只是简单的介绍如何利用spark 连接kafka,并消费数据,由于博主也是才学,所以其中代码以实现为主,可能并不是最好的实现方式。 1、对应依赖 根据kafka版本选...

主要分享大数据相关的知识,如Spark、Hudi 5656

Redis实现消息队列

Redis实现轻量级的消息队列与消息中间件相比,没有高级特性也没有ACK保证,无法做到数据不重不漏,如果业务简单而且对消息的可靠性不是那么严格可以尝试使用。 列表类型 Redis中列表List类型是按照插入顺序排序的字符串链表,和数据结构中的普通链表一样,可以在头部left和尾部right添加新的元素。插入时如果键不存在Redis将为该键创建一个新的链表。如果链表中所有元素均被删除,那么该键也会...

ALIVE 2312

PX4飞控神经网络控制:从仿真到嵌入式部署实战

神经网络控制正逐步革新传统PID在无人机领域的统治地位。通过将深度学习模型部署到PX4飞控硬件,实现了从传感器数据直接生成电机指令的端到端控制。这种架构依赖TensorFlow Lite Micro等轻量级推理框架,在STM32等嵌入式处理器上可达到93μs级推理速度。关键技术突破包括:基于NVIDIA Isaac Gym的高效仿真训练、模型量化压缩技术(如8位整数量化)、以及与PX4原生安全架构的无缝集成。该方案在mRobotics Pixracer Pro等硬件上验证了可行性,为无人机姿态控制、视觉导航

weixin_30570101的博客 404

SillyTavern角色卡制作全攻略:如何用AI还原你喜欢的虚构角色(附三叶完整角色卡JSON)

本文详细介绍了如何使用SillyTavern制作高质量AI角色卡,以《你的名字》中的宫水三叶为例,从角色特征提取、对话风格捕捉到JSON结构优化,全面解析AI角色扮演的创作技巧。通过具体的写作示例和完整角色卡JSON,帮助二次元爱好者和同人创作者实现虚构角色的精准还原与生动互动。

pandas7gardener的博客 2144

confluent-kafka入门教程

注意:建议为长时间处理应用程序设置 enable.auto.offset.store=false,然后在消息处理后显式存储偏移(使用 offsets_store()),以确保在处理完成之前不会自动提交偏移。: 默认值为5ms, 在将消息发送前,等待生产者队列中的消息累积以构建消息批次(消息集)的毫秒级延迟。: 用于认证的SASL机制, 支持“GSSAPI, PLAIN, SCRAM-SHA-256, SCRAM-SHA-512, OAUTHBEARER”, 默认为“GSSAPI”此设置由高级消费者使用。

编程随手记 1667

【win11+vs 2017+OpenCV4.5.5+Qt5.12配置】详细安装过程+小问题解决

由于Qt5无法与最新的vs2022兼容,扩展工具中一直显示不可用,所以将vs降级成vs2017。在安装Qt的过程中,会选择安装Qt套件,其中就的MCVS 2017,说明vs2017是与qt兼容的。当然也可以用qt creator这一原生IDE。OpenCV版本目前是最新的4.8.0,使用过程中没有什么问题,但是还是安装低版本大概率避免一些玄学问题。

qq_45306739的博客 3351

大数据开发之Kafka和Kafka Restful Proxy的入门教程

消费者会定期将自己消费分区的offset提交给__consumer_offsets,key是consumerGroupId+topic+分区号,value就是当前offset的值,并且kafka会定期清理topic里的消息仅保留最新的那条数据,通过如下公式可以选出consumer消费的offset要提交到__consumer_offsets的哪个分区。新消费组中的消费者在启动以后,默认会从当前分区的最后⼀条消息的offset+1开始消费(消费新消息)。可以通过以下的设置,让新的消费者第⼀次从头开始消费。

刻苦的樊同学 1563

YOLOv5 改进点总览:轻量化、高精度的背后有哪些魔改?

YOLOv5是由Ultralytics团队开发的高效目标检测模型,其核心改进包括:主干网络采用CSPDarknet53提升梯度传播效率;特征融合使用PANet增强小目标识别;输出结构采用解耦头设计优化定位和分类任务。此外,YOLOv5通过CIoU损失函数、Mosaic数据增强和SimOTA标签分配机制进一步提升性能。模型支持多种推理格式(ONNX/TensorRT等),并具备自动锚框匹配和多尺度训练功能,使其在轻量化(yolov5s仅7MB)与高性能(最高51.2% mAP)间取得平衡,但缺乏正式论文支撑是

guoguozgw的博客 1806

同花顺PC端逆向解析:Hook注入与加密破解实战指南

在Windows客户端数据采集场景中,当常规HTTP爬虫失效时,内存级逆向分析成为获取实时行情数据的关键路径。其核心涉及进程注入、运行时解密、反调试绕过等底层技术,本质是理解PE加载机制、函数调用约定与内存保护策略的协同过程。同花顺作为典型加固客户端,采用ASPack加壳+自研解密+多线程校验三重防护,迫使开发者转向APC注入、动态密钥提取与XXTEA算法复刻等高阶手段。本文聚焦于DLL注入选型依据、解密函数定位方法及二进制Blob结构化解析,最终实现从内存读取到Pandas DataFrame的端到端数据

weixin_32234493的博客 1211

Spring-Kafka史上最强入门教程

Spring-Kafka史上最强入门教程 Spring-Kafka(一)—— Kafka,你好 Spring-Kafka(二)—— 快速入门,只需三秒 Spring-Kafka(三)—— 操作Topic以及Kafka Tool 2的使用 Spring-Kafka(四)—— KafkaTemplate发送消息及结果回调 Spring-Kafka(五)—— 使用Kafka事务的两种方式 Spring-...

BraveHeart 2935

贝叶斯(Bayes)决策理论

在博文【模式识别PR和模式的概念】介绍了相关的模式识别与模式的概念。在本节描述所要讨论的问题之前,再提一下对于待识别的物理对象的描述问题。假设一个待识别的物理对象用其d个属性观察值描述,称之为d个特征,这组成一个d维的特征向量,而这d维待征所有可能的取值范围则组成了一个d维的特征空间。一般地,机器实现自动分类有两大类方法:一种是模板匹配方法,另一种是对特征空间划分为子空间(每类的势力范围)的方法。

松子茶的专栏 3万+

kafka在windows下安装和使用入门教程

https://blog.youkuaiyun.com/weixin_43085439/article/details/106403168

one大白(●—●)的博客 302

C#上位机实战:工业产线数据采集与监控系统开发(附源码思路)

模块化设计:四层架构清晰,各模块独立可替换,便于后期维护与扩展;稳定性强:支持断线重连、异常重试、并发采集,满足工业7×24小时运行需求;实用性高:覆盖产线监控核心功能,可视化组件适配工业场景,操作简单;源码可复用:通信类、采集服务、报警管理器等可直接复制到其他上位机项目。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1656

Google Earth Engine(GEE)——将sentinel - 2影像所有波段重采样到10m分辨率 (resample 和 projection的使用)

影像重投影是将一个影像从一个坐标系投影到另一个坐标系的过程。这通常涉及到将像素从一个平面坐标系变换到另一个平面坐标系。这可以用于许多应用中,例如建立数字高程模型(DEM)和地图制图。影像重投影通常需要进行数学计算,包括转换矩阵和插值算法,以确保像素值的准确性和精度。这次我们将对哨兵2好数据中20m分辨率的波段,重采样到10m分辨率中,然后同一参与计算。

此星光明博客 3111

Kafka安装启动入门教程

1、下载 可直接在官网下载对应的版本http://kafka.apache.org/downloads,我下载的是二进制版的,由于我的scala版本是2.11,所以下载kafka_2.11-1.1.0.tgz,大家可以根据自己的实际情况选择对应的版本。执行以下命令即可下载到本地了。wget http://mirrors.tuna.tsinghua.edu.cn/apache/kafka/1.1.0/kafka_2.11-1.1.0.tgz 2、解压到指定目录 tar -xzf kafka_2.11-1

m0_63016685的博客 411

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

KafKa基本入门教程

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_33915554的博客 145

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Kafka教程(一)Kafka入门教程

Message Queue 消息传送系统提供传送服务。消息传送依赖于大量支持组件,这些组件负责处理连接服务、消息的路由和传送、持久性、安全性以及日志记录。消息服务器可以使用一个或多个代理实例。 JMS(Java Messaging Service)是Java平台上有关面向消息中间件(MOM)的技术规范,它便于消息系统中的Java应用程序进行消息交换,并且通过提供标准的产生、发送、接收消息的接口简化企业应用的开发,翻译为Java消息服务。

yuan_xw的专栏 7万+

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Kafka 入门教程之一: 安装

<!DOCTYPEhtml><html><head><title>Kafka入门教程之一:安装</title><metacharset='utf-8'><linkhref='https://cdn.maxiang.io/res-min/themes/marxico.css'rel='st...

weixin_34306446的博客 9万+

KAFKA入门教程

进入kafka官网下载对应版本kafkakafka官网地址:Apache Kafkakafka是使用Scala开发,所以版本号是由 Scala的版本号和Kafka版本号组成的,如:kafka_2.12-3.2.0 , 2.12是scala版本, 3.2.0是kafka版本,下载完成解压得到kafka,目录结构如下:结构介绍: 可以进入config文件夹,修改kafka和zookeeper配置文件:zookeeper.properties是作为zookeeper的配置文件,dataDir为数据目录,clie

九离的博客 4171
上一篇: 达到阈值自动执行的工具类
下一篇: Linux常用命令总结
一步一结
博客等级 码龄7年 50粉丝 65原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值