BP 算法 (Back-propagation Algorithm) 之较直观的解释

<2> BP(Backprop) Algorithm 原文解读 原文:Learning representations by back-propagating errors, 1986 作者:David E. Rumelhart*, Geoffrey E. Hintont & Ronald J. Williams* 1.目标: 使得网络的输出尽可能地接近理想的输出,因此需要调整代表着特征表示的隐藏节点的权重。但是,对于特定的任务哪些隐藏节点所表示的特征才是所希望的很难直接了解。为了在端对端中实现自动的特征选择,因此提出了BP算法。 2.算... 阅读详情

0. 前言

之前上模式识别课程的时候,老师也讲过 MLP 的 BP 算法, 但是 ppt 过得太快,只有一个大概印象。后来课下自己也尝试看了一下stanford deep learning 的 wiki, 还是感觉似懂非懂,不能形成一个直观的思路。趁着这个机会,我再次 revisit 一下。本文对自己思路进行一些整理,分享自己的一些心得。

1. LMS 算法

故事还要从线性 model 说起~在线性 model 里面,常见的有感知机学习算法、 LMS 算法等。感知机算法的损失函数是误分类点到 Target 平面的总距离,直观解释如下:当一个实例点被误分,则调整 w, b 的值,使得分离超平面向该误分类点的一侧移动,以减少该误分类点与超平面的距离,在 Bishop 的 PRML一书中,有一个非常优雅的图展现了这个过程。但是了解了 MLP 的 BP 算法之后,感觉这个算法更多是受 LMS 算法的启发,虽然从名字上 MLP 叫做多层感知机,感知机算法是单层感知机。

LMS (Least mean squares) 算法介绍比较好的资料是 Andrew Ng cs229 的 Lecture Notes。假设我们的线性 model 是这样的:

在上面这个模型中,用公式可以表达成:

如何判断模型的好坏呢?损失函数定义为输出值 h(x) 与目标值 y 之间的“二乘”:

对偏导进行求解,可以得到:

如果要利用 gradient descent 的方法找到一个好的模型,即一个合适的 theta 向量,迭代的公式为:

所以,对于一个第 i 个单独的训练样本来说,我们的第 j 个权重更新公式是:

这个更新的规则也叫做 Widrow-Hoff learning rule, 从上到下推导下来只有几步,没有什么高深的理论,但是,仔细观察上面的公式,就可以发现几个 natural and intuitive 的特性。

  1. 首先,权重的更新是跟 y - h(x) 相关的,如果训练样本中预测值与 y 非常接近,表示模型趋于完善,权重改变小。反之,如果预测值与 y 距离比较远,说明模型比较差,这时候权重变化就比较大了。

  2. 我的理解:权重的变化还与 xi 也就是输入节点的值相关(废话)。也就是说,在同一次 train 中,由于 y - h(x) 相同, 细线上的变化与相应的输入节点 x 的大小是成正比的(参考最上面的模型图)。这中间体现的规律就是:残差的影响是按照 xi 的大小按比例分配到权重上去滴,这里的残差就是 h(x) - y. 从直观的角度,俺觉得这才是理解 BP 向后传播残差的关键。

LMS 算法暂时先讲到这里,后面的什么收敛特性、梯度下降之类的有兴趣可以看看 Lecture Notes。

2. MLP 与 BP 算法

前面我们讲过 logistic regression, logistic regression 本质上是线性分类器,只不过是在线性变换后通过 sigmoid 函数作非线性变换。而神经网络 MLP 还要在这个基础上加上一个新的nonlinear function, 为了讨论方便,这里的 nonlinear function 都用 sigmoid 函数,那么, MLP 的结构就可以用下面这个图来表示:


z: 非线性变换之前的节点值
a: 非线性变换之后的 activation 值

现在我们要利用 LMS 中的想法来对这个网络进行训练。

假设在某一个时刻,输入节点接受一个输入, MLP 将数据从左到右处理得到输出,这时候产生了残差。在第一小节中,我们知道, LMS 残差等于 h(x) - y。 MLP 的最后一层和 LMS 线性分类器非常相似,我们不妨先把最后一层的权重更新问题解决掉。在这里输出节点由于增加了一个非线性函数,残差的值比 LMS 的残差多了一个求导:
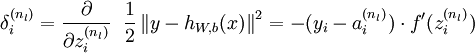
得到残差,根据之前猜想出来的规律( - -!), 残差的影响是按照左侧输入节点的 a 值大小按比例分配到权重上去的,所以呢,就可以得到:
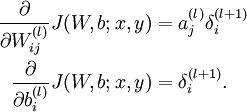
如果乘以一个 learning rate, 这就是最后一层的权重更新值。

最后一层的权重解决了,中间的隐层该怎么处理?

我们在想,要是能得到中间隐层节点上的残差,问题就分解成几个我们刚刚解决的问题。关键是:中间隐层的残差怎么算?

实际上还是按比例分配影响这个思想的再一次应用,只不过这一次是按照权重的大小按比例将残差返回到上一层。完了之后还要乘以非线性函数的导数(有没有更好的解释?):
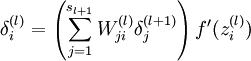
得到隐层的残差,我们又可以得到前一层权重的更新值了。这样问题就一步一步解决了。

最后我们发现,其实咱们不用逐层将求残差和权值更新交替进行,可以这样:

  1. 先从右到左把每个节点的残差求出来(数学上表现为反向传导过程)

  2. 然后再求权重的更新值

  3. 更新权重

用图表示残差的反向传播:

红色的曲线就是对 sigmoid function 的求导,和高斯分布非常相似。

更多细节请参考 stanford deep learning 的英文教程或中文教程。


参考资料:

反向传导算法
BP算法浅谈
统计学习方法 李航 着

作者:daniel-D 出处:/link.php?url=http://www.cnblogs.com/daniel-D/ 欢迎转载或分享,但请务必声明文章出处 ^ ^

 

原文链接


深度学习框架Keras学习系列(二):神经网络与BP算法(Neural Network and BP Algorithm) 概念 神经网络 Logistic Regression 梯度下降算法Gradient Descent Logistic Regression的梯度下降 神经网络模型概念神经网络请参照这篇文章神经网络浅讲:从神经元到深度学习,以对神经网络的发展历史以及其数学原理有一个基本的了解。本文只对将要在后续过程中使用的神经网络模型进行介绍。神经网络本质上是一个数理模型,它最初的灵感来自于人大脑中的神经系统,不过 阅读详情

相关推荐

BP算法浅谈(Error Back-propagation)

最近在打基础,大致都和向量有关,从比较基础的人工智能常用算法开始,以下是对BP算法研究的一个小节。       本文只是自我思路的整理,其中举了个例子,已经对一些难懂的地方做了解释,有兴趣恰好学到人工智能对这块不能深入理解的,可以参考本文。       因为大部分涉及公式,我

pennyliang的专栏 6万+

03_反向传播算法(BP算法)· 原理+演算

反向传播算法(Backpropagation Algorithm,BP算法)是深度学习的重要思想基础 其实,大概意思就是在输入和输出之间构造神经网络(像人的大脑神经网络一样),当然这个神经网络里面会有很多的神经节点和节点之间相连的边(就想神经元由前到后相连)。然后,这个神经网络作为一个计算的网络,里面会有一些参数,要是参数选的好的话,那么这个模型就可以拿去用了,比如说,看到一张狗的照片,就知道这个是狗了。而反向传播算法就是从结果出发一步步去约束其中的参数,然后使得参数达到最优的状态。 看一看神经元,这里

猪猪的博客 5059

Silvaco Atlas新手入门:从安装到第一个半导体器件仿真(附DeckBuild配置)

本文为Silvaco Atlas新手提供了一份从软件安装、DeckBuild环境配置到完成第一个半导体器件仿真的实战指南。通过构建一个经典的PN结二极管案例,详细讲解了Atlas仿真语句的语法、核心命令顺序以及结果调试与可视化方法,帮助初学者快速上手并理解TCAD仿真流程。

sql99的博客 333

神经网络和深度学习(二)——BP(Backpropagation Algorithm, 反向传播算法)

上一周主要看了 Neural Networks and Deep Learning  网上在线课程的第二章的内容 和 斯坦福大学 《机器学习》的公开课,学习了BP( Back Propagation Algorithm, 反向传播算法)。现在总结如下:        只要使用神经网络就会用到BP算法,反向传播算法可以用来学习神经网络的权值,仍然采用梯度下降算法,以最小化网络的实际输出与目

亮亮的博客 3181

双通道中频信号数字下变频及相位差估计(FPGA)

双通道中频信号数字下变频及相位差估计实验 一、上框图(通俗易懂) 二、实验要求 1、 用点频信号模拟中频信号:中频信号由DDS1和DDS2产生。具体产生方法见第2点。 2、 DDS1和 DDS2:调用IPcore里的数字信号处理中的NCO模块,工作时钟为100MHz,数据率即为100MHz,DDS1和DDS2的频率为:(学号后三位+500)Khz+f0(可设为20MHz);输出为16位;DDS1...

qq_39809425的博客 6947

【暂时完结】Prescan学习笔记

Prescan学习记录1. Prescan基础知识1.1 Conventions·坐标1.2 Road segment·道路片段1.2.1 让一个路段连接其他两个路段1.2.2 配置车道线1.2.3 Road marking·道路标志1.3 Trajectory·轨迹1.3.1 建立一个Path·路径1.3.2 配置Speedprofile1.3.3 Synchronization of Trajectories·轨迹同步1.3.4 Multiple trajectories · 多轨迹分配 1. Pres

dreautumn的博客 1万+

Deep learning---------------Back propagation Algorithm(BP algorithm)

假设我们有一个固定样本集 ,它包含  个样例。我们可以用批量梯度下降法来求解神经网络。具体来讲,对于单个样例 ,其代价函数为: 这是一个(二分之一的)方差代价函数。给定一个包含  个样例的数据集,我们可以定义整体代价函数为: 以上公式中的第一项  是一个均方差项。第二项是一个规则化项(也叫权重衰减项),其目的是减小权重的幅度,防止过度拟合。 [注:通常权重衰减

精锐小庄的专栏 1878

手把手教你利用qemu搭建银河麒麟V11 arm环境

在Windows环境下,初学者或企业用户常通过VMware、VirtualBox等虚拟机软件安装Ubuntu、Red Hat等Linux系统,这类工具更侧重X86等复杂指令集架构(CISC,常见于Intel、AMD处理器)的虚拟化。而QEMU是一款开源的虚拟机监视器与模拟器,核心优势在于可模拟ARM、MIPS、RISC-V等精简指令集架构(RISC)的处理器并提供虚拟化能力,更适合对虚拟化技术有一定了解的用户。可能是电脑性能问题,安装过程比较慢,需要耐心等待。等操作系统下载完成后,进行安装了。

huanhuanzhou blog 2457

Back Propagation Algorithm

以前写的算法。(数据集见图) package BP; import java.io.BufferedReader; import java.io.BufferedWriter; import java.io.FileReader; import java.io.FileWriter; import java.io.IOException; import java.util

JChen的博客 513

STM32H745xI双核芯片SMPS/LDO配置误区:从复位失败到精准排查的实战复盘

本文详细分析了STM32H745xI双核芯片在SMPS/LDO配置中的常见误区,特别是复位失败问题的排查过程。通过对比参考板与故障板的波形数据,揭示了电感选型不当导致的电源稳定性问题,并提供了硬件设计检查清单和调试技巧,帮助开发者避免类似陷阱。

weixin_42531588的博客 265

深度解析 Android 开发工程师岗位:技术栈、职责与面试全攻略

本文深度剖析Android开发工程师职位要求,从核心技术栈到面试准备进行全面解读。关键点包括:1)掌握Kotlin语言特性和Jetpack组件;2)具备UI开发、性能优化和逆向分析能力;3)理解MVVM架构和Room数据库;4)熟悉常用工具链和开发流程。文章提供了详细的面试题库及解析,涵盖基础概念、UI优化、架构设计等方向,并给出职业发展建议:夯实基础、拓展技术广度、培养工程素养。旨在帮助开发者系统性地准备Android岗位求职,把握移动开发领域的技术趋势。

郑伟强dev的专栏 174

误差反向传播算法(BP,Back-Propagation algorithm)(一)

多层感知器网络(MLP)的设计 1.选定层数:通常采用三层网络(因为增加网络层数并不能提高网络的分类能力; 2.输入层:输入层节点数为输入特征的维数 n, 激活函数采用线性函数; 3.隐层:隐层可实现非线性分类,其节点数需要设定;一般的,隐层节点数越多,网络的分类能力就越强,激活函数一般采用 Sigmoid 函数; 4.输出层:输出层节点数可以等于类别数,也可采用编码输出的方式(少于类别数),激活函数可使用线性函数或Sigmoid 函数。 如上图所示,该三层网络的判别函数形式为 Y3=f3(∑k=1n2w

qq_41536160的博客 1350

Python爬虫教程:抓取Android或iOS应用中的数据

随着智能手机的普及,移动应用程序已经成为我们生活中不可或缺的一部分。从社交媒体、在线购物到金融服务和健康管理,几乎所有领域都有相应的手机应用程序(App)服务用户。而这些应用程序通常会存储大量的数据,例如用户行为、产品信息、订单记录等。如果我们能有效地抓取这些数据,可以为数据分析、商业智能、用户行为分析等提供有力支持。本文将重点介绍如何使用Python爬虫技术抓取Android或iOS应用中的数据,尤其是如何从这些应用的后端接口、存储、或网页中提取数据。我们将探讨如何通过反向工程技术访问移动应用中的API接

2201_76125261的博客 802

误差反向传播算法(BP,Back-Propagation algorithm)(二)

有关BP算法的原理及推导可参见**误差反向传播算法(BP,Back-Propagation algorithm)(一)* BP算法分析 利用 BP 算法对网络进行训练,每一次前向传播,则必有一次后向传播来修改网络权值;后向传播的计算代价和前项是一致的,因此BP网络的计算代价是前向网络的两倍。 BP网络具备很强的非线性映射能力,能够学习和存储大量输入—输出模式映射,而无须存在描述这种映射关系的数学方程。同时,假定隐层的节点可以根据需要自由设置,那么三层的 Sigmoid 激活函数的网络可以以任意精度逼近任何连

qq_41536160的博客 1080

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

Back Propagation Algorithm 后向传播算法

Back Propagation Algorithm 后向传播算法 本文所有图片来自浙大课程截图 Intro NN need to compute a lot of partial derivative. We can use the inner relationships to simplify computing. Basic equations: {z1=ω11x1+ω21x2+b1z2=ω...

weixin_45286813的博客 389

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Neural Network based on Eorr Back Propagation典型BP网络c++实现

参考资料:人工神经网络-韩力群PPT         看了一些关于基于神经网络的语言模型, 与传统语言模型相比, 除了计算量让人有点不满意之外, 不需要额外的平滑算法, 感觉它们的效果让人惊讶。 这些网络里面都能看到BP的影子, 可以说BP网络是最基本的, 掌握扎实了, 对其他结构理解会更深刻, 于是早在学习语言模型之前我自己曾经用c++写过一个简单的BP网络,虽然功能简单,只有最基本的三

天道酬勤,做一个务实的理想主义者 2235

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

今日学习——反向传播(Back Propagation算法BP算法)

前向传播和反向传播是神经网络进行参数优化运算时必不可少的两个步骤。前向传播是指:神经网络前一层的输出作为下一层神经元的输入,带入去计算下一层的输出并且不断前进,直到得到整个神经网络的输出。反向传播与之对应,是指:每次前向传播过程结束得到整个网络的输出后,计算神经网络输出和真实样本标记之间的差距作为损失函数,并以此损失函数反过来从网络的输出层开始往网络的输入层不断计算各层参数的梯度的方法。

m0_61165991的博客 290

BACK_PROPAGATION初学笔记

一、感知器 神经元又叫感知器:它可以拟合任何的线性函数,任何线性分类或线性回归问题都可以用感知器来解决。异或不行,因为不能用一条直线将异或的结果分类 m个输入,n个输出,隐含层为     其中单个神经元: xi 为输入, wi为权重,在-1到1之间,b为偏置项 为激励值,在-1到1之间 激活函数:阶跃函数: 输出=f(wi*xi+```+```+b) 设阈值为1,

muyexueshang的博客 363

前向传播算法 Forward propagation 与反向传播算法 Back propagation

前向传播算法 Forward propagation 与反向传播算法 Back propagation

qq_45033818的博客 180

基于COA与BP神经网络回归模型的特征选择方法研究(Python实现)

本项目提出了一种基于郊狼优化算法(COA)和BP神经网络的特征选择方法。通过COA算法从10维特征中筛选最优特征子集,结合BP神经网络构建回归模型。实验使用2000条无缺失数据,经预处理和探索性分析后,采用80/20划分训练测试集。模型评估显示R方达0.9854,MSE为621.48,证明该方法能有效提升预测性能。项目提供了完整的Python实现代码、数据处理流程和模型评估指标,为高维数据特征选择提供了实用解决方案。

张陈亚的博客 805

前向传播算法(Forward propagation)与反向传播算法(Back propagation)

神经网络——最易懂最清晰的一篇文章

qq_45140518的博客 336
上一篇: 浅谈C\C++代码优化中的一些小技巧
下一篇: linux 无敌权限
jstudy0
博客等级 码龄16年 101粉丝 11原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值