一个100G文件 0.2 秒复制完?背后到底是谁的功劳?

DeepSeek-V3.2稀疏注意力工程实践:DSA、CANN与本地部署全指南 稀疏注意力(Sparse Attention)是大语言模型处理长上下文的核心技术,其原理在于通过结构化稀疏计算降低显存带宽压力,而非简单跳过token。相比FlashAttention-2等通用优化方案,DeepSeek-V3.2提出的DSA(DeepSeek Sparse Attention)结合硬件感知编译器CANN,实现了从算法设计到GPU kernel级的端到端协同优化,显著提升128K长文本推理的吞吐与延迟稳定性。该技术已落地于交通调度、法律审查等真实业务场景,在RTX 4090等消费级显卡上达成 阅读详情

今天给大家分享一篇关于100G文件0.2秒复制完的背后故事!

文章来源:本文转自公众号奇伢云存储
71d5db63d67d129a299dba6805e5b0c2.jpeg

cp 引发的思考

今天同事用 cp 命令,把他给惊到了!背景是这样的:他用 cp  拷贝了一个 100 G的文件,竟然一秒不到就拷贝完成了!

用 ls  看一把文件,显示文件确实是 100 G。

sh-4.4# ls -lh
-rw-r--r-- 1 root root 100G Mar  6 12:22 test.txt

但是copy起来为什么会这么快呢?

sh-4.4# time cp ./test.txt ./test.txt.cp

real 0m0.107s
user 0m0.008s
sys 0m0.085s

一个 SATA 机械盘的写能力能到 150 M/s (大部分的机械盘都是到不了这个值的)就算非常不错了,正常情况下,copy 一个 100G 的文件至少要 682 秒 ( 100 G/ 150 M/s ),也就是 11 分钟。

实际情况却是 cp 一秒没到就完成了工作,惊呆了,为啥呢?

更诡异的是:他的文件系统只有 40 G,为啥里面会有一个 100 G的文件呢?

同事把我找来,看看这个诡异的问题。

分析文件

我让他先用 du 命令看一下,却只有 2M ,根本不是100G,这是怎么回事?

sh-4.4# du -sh ./test.txt
2.0M ./test.txt

再看 stat 命令显示的信息:

sh-4.4# stat ./test.txt
  File: ./test.txt
  Size: 107374182400 Blocks: 4096       IO Block: 4096   regular file
Device: 78h/120d Inode: 3148347     Links: 1
Access: (0644/-rw-r--r--)  Uid: (    0/    root)   Gid: (    0/    root)
Access: 2021-03-13 12:22:00.888871000 +0000
Modify: 2021-03-13 12:22:46.562243000 +0000
Change: 2021-03-13 12:22:46.562243000 +0000
 Birth: -

stat 命令输出解释:

  1. Size 为 107374182400(知识点:单位是字节),也就是 100G ;

  2. Blocks 这个指标显示为 4096(知识点:一个 Block 的单位固定是 512 字节,也就是一个扇区的大小),这里表示为 2M;

划重点:

  • Size 表示的是文件大小,这个也是大多数人看到的大小;

  • Blocks 表示的是物理实际占用空间;

同事问道:“文件大小和实际物理占用,这两个竟然不是相同的概念 !为什么是这样?”

“看来,我们必须得深入文件系统才能理解了,来,我给你好好讲讲。”

文件系统

文件系统听起来很高大上,通俗话就用来存数据的一个容器而已,本质和你的行李箱、仓库没有啥区别,只不过文件系统存储的是数字产品而已。

我有一个视频文件,我把这个视频放到这个文件系统里,下次来拿,要能拿到我完整的视频文件数据,这就是文件系统,对外提供的就是存取服务。

现实的存取场景

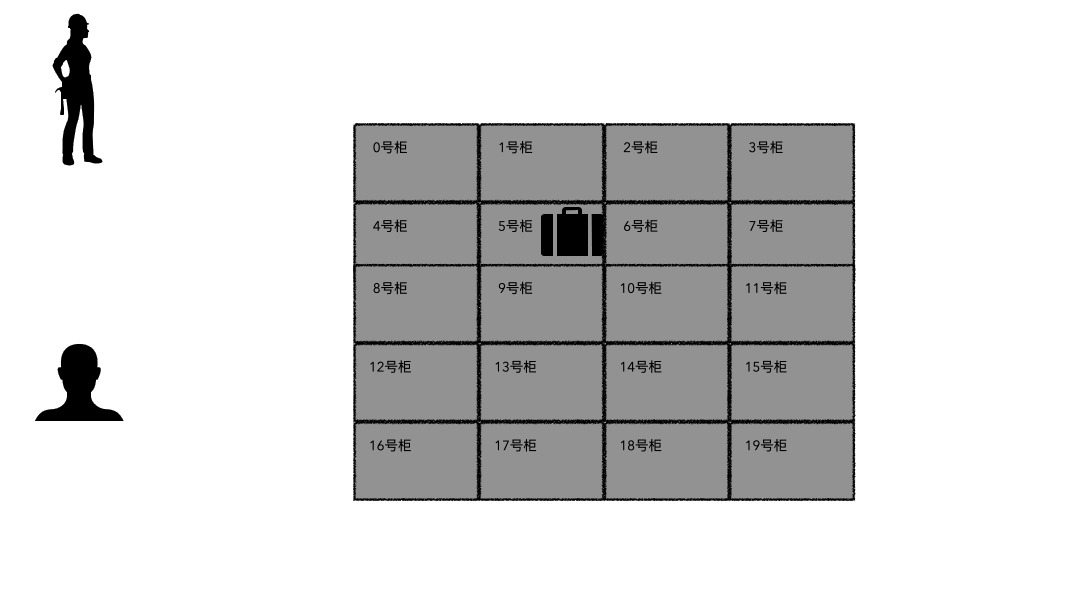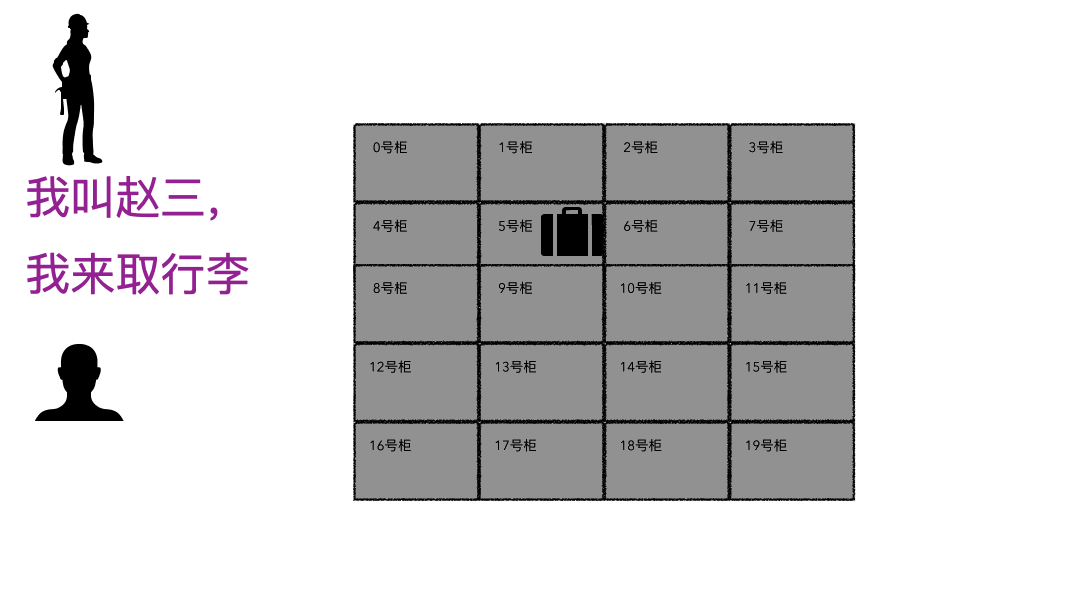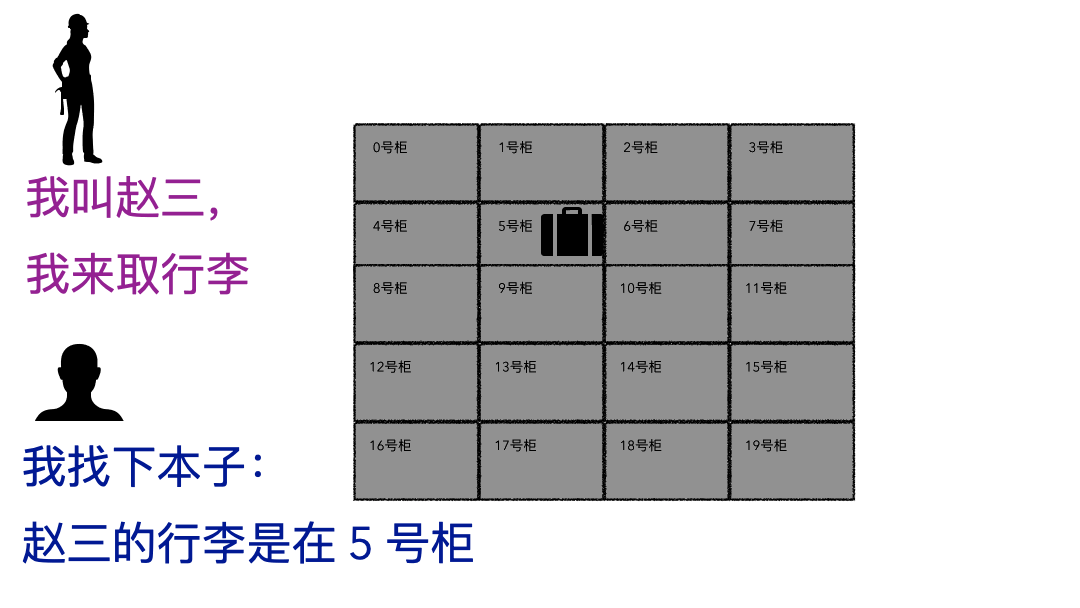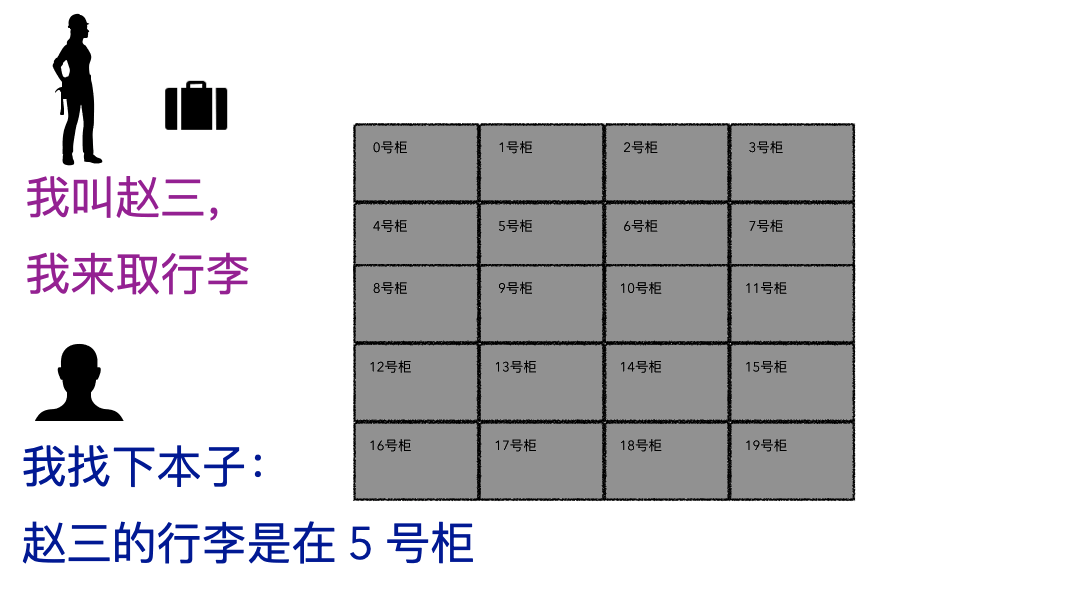
例如你到火车站使用寄存服务:

存行李的时候,是不是要登记一些个人信息?对吧,至少自己名字要写上。可能还会给你一个牌子,让你挂手上,这个东西就是为了标示每一个唯一的行李。
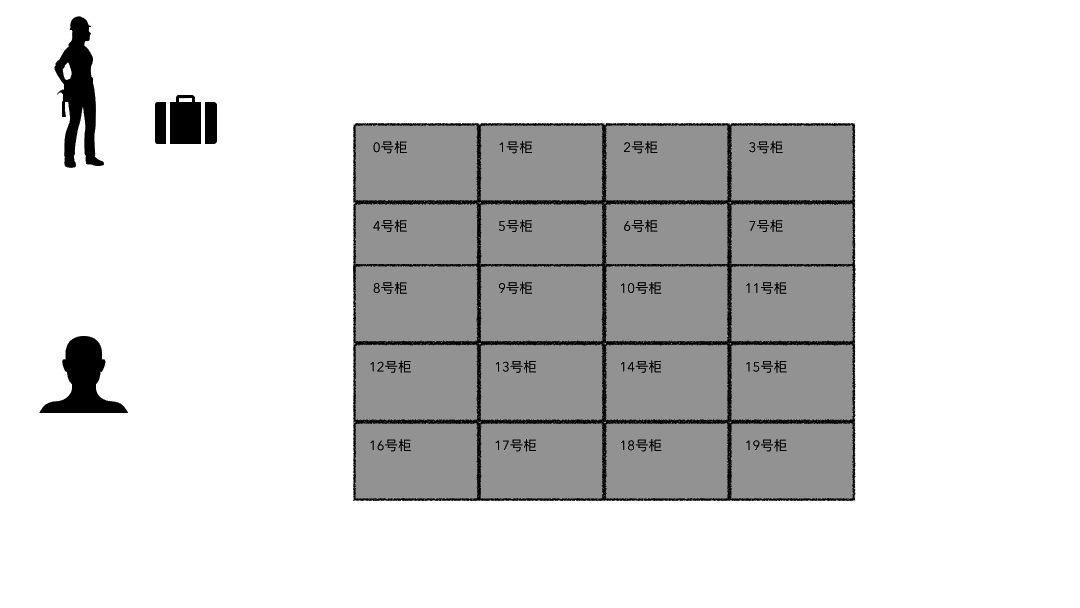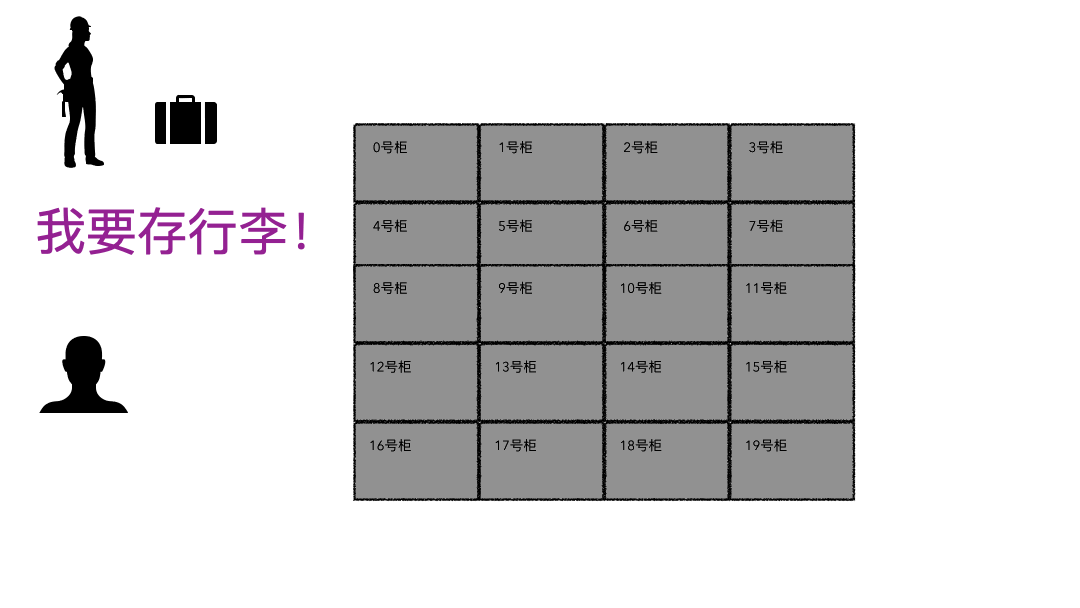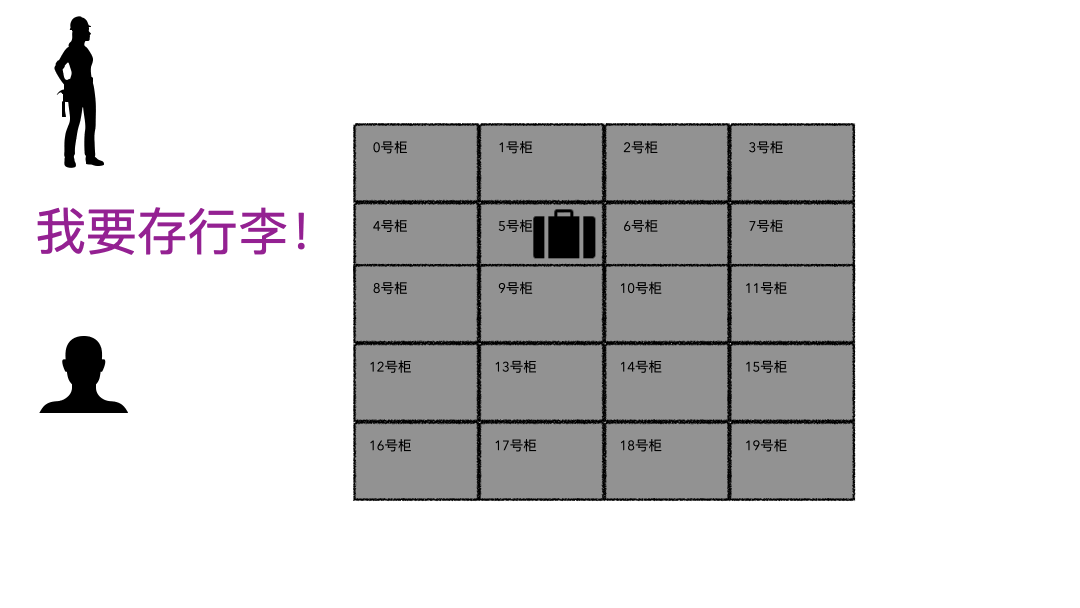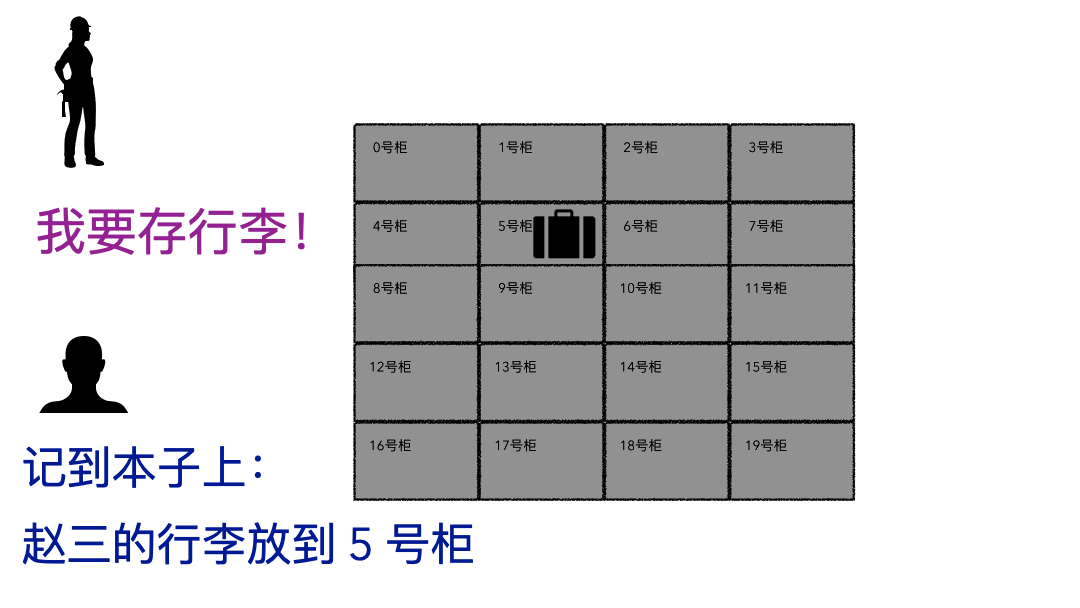
4384f342dedff9959ff35acb4af14e5b.gif

取行李的时候,要报自己名字,有牌子的给他牌子,然后工作人员才能去特定的位置找到你的行李
e4e1aa3b0a632482cf4c05c200ade9c0.gif

划重点:存的时候必须记录一些关键信息(记录ID、给身份牌),取的时候才能正确定位到。

文件系统

回到我们的文件系统,对比上面的行李存取行为,可以做个简单的类比;

  1. 登记名字就是在文件系统记录文件名;

  2. 生成的牌子就是元数据索引;

  3. 你的行李就是文件;

  4. 寄存室就是磁盘(容纳东西的物理空间);

  5. 管理员整套运行机制就是文件系统;

上面的对应并不是非常严谨,仅仅是帮助大家理解文件系统而已,让大家知道其实文件系统是非常朴实的一个东西,思想都来源于生活。

空间管理

现在思考文件系统是怎么管理空间的?

如果,一个连续的大磁盘空间给你使用,你会怎么使用这段空间呢?

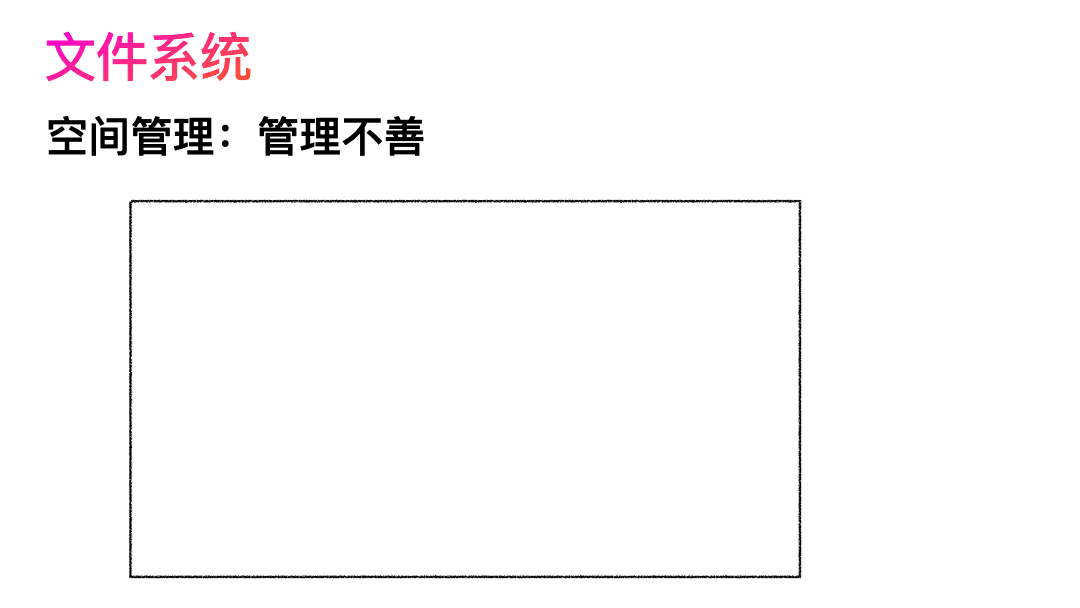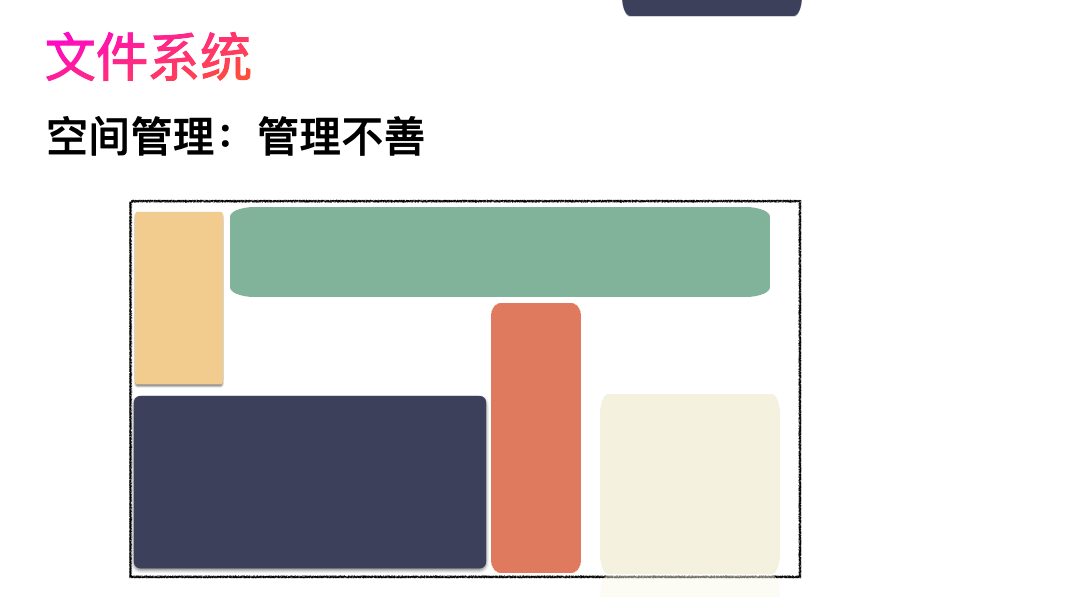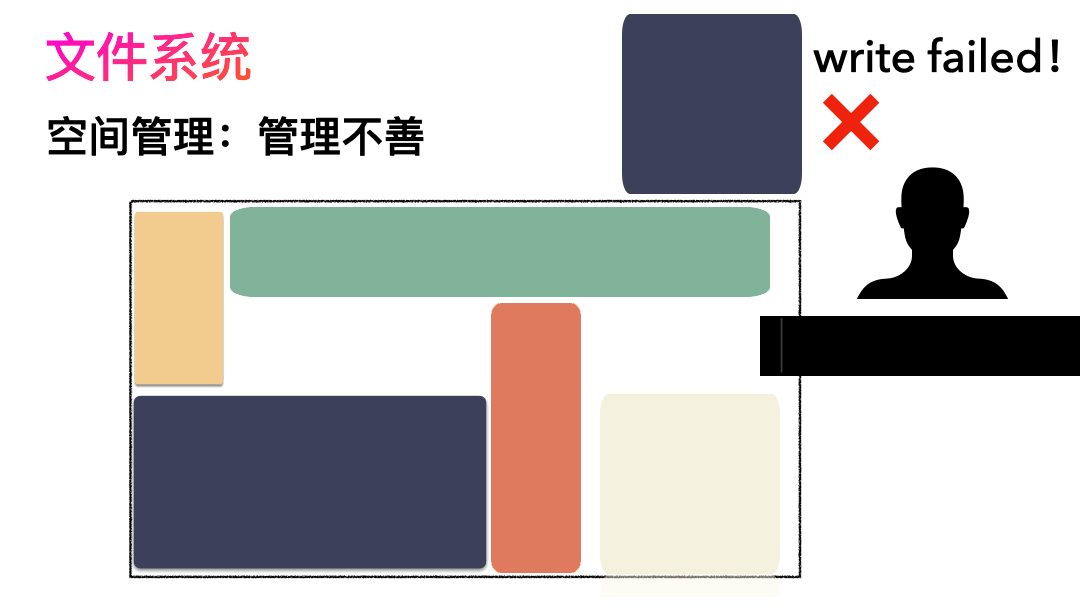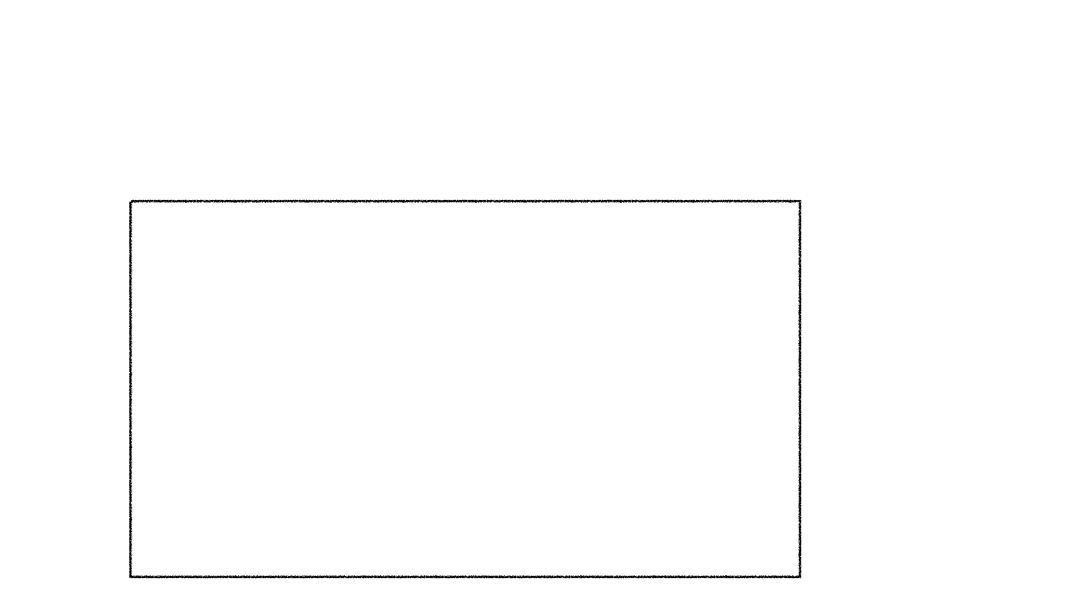
直观的一个想法,我把进来的数据就完整的放进去。
dd63b46861f658afdd0bc1575adb216b.gif

这种方式非常容易实现,属于眼前最简单,以后最麻烦的方式。因为会造成很多空洞,明明还有很多空间位置,但是由于整个太大,形状不合适(数据大小),哪里都放不下。因为你要放一个完整的空间。

怎么改进?有人会想,既然整个放不进去,那就剁碎了呗。这里塞一点,那里塞一点,就塞进去了。

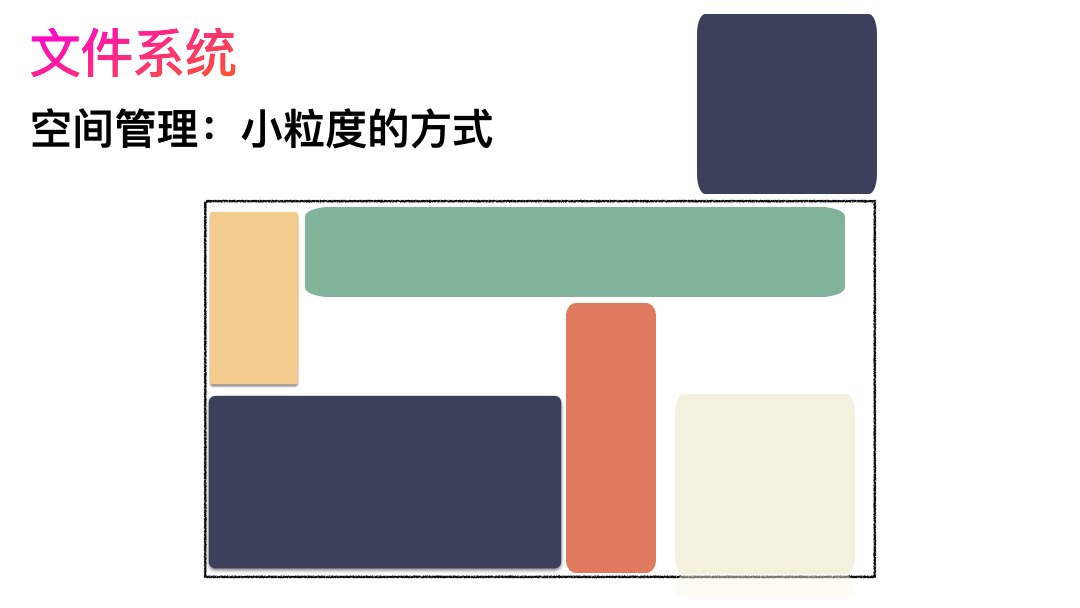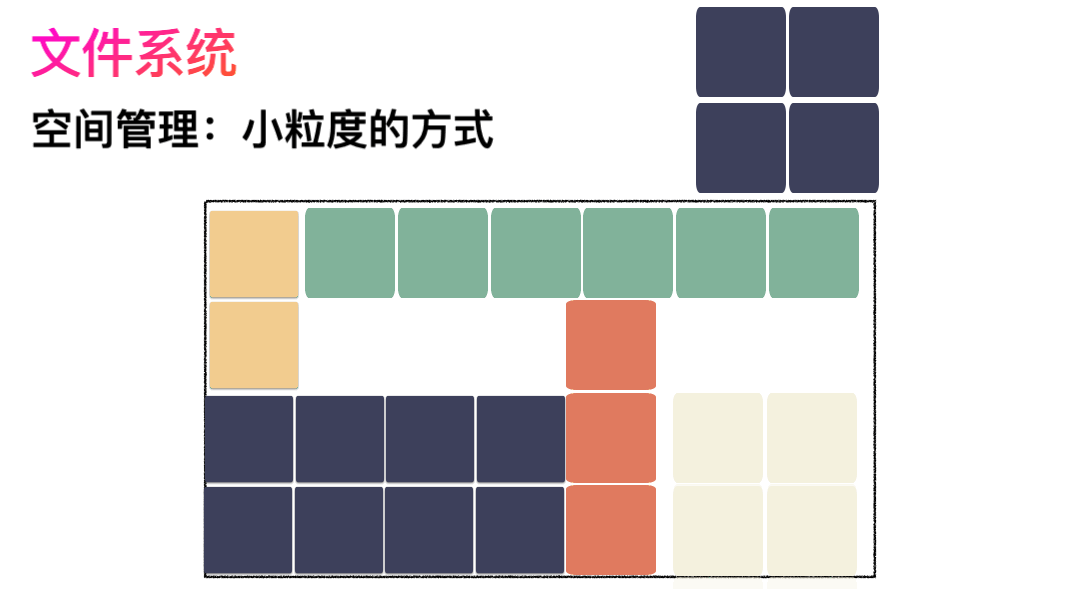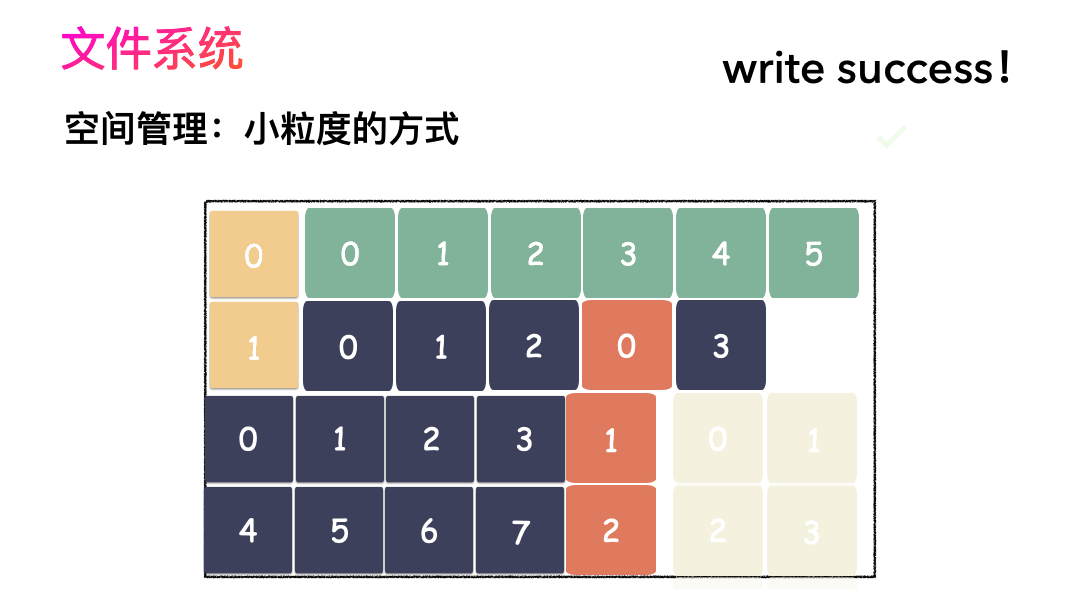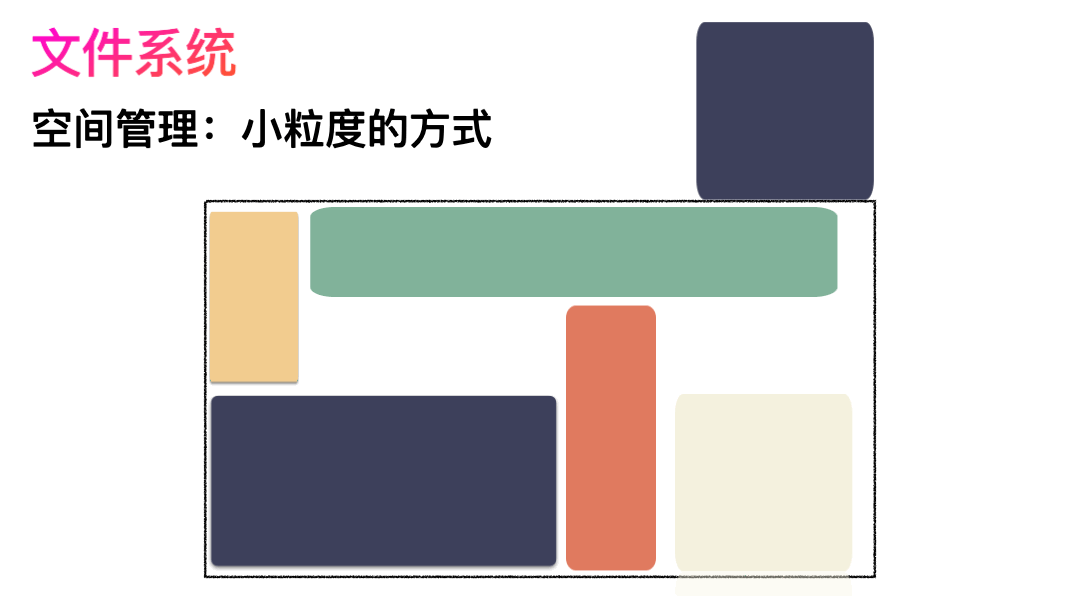
对,思路完全正确。改进的方式就是切分,把空间按照一定粒度切分。每个小粒度的物理块命名为 Block,每个 Block 一般是 4K 大小,用户数据存到文件系统里来自然也是要切分,存储到磁盘上各个角落。
8567d424ba46247903e3daf1fdda0026.gif

图示标号表示这个完整对象的 Block 的序号,用来复原对象用的。

随之而来又有一个问题:你光会切成块还不行,取文件数据的时候,还得把它们给组合起来才行。

所以,要有一个表记录文件对应所有 Block 的位置,这个表被文件系统称为inode。

写文件的流程是这样的:

  1. 先写数据:数据先按照 Block 粒度存储到磁盘的各个位置;

  2. 再写元数据:然后把 Block 所在的各个位置保存起来,即inode(我用一本书来表示);

dd1d9c3a4518ef086d69805c36bcdb58.gif

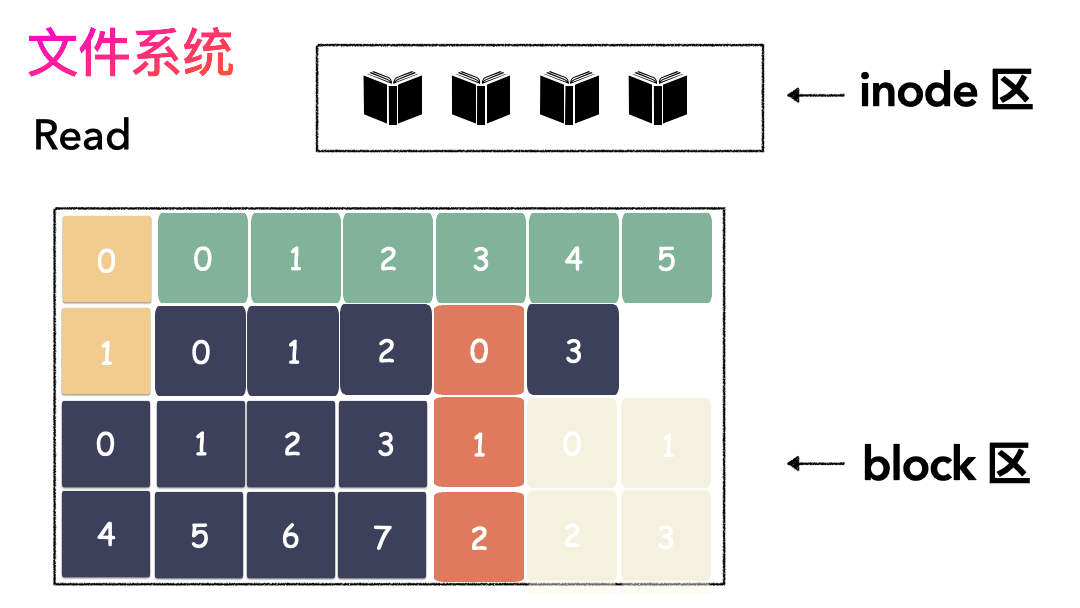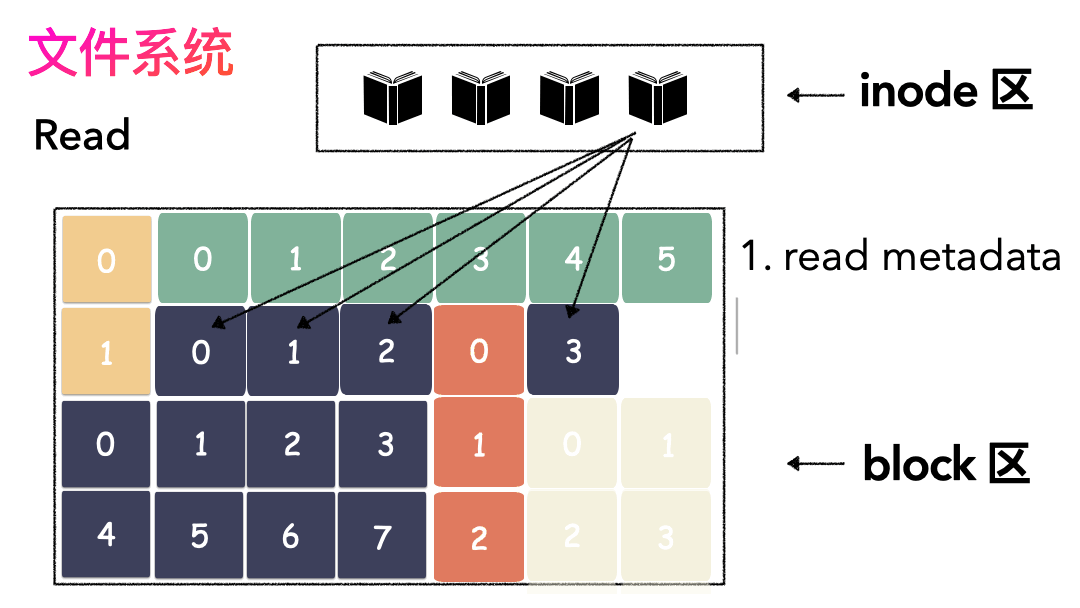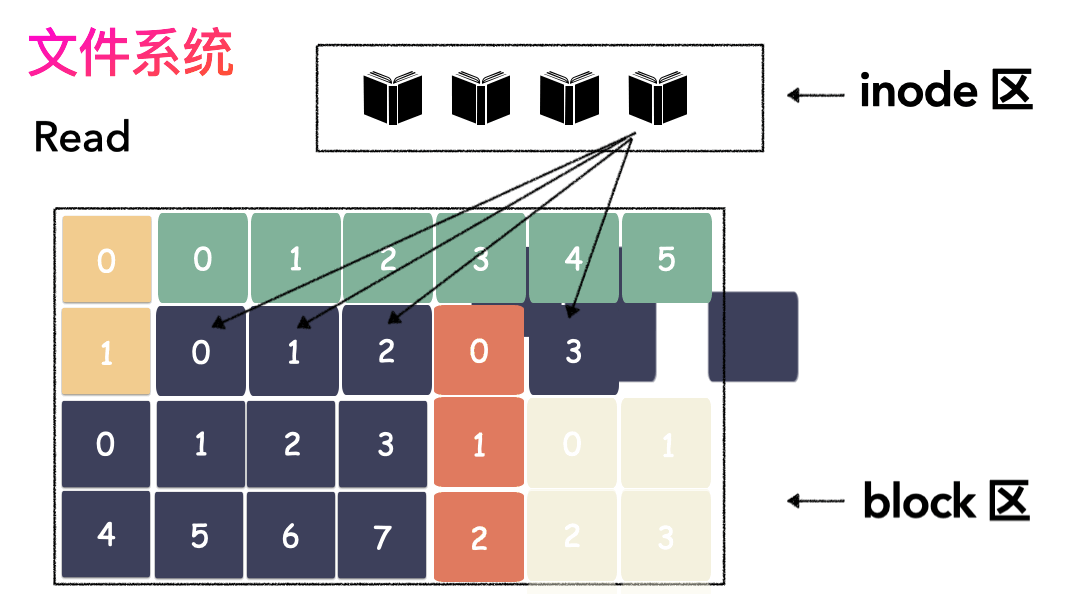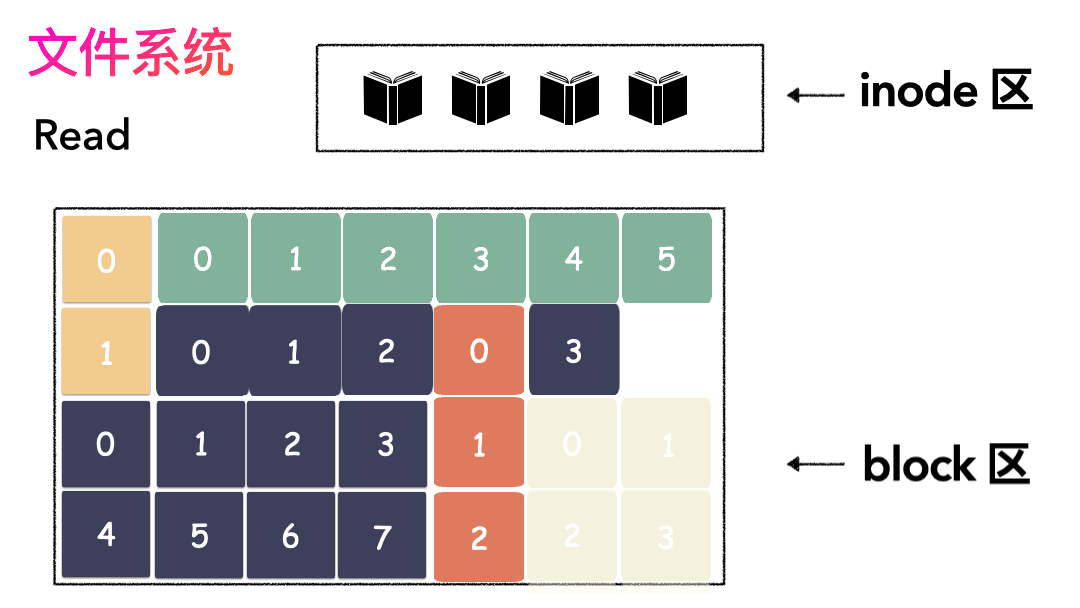
读文件流程则是:

  1. 先读inode,找到各个 Block 的位置;

  2. 然后读数据,构造一个完整的文件,给到用户;

ecc7fc04d847361a0a5f5518208a3a53.gif
inode/block 概念

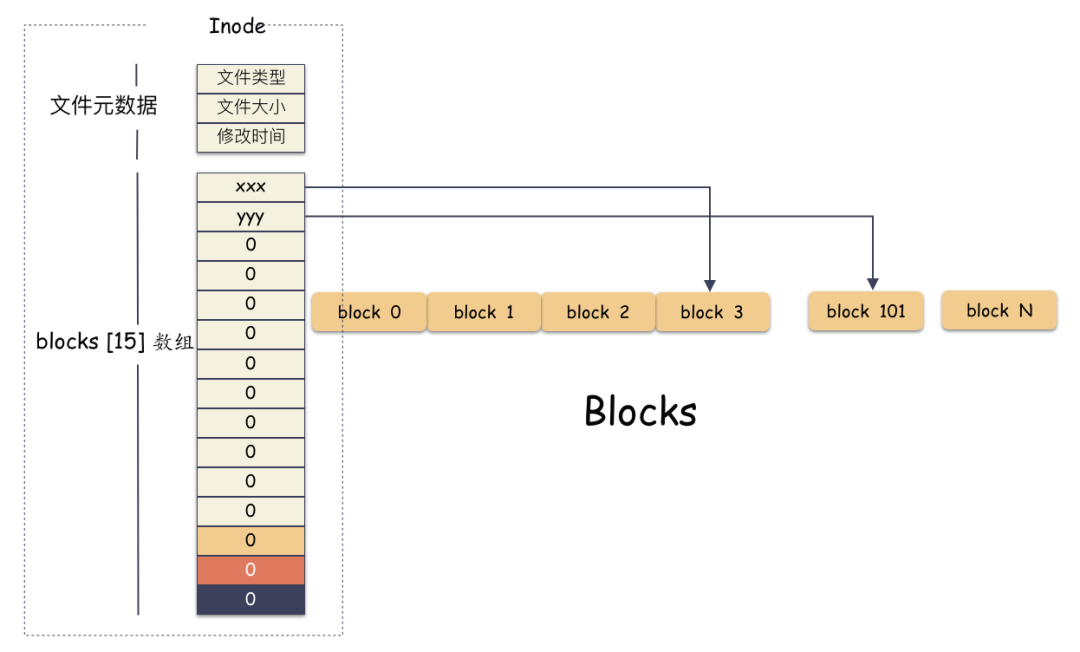
好,我们现在来看看inode,直观地感受一下:
26119c6b0f9a852e768e255cfb27c5e9.png

这个inode有文件元数据和Block数组(长度是15),数组中前两项指向Block 3和Block 11,表示数据在这两个块中存着。

你肯定会意识到:Block数组只有15个元素,每个Block是4K, 难道一个文件最大只能是 15 * 4K =  60 K ?

这是绝对不行的!

最简单的办法就是:把这个Block数组长度给扩大!

比如我们想让文件系统最大支持100G的文件,Block数组需要这么长:

(100*1024*1024)/4 = 26214400

Block数组中每一项是4个字节,那就需要(26214400*4)/1024/1024 = 100M

为了支持100G的文件,我们的Block数组本身就得100M !

并且对每个文件都是如此 !即使这个文件只有1K!这将是巨大浪费!

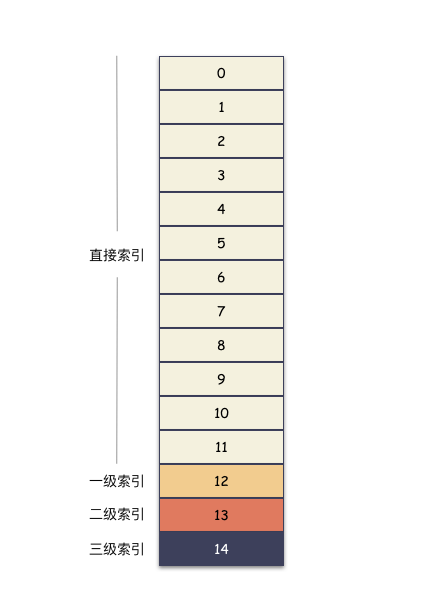
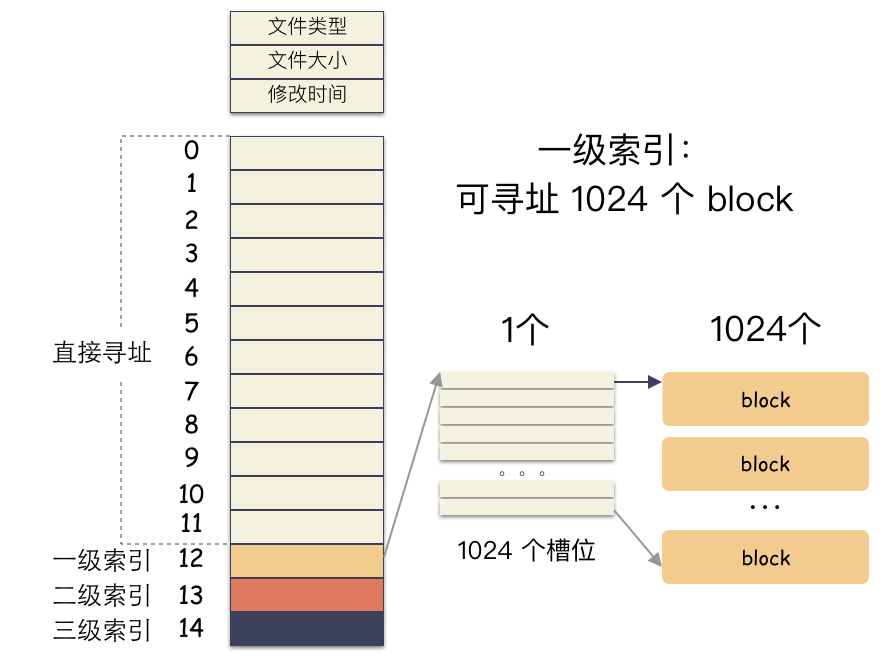
肯定不能这么干,解决方案就是间接索引,按照约定,把这 15 个槽位分作 4 个不同类别来用:

  1. 前 12 个槽位(也就是 0 - 11 )我们成为直接索引;

  2. 第 13 个位置,我们称为 1 级索引;

  3. 第 14 个位置,我们称为 2 级索引;

  4. 第 15 个位置,我们称为 3 级索引;

39f2fb8aeead92e74f9ab878d4fdb394.png

直接索引:能存 12 个 block 编号,每个 block 4K,就是 48K,也就是说,48K 以内的文件,前 12 个槽位存储编号就能完全 hold 住。

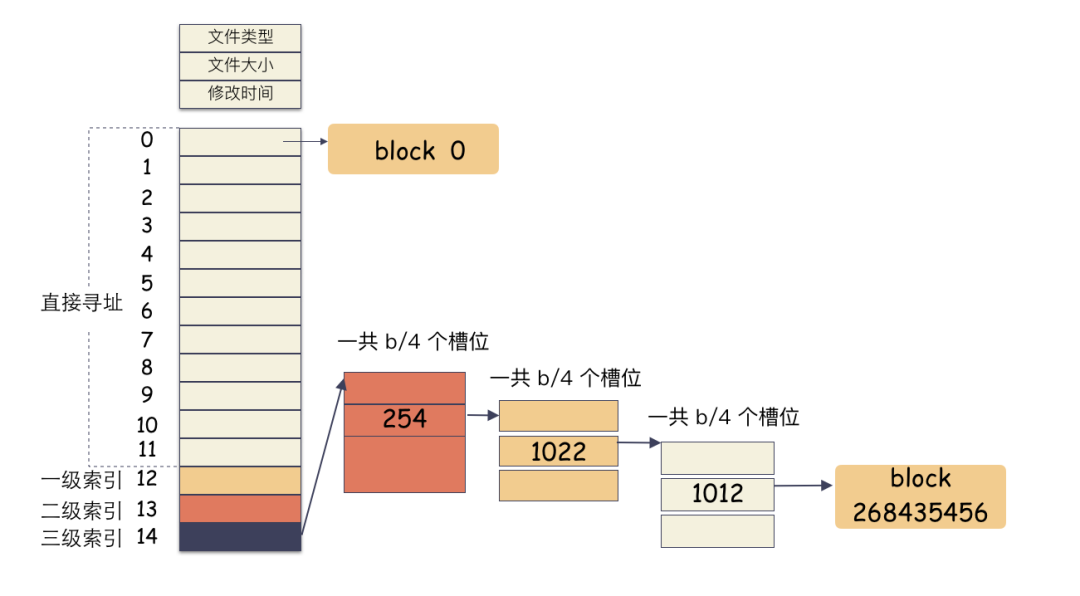
一级索引:

也就是说这里存储的编号指向的 block 里面存储的也是 block 编号,里面的编号指向用户数据。一个 block  4K,每个元素 4 字节,也就是有 1024 个编号位置可以存储。所以,一级索引能寻址 4M(1024 * 4K)空间 。
ce97378fdcd2ff4c106533f3e61f2526.png

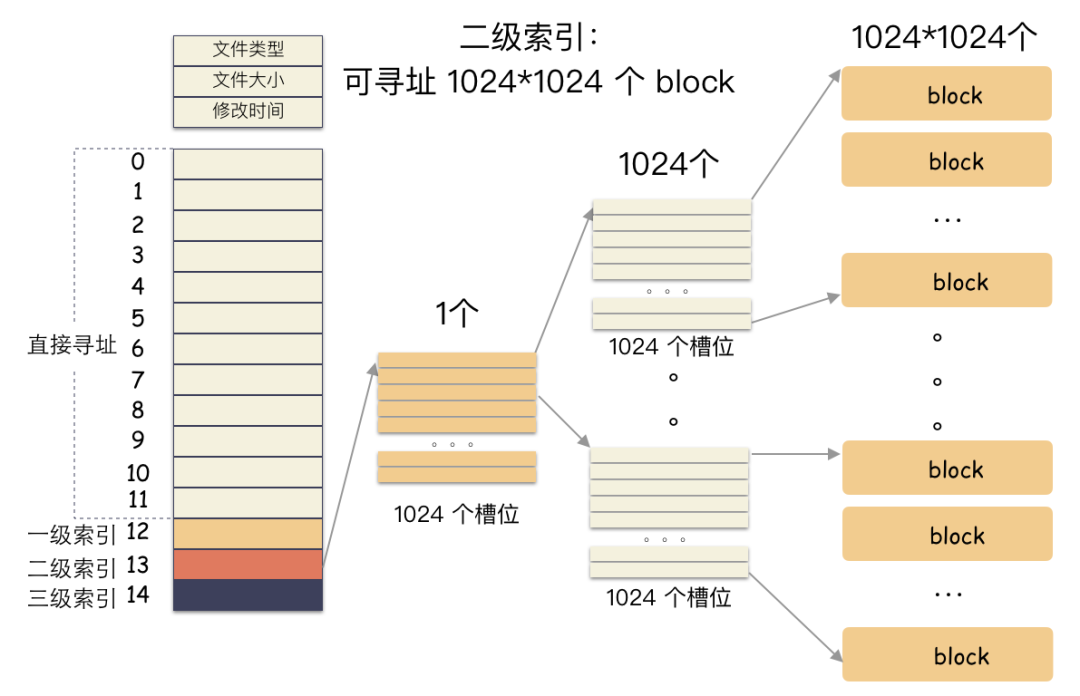
二级索引:

二级索引是在一级索引的基础上多了一级而已,换算下来,有了 4M 的空间用来存储用户数据的编号。所以二级索引能寻址 4G (4M/4 * 4K) 的空间。
ec73fc87215f824872b9064080ae6928.png

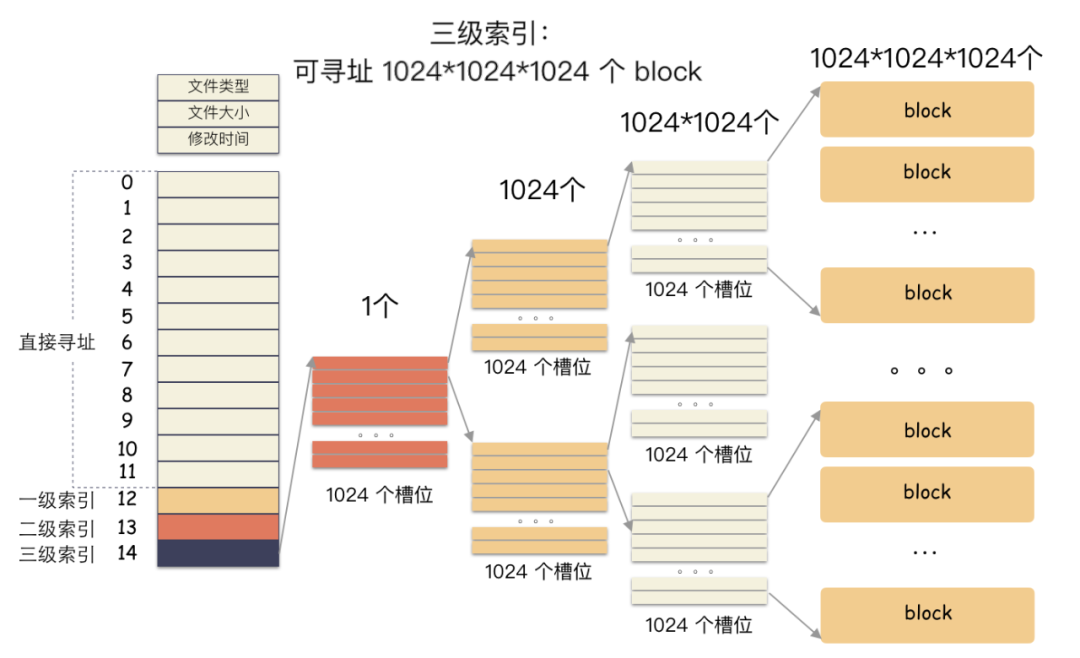
三级索引:

三级索引是在二级索引的基础上又多了一级,也就是说,有了 4G 的空间来存储用户数据的 block 编号。所以二级索引能寻址 4T (4G/4 * 4K) 的空间。
a6d4e4d3ec36ff853aa3e78219e22c67.png

所以,在这种文件系统(如ext2)上,通过这种间接块索引的方式,最大能支撑的文件大小 = 48K + 4M + 4G + 4T ,约等于 4 T。

这种多级索引寻址性能表现怎么样?

在不超过 12 个数据块的小文件的寻址是最快的,访问文件中的任意数据理论只需要两次读盘,一次读 inode,一次读数据块。访问大文件中的数据则需要最多五次读盘操作:inode、一级间接寻址块、二级间接寻址块、三级间接寻址块、数据块。

为什么cp那么快?

接下来我们要写入一个奇怪的文件,这个文件很大,但是真正的数据只有8K:

在[0,4K]这位置有4K的数据

在[1T , 1T+4K] 处也有4K数据

中间没有数据,这样的文件该如何写入硬盘?

  1. 创建一个文件,这个时候分配一个 inode;

  2. 在 [ 0,4K ] 的位置写入 4K 数据,这个时候只需要 一个 block,把这个编号写到 block[0] 这个位置保存起来;

  3. 在 [ 1T,1T+4K ] 的位置写入 4K 数据,这个时候需要分配一个 block,因为这个位置已经落到三级索引才能表现的空间了,所以需要还需要分配出 3 个索引块;

  4. 写入完成,close 文件;

实际存储如图:

628f97ddb342db5c463483d70fee30cd.png

这个时候,我们的文件看起来是超大文件,size 等于 1T+4K ,但里面实际的数据只有 8 K,位置分别是  [ 0,4K ] ,[ 1T,1T+4K ]。

由于没写数据的地方不用分配物理block块,所以实际占用的物理空间只有8K。

重点:文件 size 只是 inode 里面的一个属性,实际物理空间占用则是要看用户数据放了多少个 block ,没写数据的地方不用分配物理block块。

这样的文件其实就是稀疏文件, 它的逻辑大小和实际物理空间是不相等的。

所以当我们用cp命令去复制一个这样的文件时,那肯定迅速就完成了。

总结

好,我们再深入思考下,文件系统为什么能做到这一点?

  1. 首先,最关键的是把磁盘空间切成离散的、定长的 block 来管理;

  2. 然后,通过 inode 能查找到所有离散的数据(保存了所有的索引);

  3. 最后,实现索引块和数据块空间的后分配;

这三点是层层递进的。

03c31f3d44f75e28903a83b9b502757f.png

GPT-4o推理加速原理:MoE架构与多模态token统一设计 大语言模型推理优化正从单纯扩大参数转向提升计算效率,核心在于模型架构与系统协同的深度重构。MoE(混合专家)通过动态路由与稀疏激活,在降低实际计算量的同时维持高任务精度;而多模态统一token空间则打破语音、文本、图像间的模态壁垒,实现跨模态语义对齐与注意力剪枝。这类技术显著压缩端到端延迟、降低显存占用,并支撑实时交互场景下的低感知延迟体验。结合KV缓存分层管理、Paged Attention 2.0内存优化及硬件级FlashAttention-3加速,GPT-4o展现出‘小参数、高响应、强泛化’的工程范式 阅读详情

相关推荐

OpenClaw一键部署实战指南:阿里云ECS与本地Windows/macOS全平台适配

智能体工作流编排是当前AI工程落地的核心范式,其本质是将多步AI任务(如文档解析、结构化提取、报告生成)通过可视化节点与可复用技能模块进行低代码组装。OpenClaw作为轻量级运行时平台,无需Kubernetes或复杂容器编排,即可在单机环境实现稳定服务调度。它依托Docker Engine与动态渲染的docker-compose配置,支持环境自检、端口冲突规避、云服务(如阿里云OSS/RDS)无缝对接等关键能力,显著降低AI Workflow从开发到生产的运维门槛。本文聚焦OpenClaw v0.8.3在

weixin_34194359的博客 313

0.2秒居然复制了100G文件? 我给同事讲了一个小时,他感动得快哭了...

cp 引发的思考今天同事用 cp 命令,把他给惊到了!背景是这样的:他用 cp 拷贝了一个 100 G的文件,竟然一秒不到就拷贝完成了!用ls看一把文件,显示文件确实是 100 G...

码农翻身 1009

智能体集群与视觉理解:AI工作流的工程化落地实践

智能体(Agent)作为AI系统从‘模型调用’迈向‘自主协作’的关键范式,其核心价值在于可编排、可审计、可扩展的任务协同能力。而视觉智能体并非OCR增强版,而是融合像素感知、文档推理与任务意图生成的多粒度理解引擎。二者深度耦合构成的智能体集群,解决了企业级AI落地中长期存在的能力边界模糊、状态不可追溯、错误不可定位等工程痛点。在报销审核、设备巡检、合同审查等典型场景中,该架构显著提升端到端准确率与可解释性,支撑金融、制造、政务等领域对合规性、稳定性与可维护性的严苛要求。本文聚焦Kimi K2.5的集群调度机

weixin_34195546的博客 440

拷贝cp大文件报错“文件太大”

问题:今天在centos7系统下,u盘位vfat格式16个G,拷贝7个G大小的问文件,无论是用dd还是cp都在拷贝到4.3G大小的时候显示失败。 故写下这篇博客。 无论什么系统,只要分区格式确定,分区大小和文件大小就已经确定。大写为windows下的格式,小写为linux下的格式: FAT32(linux下vfat):支持最大分区128G,支持最大文件4GB。 FAT16:支持最大分区2G...

zhangna的博客 6282

网络文件下载和网络测速

里面提供的下载链接并不合适,请自行寻找大于1M的网上资源用于下载测试。

Jenkins离线安装保姆级教程:从下载.war包到SVN+Maven项目一键部署(附避坑脚本)

本文详细介绍了Jenkins离线安装的全流程,包括.war包下载、SVN+Maven项目配置及自动化部署。特别针对内网环境提供解决方案,涵盖插件管理、开发工具链配置、构建触发器和SSH部署等关键步骤,帮助企业在网络隔离环境下实现高效持续集成。

weixin_30096975的博客 374

两个高效的cp 命令用法!

导读 在 Linux 上能使用鼠标点来点去的图形化界面是一件很美妙的事……但是如果你喜欢的开发交互环境和编译器是终端窗口、Bash 和 Vim,那你应该像我一样经常和终端打交道。 即使是不经常使用终端的人,如果对终端环境深入了解也能获益良多。举个例子—— cp 命令,据 维基百科 的解释,cp (意即 copy)命令是第一个版本的 Unix 系统的一部分。连同一组其它的命令 l

Listen2You的博客 1115

Avalonia v11实战:手把手教你从零创建第一个跨平台桌面App(含设计器不显示的解决方案)

本文详细介绍了如何使用Avalonia v11从零开始创建跨平台桌面应用,包括环境准备、项目创建、界面设计及常见问题解决方案。特别针对设计器不显示等常见问题提供了实用解决方法,帮助.NET开发者快速掌握这一强大的UI框架,实现Windows、macOS和Linux多平台应用开发。

weixin_30417487的博客 164

linux复制(cp,scp)

linux为我们提供了两个用于文件的copy的命令,一个是cp,一个是scp.但是它们略有不同:  rsync 高速复制 cp主要用于在同一台电脑上,在不同的目录之间来回copy文件, scp主要是在不同的linux系统之间来回的copy文件    1.scp从本地复制到远程:  scp 被拷贝的文件名 root@目标IP:/目录/  scp linux_fuzai.zip root@10.58

599

操作系统原理:【优麒麟】linux内核添加系统调用

在底端添加如下代码。

Joyce_zz的博客 2709

深入理解DQN中的Q值:核心概念和应用

在强化学习中,Q值(或称为动作价值函数)是核心概念之一。Q值函数 ( Q(s, a) ) 表示在给定状态 ( s ) 下,采取动作 ( a ) 并遵循某策略后,智能体从当前状态到未来状态所能获得的预期总回报。简言之,Q值是评估特定状态和动作对的好坏的指标。

qlkaicx的博客 2975

电脑之间快速传输超大文件(100GB以上)的方法

引言 假如有这样一个场景,你买了一台新的电脑。但是老电脑上存放着多年累积的数据。几百G之多。你要花时间把旧电脑上的数据导到新电脑上去,这很费精力。于是你想有没有更快速的方法立马挪过去呢?本文提供了五种方法,哪种最快您用哪种? 根据经验,使用任何使用物理连接的方法(如交换硬盘或通过局域网传输),都比使用快速简单的解决方案(如通过Wi-Fi或USB驱动器传输)更快。 直接先上视频 【教程】如何快速的在两台电脑间传输大文件?

gznc_pcc的博客 7万+

【脚本篇】---spyglass lint脚本

【代码】【脚本篇】---spyglass lint脚本。

冬瓜 6355

一个100G文件0.2秒复制完?背后到底是谁的功劳

cp 引发的思考 今天同事用 cp 命令,把他给惊到了!背景是这样的:他用 cp 拷贝了一个 100 G的文件,竟然一秒不到就拷贝完成了!用 ls 看一把文件,显示文件确实是 100 ...

AI研习社 212

AutoSAR系列讲解 - 总目录

博主想在开始前先讲一下我们的具体安排,这里就以目录加说明的形式展示出来,同时这也可以作为大家学习AutoSAR的参考。由于实践篇需要在很久以后才会更新,所以这里我们先罗列一下理论篇的内容,实践篇等开始更新的时候我再补充上

雪云飞星的博客 49万+

Open3D 使用CPD算法对点云配准【2025最新版】

Coherent Point Drift相干点漂移算法实现点云配准(python代码)博客长期更新,本文最近更新时间为:2025年2月2日。

点云侠的博客 8万+

GPT-4稀疏激活真相:参数规模与动态路由的工程本质

大模型稀疏激活是当前AI工程落地的核心技术趋势,其本质并非简单关闭参数,而是通过MoE(混合专家)架构实现计算资源的语义化动态调度。理解稀疏激活需回归第一性原理:参数量是训练FLOPs反推的工程估算值,而‘2%激活率’实为Top-k路由下的加权访存占比,受硬件带宽、缓存策略与编译器优化深度耦合。该机制显著提升长尾任务推理效率与显存利用率,尤其适用于高频短Query、多领域垂直服务等场景;但在长上下文生成中可能因KV cache开销抵消优势。本文聚焦GPT-4级MoE系统的实际部署逻辑,揭示参数组织方式正取代

weixin_33804582的博客 332

第14.8章 高翔博士最新开源框架Lightning-LM源码解读(八):位姿平滑器PoseSmoother深度剖析,从原理到代码实现

本文深度解析了高翔博士开源框架Lightning-LM中的位姿平滑器PoseSmoother模块。该模块通过设置平滑因子,在保证位姿准确性的同时减少突变,使位姿变化更平稳。文章详细讲解了模块功能、数据流程和核心代码实现,包括构造函数、拷贝构造函数以及关键的PushDRPose和PushPose函数。重点分析了位姿平滑算法原理,涉及运动有效性校验、位姿队列维护和平滑因子调节等核心机制。此外还介绍了相关C++语法(如显式构造函数、默认拷贝构造)和优化方向。本解析为SLAM学习者提供了位姿平滑处理的实用实现范例。

行知SLAM 600

Cleer Arc5耳机扬声器纸盆耐候性实验

本文深入解析Cleer Arc5开放式耳机扬声器纸盆的耐候性实验,涵盖高温高湿、冷热循环、汗液腐蚀与紫外线老化四项极限测试,揭示其在复杂环境下的材料稳定性与长期可靠性,展现高端音频设备背后的系统工程实力。

weixin_35516624的博客 620

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

BEYOND REALITY Z-Image实战案例:为婚庆公司定制‘中式嫁衣+写实面容’生成模板

本文介绍了如何在星图GPU平台上自动化部署🌌 BEYOND REALITY Z-Image镜像,专为婚庆行业定制‘中式嫁衣+写实面容’AI人像生成方案。用户无需算法基础,即可快速产出高精度、可商用的婚纱宣传图、电子请柬封面及社交媒体配图,显著提升内容交付效率与真实感。

weixin_42453228的博客 115

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

GPT-4的2%参数激活:MoE稀疏推理的工程真相

混合专家(MoE)是大语言模型实现高效扩展的核心架构,其本质在于通过动态路由实现参数稀疏激活——并非所有参数同时参与计算。原理上,Router模块为每个token选择top-k专家,形成高度偏态的激活分布,均值约2%仅为统计表象,实际负载呈现长尾与不可预测性。该机制显著降低显存占用与FLOPs消耗,技术价值体现在推理成本压缩、硬件资源弹性调度与服务稳定性提升。典型应用场景包括高并发API部署、长上下文推理及边缘端轻量化适配。本文聚焦GPT-4级MoE模型在真实生产环境中的参数存储、路由行为、显存管理与微服务

weixin_30892889的博客 283

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

MySQL数据库备份和恢复方案小结

这两天在调研MySQL数据库的备份和恢复方案,备份对象是对大量Innodb表,或者加上少量的MyISAM表。   InnoDB备份常见问题: 文件一致性:数据文件、缓存、日志文件必须保持严格一致。加锁的方法没法保证一致性,因为InnoDB后台刷新数据是异步进行的。 数据一致性:不能一次锁住一张表,这个备份的是不同时刻的表数据;如果一次锁住所有表,innodb的mvcc机制会增加undo日志...

spb3732的博客 3850

tomcat7修改内存 win_老电脑也用上了32GB雷赤纯国产内存条,稳定耐用还实惠

我在公司里用的那台电脑是品牌机,配置有点低,处理器是i3-6100,内存是4GB,硬盘是1TB的机械,这个配置日常办公是没有问题的,但是现在有一些活已经超出了这个配置的能力,加之近期的一些工作还需要在苹果环境下才能使用,让公司买一台苹果电脑不现实,毕竟用的太少,就准备把这台电脑装上黑苹果+Win10双系统,结果捣鼓半天,不引导,最后没招了,只能装虚拟机。虚拟机很顺利,但装完之后一开机傻眼了,总共就...

weixin_35334000的博客 146

Qwen3.5效率革命:MoE+DeltaNet如何实现小参数大智能

大语言模型的智能水平并不简单等同于参数规模,其本质是计算效率、架构设计与任务适配的系统性协同。混合专家(MoE)通过稀疏激活实现资源精准调度,门控增量网络(Gated DeltaNet)则在保持长程建模能力的同时将注意力复杂度从O(n²)降至O(n),显著降低显存与延迟。这种‘更聪明的智能,更少的算力’范式,正推动AI从数据中心走向消费级GPU乃至端侧CPU。在RAG、Agent调度、本地知识库、移动端AI等对低延迟、高性价比有强需求的工程场景中,Qwen3.5系列凭借FP8量化、256K上下文支持与Den

aaa1231722的博客 468

工作汇报PPT模板

文件大小: 4.6GB内容特色: 100+年终述职一键替换,配色高级适用人群: 年底被okr逼疯的打工人核心价值: 把熬夜排版的时间拿去刷剧下载链接文件大小: 21.4GB内容特色: 21G极简高级感模板,全场景覆盖适用人群: 追求颜值的学生党与社畜核心价值: 一键换图,质感飞升不花钱下载链接文件大小: 2.0GB内容特色: 2026年会+总结全套方案,直接打印适用人群: 行政hr和年底抓狂的管理层核心价值: 半天搞定年会流程和述职下载链接。

白日梦技术博客 372

Qwen3系列架构演进:MoE与GQA如何重塑大模型部署实践

大语言模型的稀疏化架构(如MoE混合专家)和注意力优化技术(如GQA分组查询)正成为提升推理效率与多模态能力的关键路径。MoE通过稀疏激活降低显存占用与计算开销,使超大规模参数模型(如1T+)可在单卡高效运行;GQA则显著压缩KV缓存,尤其在长上下文与视觉语言任务中释放内存瓶颈。二者协同不仅支撑了Qwen3系列在文本深度推理、多模态理解及智能体执行等场景的能力跃迁,更深刻影响着本地部署选型、推理服务设计与微调策略。面向实际工程落地,理解MoE路由机制、GQA内存收益及分支定位逻辑,是平衡性能、成本与业务需求

weixin_30500473的博客 449
上一篇: 公司年会要求搞一个抽奖程序,及时安排一波
下一篇: 2022年大厂中秋礼盒大赏,卷的就是创意!
编程IT圈
博客等级 码龄6年 1130粉丝 544原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值