AI基石 | 机器学习基础(二):不以成败论英雄 —— 准确率、F1 分数与 ROC/AUC,谁才是真正的评判标准?

人工智能/机器学习基础知识——性能度量(Precision、Recall、F1、ROC、AUC) 阅读详情

AI基石 | 机器学习基础(二):不以成败论英雄 —— 准确率、F1 分数与 ROC/AUC,谁才是真正的评判标准?

前言

在上一篇,我们学会了用逻辑回归。假设你训练好了一个预测癌症模型,跑了一下测试集,发现准确率(Accuracy)高达 99.9%。

你兴冲冲地拿着结果去找医生:“看,我的 AI 神医,误诊率只有 0.1%!”

医生看了一眼你的模型逻辑,冷冷地说:“你这个模型是个垃圾,它会害死人的。”

为什么?

因为在 1000 个人里,可能只有 1 个人真正得了癌症。你的模型只要闭着眼睛全部预测‘没病’,准确率就能达到 99.9%。

但是,那个唯一的病人被你漏掉了,因为延误治疗而死亡。

这就是 AI 领域最著名的 “准确率陷阱”。今天,我们要学会一套 “不以(单一)成败论英雄” 的评判体系,彻底看懂混淆矩阵、F1 分数和 ROC/AUC。


一、 万恶之源:混淆矩阵 (Confusion Matrix)

所有的指标,都源自这个简单的 2×22 \times 22×2 表格。不理解它,就别谈评估。

假设我们在进行 新冠病毒检测(正样本=阳性=有病):

AI 预测:阳性 (Positive)AI 预测:阴性 (Negative)
真实:阳性 (True)TP (真阳性) 恭喜,抓住了病人!FN (假阴性) 💀 漏诊! 病人跑了,最危险的情况。
真实:阴性 (False)FP (假阳性) ⚠️ 误诊! 吓唬健康人,但这只是虚惊一场。TN (真阴性) 没事,大家都健康。
  • 记忆口诀:
    • 第一个字母(T/F):AI 猜对了(True)还是猜错了(False)?
    • 第二个字母(P/N):AI 猜的是阳性(Positive)还是阴性(Negative)?

核心结论:不同的业务场景,对 FP 和 FN 的容忍度是完全不同的。

  • 癌症筛查:FN (漏诊) 是不可接受的,宁可错杀一千 (FP),不可放过一个。
  • 垃圾邮件:FP (误杀) 是不可接受的,你不想老板的重要邮件被扔进垃圾箱。

二、 精确率与召回率:鱼与熊掌的博弈

因为准确率((TP+TN)/总数(TP+TN)/总数(TP+TN)/总数)在样本不平衡时会失效,我们引入两个更专一的指标。

1. 精确率 (Precision) —— “神枪手”

Precision=TPTP+FP Precision = \frac{TP}{TP + FP} Precision=TP+FPTP​

  • 含义:在你开枪打中的人里,有多少个是坏人?
  • 心态:宁缺毋滥。我不敢轻易开枪,但只要我开枪,就必须保证打中坏人。
  • 适用:垃圾邮件过滤、视频推荐(推错用户会烦)。

2. 召回率 (Recall) —— “大撒网”

Recall=TPTP+FN Recall = \frac{TP}{TP + FN} Recall=TP+FNTP​

  • 含义:在所有的坏人里,你到底抓住了几个?
  • 心态:宁错杀不放过。不管是好人坏人我先抓起来再说,绝对不能让坏人跑了。
  • 适用:地震预测、传染病筛查、金融反欺诈。

3. F1 分数 (F1 Score) —— “端水大师”

很多时候,老板既要马儿跑(高召回),又要马儿不吃草(高精确)。这时候看 F1。

F1=2×Precision×RecallPrecision+Recall F1 = 2 \times \frac{Precision \times Recall}{Precision + Recall} F1=2×Precision+RecallPrecision×Recall​

  • 它是精确率和召回率的调和平均数。
  • 为什么不是算术平均?
    • 假设 Precision=100%, Recall=0%(一个坏人都没抓到)。
    • 算术平均 = 50%(看起来还行?错!)。
    • 调和平均 (F1) = 0(直接判定模型失效)。
  • 结论:F1 能惩罚严重的偏科。

三、 ROC 与 AUC:不看脸色的硬核指标

上面讲的指标,都有一个共同的缺陷:它们都依赖于一个固定的阈值(Threshold)。

逻辑回归输出的是概率(比如 0.6)。通常我们以 0.5 为界,大于 0.5 算阳性。

但如果我们把门槛提高到 0.9(严防误报),或者降低到 0.1(严防漏报),Precision 和 Recall 就会剧烈波动。

有没有一个指标,不管你门槛怎么变,都能衡量模型够不够硬?

有,这就是 AUC (Area Under Curve)。

1. ROC 曲线怎么画?

我们让阈值从 0 滑动到 1,记录每一刻的:

  • 横轴:假阳性率 (FPR) —— 好人被误抓的比例(代价)。
  • 纵轴:真阳性率 (TPR/Recall) —— 坏人被抓住的比例(收益)。

ROC曲线解释图

2. AUC (曲线下面积) 的物理意义

AUC = 0.8 表示什么?

它的含义极其直观:

随机挑一个正样本(病人)和一个负样本(健康人)。

你的模型给“病人”打的分数 高于 给“健康人”打分的概率,是 80%。

  • AUC = 0.5:瞎猜(抛硬币)。
  • AUC = 1.0:神级模型,完美区分。
  • AUC < 0.5:反向毒奶(你猜它是阴性,那它大概率是阳性)。

四、 实战:用代码戳穿“高准确率”的谎言

我们来构造一个极度不平衡的数据集(98个好人,2个坏人),看看 Accuracy 是怎么骗人的。

import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.dummy import DummyClassifier
from sklearn.metrics import (accuracy_score, f1_score, roc_auc_score,
                             confusion_matrix, ConfusionMatrixDisplay,
                             RocCurveDisplay)

# --- 1. 制造极度不平衡数据 ---
# 权重 0.98(负类/健康) : 0.02(正类/生病)
X, y = make_classification(n_samples=1000, n_features=20,
                           weights=[0.98, 0.02], random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# --- 2. 训练模型 ---
# A. 傻子模型:永远预测“0”(多数类)
# 策略:不管输入什么,永远预测“0” (没病/正常)
dummy = DummyClassifier(strategy="most_frequent")
dummy.fit(X_train, y_train)
y_pred_dummy = dummy.predict(X_test)

# B. 正经模型:逻辑回归
# class_weight='balanced' 是一个关键参数!告诉模型要重视少数类
model = LogisticRegression(class_weight='balanced', random_state=42)
model.fit(X_train, y_train)
y_pred_model = model.predict(X_test)
y_prob_model = model.predict_proba(X_test)[:, 1]

# 3. 对比时刻
print("--- 傻子模型表现 ---")
print(f"准确率: {accuracy_score(y_test, y_pred_dummy):.4f} (看起来很高!)")
print(f"F1 分数: {f1_score(y_test, y_pred_dummy):.4f} (露馅了)")
# 混淆矩阵会显示:TP=0,全是 FN

# --- 傻子模型表现 ---
# 准确率: 0.9750 (看起来很高!)
# F1 分数: 0.0000 (露馅了)

print("\n--- 正经模型表现 ---")
print(f"准确率: {accuracy_score(y_test, y_pred_model):.4f}")
print(f"F1 分数: {f1_score(y_test, y_pred_model):.4f}")
print(f"AUC 分数: {roc_auc_score(y_test, y_prob_model):.4f}")

# --- 正经模型表现 ---
# 准确率: 0.8600
# F1 分数: 0.1250
# AUC 分数: 0.7805

print("\n--- 正经模型的混淆矩阵 ---")
print(confusion_matrix(y_test, y_pred_model))

# --- 正经模型的混淆矩阵 ---
# [[170  25]
#  [  3   2]]

# --- 4. 可视化对比 ---
# 创建画布,一行两列
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
plt.subplots_adjust(hspace=0.4, wspace=0.3)

# === 第一行:混淆矩阵对比 ===
# 傻子模型的混淆矩阵
cm_dummy = confusion_matrix(y_test, dummy.predict(X_test))
sns.heatmap(cm_dummy, annot=True, fmt='d', cmap='Blues', ax=axes[0, 0])
axes[0, 0].set_title(f"傻子模型 (Acc: {accuracy_score(y_test, dummy.predict(X_test)):.2f})")
axes[0, 0].set_xlabel('预测标签')
axes[0, 0].set_ylabel('真实标签')

# 正经模型的混淆矩阵
cm_model = confusion_matrix(y_test, model.predict(X_test))
sns.heatmap(cm_model, annot=True, fmt='d', cmap='Greens', ax=axes[0, 1])
axes[0, 1].set_title(f"正经模型 (F1: {f1_score(y_test, model.predict(X_test)):.2f})")
axes[0, 1].set_xlabel('预测标签')
axes[0, 1].set_ylabel('真实标签')

# === 第二行:ROC 曲线对比 ===
# 合并到一个图里画
ax_roc = axes[1, 0]
# 傻子模型的 ROC (几乎是一条直线)
RocCurveDisplay.from_estimator(dummy, X_test, y_test, ax=ax_roc, name="傻子模型")
# 正经模型的 ROC (应该明显拱起)
RocCurveDisplay.from_estimator(model, X_test, y_test, ax=ax_roc, name="逻辑回归(均衡权重)")
# 画出对角线(瞎猜基准线)
ax_roc.plot([0, 1], [0, 1], "k--", label="瞎猜基准线 (AUC=0.5)")
ax_roc.set_title("ROC 曲线对比")
ax_roc.legend()
# 右下角留空或画点别的
axes[1, 1].axis('off')
plt.tight_layout()
plt.show()
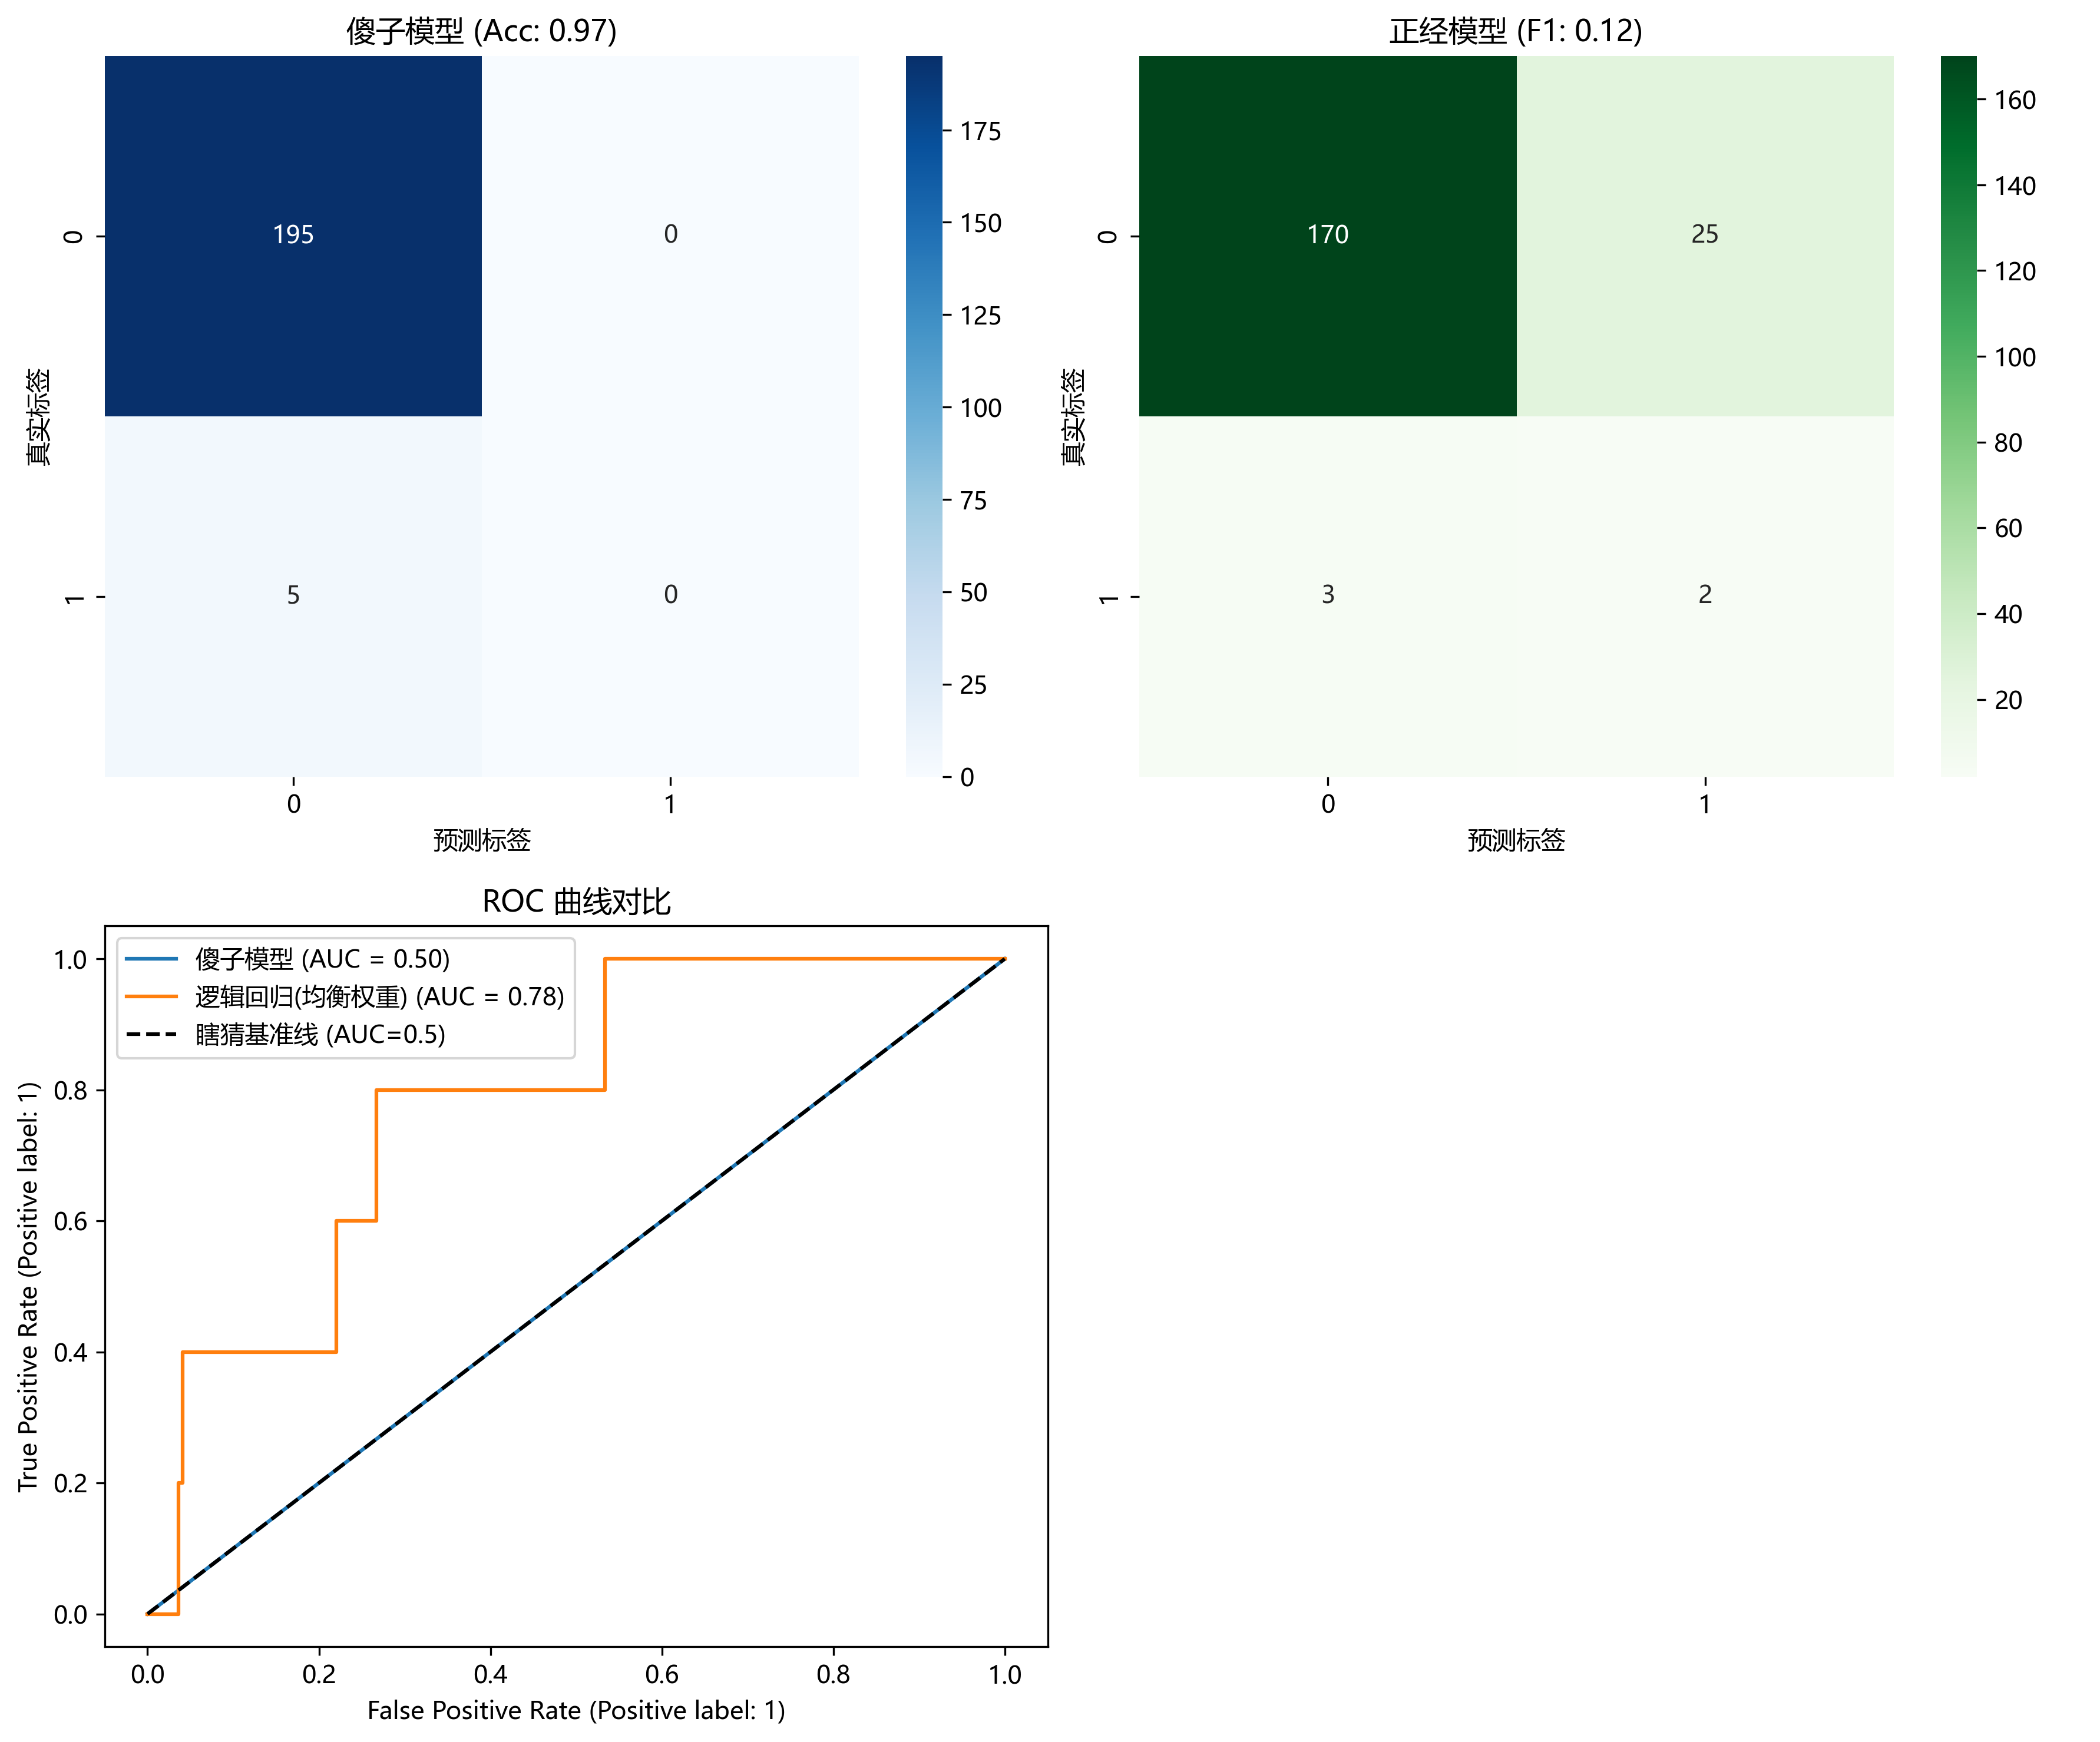
效果图

代码预警

当你运行这段代码,你会发现:

  • 傻子模型的准确率可能高达 98%,但 F1 分数是 0.0。
  • 逻辑回归的准确率可能也是 98%,但 F1 分数可能是 0.5,AUC 是 0.8。
  • 只有 F1 和 AUC 才能告诉你,谁才是真正有用的模型。

五、 总结:指标选择指南 (Cheat Sheet)

最后,送你一张面试/工作通用的选型指南:

  1. 数据极度不平衡(欺诈、癌症):
    • 千万别看 Accuracy。
    • 首选 PR 曲线(Precision-Recall)和 F1。
    • 关注 Recall(甚至为了提高 Recall 牺牲 Precision)。
  2. 正负样本均衡(猫狗分类、手写数字):
    • Accuracy 和 AUC 都可以。
  3. 你需要给出一个确定的 Yes/No:
    • 看 F1 分数。
  4. 你需要给出一个概率/评分(比如信用分):
    • 看 AUC。

结语

学会了这套评判标准,你现在拥有的不仅是编程能力,更是数据科学家的直觉。

下一次,当有人拿着 99% 的准确率向你炫耀时,请淡定地问他一句:

“那么,你的 AUC 是多少呢?”


下一篇预告

好了,经典的“小模型”时代我们彻底通关了。

是时候迎接真正的挑战了。下一篇,我们将直面那个改变世界的巨人。

《大模型基石:Transformer 架构 —— GPT 是如何“读懂”你的?》

机器学习经典算法:分类模型的多重评价指标 分类模型的多重评价指标用于全面衡量模型的分类性能,通过不同角度评估模型的表现。常见的指标包括 准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1值和ROC-AUC。 阅读详情

相关推荐

模型性能评估——Python代码实现

怎样衡量模型泛化能力?(性能度量) 性能度量的作用:评价模型的好坏。但是不同的任务需求需要不同的性能度量,而导致不同的评估结果,因此好坏是相对的。 (一)分类 (二)回归 1.错误率与精度 2.查准率、查全率、F1 3.ROC与AUC 4.代价敏感错误率与代价曲线 https://mp.weixin.qq.com/s/ROXFT9-2k9KLO_32E9ChbA ...

weixin_45366750的博客 3870

混淆矩阵、AUC与ROC曲线及代码实现

一. 混淆矩阵 Confusion Matrix Predict True False Real True True Positive False Positive False False Negative True Negative 准确率 (Accuracy) acc=TP+TNT...

小木的博客 8211

【R语言数据科学】(十五):机器学习常见评估指标

在我们开始介绍如何构建机器学习算法之前,我们首先介绍一下如何对一个模型的效果进行评估。我们将重点描述评估机器学习算法的指标。具体来说,我们需要量化什么样的模型是“更好”的,本篇我们来讨论一下如何评估一个模型的效果。在这里我们需要使用caret包.........

阿里云专家博主、数据科学领域优质创作者、统计er在读 1万+

机器学习--ROC & AUC

ROC和 AUC的一些基本认识

qq_55552561的博客 1274

当AI换脸遇上内容审核:Facefusion NSFW检测的技术伦理与用户自主权之争

本文探讨了Facefusion开源AI换脸工具中NSFW检测机制的技术伦理困境与用户自主权之争。分析了其多层次防御机制的技术实现与社区规避方法,揭示了开源软件在安全与自由之间的平衡难题,并提出了分层权限设计等社区实践方案。

weixin_29165725的博客 686

B站DRM视频解密流程实战解析:从密钥获取到播放全流程

本文详细解析了B站DRM视频的解密全流程,从识别加密视频、捕获关键网络请求(如playurl接口的widevine_pssh数据),到逆向分析DRM SDK的JavaScript执行逻辑,最终手动模拟EME流程获取解密密钥,并使用mp4decrypt和ffmpeg工具完成视频文件的解密与合并。文章为开发者提供了从密钥获取到播放的完整实战指南。

weixin_29290379的博客 839

机器学习中的分类问题:如何选择和理解性能衡量标准

对于这些问题,我们需要一种方式来评估模型的性能,以便选择最合适的模型、调整参数,并最终在实际应用中做出可靠的决策。不同的问题可能需要不同的度量标准。绘制这两种曲线的过程相似,通常需要使用模型的预测概率来确定不同的阈值,并计算相应的性能指标。ROC曲线是另一种用于评估分类模型性能的工具,它关注的是模型的真正例率(True Positive Rate)和假正例率(False Positive Rate)。ROC曲线是一个用于可视化分类器性能的工具,而AUC是ROC曲线下的面积,用于量化分类器的性能。

null18的博客 2358

从Simulink到Amesim:一份FMU联合仿真的避坑指南(含UDP通讯完整配置)

本文详细解析了从Simulink到Amesim的FMU联合仿真全流程,重点介绍了UDP通讯配置中的常见陷阱与解决方案。通过实战案例,帮助工程师规避编译器不兼容、步长设置冲突等典型问题,提升复杂系统仿真的效率与准确性。

weixin_34046298的博客 336

机器学习模型评估指标完全解析:准确率、召回率、F1分数等

机器学习评价指标解析

weixin_51122828的博客 1542

SIGIR 2026:信息检索前沿技术与投稿指南

信息检索(Information Retrieval, IR)是计算机科学中处理大规模数据检索的核心技术,其基本原理是通过算法模型从海量数据中高效提取相关信息。随着深度学习的发展,神经信息检索(Neural IR)和多模态检索成为研究热点,如稠密检索模型(DPR)和跨模态预训练(CLIP)等技术的应用显著提升了检索精度。这些技术不仅在学术领域具有重要价值,还在电商搜索、医疗检索等实际场景中展现出巨大潜力。SIGIR作为信息检索领域的顶级会议,汇聚了全球顶尖学者和工业界专家,是展示最新研究成果的重要平台。本文

weixin_29189363的博客 287

路径规划 | 图解Informed RRT*算法(附ROS C++/Python/Matlab仿真)

Informed RRT*算法针对RRT*算法进行了采样优化,用椭圆采样代替全局均匀采样,避免了RRT*算法搜索树上产生过多冗余分支的缺陷。本文图解Informed RRT*原理,并提供ROS C++/Python/Matlab三种实现加深理解

FRIGIDWINTER的博客 7485

sklearn教程14 - 二分类模型评估-混淆矩阵,精确率,召回率,F1-score,ROC曲线与AUC指标

sklearn教程14 - 二分类模型评估-混淆矩阵,精确率,召回率,F1-score,ROC曲线与AUC指标

山顶极客 2155

YOLOv13涨点改进 | 全网独家创新、高效涨点改进篇 | CVPR 2024 | YOLOv13引入SHSA单头自注意力模块,减少冗余的多头注意力,轻量化改进,助力目标检测和图像分类任务高效涨点

本文提出了一种改进YOLOv13模型的新方法——SHSA(单头自注意力)模块,用于提升目标检测任务的计算效率和推理速度。SHSA通过简化多头注意力机制为单头结构,显著减少了计算冗余和内存占用。实验表明,该模块在保持精度的同时,在GPU、CPU和移动设备上分别实现了3.3倍、8.1倍和2.4倍的加速效果。文章详细介绍了SHSA的结构原理、核心代码实现方法,以及如何集成到YOLOv13的配置文件中。这种改进特别适合资源受限设备,为实时目标检测提供了更优的速度-精度平衡方案。

Ai缝合怪、助力小伙伴高效发论文 507

从准确率到AUC:一文读懂机器学习模型评价指标

机器学习模型评价需科学衡量泛化能力和实际价值,尤其在医疗、金融等关键领域。本文系统解析了分类任务的评价指标: 基础指标 准确率易受类别不平衡影响 精确率与召回率反映业务权衡,F1分数综合二者 核心指标AUC 通过ROC曲线绘制模型在所有阈值下的表现 本质衡量正样本得分高于负样本的概率 三大优势:抗类别不平衡、兼顾精确率/召回率、适用于排序任务 指标选择原则 需结合业务目标(漏报/误报成本)和数据特点(类别平衡性),AUC因其全局性和稳健性成为二分类任务的重要评价标准。

qq_45464126的博客 1185

092、多sensor帧同步在环视系统中的实现——基于瑞芯微RK3588的PPS同步与曝光同步方案

摘要: 本文探讨了瑞芯微RK3588平台在360环视系统中实现多摄像头帧同步的技术方案。针对环视拼接常见的动态场景错位问题,提出了PPS同步与曝光同步相结合的解决方案。通过GPIO硬件触发实现四路摄像头同步曝光,配合I2C全局曝光控制,将时间误差控制在0.5ms内。文章详细解析了RK3588设备树配置、内核驱动实现中的关键细节,包括同步信号处理、寄存器原子写入等核心技术点,并分享了量产中遇到的温度漂移、信号完整性等实际问题及解决方法。最终通过硬件整形和电源优化,将同步抖动控制在±5μs以内,有效解决了动态拼

zzfmlxs的博客 33

详解【计算机类&面试真题】军队文职考试——第7期:C盘格式化需要注意什么?| 两台笔记本连起来后ping不同,可能存在哪些问题?| 模拟信号到数字信号是如何转化的?| 计算机由哪些部件组成?

这是我分享的系列面试知识——军队文职(计算机类)面试真题详解(第7期)。本期分享:两台笔记本连起来后ping不同,你觉得可能存在哪些问题?模拟信号到数字信号是如何转化的?谈一谈计算机由哪些部件组成?如何加强计算机网络安全管理?若通过域名无法访问,而通过IP地址能访问。这是怎么回事?你将如何解决?谈一谈C盘格式化需要注意什么?开放类题目:如果应聘的岗位和你想的差距很远,你怎么办?

追光者♂:记录、分享、总结、提升,现象级专栏《Python从入门到人工智能》作者,无惧黑暗,坚信曙光 1922

如何判断一个 AI 分类模型的好坏?从准确率到 AUC 等核心指标一文讲透

模型评估的本质,是将技术指标与业务代价对齐。没有“最好”的指标,只有“最合适”的指标。准确率、精确率、召回率、F1、AUC、AUPR 各有其适用边界,理解它们的定义、假设与局限,才能在实际项目中做出合理判断。

weixin_55939638的博客 1279

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

机器学习:分类模型性能评估(Accurary Precision Recall F1分数 PR ROC)

理想的PR曲线应该尽可能地接近右上角,这意味着模型在保持高召回率的同时,也能保持高精确度。这里特指负样本数量远大于正样本时,在这类问题中,我们往往更关注正样本是否被正确分类,即TP的值。其中横坐标为假正率(FPR),纵坐标为真正率(TPR),下面就是一个标准的 ROC 曲线图。所有被预测为正的样本中实际为正的样本的概率,公式如下:实际为正的样本中被预测为正样本的概率,其公式如下。如果我们把精确率(Precision)和召回率(Recall)之间的关系用图来表达,就是下面的PR曲线。

顺颂时祺,秋绥冬禧 496

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

机器学习分类模型评估指标的学习

常见的分类模型评估指标包括准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数(F1 Score)、ROC曲线和AUC值。

2201_75562267的博客 2498

模型评估指标选错=项目失败?MCP AI-102中必须掌握的4项黄金标准

掌握MCP AI-102的模型评估指标,精准判断模型性能。详解准确率、召回率、F1分数与AUC-ROC四大黄金标准,覆盖分类、不平衡数据等典型场景,避免因指标选错导致项目失败。方法实用,逻辑清晰,值得收藏。

AlgoInk的博客 988

机器学习中的ROC曲线和AUC指标

什么是ROC曲线 ROC曲线反应了TPR和FPR之间的关系。 TPR = TP/ (TP+FN) 预测为1 并且预测对的占实际就是1的百分比 FPR = FP/ (FP+TN) 预测为1 但是预测错了实际应该为0,占真实值为0的百分比。 我们来举个例子看如何计算TPR和FPR。 当我们阈值设置为0.9时,即认为socre要大于等于0.9才会判断为P时,对应的TPR = 1 / ( 1 + 9) = 10%,FPR = 0 / (0 + 10) = 0% 当我们阈值设置为0.5时,即认为socre要

GwentBoy的博客 1509

分类性能度量指标:准确性(AC)、敏感性(SE)、特异性(SP)、F1评分、ROC曲线、PR(Precision-Recall)曲线、AUC曲线,混淆曲线

一:比较容易理解的比喻 原文:敏感性和特异性 以糖尿病人的筛查为例。第一个钟形代表正常人,第二个钟形代表糖尿病人。理想中,如果正常人和糖尿病人的血糖范围完全没有重合就好了。这样我就把标准定在中间那个最低点。低于此点的,就是正常人;高于此点的,就是糖尿病人。多好!可惜,现实中,是这样的:由于人人都是任性的小公举,所以正常人的血糖范围和糖尿病人的血糖范围有一部分是重叠的。那么应该把标准画在哪里比较好呢...

据说大佬都喜欢黑色! 3万+

模型评估:分类模型评估指标、ROC曲线与PR曲线的差异解析

一个理想的分类器应该具有接近左上角的ROC曲线,这意味着模型在高召回率的同时保持低假正例率。在实际应用中,我们需要根据具体的问题和需求选择合适的评估方法和可视化工具来全面评估模型的性能。:ROC曲线主要关注真正例率(TPR,即查全率)和假正例率(FPR),通过在不同阈值下绘制TPR和FPR的点并连接成线来展示模型性能。为了计算上述指标,我们首先需要得到模型的预测结果,包括真正例(TP)、假正例(FP)、真反例(TN)和假反例(FN)的数量。高查准率意味着模型预测为正例的样本中,真实正例的占比较高。

linzusjenhsoo的博客 1212

机器学习中的模型评估:多分类任务的性能评估

在机器学习项目中,多分类任务是常见的应用场景之一,涉及将数据分为多个类别。与二分类任务不同,多分类任务的性能评估需要考虑更多的指标和方法。本文将从多分类任务的性能评估指标出发,介绍常用的评估方法,并通过一个完整的代码示例带你入门,同时探讨其应用场景和注意事项。多分类任务的性能评估是机器学习项目中的一个重要环节,通过合理的性能评估指标,可以全面了解模型在各个类别上的表现,选择最适合任务的模型。本文通过一个完整的代码示例,展示了如何计算和可视化多分类任务的性能指标,并探讨了其应用场景和注意事项。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1893

不平衡多分类问题模型评估指标探讨与sklearn.metrics实践

我们在用机器学习、深度学习建模、训练模型过程中,需要对我们模型进行评估、评价,并依据评估结果决策下一步工作策略,常用的评估指标有准确率、精准率、召回率、F1分数、ROC、AUC、MAE、MSE等等,本文将结合SKlearn的metrics所封装的函数,重点围绕多分类问题实践评估指标。

肖永威的专栏 7415

分类算法模型的评价标准

如果对一个事物进行好坏的评价,一定是在指定场景下,使用符合该场景相关的评价标准对其进行好坏的评价分类模型的评价有如下几种方式。

m0_46926492的博客 3130
上一篇: AI基石 | 机器学习基础(一):经典算法三巨头 —— 逻辑回归、决策树与 SVM 的“华山论剑”
下一篇: AI基石 | 大模型基石:Transformer 架构 —— GPT 是如何“读懂”你的?
ipython_harley
博客等级 码龄7年 8粉丝 33原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值