Apriori算法的简单描述

数据挖掘(一)——Apriori关联规则算法及评估 数据挖掘(一)——Apriori关联规则算法及评估 1、Apriori算法概述 直接上算法的手推图: 左上角是原数据,下半部分是步骤,用于挖掘最大频繁项集。 2、频繁项集评估参数 3、Python代码实现 阅读详情

(一)

Apriori 算法 

Apriori算法是种最有影响的挖掘布尔关联规则频繁项集的算法。它的核心是基于两阶段频集思想的递推算法。该关联规则在分类上属于单维、单层、布尔关联规则。在这里,所有支持度大于最小支持度的项集称为频繁项集(简称频集),也常称为最大项目集。
在Apriori算法中,寻找最大项目集(频繁项集)的基本思想是:算法需要对数据集进行多步处理。第一步,简单统计所有含一个元素项目集出现的频数,并找出那些不小于最小支持度的项目集,即一维最大项目集。从第二步开始循环处理直到再没有最大项目集生成。循环过程是:第k步中,根据第k-1步生成的(k-1)维最大项目集产生k维侯选项目集,然后对(事务)数据库进行搜索,得到侯选项目集的项集支持度,与最小支持度进行比较,从而找到k维最大项目集。
下面以图例的方式说明该算法的运行过程: 假设有一个数据库D,其中有4个事务记录,分别表示为:

TID Items
T1I1,I3,I4
T2I2,I3,I5
T3I1,I2,I3,I5
T4I2,I5

这里预定最小支持度minSupport=2,下面用图例说明算法运行的过程:

TID Items
T1I1,I3,I4
T2I2,I3,I5
T3I1,I2,I3,I5
T4I2,I5

扫描D,对每个候选项进行支持度计数得到表C1(I1出现2次,I2出现3次,I3出现3次,I4出现1次,I5出现3次):

项集 支持度计数
{I1}2
{I2}3
{I3}3
{I4}1
{I5}3

比较候选项支持度计数与最小支持度minSupport,产生1维最大项目集L1(这里,小于支持度为2的被筛选掉):

项集 支持度计数
{I1}2
{I2}3
{I3}3
{I5}3

由L1产生候选项集C2(I1、I2、I3、I5组合成2维项目集):

项集
{I1,I2}
{I1,I3}
{I1,I5}
{I2,I3}
{I2,I5}
{I3,I5}

扫描D,对每个候选项集进行支持度计数:

项集 支持度计数
{I1,I2}1
{I1,I3}2
{I1,I5}1
{I2,I3}2
{I2,I5}3
{I3,I5}2

比较候选项支持度计数与最小支持度minSupport,产生2维最大项目集L2(找出2维最大项目集,小于2的项目集被筛选掉):

项集 支持度计数
{I1,I3}2
{I2,I3}2
{I2,I5}3
{I3,I5}2

由L2产生候选项集C3(扫描数据库一次生成3-频繁集,并把它们排序,放入L表中):

项集
{I2,I3,I5}

比较候选项支持度计数与最小支持度minSupport,产生3维最大项目集L3:

项集 支持度计数
{I2,I3,I5}2

算法终止。

从算法的运行过程,我们可以看出该Apriori算法的优点:简单、易理解、数据要求低,然而我们也可以看到Apriori算法的缺点:(1)在每一步产生侯选项目集时循环产生的组合过多,没有排除不应该参与组合的元素;(2)每次计算项集的支持度时,都对数据库D中的全部记录进行了一遍扫描比较,如果是一个大型的数据库的话,这种扫描比较会大大增加计算机系统的I/O开销。而这种代价是随着数据库的记录的增加呈现出几何级数的增加。因此人们开始寻求更好性能的算法,如下面要介绍的F-P算法。

问题思路:从K-1维最大项目集中选出K维候选项目集的依据是什么、最小支持度怎么设定才合理、

部分转自维基百科:http://zh.wikipedia.org/wiki/%E5%85%B3%E8%81%94%E5%BC%8F%E8%A7%84%E5%88%99#Apriori_.E6.BC.94.E7.AE.97.E6.B3.95


(二)

关联规则的三种算法:

       1.Apriori算法:使用候选项集找频繁项集
  Apriori算法是一种最有影响的挖掘布尔关联规则频繁项集的算法。其核心是基于两阶段频集思想的递推算法。该关联规则在分类上属于单维、单层、布尔关联规则。在这里,所有支持度大于最小支持度的项集称为频繁项集,简称频集。
  该算法的基本思想是:首先找出所有的频集,这些项集出现的频繁性至少和预定义的最小支持度一样。然后由频集产生强关联规则,这些规则必须满足最小支持度和最小可信度。然后使用第1步找到的频集产生期望的规则,产生只包含集合的项的所有规则,其中每一条规则的右部只有一项,这里采用的是中规则的定义。一旦这些规则被生成,那么只有那些大于用户给定的最小可信度的规则才被留下来。为了生成所有频集,使用了递推的方法。
  基于以上描述,Apriori算法应该是对离散型数据进行分析的工具。

  2.基于划分的算法
  Savasere等设计了一个基于划分的算法。这个算法先把数据库从逻辑上分成几个互不相交的块,每次单独考虑一个分块并对它生成所有的频集,然后把产生的频集合并,用来生成所有可能的频集,最后计算这些项集的支持度。这里分块的大小选择要使得每个分块可以被放入主存,每个阶段只需被扫描一次。而算法的正确性是由每一个可能的频集至少在某一个分块中是频集保证的。该算法是可以高度并行的,可以把每一分块分别分配给某一个处理器生成频集。产生频集的每一个循环结束后,处理器之间进行通信来产生全局的候选k-项集。
从这点看来,该算法要求的数据也是离散数据。

  3.FP-树频集算法
  针对Apriori算法的固有缺陷,J. Han等提出了不产生候选挖掘频繁项集的方法:FP-树频集算法。采用分而治之的策略,在经过第一遍扫描之后,把数据库中的频集压缩进一棵频繁模式树(FP-tree),同时依然保留其中的关联信息,随后再将FP-tree分化成一些条件库,每个库和一个长度为1的频集相关,然后再对这些条件库分别进行挖掘。当原始数据量很大的时候,也可以结合划分的方法,使得一个FP-tree可以放入主存中。实验表明,FP-growth对不同长度的规则都有很好的适应性,同时在效率上较之Apriori算法有巨大的提高。
FP-树对数据值的强制要求,是二项值。比如true和false。

(

   FP-Tree算法  基本原理和思想:

  只进行2次数据库扫描,不使用候选集,直接压缩数据库成一个频繁模式树,最后通过这棵树生成挂链规则。基本过程如下:

  (1) 按Apriori算法,扫描数据库一次生成1-频繁集,并把它们按照降序排序,放入L表中。

  (2) 创建根节点,并标志为null,扫描数据库一次,当得到数据库的一个项目集时,就把其中的元素按L表的次序排序,然后递归调用FP-growth来实现FP-tree增长。

)

转自:http://f.dataguru.cn/thread-293331-1-1.html


(三)

再来一个栗子:

【例1】设事务数据库D如表2.1所示,D中包含4个事务,即|D|=4,最小支持数mincount=2,即最小支持度minsup=2/4=50%。挖掘频繁项目集的具体过程如下所述:C1={{A},{B},{C},{D},{F}},第一次循环产生L1={{A},{B},{C},{F}},由Apriori_gen(L1)生成C2,扫描数据库,计算C2中每个候选集得到L2。依此循环,得到L3。整个挖掘过程如下图1所示。
表1 事务数据库D
Tid
事务
100
200
300
400
B,C,F
A,C,D
B,F
A,B,C,F

  
图1 Apriori算法的执行过程
在找到了事务数据库中的所有频繁项集后,利用这些频繁项集可以产生关联规则,产生关联规则的步骤如下:
(1) 对于每个频繁项目集l,产生l的所有非空子集。
(2) 对于l的每个非空子集m,如果support(l)/support(m)≥minconf,则输出规则“m (l-m)”。
例如,在上例中产生的频繁项目集l={B,C,F},l的非空子集有{B,C}、{B,F}、{C,F}、{B}、{C}和{F},则运用上述产生关联规则的方法可以得到以下关联规则:
          B C F    confidence=(2/4)/(4/4)=1
          B F C    confidence=(2/4)/(3/4)=0.667
          C F B    confidence=(2/4)/(2/4)=1
          F B C    confidence=(2/4)/(3/4)= 0.667
          C B F    confidence=(2/4)/(3/4)= 0.667
          B C F    confidence=(2/4)/(3/4)= 0.667

转自:http://f.dataguru.cn/thread-258437-1-1.html


(四)


一、Apriori算法简介:  Apriori算法是一种挖掘关联规则的频繁项集算法,其核心思想是通过候选集生成和情节的向下封闭检测两个阶段来挖掘频繁项集。 Apriori(先验的,推测的)算法应用广泛,可用于消费市场价格分析,猜测顾客的消费习惯;网络安全领域中的入侵检测技术;可用在用于高校管理中,根据挖掘规则可以有效地辅助学校管理部门有针对性的开展贫困助学工作;也可用在移动通信领域中,指导运营商的业务运营和辅助业务提供商的决策制定。

二、挖掘步骤:

1.依据支持度找出所有频繁项集(频度)

2.依据置信度产生关联规则(强度)

三、基本概念

对于A->B

①支持度:P(A ∩ B),既有A又有B的概率

②置信度:

P(B|A),在A发生的事件中同时发生B的概率 p(AB)/P(A)     例如购物篮分析:牛奶 ⇒ 面包

例子:[支持度:3%,置信度:40%]

支持度3%:意味着3%顾客同时购买牛奶和面包

置信度40%:意味着购买牛奶的顾客40%也购买面包

③如果事件A中包含k个元素,那么称这个事件A为k项集事件A满足最小支持度阈值的事件称为频繁k项集。

④同时满足最小支持度阈值和最小置信度阈值的规则称为强规则

四、实现步骤

    Apriori算法是一种最有影响的挖掘布尔关联规则频繁项集的算法Apriori使用一种称作逐层搜索的迭代方法,“K-1项集”用于搜索“K项集”。

首先,找出频繁“1项集”的集合,该集合记作L1。L1用于找频繁“2项集”的集合L2,而L2用于找L3。如此下去,直到不能找到“K项集”。找每个Lk都需要一次数据库扫描。

核心思想是:连接步和剪枝步。连接步是自连接,原则是保证前k-2项相同,并按照字典顺序连接。剪枝步,是使任一频繁项集的所有非空子集也必须是频繁的。反之,如果某个候选的非空子集不是频繁的,那么该候选肯定不是频繁的,从而可以将其从CK中删除。

简单的讲,1、发现频繁项集,过程为(1)扫描(2)计数(3)比较(4)产生频繁项集(5)连接、剪枝,产生候选项集   重复步骤(1)~(5)直到不能发现更大的频集

2、产生关联规则,过程为:根据前面提到的置信度的定义,关联规则的产生如下:

(1)对于每个频繁项集L,产生L的所有非空子集;

(2)对于L的每个非空子集S,如果

                P(L)/P(S)≧min_conf

则输出规则“SàL-S”

注:L-S表示在项集L中除去S子集的项集

再来一张图解释一下:

五、总结:

  ①Apriori算法的缺点:(1)由频繁k-1项集进行自连接生成的候选频繁k项集数量巨大。(2)在验证候选频繁k项集的时候需要对整个(事务)数据库进行扫描,非常耗时。

  ②网上提到的频集算法的几种优化方法:1. 基于划分的方法。2. 基于hash的方法。3. 基于采样的方法。4. 减少交易的个数。


转自:
http://blog.youkuaiyun.com/lizhengnanhua/article/details/9061755
http://blog.youkuaiyun.com/lizhengnanhua/article/details/9061887

(五)

补充下Apriori 的性质,有以下几种说法:
(1)
Apriori 性质:任一频繁项集的所有非空子集也必须是频繁的。意思就是说,生成一个k-itemset的候选项时,如果这个候选项有子集不在(k-1)-itemset(已经确定是frequent的)中时,那么这个候选项就不用拿去和支持度判断了,直接删除。
(2)
可以想象,该算法基本思路计算复杂度是非常大的。为了提高频繁项集的产生效率,使用先验性质(频繁项集的所有非空子集也一定是频繁的;换句话说,若某个集合存在一个非空子集不是频繁项集,则该集合不是频繁项集)来压缩搜索空间。
(3)
 定理1:频繁项集的所有非空子集都是频繁项集。
 定理2:非频繁项集的超集一定是非频繁项集。
可以发现,“生成候选集的过程中,利用了先验原理:如果一个项集是频繁的,那么它的自己一定是频繁的。反之,如果一个项集的子集不是频繁的,那么这个项集本身一定也不是频繁的。利用这个原理我们就可以缩小候选集的规模,来减少判断的时间”, 即 这两条定理的作用是:缩小候选集的规模。
(4)
算法中核心性质:频繁项集的所有非空子集也必须是频繁的。逆反命题 也成立:如果一个项集是非频繁的,那么所有它的超集也是非频繁。

参考:
http://blog.youkuaiyun.com/zhyoulun/article/details/41978401
http://blog.youkuaiyun.com/chenwei825825/article/details/16985723

http://www.tuicool.com/articles/U7VzUv2

http://f.dataguru.cn/thread-257918-1-1.html

(六)

关联规则挖掘(Association rule mining)是数据挖掘中最活跃的研究方法之一,可以用来发现事情之间的联系,最早是为了发现超市交易数据库中不同的商品之间的关系。(啤酒与尿布)

基本概念
  1. 支持度的定义:support(X-->Y) = |X交Y|/N=集合X与集合Y中的项在一条记录中同时出现的次数/数据记录的个数。例如:support({啤酒}-->{尿布}) = 啤酒和尿布同时出现的次数/数据记录数 = 3/5=60%。
  2. 自信度的定义:confidence(X-->Y) = |X交Y|/|X| = 集合X与集合Y中的项在一条记录中同时出现的次数/集合X出现的个数 。例如:confidence({啤酒}-->{尿布}) = 啤酒和尿布同时出现的次数/啤酒出现的次数=3/3=100%;confidence({尿布}-->{啤酒}) = 啤酒和尿布同时出现的次数/尿布出现的次数 = 3/4 = 75%

同时满足最小支持度阈值(min_sup)和最小置信度阈值(min_conf)的规则称作强规则 ,如果项集满足最小支持度,则称它为频繁项集

“如何由大型数据库挖掘关联规则?”关联规则的挖掘是一个两步的过程:

  1. 找出所有频繁项集:根据定义,这些项集出现的频繁性至少和预定义的最小支持计数一样。
  2. 由频繁项集产生强关联规则:根据定义,这些规则必须满足最小支持度和最小置信度。

Apriori定律

为了减少频繁项集的生成时间,我们应该尽早的消除一些完全不可能是频繁项集的集合,Apriori的两条定律就是干这事的。

Apriori定律1:如果一个集合是频繁项集,则它的所有子集都是频繁项集。举例:假设一个集合{A,B}是频繁项集,即A、B同时出现在一条记录的次数大于等于最小支持度min_support,则它的子集{A},{B}出现次数必定大于等于min_support,即它的子集都是频繁项集。(注:在算法实现的过程中用到这个思想,生成频繁项集的时候,判断该频繁项集的子集是否都是频繁项集;否则过滤掉)

Apriori定律2:如果一个集合不是频繁项集,则它的所有超集都不是频繁项集。举例:假设集合{A}不是频繁项集,即A出现的次数小于min_support,则它的任何超集如{A,B}出现的次数必定小于min_support,因此其超集必定也不是频繁项集。
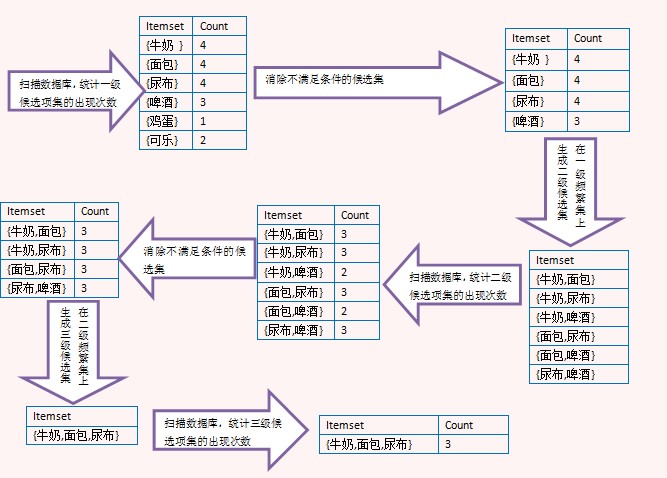
上面的图演示了Apriori算法的过程,注意看由二级频繁项集生成三级候选项集时,没有{牛奶,面包,啤酒},那是因为{面包,啤酒}不是二级频繁项集,这里利用了Apriori定理。最后生成三级频繁项集后,没有更高一级的候选项集,因此整个算法结束,{牛奶,面包,尿布}是最大频繁子集。

Python实现算法地址https://github.com/taizilongxu/datamining

参考资料


转自:
http://blog.youkuaiyun.com/lizhengnanhua/article/details/9061755
http://blog.youkuaiyun.com/lizhengnanhua/article/details/9061887
http://hackerxu.com/2014/10/18/apriori.html
Java实现Apriori算法 简介: Apriori算法是第一个关联规则挖掘算法,也是最经典的算法。它利用逐层搜索的迭代方法找出数据库中项集的关系,以形成规则,其过程由连接(类矩阵运算)与剪枝(去掉那些没必要的中间结果)组成。该算法中项集的概念即为项的集合。包含K个项的集合为k项集。项集出现的频率是包含项集的事务数,称为项集的频率。如果某项集满足最小支持度,则称它为频繁项集。 基本思想: 首先扫描数据库中所需要进行分析的数据,在设置完支持度以及置信度以后,在最小支持度的支持下产生频繁项,即统计所有项目集中包含一个或一个以上的元素频数,找 阅读详情

相关推荐

关联规则算法——Apriori算法解析及Python实现

文章目录关联规则挖掘过程Apriori算法1. Apriori算法的基本思想2. Apriori算法产生频繁项集的过程3. Apriori算法的主要步骤4. 举例及代码实现 关联规则挖掘过程 关联规则挖掘问题可以分解为以下两个子问题 找频繁项集 找出事务集T中所有大于或等于用户指定最小支持度的项集,即频繁项集。(项集的支持度可简单用包含该项集的事务数来表示) 利用频繁项集生成所需要的关联规则 对每一频繁项集A,找到A的所有非空子集a,如果support(A) / support(a) >= min

bibibibiboi的博客 4825

学习序列模式挖掘--Apriori算法

学习序列模式挖掘 1.1引言 已Apriori算法为例,此算法是经典的挖掘频繁项集和关联规则的数据挖掘算法。A priori在拉丁语中指"来自以前"。当定义问题时,通常会使用先验知识或者假设,这被称作"一个先验"(a priori)。Apriori算法的名字正是基于这样的事实:算法使用频繁项集性质的先验性质,即频繁项集的所有非空子集也一定是频繁的。Apriori算法使用一种称为逐层搜索的迭代方法,其中k项集用于探索(k+1)项集。首先,通过扫描数据库,累计每个项的计数,并收集满足最小支持度的项,找出频繁1项

perfectzxiny的博客 2002

Apriori算法原理及实现

有这样一个故事:美国的妇女们经常会嘱咐她们的丈夫下班后为孩子买尿布,而丈夫在买完尿布后又要顺 手买回自己爱喝的啤酒,因此啤酒和尿布在一起被购买的机会很多。这个举措使尿布和啤酒的销量双双增加,并一直为众商家所津津乐道。"尿布和啤酒":关联规则的一个非常有名的故事。关联规则的是在一个数据集中找出项与项之间的关系,也被称为购物蓝分析。

晓风残月xj 7504

机器学习实战(十)Apriori详解

文章目录前言:一、关联分析二、频繁项集的评估标准三、关联规则发现四、先验原理五、Apriori算法思想六、Aprior算法流程 前言: 一、关联分析 大型超市有海量的交易数据,作为精明的商家肯定不会放弃对这些海量数据的应用,他们希望通过对这些交易数据的分析,了解顾客的购买行为。我们可以通过聚类算法寻找购买相似物品的人群,从而为特定人群提供更具个性化的服务。但是对于超市来讲,更有价值的是找出商品之间...

陌若安生的博客 3766

Apriori算法及C++实现

最近工作比较忙,每天发在学习上的时间比较少,最近学的数据挖掘教程比较进度缓慢,上星期开始看的Apriori算法,这算是我接触的第一个数据挖掘方面的算法,看了2-3遍了解其原理。曾看过大侠说过,要想完全理解其算法的本质,即必须上机编写测试,哪怕是写出伪代码也要翻译成机器语言跑一遍,来感觉此算法的伟大。所以抽了个周六,详细编写了遍,并参考网上的例子,对其进行适当的优化。 首先我们要先了解Aprior

shadow_dreamer的博客 1万+

数据挖掘之Apriori算法

假设有15个候选3-项集: {1 4 5}, {1 2 4}, {4 5 7}, {1 2 5}, {4 5 8}, {1 5 9}, {1 3 6}, {2 3 4}, {5 6 7}, {3 4 5}, {3 5 6}, {3 5 7}, {6 8 9}, {3 6 7}, {3 6 8}所有的候选项集都存放在hash树的叶结点中。基于遍历的支持度计算非常耗时间,而基于 hash 的支持度计算可以将所有候选项集以 hash 结构中,每条事务只需要匹配其对应桶里的候选项集,从而节省时间开销。

m0_68340170的博客 2333

数据挖掘之频繁项集分析

频繁项集最经典和常用的应用就是超市的购物篮分析。每个购物篮里有很多商品,每个商品都是一项元素,每个购物篮都是一个集合,所有购物篮就形成了一个系列集合。 分析哪些商品经常一起频繁出现在购物篮内,即找到频繁项集,然后,再分析其他商品与频繁项集的关系,即关联规则。 1. 什么是频繁项?什么是频繁项集?与相似性分析有什么差别? 有什么应用? 频繁项:在多个集合中,频繁出现的元素/项,就是频繁

viewcode的专栏 2万+

Apriori算法——深度剖析及源码实现

引言在一家超市中,人们发现了一个特别有趣的现象:尿布与啤酒这两种风马牛不相及的商品居然摆在一起。但这一奇怪的举措却使尿布和啤酒的稍量大幅增加了。这可不是一个笑话,而是一直被商家所津津乐道的发生在美国沃尔玛连锁超市的真实案例。原来,美国的妇女通常在家照顾孩子,所以她们经常会嘱咐丈夫在下班回家的路上为孩子买尿布,而丈夫在买尿布的同时又会顺手购买自己爱喝的啤酒。这个发现为商家带来了大量的利润,但是如何从浩

老杨的博客 7771

【机器学习】深度解析Apriori算法

项集、支持度、置信度、最小支持度、最小置信度、频繁项集

Zsusan7的博客 3509

BERTopic模型入门教程(附代码+参数调节)

BERTopic 是一种用于从文本数据中提取主题模型的新型方法。通过结合 BERT嵌入和传统的主题模型来生成语义丰富的主题。传统的主题模型(如LDA)主要依赖于词频矩阵,而 BERTopic 通过预训练语言模型生成高维语义嵌入来捕捉词语间的复杂关系,因此可以更好地处理上下文信息。BERTopic模型可以看作是创建其主题表示的一系列步骤。核心原理如下:就本质而言,BERTopic就是一个拼装框架,可以把每部分都替换成其他模型,只要完成任务即可。

m0_52069102的博客 1万+

数字后端DRC Violation定位与自动化修复:Innovus与Calibre协同实战

设计规则检查(DRC)是芯片tapeout前确保版图可制造性的关键验证环节。在数字后端流程中,Calibre作为signoff级物理验证工具,会依据代工厂SVRF规则文件对GDS进行严格几何检查;而Innovus则提供快速迭代的in-design DRC反馈。两者协同成为工程师定位violation、保障流片成功的主流工作流。面对成千上万条DRC violation,高效的定位与分类思路、跨工具映射技巧,以及基于Tcl脚本的自动化修复方法,能大幅缩短物理验证周期。本文从DRC的分层定位出发,结合Innovu

weixin_29185167的博客 335

简易apriori算法实现

Apriori是一种经典的数据挖掘算法,基于事务数据库的求频繁项目集的算法,最终得到频繁项目集从而得到关联规则。 总体思路如下: 1.找出所有1项集的支持度(即个数占总个数比重),作为频繁1项集的备选项; 2.根据给出的最小支持度找出所有大于该最小支持度的项集作为频繁项集; 3.在该频繁项集中对项集连接和剪切,得到下一个频繁项集的备选项集; 4.一直重复2,3直到备选项集中不存在符合条...

Qingyun 's blog 583

VMware Horizon 8 2111 部署系列(十一)准备RDS主机

RDS (Remote Desktop Service),即远程桌面服务。我们可以使用 Microsoft 远程桌面服务 (RDS) 提供 RDS 主机上的桌面会话并将应用程序传送给多个用户。

白昼的技术专栏 3470

利用 Python 实现简单的 Apriori 算法

利用 Python 实现简单的 Apriori 算法   实现Apriori算法,并采用所写程序提取以下购物篮数据中的频繁项集和强关联规则(参数设置:最小支持度计数 = 4,最小置信度 = 0.6) 事务ID 购买商品 001 面包,黄油,尿布,啤酒 002 咖啡,糖,小甜饼,鲑鱼,啤酒 003 面包,黄油,咖啡,尿布,啤酒,鸡蛋 004 面包,黄油,鲑鱼,鸡 00...

渣渣的夏天 1万+

无人机:DJI Matrice 200 Series_(13).行业应用案例分析

在前一节中,我们介绍了DJI Matrice 200系列无人机的基本硬件配置和性能参数。本节将通过具体的行业应用案例,分析如何利用DJI Matrice 200系列无人机进行二次开发,以满足不同行业的需求。

zhubeibei168的博客 1448

PMSM控制系列文章进阶-8.电流、角度采样及其同步

摘要:本文分析了高低压电机在电流和角度采样中的不同方案选择。高压电机采用霍尔传感器和旋变进行隔离采样,低压电机则使用shunt电阻和磁编码器以降低成本。重点讨论了采样时间补偿问题:电流采样需与PWM周期同步,角度采样需考虑传感器延迟;通过park变换和反park变换时需补偿采样与发波的时间差,提出了通过测试母线电流或Ud变化来验证补偿时间准确性的方法。文中还介绍了对传感器信号进行软解码处理的方法,包括消除直流偏置、增益误差和正交误差等参数的自学习过程。

weixin_41343701的博客 613

Apriori算法详解

Apriori算法总结 一、背景 关联规则学习(Association rule learning)是一种在大型数据库中发现变量之间的有趣性关系的方法。它的目的是利用一些有趣性的量度来识别数据库中发现的强规则。 关联分析是一种在大规模数据集中寻找有趣关系的任务。这些关系可以有两种形式:频繁项 集或者关联规则。频繁项集(frequent item sets)是经常出现在一块的物品的集合,关联...

weixin_39220714的博客 5万+

37、免驱动USB双目同步测距3D活体深度检测和RV1126结合V4L开发USB摄像头使用

基本思想:需要使用双目摄像头在rv1126上进行活体检测,然后将画面实时返回到桌面上,记录一下。第二步:刷机rv1126开发板系统和ssh远程连接,见参考目录。第一步:购买可见光的红外摄像头,见参考连接,在PC端测试可用。

sxj731533730 2620

从Apriori到MS-Apriori算法

前言 最近的几个月一直在研究和学习各种经典的DM,机器学习的相关算法,收获还是挺多的,另外还整了一个DM算法库,集成了很多数据挖掘算法,放在了我的github上,博友的热度超出我的想象,有很多人给我点了star,在此感谢各大博友们,我将会继续更新我的DM算法库。也许这些算法还不能直接拿来用,但是可以给你提供思路,或变变数据的输入格式就能用了。好,扯得有点远了,现在说正题,本篇文章重新回到讲述Ap

走在前往架构师的路上 5221

SCADA|用KingSCADA实现设备台账的查询功能

以上为用KingSCADA实现设备台账的查询功能,另外还有一些细节功能,比如当点击增加按钮时弹出的信息窗口内的信息希望是在选中的某行信息,只要找到差不多的设备,修改个别参数即可,避免增加时弹出空白页,所有信息都需要填写。以上为实现设备台账查询的最简单实现,实际项目中可能会更复杂,你做过哪些设备台账或相关的功能,有比较好的创意或高难度功能方法,欢迎在留言区评论,或在交流群探讨,互通有无,共同进步。首先完成界面的组态工作,主要是通过查询按钮,查询SQLServer数据库的设备台账数据,然后填充到报表内。

做有价值的事,积累有价值的笔记! 479

PX4从放弃到精通(五):PX4中的姿态表示方法及转换关系

文章目录机体坐标系与地理坐标系一、pandas是什么?二、使用步骤1.引入库2.读入数据总结 机体坐标系与地理坐标系 在实际应用中,加速度计的测量轴是由运动平台安装固定此器件的轴向决定的。这些坐标轴就形成了载体坐标系,定义如下: 坐标原点设在载体质心(这样可简化运动方程的推导); y轴指向载体前方,称为横滚轴,横滚角以y轴为起始旋转轴而得到,符合右手定则; x轴与y轴夹角90°,指向载体横向,称为俯仰轴,俯仰角以x轴为起始旋转轴而得到,符合右手定则; z轴与x轴、y轴构成右手笛卡儿坐标系,指向载体垂直方向

超维空间科技的博客 8113

Apriori算法

1 关联分析概述 1.1 关联分析 关联分析(association analysis)是一种在大规模数据集中寻找有趣关系的非监督学习算法。 这种关系可以有两种形式: 频繁项集或者关联规则。 频繁项集(frequent item sets)是经常出现在一块的物品的集合, 关联规则(association rules)暗示两种物品之间可能存在很强的关系。 关联分析的一个典型例子是购物篮分析。 交易号码 商品 001 豆奶,莴苣 002 莴苣,尿布,啤酒,甜菜 003 豆奶,尿布,啤酒,橙汁 004 莴苣,

积一时之步,臻千里之遥程 3953

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

机器学习实验报告——APRIORI算法

1.4.1关联规则关联规则是形如X=>Y的蕴含式,其中X、Y分别是一事务的真子集,且X∩Y=Φ。X称为规则的前提,Y称为规则的结果。关联规则反映出X中的项目在事务中出现时,Y中的项目也跟着出现的规律。本次实验主要探讨了关联规则挖掘领域中的经典算法——Apriori算法。首先介绍了Apriori算法的背景,该算法填补了关联规则挖掘领域的研究空白,并为大规模数据集中频繁项集和关联规则的发现提供了高效的解决方案。

m0_64198455的博客 3015

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

apriori算法实现_Apriori算法详解

Apriori算法简介Apriori算法是一种常用的用于挖掘出数据关联规则(Association Rules)的算法,“apriori”在拉丁语中翻译为“来自以前”,顾名思义,这个算法是使用先验知识来预测数据的关联规则。说到关联规则,我们不得不提到一个经典案例——啤酒与尿布。在这个案例中,沃尔玛发现看似两个无关的商品,它们却经常被一起购买,这是为什么呢?在美国有婴儿的家庭中,一般是母亲...

weixin_42365492的博客 1万+

Apriori算法的python实现

最近学习了关联分析和用于寻找频繁项集的Apriori算法,做了一些笔记,并且来自己实现一下。

jkjgj的博客 5617
上一篇: I/O技术
下一篇: C语言 gets()和scanf()函数的区别
heming621
博客等级 码龄15年 9粉丝 15原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值