【BERT】BERT模型压缩技术概览

Bert/Transformer模型压缩与优化加速 前言 Bert/Transformer结构及其变体,已成为自然语言处理 (NLP)、语音识别 (ASR)等领域的主流序列建模结构。并且,相比于卷积操作的局部特征提取能力、以及平移不变性,Self-attention的全局Context信息编码能力,能够使视觉模型具备更强的特征表达能力、与领域适应性。因此在计算机视觉领域,Vision Transformer结构也日益流行、方兴未艾。然而,Transformer模型的高计算复杂度与参数量,限制了模型的推理部署(包括服务端与移动端应用),其计算、存储与运行时内 阅读详情

由于BERT参数众多,模型庞大,推理速度较慢,在一些实时性要求较高、计算资源受限的场景,其应用会受到限制。因此,讨论如何在不过多的损失BERT性能的条件下,对BERT进行模型压缩,是一个非常有现实意义的问题。

本文先介绍模型压缩的概念及常见方法;随后,对目前出现的BERT剪枝的技术做一个整体的介绍。在后面的文章中,挑选一些典型的例子再进行深度的介绍。

作者&编辑 | 小Dream哥

1 模型压缩 

所谓模型压缩,就是在尽可能不改变模型效果的情况下,减少模型的尺寸,使得模型有更快的推理速度。

随着深度学习技术越来越多的得到应用,模型压缩越来越受到重视,因为当模型的准确度达到一定程度后,如何用更少的硬件成本去达到相同的效果,就变得很有价值;另一方面,随着深度学习模型变得越来越“大”,在很多涉及边缘计算的嵌入式设备中部署就变得困难,模型压缩就变成一个必须的事情。
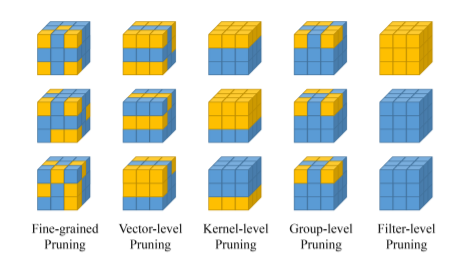
目前,模型压缩主要有4种方法,包括如下:

1.parameter pruning and quantization

参数剪枝(parameter pruning),顾名思义,就是对模型的参数进行删减;

量化(quantization)是一种通过降低数值精度来提高模型推理速度的方法,例如将通常的64位浮点型,转化为16位浮点型进行运算。

2.low-rank factorization

通过低秩因式分解,将参数矩阵分解成两个较小矩阵的乘积来逼近原始参数矩阵,降低模型的参数量,ALBERT中就用了这种方法。

3.transferred/compact convolutional filters

设计特殊结构的卷积滤波器以减少存储和计算的复杂度。

4.knowledge distillation 

知识蒸馏,即先训练一个大模型得到较好的效果;再设计和训练一个小模型来获得与大模型相当的效果。

[1] Cheng Y , Wang D , Zhou P , et al. A Survey of Model Compression and Acceleration for Deep Neural Networks[J]. 2017.

[2]  Cheng J , Wang P S , Gang L I , et al. Recent advances in efficient computation of deep convolutional neural networks[J]. Frontiers of Information Technology & Electronic Engineering, 2018, 19(01):64-77.

[3] Liu Z , Sun M , Zhou T , et al. Rethinking the Value of Network Pruning[J]. 2018.

[4] Frankle J , Carbin M . The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks[J]. 2018.

2 BERT模型压缩

BERT模型的参数量巨大,这导致几乎没有BERT或者 BERT-Large 模型可直接在GPU及智能手机上应用,因此模型压缩方法对于BERT的未来的应用前景非常有价值。下面介绍一些BERT模型压缩的工作,可作参考。

(1) BERT剪枝

去掉BERT中不必要的部分,剪枝的内容包括权重大小剪枝、注意力剪枝、网络层以及其他部分的剪枝等。还有一些方法也通过在训练期间采用正则化的方式来提升剪枝能力(layer dropout)。

BERT模型包括输入层(嵌入层),self-attention层,feed-forward等,针对BERT系列模型的结构,可采取的剪枝策略如下:

1)减少层数

在BERT模型的应用中,我们一般取第12层的hidden向量用于下游任务。可以根据不同的任务,接不同层进行finetune。

2)维度剪枝[1]

可以通过因式分解等方法,降低BERT隐藏层的维度,从而降低BERT的参数量。

3)Attention剪枝

在多头注意力中,每头维度是64,最终叠加注意力向量共768维。有研究[2]表明:在推理阶段,大部分头在被单独去掉的时候,效果不会损失太多;将某一层的头只保留1个,其余的头去掉,对效果基本不会有什么影响。

[1] Compressing BERT: Studying the Effects of Weight Pruning on Transfer Learning

[2] Are Sixteen Heads Really Better than One?

[3] Pruning a BERT-based Question Answering Model

[4] Reducing Transformer Depth on Demand with Structured Dropout

[5] Reweighted Proximal Pruning for Large-Scale Language Representation

2) BERT权重因子分解

通过低秩因式分解,将参数矩阵分解成两个较小矩阵的乘积来逼近原始参数矩阵,降低模型的参数量。最典型的就是ALBERT模型,其提出者认为,词向量只是记忆了相对少量的词语的信息,更多的语义和句法等信息时由隐藏层记忆的。因此,他们认为,词嵌入的维度可以不必与隐藏层的维度一致,可以通过降低词嵌入的维度的方式来减少参数量。

感兴趣的同学看这篇博文详细了解ALBERT的内容:

【NLP】ALBERT:更轻更快的NLP预训练模型

[1] Structured Pruning of Large Language Models

[2] ALBERT: A Lite BERT for Self-supervised Learning of Language Representations

3)BERT知识蒸馏

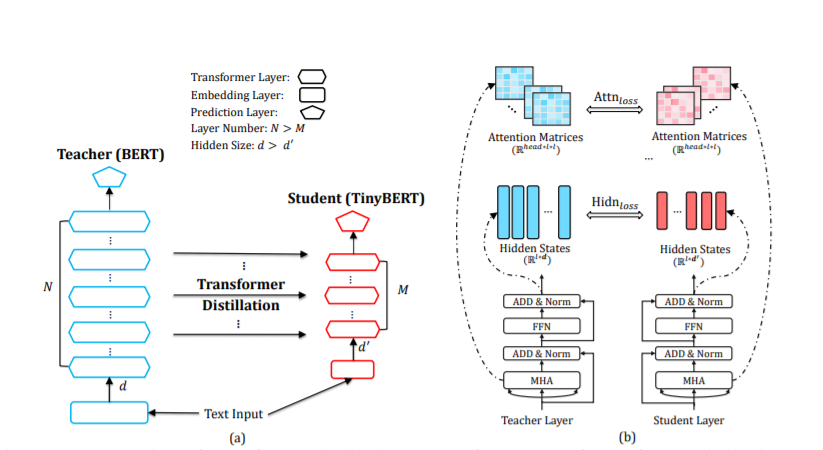
知识蒸馏的本质是让超大线下teacher模型来协助线上student模型的训练,本质上是一种超大模型的知识迁移过程。

对Bert的知识蒸馏,研究的是如何将一个大型网络的泛化能力,迁移到一个相对小型的网络,从而达到以下两个目标:

1) 不需要从零开始训练小模型;

2) 蒸馏学习得到的模型效果优于直接训练。

理论上来说,模型在训练的时候需要尽可能多的神经元连接,而一旦训练完成,其中的部分连接其实是冗余的,可以用一个相对紧凑的结构来代替。
[1] DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter

[2] Distilling Task-Specific Knowledge from BERT into Simple Neural Networks

[3] Distilling Transformers into Simple Neural Networks with Unlabeled Transfer Data

[4] Attentive Student Meets Multi-Task Teacher: Improved Knowledge Distillation for Pretrained Models

[5] Patient Knowledge Distillation for BERT Model Compression

[6] TinyBERT: Distilling BERT for Natural Language Understanding

[7] MobileBERT: Task-Agnostic Compression of BERT by Progressive Knowledge Transfer

4)BERT量化

量化(quantization)是一种通过降低数值精度来提高模型推理速度的方法,例如将通常的64位浮点型,转化为8位浮点型进行运算,BERT的量化的基本理论也是如此。

Q-BERT模型微调后的 BERT_BASE 模型同样包含三部分:嵌入、基于 Transformer 的编码器层、输出层。BERT_BASE 模型不同层的参数大小为:嵌入 91MB、编码器 325MB、输出 0.01MB,减少了非常多。

量化过程更多涉及具体的工程化问题,想了解同学可以参考如下的论文了解。

[1]  Q8BERT: Quantized 8Bit BERT

[2] Q-BERT: Hessian Based Ultra Low Precision Quantization of BERT

总结

BERT模型在多种下游任务表现优异,但庞大的模型结果也带来了训练及推理速度过慢的问题,难以满足对实时响应速度要求高的场景,模型轻量化就显得非常重要。

后续我们分别详细介绍不同类型的BERT模型压缩方法。

下期预告:暂无

知识星球推荐
扫描上面的二维码,就可以加入我们的星球,助你成长为一名合格的自然语言处理算法工程师。

知识星球主要有以下内容:

(1) 聊天机器人。

(2) 知识图谱。

(3) NLP预训练模型。

转载文章请后台联系

侵权必究
往期文章

BERT模型压缩技术:如何让大模型在移动端高效运行 随着人工智能的发展,BERT模型在自然语言处理领域取得了显著的成果。然而,BERT模型规模庞大,计算资源需求高,难以在移动端设备上高效运行。本文的目的就是探索如何运用模型压缩技术,让BERT模型能够在移动端实现高效运行,范围涵盖了常见的模型压缩技术及其应用。本文首先介绍核心概念,包括知识蒸馏、量化和剪枝;接着阐述这些核心概念的原理和相互关系;然后给出核心算法原理和具体操作步骤,以及相关的数学模型和公式;通过项目实战展示模型压缩技术的实际应用;再介绍实际应用场景、工具和资源推荐;分析未来发展趋势与挑战; 阅读详情

相关推荐

BERT模型压缩与加速

作者:禅与计算机程序设计艺术 1.背景介绍 Google提出的BERT模型,是当今最火的自然语言处理(NLP)模型之一,其已经成为NLP任务的主流技术。BERT模型的输入可以是文本序列,输出是预测的标签或概率分布。它在两个方面做了优化:一是通过精心设计的网络结构,使得模型能够学习到上下文信息;二是通

AI天才研究院 987

15篇论文全面概览BERT压缩方法

作者 | Mitchell A. Gordon译者 | 孙薇出品 | AI科技大本营(ID:rgznai100)模型压缩可减少受训神经网络的冗余——由于几乎没有BERT或者BERT-Large模型可用于GPU及智能手机上,这一点就非常有用了。另外,内存与推理速度的提高也能节省大量成本。本篇列出了作者所见过的BERT压缩论文,以下表格中对不同方法进行了分类。论文1:Compressing BERT...

AI科技大本营 3462

IPD(集成产品开发)管理之道

IPD,是集成产品开发(Integrated Product Development)的缩写,它是集成了众多管理模型和理论、众多企业最佳管理实践的一整套体系,可以帮助企业快速响应市场变化、缩短产品上市时间、减少资源浪费、提高生产力,最终取得商业成功。IPD的思想最早来源于美国PRTM公司出版的《产品及生命周期优化法》一书中,该书详细描述了IPD模式所包含的各个方面。但IPD在中国的普及,源于IBM和华为的推行使用。IPD作为一套先进的产品研发管理模式,其成功的基础是功能部门和各团队之间的密切配合。

钢镚·真的博客 2716

所有你要知道的 BERT 模型压缩方法,都在这里!

模型压缩可减少受训神经网络的冗余,由于几乎没有 BERT 或者 BERT-Large 模型可直接在 GPU 及智能手机上应用,因此模型压缩方法对于 BERT 的未来的应用前景而言,非常有价值。 软件工程师 Mitchell A. Gordon 在本文中总结了所有的 BERT 压缩模型的方法,并对该领域的论文进行罗列及分类,我们下面来看: 压缩方法 1、剪枝——即训练后从网络中去掉不必要的部分...

喜欢打酱油的老鸟 593

TensorRT(C++)部署 Pytorch模型

众所周知,python训练pytorch模型得到.pt模型。但在实际项目应用中,特别是嵌入式端部署时,受限于语言、硬件算力等因素,往往需要优化部署,而tensorRT是最常用的一种方式。本文以yolov5的部署为例,说明模型部署在x86架构上的电脑端的流程。(部署在Arm架构的嵌入式端的流程类似)。

女神sha手的博客 5409

30秒精准解析论文PDF:PyMuPDF4LLM+Qwen2本地Agent实战指南

PDF文献解析是科研信息处理的基础能力,其本质是将非结构化文档转化为可计算的语义结构。传统OCR方案在原生PDF(如LaTeX导出)上精度低、容错差;而基于PDF对象树的解析技术,能精准定位文本、公式、图表锚点与参考文献区块,为后续结构化提取提供高质量输入。结合轻量级领域微调模型(如Qwen2-1.5B-Instruct)与强约束提示词工程,可实现研究目标、方法框架、核心结果等五大要素的高保真蒸馏。该技术路径兼顾隐私安全、零成本复现与离线鲁棒性,特别适用于高校实验室、研究生课题组及AI初学者构建个人文献处理

weixin_33509203的博客 288

【下载】6 篇论文,6 种最前沿剪枝算法

本文转自『机器之心编译』(almosthuman2014)下载方式,见文末剪枝是一种帮助神经网络实现规模更小、效率更高的深度学习方法。这是一种模型优化技术,它删除权重张量中不必要的值,从...

机器学习算法与Python学习 1495

基于python的奥运会历史数据分析【120年】

数据分析实战案例

xff123456_的博客 3339

历史最全BERT压缩方法汇总分享

模型压缩减少了训练好的神经网络中冗余的部分。模型压缩对于像BERT这类复杂模型来说特别有用,因为BERT,特别是BERT-Large需要消耗大量GPU显存,且根本不适用于内存受限的智能手机。当然,提高内存和推理速度也可以大规模节省成本。 在这篇文章中,整理列一些压缩BERT的一些论文,分享给大家。 Bert压缩常用方法 裁剪-训练后移除网络中不必要...

lqfarmer的博客 1007

基于Meteoinfo与TrajStat的后向轨迹聚类分析实战:从数据准备到可视化制图

本文详细介绍了基于Meteoinfo与TrajStat进行后向轨迹聚类分析的完整实战流程。从Java环境配置、Meteoinfo软件与TrajStat插件安装,到精准获取NOAA气象数据、设置参数进行批量轨迹计算,再到利用聚类分析提炼主要气流路径,并最终完成专业地图可视化与制图。文章旨在帮助环境与气象研究者快速掌握从数据准备到成果输出的全链路操作。

p4q5r6s7t的博客 805

【STM32】STM32 CANFD外设的几种消息接收过滤模式

在控制器区域网络(CAN)系统中,正确配置消息过滤器对于有效管理网络通信至关重要。特别是在使用Flexible Data-rate Controller Area Network(FDCAN)时,选择合适的过滤器类型可以大大提高网络效率和消息处理速度。

林愿留的博客 6230

深度神经网络模型压缩与加速研究综述

深度神经网络模型压缩与加速研究综述 前言 深度卷积神经网络(CNNs)近年来在许多视觉识别领域取得了巨大的成功。然而,现有的深度神经网络模型在计算上是昂贵的且内存是密集型的。这限制了他们在低配置的硬件上的运行。因此,在不显著降低模型性能的情况下,在深度网络中进行模型压缩和加速是一种自然的思路,在这篇博客里讲会大致的想你介绍这个领域内的技术,综述了近年来发展起来的压缩和加速CNNs模型的先进技术。...

python_LC_nohtyp的博客 2328

R语言数据可视化:绘制世界地图的两种方案

本文介绍了两种使用R语言绘制世界地图的方案:包含边界边框和不包含边界边框。无论您选择哪种方案,使用ggplot2包和相关的地理数据包,我们可以轻松地绘制出漂亮的世界地图。R语言提供了丰富的包和函数,使我们能够轻松地绘制世界地图,并根据需求添加边界边框。在本文中,我将介绍两种绘制世界地图的方案:一种包含边界边框,一种不包含边界边框。在上述代码中,我们使用了与方案一相同的数据准备和地图绘制步骤,但省略了添加边界边框的代码。函数的调用,我们可以绘制不包含边界边框的世界地图。方案二:绘制不包含边界边框的世界地图。

CodeMaven的博客 2228

应用于bert模型的动态量化技术(使用动态量化技术对训练后的bert模型进行压缩)、使用huggingface中的预训练BERT模型进行微调、模型压缩技术中的动态量化与静态量化

日萌社 人工智能AI:Keras PyTorch MXNet TensorFlow PaddlePaddle 深度学习实战(不定时更新) 应用于bert模型的动态量化技术 学习目标 了解模型压缩技术中的动态量化与静态量化的相关知识。 掌握使用huggingface中的预训练BERT模型进行微调。 掌握使用动态量化技术对训练后的bert模型进行压缩。 相关知识 模型压缩: ...

あずにゃん梓喵的博客 3494

YOLOV5 自动刷图脚本实战(十五)之如何找到正确的门

DXF是一个2D游戏,我们所看到的人物移动,其实是后面的背景在移动,我们所看到的画面,不过是一个完整背景中的一个镜头视角而已想要正确找到门的坐标,我们需要对不同的地图中的每个房间做一些配置信息。

qq_38892949的博客 2812

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

什么是量化?BERT 模型压缩的秘密武器

本文探讨了 BERT 量化的多种精度补偿策略,如量化感知训练、知识蒸馏辅助量化、混合精度训练以及优化量化算法和参数。实验表明,这些策略能不同程度缓解精度损失问题,单独用量化感知训练模型变小、推理加速但精度下降,结合知识蒸馏或优化量化算法可改善精度,多种策略综合运用能使量化 BERT 模型保持压缩和加速优势且性能接近原始模型。​

紫雾凌寒 1816

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

详解4种模型压缩技术、模型蒸馏算法

理论上来说,深度神经网络模型越深,非线性程度也就越大,相应的对现实问题的表达能力越强,但相应的代价是,训练成本和模型大小的增加。同时,在部署时,大模型预测速度较低且需要更好的硬件支持。首先是速度,比如像人脸闸机、人脸解锁手机等应用,对响应速度比较敏感,需要做到实时响应。其次是存储,比如电网周边环境监测这个应用场景中,要图像目标检测模型部署在可用内存只有200M的监控设备上,且当监控程序运行后,剩余内存会小于30M。最后是耗能,离线翻译这种移动设备内置AI模型的能耗直接决定了它的续航能力。

woaimx_1314的博客 7988

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

模型压缩实践系列之——bert-of-theseus,一个非常亲民的bert压缩方法

作者:邱震宇(华泰证券股份有限公司 算法工程师)知乎专栏:我的ai之路本文是模型压缩实践系列的第二篇,方法参考自论文:BERT-of-Theseus: ...

hecongqing的博客 1833

模型蒸馏原理和bert模型蒸馏以及theseus压缩实战

模型蒸馏原理和bert模型蒸馏实战

HUSTHY的博客 9365

TinyBERT: Distilling BERT for Natural Language Understanding——用于自然语言理解的BERT压缩模型

TinyBERT: Distilling BERT for Natural Language Understanding——用于自然语言理解的BERT压缩模型

Together_CZ的博客 1447

12层的bert参数量_关于BERT的模型压缩简介

本期AI论道想跟大家分享一些关于BERT的模型压缩技术。众所周知,大规模的预训练语言模型已经成为各种自然语言处理任务(NLP)的新驱动力,例如BERT在对下游任务进行微调后,显著提高了模型的表现。尽管这些模型在各种NLP任务上获得了最先进的结果,但是通常内存占用和功耗过高,以此带来很高的延迟,包括训练阶段和推断阶段。这反过来又限制了这些模型在移动和物联网等嵌入式设备上的部署。模型压缩旨在...

weixin_39922374的博客 811

独家 | 基于知识蒸馏的BERT模型压缩

作者:孙思琦、成宇、甘哲、刘晶晶本文约1800字,建议阅读5分钟。本文为你介绍“耐心的知识蒸馏”模型。数据派THU后台回复“191010”,获取论文地址。在过去一年里,语...

数据派THU 1959

bert下游_15篇论文全面概览BERT压缩方法

作者 | Mitchell A. Gordon译者 | 孙薇出品 | AI科技大本营(ID:rgznai100)模型压缩可减少受训神经网络的冗余——由于几乎没有BERT或者BERT-Large模型可用于GPU及智能手机上,这一点就非常有用了。另外,内存与推理速度的提高也能节省大量成本。本篇列出了作者所见过的BERT压缩论文,以下表格中对不同方法进行了分类。论文1:Compressing BERT:...

weixin_42298081的博客 361

datawhale11月组队学习 模型压缩技术3:2:4结构稀疏化BERT模型

在本教程中,我们将对BERT问答模型进行`2:4`稀疏化。在微调后,模型准确性损失很小(F1得分86.92 vs 86.48),但推理速度提升了`1.3`倍。

qq_56591814的博客 1476
上一篇: 【每周CV论文】初学深度学习图像对比度增强应该要读的文章
下一篇: 【杂谈】有三AI开源项目中的代码和教程,来学习的粉丝们应该要知道了
言有三
言有三 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄15年 3635粉丝 976原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

言有三

三人行必有AI

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值