



目录
1 DataFrame数据的行转列
1.1 需求
在做数据处理时我们可能会经常用到 Apache Spark 的 DataFrame来对数据进行处理,需要将行数据转成列数据来处理,例如一些指标数据一般会保存在KV类型数据库,根据几个字段作为key,将计算指标作为value保存起来,这样多个用户多个指标就会形成一个窄表,我们在使用这个数据时又希望按照每个用户来展示,将同一个用户的多个指标放到一行,这就需要将DataFrame数据进行行列转换,然后再通过Spark做进一步的处理,将最终的数据保存或提供给调用方。
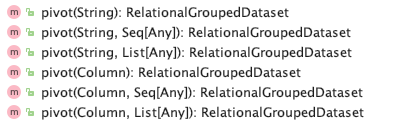
Spark 中DataFrame数据的行转列需要用到Spark中的Pivot(透视),简单来说将用行Row形式的保存的数据转换为列Column形式的数据叫做透视;反之叫做逆透视。pivot算子在org.apache.spark.sql.RelationalGroupedDataset ➹类中,主要有如下6个重载的方法,查看这个方法源码的注释,我们可以看到这个方法是在Spark 1.6.0开始引入的(前4个是1.6.0之后,后2个是从2.4.0之后),而且建议我们最好指定第二个参数(列字段集合),否则效率会很低。
/**
   * Pivots a column of the current `DataFrame` and performs the specified aggregation.
   * There are two versions of pivot function: one that requires the caller to specify the list
   * of distinct values to pivot on, and one that does not. The latter is more concise but less
   * efficient, because Spark needs to first compute the list of distinct values internally.
   *
   * {{{
   *   // Compute the sum of earnings for each year by course with each course as a separate column
   *   df.groupBy("year").pivot("course", Seq("dotNET", "Java")).sum("earnings")
   *
   *   // Or without specifying column values (less efficient)
   *   df.groupBy("year").pivot("course").sum("earnings")
   * }}}
   *
   * @param pivotColumn Name of the column to pivot.
   * @param values List of values that will be translated to columns in the output DataFrame.
   * @since 1.6.0
   */
1.2 准备数据
例如现在有如下销售的不同类目的各个季度的销售额的数据,第一列数据为商品类目,第二列是季度:第一季度Q1、第二季度Q2、第三季度Q3、第四季度Q4,第三列是销售额单位为万元。
import org.apache.spark.sql.Row
import org.apache.spark.sql.types._

object DF_Data {
  val scc = new SparkConfClass()

  /**
    *  category|  quarter|  sales
    *  种类 | 季度 | 销售额
    */
  val store_sales = scc.getSc.parallelize(Array(
     "Books|Q4|4.66",
    "Books|Q1|1.58",
    "Books|Q3|2.84",
    "Books|Q2|1.50",
    "Women|Q1|1.41",
    "Women|Q2|1.36",
    "Women|Q3|2.54",
    "Women|Q4|4.16",
    "Music|Q1|1.50",
    "Music|Q2|1.44",
    "Music|Q3|2.66",
    "Music|Q4|4.36",
    "Children|Q1|1.54",
    "Children|Q2|1.46",
    "Children|Q3|2.74",
    "Children|Q4|4.51",
    "Sports|Q1|1.47",
    "Sports|Q2|1.40",
    "Sports|Q3|2.62",
    "Sports|Q4|4.30",
    "Shoes|Q1|1.51",
    "Shoes|Q2|1.48",
    "Shoes|Q3|2.68",
    "Shoes|Q4|4.46",
    "Jewelry|Q1|1.45",
    "Jewelry|Q2|1.39",
    "Jewelry|Q3|2.59",
    "Jewelry|Q4|4.25",
//    "null|Q1|0.04",
    "null|Q2|0.04",
//    "null|Q3|0.07",
    "null|Q4|0.13",
    "Electronics|Q1|1.56",
    "Electronics|Q2|1.49",
    "Electronics|Q3|2.77",
    "Electronics|Q4|4.57",
    "Home|Q1|1.57",
    "Home|Q2|1.51",
    "Home|Q3|2.79",
    "Home|Q4|4.60",
    "Men|Q1|1.60",
    "Men|Q2|1.54",
    "Men|Q3|2.86",
    "Men|Q4|4.71"
  ))
  val schemaStoreSales = StructType(
    "category|quarter".split("\\|")
      .map(column => StructField(column, StringType, true))
  ).add("sales", DoubleType, true)
  val store_salesRDDRows = store_sales.map(_.split("\\|"))
    .map(line => Row(
      line(0).trim,
      line(1).trim,
      line(2).trim.toDouble
    ))
}
上述代码中SparkConfClass类为自定义的一个Spark 类,主要将常用的SparkConf、SparkContext、SparkContext、以及关闭操作封装到一个类。
import org.apache.spark.{SparkConf, SparkContext}
import org.apache.spark.sql.SQLContext

class SparkConfClass() extends Serializable {
  @transient
  private val conf = new SparkConf().setAppName("pivot_demo").setMaster("local[4]")
    .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
  @transient
  private val sc: SparkContext = new SparkContext(conf)
  sc.setLogLevel("ERROR")
  @transient
  private val sqlContext: SQLContext = new SQLContext(sc)

  def getSc: SparkContext = {
    sc
  }

  def getSqlContext: SQLContext = {
    sqlContext
  }

  def closeSc(): Unit = {
    sc.stop()
  }
}
1.3 使用 Pivot 行转列
object PivotDemo {
  def main(args: Array[String]): Unit = {
    val store_salesFrame = DF_Data.scc.getSqlContext.createDataFrame(DF_Data.store_salesRDDRows, DF_Data.schemaStoreSales)
    store_salesFrame.show(20, false)

	//使用Spark中的函数,例如 round、sum 等
    import org.apache.spark.sql.functions._
    store_salesFrame.groupBy("category")
      .pivot("quarter")
      .agg(round(sum("sales"), 2))
      .show(false)
  }
}
1.4 初次处理的结果
我们的数据转成DataFrame后如下
+--------+-------+-----+
|category|quarter|sales|
+--------+-------+-----+
|   Books|     Q4| 4.66|
|   Books|     Q1| 1.58|
|   Books|     Q3| 2.84|
|   Books|     Q2|  1.5|
|   Women|     Q1| 1.41|
|   Women|     Q2| 1.36|
|   Women|     Q3| 2.54|
|   Women|     Q4| 4.16|
|   Music|     Q1|  1.5|
|   Music|     Q2| 1.44|
|   Music|     Q3| 2.66|
|   Music|     Q4| 4.36|
|Children|     Q1| 1.54|
|Children|     Q2| 1.46|
|Children|     Q3| 2.74|
|Children|     Q4| 4.51|
|  Sports|     Q1| 1.47|
|  Sports|     Q2|  1.4|
|  Sports|     Q3| 2.62|
|  Sports|     Q4|  4.3|
+--------+-------+-----+
only showing top 20 rows
按照类目,将每个季度转成列,如下,可以看到原始数据中category为null的行缺少第一和第三季度的值,但是经过pivot转换后,没有的列对应的值为null,这里需要注意,否则做统计时null值处理后可能还是null值。
+-----------+----+----+----+----+
|category   |Q1  |Q2  |Q3  |Q4  |
+-----------+----+----+----+----+
|Home       |1.57|1.51|2.79|4.6 |
|Sports     |1.47|1.4 |2.62|4.3 |
|Electronics|1.56|1.49|2.77|4.57|
|Books      |1.58|1.5 |2.84|4.66|
|Men        |1.6 |1.54|2.86|4.71|
|Music      |1.5 |1.44|2.66|4.36|
|Women      |1.41|1.36|2.54|4.16|
|Shoes      |1.51|1.48|2.68|4.46|
|Jewelry    |1.45|1.39|2.59|4.25|
|Children   |1.54|1.46|2.74|4.51|
|null       |null|0.04|null|0.13|
+-----------+----+----+----+----+
1.5 下一步
通过上一步已经将行数据转换为列数据,转换后的数据也是一个sql.DataFrame,那么我们就可将其注册为临时视图(这里叫 TempView ),如果是全局的,查询的时候记得在表名前加上global_temp。
注册成临时视图后,我们就可以像操作表数据一样用SQL操作这个数据了,例如现在需要返回,每个商品类目的每个季度的销售额、总销售额,精确到小数点两位。
	import org.apache.spark.sql.functions._
    store_salesFrame.groupBy("category")
       // 指定行转列的各个字段集合,如果知道具体的字段,最好指定上
      .pivot("quarter", Seq("Q1", "Q2", "Q3", "Q4"))
      // 对于同一category的数据,如果quarter值相同时就对其求和,并保留两位小数
      .agg(round(sum("sales"), 2))
        .createOrReplaceGlobalTempView("category")
//        .createTempView("category")

    DF_Data.scc.getSqlContext
      .sql(
        """
          |SELECT category, Q1, Q2, Q3, Q4, ROUND(NVL(Q1, 0.0) + NVL(Q2, 0.0) + NVL(Q3, 0.0) + NVL(Q4, 0.0), 2) AS total
          |FROM global_temp.category
        """.stripMargin)
      .show(false)
存在null值时我们需要调用NVL处理下,结果如下
+-----------+----+----+----+----+-----+
|category   |Q1  |Q2  |Q3  |Q4  |total|
+-----------+----+----+----+----+-----+
|Home       |1.57|1.51|2.79|4.6 |10.47|
|Sports     |1.47|1.4 |2.62|4.3 |9.79 |
|Electronics|1.56|1.49|2.77|4.57|10.39|
|Books      |1.58|1.5 |2.84|4.66|10.58|
|Men        |1.6 |1.54|2.86|4.71|10.71|
|Music      |1.5 |1.44|2.66|4.36|9.96 |
|Women      |1.41|1.36|2.54|4.16|9.47 |
|Shoes      |1.51|1.48|2.68|4.46|10.13|
|Jewelry    |1.45|1.39|2.59|4.25|9.68 |
|Children   |1.54|1.46|2.74|4.51|10.25|
|null       |null|0.04|null|0.13|0.17 |
+-----------+----+----+----+----+-----+
2 Spark 中数据转换与处理
在 Spark 程序中经常需要读取某个文件,对读取到的文件使用 RDD、DataSet、DataFrame、临时表等进行处理,下面以一个简单的流程演示 Spark 中的数据转换与处理。
2.1 测试数据
加入现在有如下数据 data_01.txt
|SECURITIES|ERROR CODE|NUM FLDS|CRNCY|BASE_CRNCY|PX_LAST|QUOTE_FACTOR|LAST_UPDATE_DT|LAST_UPDATE|
|H****D T170 Curncy|0|6|USD|HKD|.128740|1.0000|20181121|20:00:00|
|I****Y T170 Curncy|0|6|JPY|IDR|.748200|100.0000|20181121|20:00:00|
|A****P CMPN Curncy|0|6|MOP|AUD|6.195100|1.0000|20181121|20:00:00|
|J****D CMPN Curncy|0|6|YND|JPY|21195.620000|100.0000|20181121|20:00:00|
|V****R CMPN Curncy|0|6|IDR|VND|N.A.|1.0000|N.A.|N.A.|
|V****P CMPN Curncy|0|6| | | | | | |
2.2 清洗过滤
因为数据中开头和结尾都有分割符,先去除一下
val path = "spark-3.x/spark-df/src/main/resources/data_01.txt"
// 使用前面 1.2节定义好的 SparkConfClass 获取 getSqlContext
val spark = DF_Data.scc.getSqlContext
import spark.implicits._
// load 后为 DataFrame
val lines = spark.read/*.schema()*/.format("text").load(path)
    .map(line => line.get(0).toString.replaceAll("^\\|{1}|\\|{1}$", ""))

lines.show(10, false)
输出结果如下
+-----------------------------------------------------------------------------------------------+
|value                                                                                          |
+-----------------------------------------------------------------------------------------------+
|SECURITIES|ERROR CODE|NUM FLDS|CRNCY|BASE_CRNCY|PX_LAST|QUOTE_FACTOR|LAST_UPDATE_DT|LAST_UPDATE|
|H****D T170 Curncy|0|6|USD|HKD|.128740|1.0000|20181121|20:00:00                                |
|I****Y T170 Curncy|0|6|JPY|IDR|.748200|100.0000|20181121|20:00:00                              |
|A****P CMPN Curncy|0|6|MOP|AUD|6.195100|1.0000|20181121|20:00:00                               |
|J****D CMPN Curncy|0|6|YND|JPY|21195.620000|100.0000|20181121|20:00:00                         |
|V****R CMPN Curncy|0|6|IDR|VND|N.A.|1.0000|N.A.|N.A.                                           |
|V****P CMPN Curncy|0|6| | | | | |                                                              |
+-----------------------------------------------------------------------------------------------+
2.3 DataSet 转 RDD
// 过滤掉第一行
val rdd = lines.rdd.filter(line => !line.toString.contains("SECURITIES|"))
  .map(line => line.toString().split("\\|"))
  .map(line => Row(
    line(0), line(1),line(2),line(3),line(4),
    line(5),line(6),line(7),line(8)
  ))

rdd.collect().foreach(r => println(r))
输出结果如下
[H****D T170 Curncy,0,6,USD,HKD,.128740,1.0000,20181121,20:00:00]
[I****Y T170 Curncy,0,6,JPY,IDR,.748200,100.0000,20181121,20:00:00]
[A****P CMPN Curncy,0,6,MOP,AUD,6.195100,1.0000,20181121,20:00:00]
[J****D CMPN Curncy,0,6,YND,JPY,21195.620000,100.0000,20181121,20:00:00]
[V****R CMPN Curncy,0,6,IDR,VND,N.A.,1.0000,N.A.,N.A.]
[V****P CMPN Curncy,0,6, , , , , , ]
2.4 RDD 转 DataFrame
// Scame,这里先全部以 String 类型处理
val schema: StructType = StructType(
  lines.head().split("\\|")
    .map(filed => StructField(filed, StringType, true))
)

// 生成DF
val df = spark.createDataFrame(rdd, schema)
df.show(10, false)
输出结果如下
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
|SECURITIES        |ERROR CODE|NUM FLDS|CRNCY|BASE_CRNCY|PX_LAST     |QUOTE_FACTOR|LAST_UPDATE_DT|LAST_UPDATE|
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
|H****D T170 Curncy|0         |6       |USD  |HKD       |.128740     |1.0000      |20181121      |20:00:00   |
|I****Y T170 Curncy|0         |6       |JPY  |IDR       |.748200     |100.0000    |20181121      |20:00:00   |
|A****P CMPN Curncy|0         |6       |MOP  |AUD       |6.195100    |1.0000      |20181121      |20:00:00   |
|J****D CMPN Curncy|0         |6       |YND  |JPY       |21195.620000|100.0000    |20181121      |20:00:00   |
|V****R CMPN Curncy|0         |6       |IDR  |VND       |N.A.        |1.0000      |N.A.          |N.A.       |
|V****P CMPN Curncy|0         |6       |     |          |            |            |              |           |
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
2.5 DataFrame 注册为临时表
// 注册为临时表
val view = df.createOrReplaceTempView("rate")
spark.sql("SELECT * FROM rate")
  .show(false)
执行后,他通过 SQL 查询临时表的数据,输出结果如下
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
|SECURITIES        |ERROR CODE|NUM FLDS|CRNCY|BASE_CRNCY|PX_LAST     |QUOTE_FACTOR|LAST_UPDATE_DT|LAST_UPDATE|
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
|H****D T170 Curncy|0         |6       |USD  |HKD       |.128740     |1.0000      |20181121      |20:00:00   |
|I****Y T170 Curncy|0         |6       |JPY  |IDR       |.748200     |100.0000    |20181121      |20:00:00   |
|A****P CMPN Curncy|0         |6       |MOP  |AUD       |6.195100    |1.0000      |20181121      |20:00:00   |
|J****D CMPN Curncy|0         |6       |YND  |JPY       |21195.620000|100.0000    |20181121      |20:00:00   |
|V****R CMPN Curncy|0         |6       |IDR  |VND       |N.A.        |1.0000      |N.A.          |N.A.       |
|V****P CMPN Curncy|0         |6       |     |          |            |            |              |           |
+------------------+----------+--------+-----+----------+------------+------------+--------------+-----------+
2.6 完整代码
package yore

import org.apache.spark.sql.Row
import org.apache.spark.sql.types.{StringType, StructField, StructType}

object DF_Rate {
  def main(args: Array[String]): Unit = {
    val path = "spark-3.x/spark-df/src/main/resources/data_01.txt"
    val spark = DF_Data.scc.getSqlContext
    import spark.implicits._
    val lines = spark.read
      .format("text")
      .load(path)
      .map(line => line.get(0).toString.replaceAll("^\\|{1}|\\|{1}$", ""))

    val rdd = lines.rdd.filter(line => !line.toString.contains("SECURITIES|"))
      .map(line => line.toString().split("\\|"))
      .map(line => Row(
        line(0), line(1),line(2),line(3),line(4),
        line(5),line(6),line(7),line(8)
      ))

    // Scame,这里先全部以 String 类型处理
    val schema: StructType = StructType(
      lines.head().split("\\|")
        .map(filed => StructField(filed, StringType, true))
    )

    // 生成DF
    val df = spark.createDataFrame(rdd, schema)

    // 注册为临时表
    val view = df.createOrReplaceTempView("rate")
    spark.sql("SELECT * FROM rate")
      .show(false)
  }
}

 988


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


