


👉 这是一个或许对你有用的社群
🐱 一对一交流/面试小册/简历优化/求职解惑,欢迎加入「芋道快速开发平台」知识星球。下面是星球提供的部分资料:
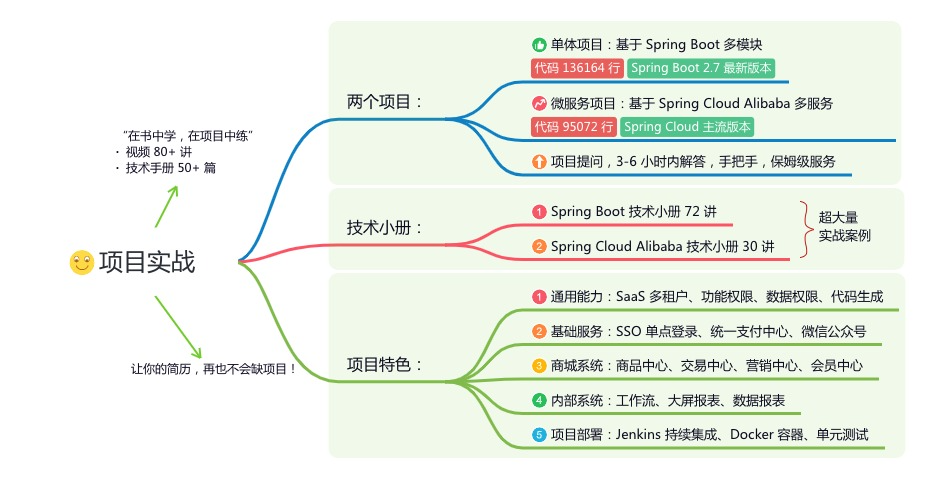
《项目实战(视频)》:从书中学,往事上“练”
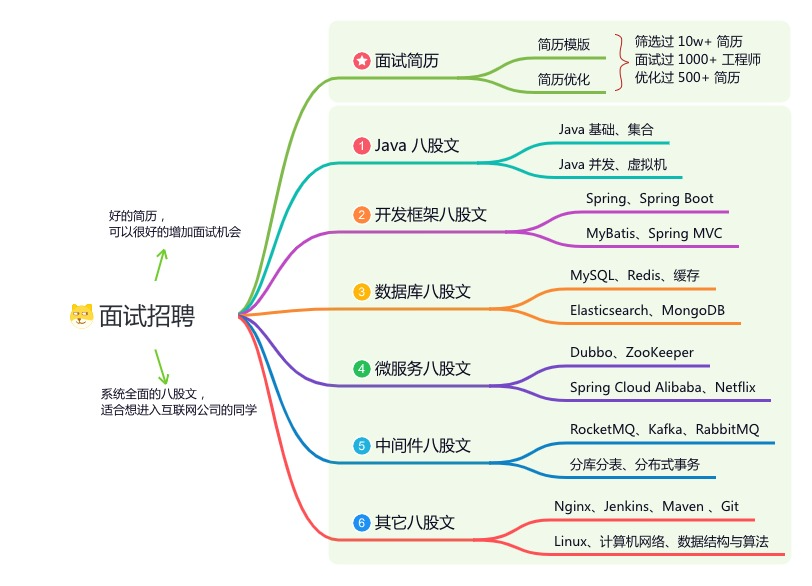
《互联网高频面试题》:面朝简历学习,春暖花开
《架构 x 系统设计》:摧枯拉朽,掌控面试高频场景题
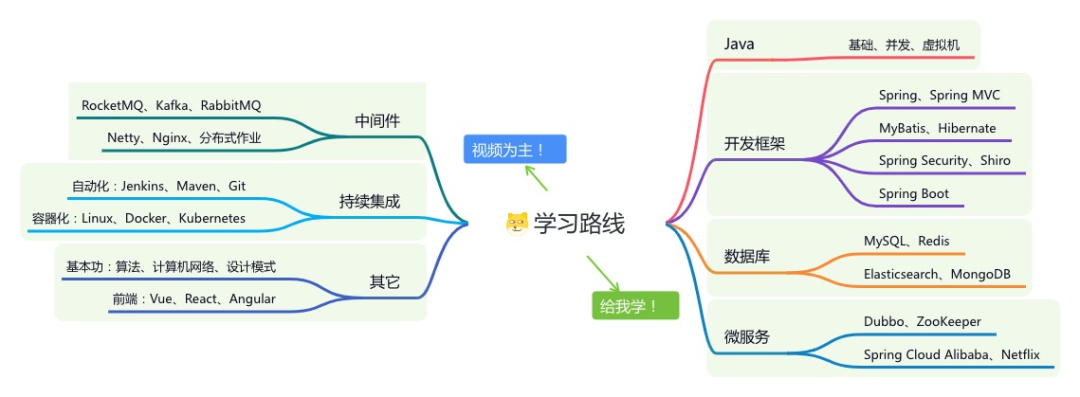
《精进 Java 学习指南》:系统学习,互联网主流技术栈
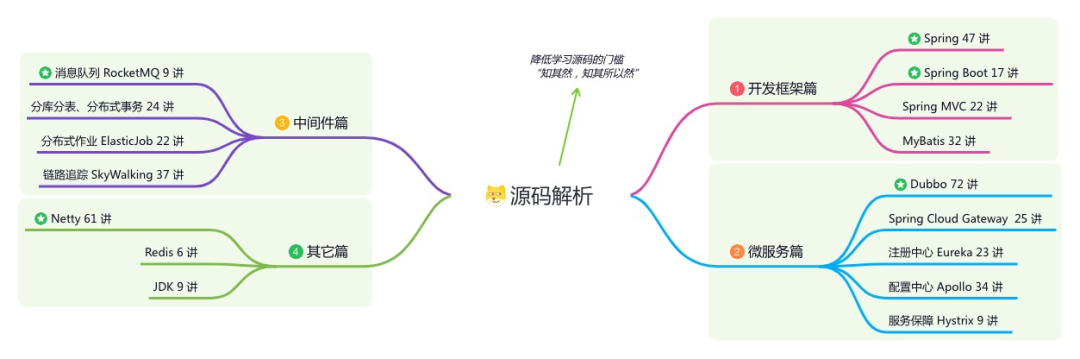
《必读 Java 源码专栏》:知其然,知其所以然
👉这是一个或许对你有用的开源项目
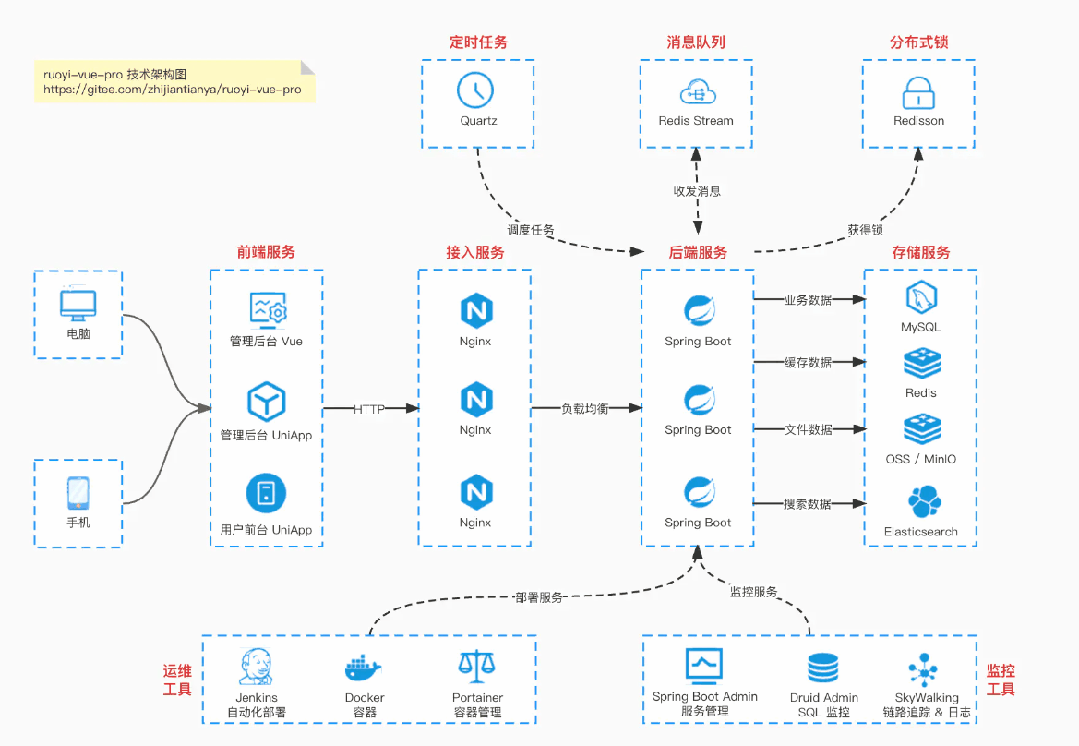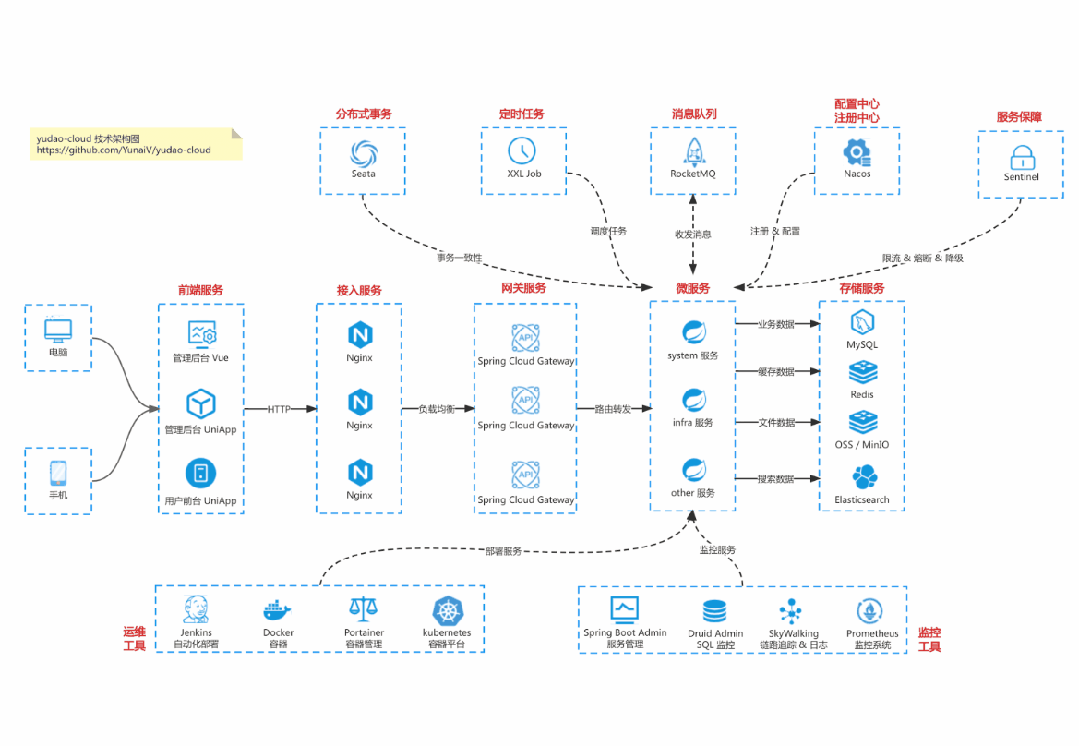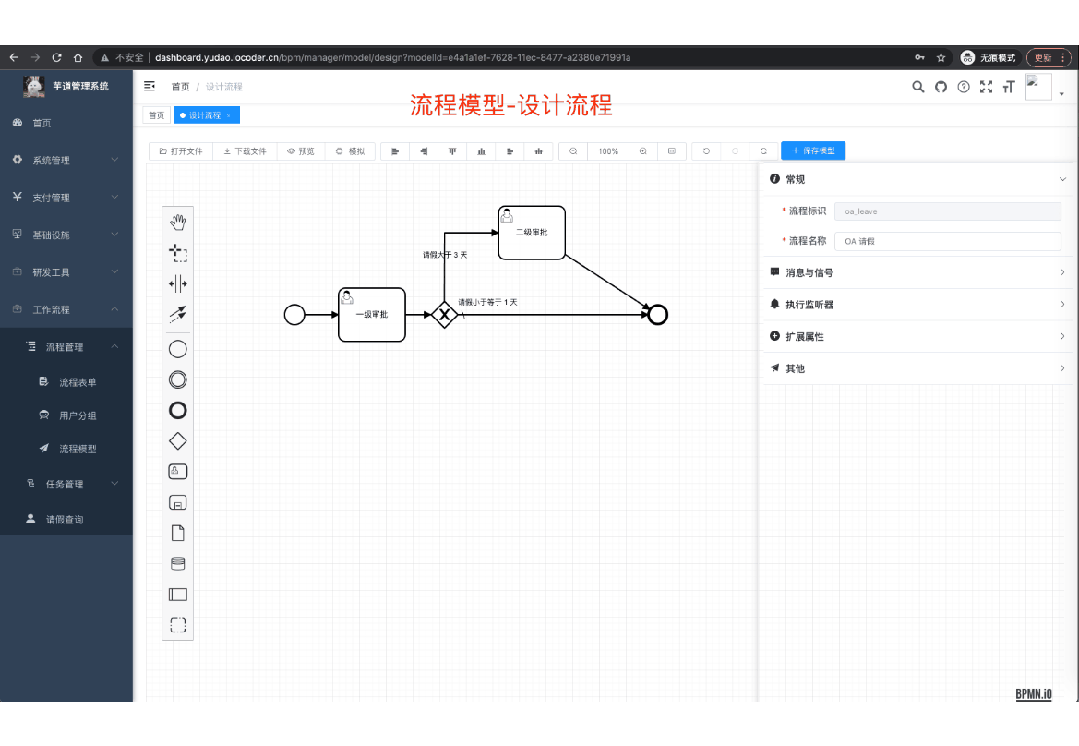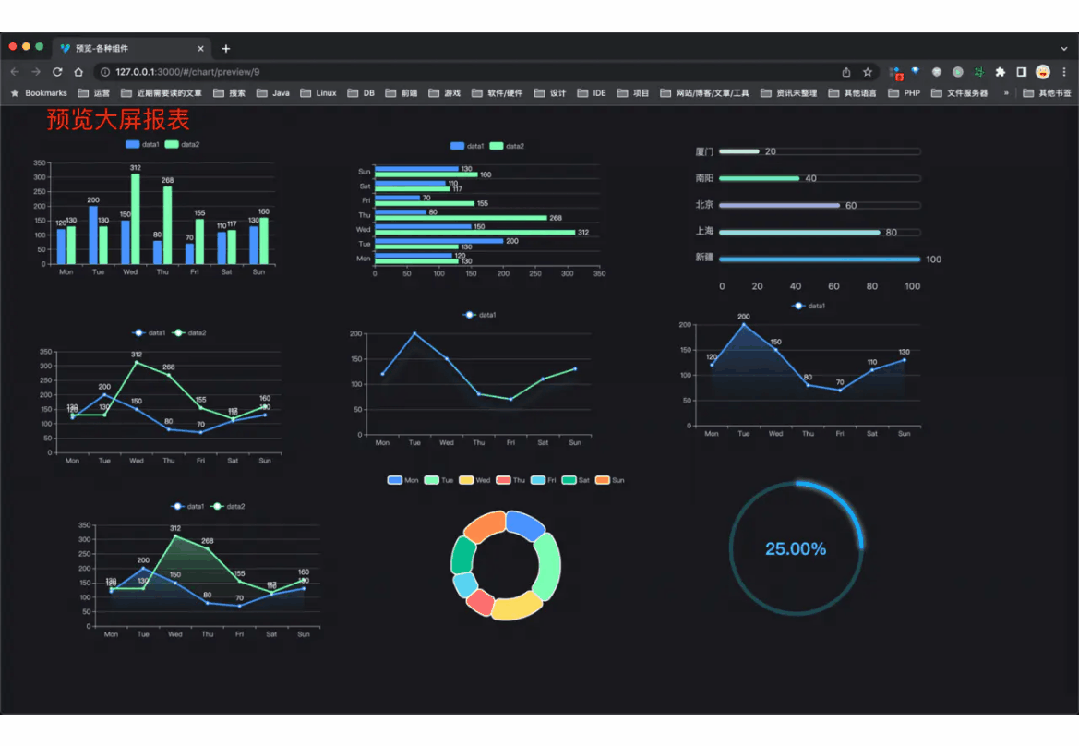
国产 Star 破 10w+ 的开源项目,前端包括管理后台 + 微信小程序,后端支持单体和微服务架构。
功能涵盖 RBAC 权限、SaaS 多租户、数据权限、商城、支付、工作流、大屏报表、微信公众号、CRM 等等功能:
Boot 仓库:https://gitee.com/zhijiantianya/ruoyi-vue-pro
Cloud 仓库:https://gitee.com/zhijiantianya/yudao-cloud
视频教程:https://doc.iocoder.cn
【国内首批】支持 JDK 21 + SpringBoot 3.2.2、JDK 8 + Spring Boot 2.7.18 双版本
来源:juejin.cn/post/
7146016771936354312
场景
当我们业务数据库表中的数据越来越多,如果你也和我遇到了以下类似场景,那让我们一起来解决这个问题
数据的插入,查询时长较长
后续业务需求的扩展 在表中新增字段 影响较大
表中的数据并不是所有的都为有效数据 需求只查询时间区间内的
基于 Spring Boot + MyBatis Plus + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
项目地址:https://github.com/YunaiV/ruoyi-vue-pro
视频教程:https://doc.iocoder.cn/video/
评估表数据体量
我们可以从表容量/磁盘空间/实例容量三方面评估数据体量,接下来让我们分别展开来看看
表容量
表容量主要从表的记录数、平均长度、增长量、读写量、总大小量进行评估。一般对于OLTP的表,建议单表不要超过2000W行数据量,总大小15G以内。访问量:单表读写量在1600/s以内
查询行数据的方式:我们一般查询表数据有多少数据时用到的经典sql语句如下:
select count(*) from table
select count(1) from table
但是当数据量过大的时候,这样的查询就可能会超时,所以我们要换一种查询方式
use 库名
show table status like '表名' ;
或:show table status like '表名'\G ;
上述方法不仅可以查询表的数据,还可以输出表的详细信息 , 加 \G 可以格式化输出。包括表名 存储引擎 版本 行数 每行的字节数等等,大家可以自行试一下哈
磁盘空间
查看指定数据库容量大小
select
table_schema as '数据库',
table_name as '表名',
table_rows as '记录数',
truncate(data_length/1024/1024, 2) as '数据容量(MB)',
truncate(index_length/1024/1024, 2) as '索引容量(MB)'
from information_schema.tables
order by data_length desc, index_length desc;
查询单个库中所有表磁盘占用大小
select
table_schema as '数据库',
table_name as '表名',
table_rows as '记录数',
truncate(data_length/1024/1024, 2) as '数据容量(MB)',
truncate(index_length/1024/1024, 2) as '索引容量(MB)'
from information_schema.tables
where table_schema='mysql'
order by data_length desc, index_length desc;
查询出的结果如下:

建议数据量占磁盘使用率的70%以内。同时,对于一些数据增长较快,可以考虑使用大的慢盘进行数据归档(归档可以参考方案三)
实例容量
MySQL是基于线程的服务模型,因此在一些并发较高的场景下,单实例并不能充分利用服务器的CPU资源,吞吐量反而会卡在mysql层,可以根据业务考虑自己的实例模式
基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
项目地址:https://github.com/YunaiV/yudao-cloud
视频教程:https://doc.iocoder.cn/video/
出现问题的原因
上面我们已经查到我们数据表的体量了 那么为什么单表数据量越大 业务的执行效率就越慢 根本原因是什么呢?
一个表的数据量达到好几千万或者上亿时,加索引的效果没那么明显啦。性能之所以会变差,是因为维护索引的B+树结构层级变得更高了,查询一条数据时,需要经历的磁盘IO变多,因此查询性能变慢。
❝
大家是否还记得,一个B+树大概可以存放多少数据量呢?
❞
InnoDB存储引擎最小储存单元是页,一页大小就是16k。
B+树叶子存的是数据,内部节点存的是键值+指针。索引组织表通过非叶子节点的二分查找法以及指针确定数据在哪个页中,进而再去数据页中找到需要的数据;
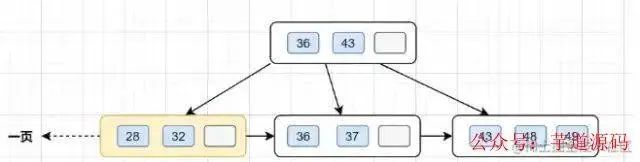
假设B+树的高度为2的话,即有一个根结点和若干个叶子结点。这棵B+树的存放总记录数为=根结点指针数*单个叶子节点记录行数。
如果一行记录的数据大小为1k,那么
单个叶子节点可以存的记录数 =16k/1k =16.非叶子节点内存放多少指针呢?我们假设主键ID为bigint类型,长度为8字节(面试官问你int类型,一个int就是32位,4字节),而指针大小在InnoDB源码中设置为6字节,所以就是
8+6=14字节,16k/14B =16*1024B/14B = 1170
因此,一棵高度为2的B+树,能存放1170 * 16=18720条这样的数据记录。同理一棵高度为3的B+树,能存放1170 *1170 *16 =21902400,也就是说,可以存放两千万左右的记录。B+树高度一般为1-3层,已经满足千万级别的数据存储。
如果B+树想存储更多的数据,那树结构层级就会更高,查询一条数据时,需要经历的磁盘IO变多,因此查询性能变慢。
如何解决单表数据量太大,查询变慢的问题
知道了根本原因之后,我们就需要考虑如何优化数据库来解决问题了
这里提供了三种解决方案,包括数据表分区,分库分表,冷热数据归档 了解完这些方案之后大家可以选取适合自己业务的方案
方案一:数据表分区
为什么要分区:表分区可以在区间内查询对应的数据,降低查询范围 并且索引分区 也可以进一步提高命中率,提升查询效率 分区是指将一个表的数据按照条件分布到不同的文件上面,未分区前都是存放在一个文件上面的,但是它还是指向的同一张表,只是把数据分散到了不同文件而已。
我们首先看一下分区有什么优缺点:
表分区有什么好处?
与单个磁盘或文件系统分区相比,可以存储更多的数据。
对于那些已经失去保存意义的数据,通常可以通过删除与那些数据有关的分区,很容易地删除那些数据。相反地,在某些情况下,添加新数据的过程又可以通过为那些新数据专门增加一个新的分区,来很方便地实现。
一些查询可以得到极大的优化,这主要是借助于满足一个给定
WHERE语句的数据可以只保存在一个或多个分区内,这样在查找时就不用查找其他剩余的分区。因为分区可以在创建了分区表后进行修改,所以在第一次配置分区方案时还不曾这么做时,可以重新组织数据,来提高那些常用查询的效率。涉及到例如
SUM()和COUNT()这样聚合函数的查询,可以很容易地进行并行处理。这种查询的一个简单例子如 “SELECT salesperson_id, COUNT (orders) as order_total FROM sales GROUP BY salesperson_id;”。通过“并行”,这意味着该查询可以在每个分区上同时进行,最终结果只需通过总计所有分区得到的结果。通过跨多个磁盘来分散数据查询,来获得更大的查询吞吐量。
表分区的限制因素
一个表最多只能有1024个分区。
MySQL5.1中,分区表达式必须是整数,或者返回整数的表达式。在MySQL5.5中提供了非整数表达式分区的支持。
如果分区字段中有主键或者唯一索引的列,那么多有主键列和唯一索引列都必须包含进来。即:分区字段要么不包含主键或者索引列,要么包含全部主键和索引列。
分区表中无法使用外键约束。
MySQL的分区适用于一个表的所有数据和索引,不能只对表数据分区而不对索引分区,也不能只对索引分区而不对表分区,也不能只对表的一部分数据分区。
在进行分区之前可以用如下方法 看下数据库表是否支持分区哈
mysql> show variables like '%partition%';
+-------------------+-------+
| Variable_name     | Value |
+-------------------+-------+
| have_partitioning | YES   |
+-------------------+-------+
1 row in set (0.00 sec)
方案二:数据库分表
为什么要分表:分表后,显而易见,单表数据量降低,树的高度变低,查询经历的磁盘io变少,则可以提高效率 mysql 分表分为两种 水平分表和垂直分表
分库分表就是为了解决由于数据量过大而导致数据库性能降低的问题,将原来独立的数据库拆分成若干数据库组成 ,将数据大表拆分成若干数据表组成,使得单一数据库、单一数据表的数据量变小,从而达到提升数据库性能的目的。
水平分表
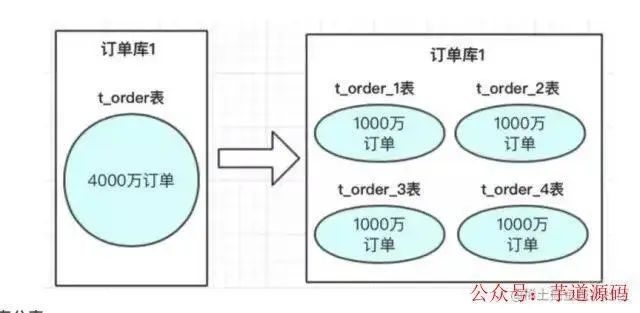
定义:数据表行的拆分,通俗点就是把数据按照某些规则拆分成多张表或者多个库来存放。分为库内分表和分库。
比如一个表有4000万数据,查询很慢,可以分到四个表,每个表有1000万数据
垂直分表
定义:列的拆分,根据表之间的相关性进行拆分。常见的就是一个表把不常用的字段和常用的字段就行拆分,然后利用主键关联。或者一个数据库里面有订单表和用户表,数据量都很大,进行垂直拆分,用户库存用户表的数据,订单库存订单表的数据
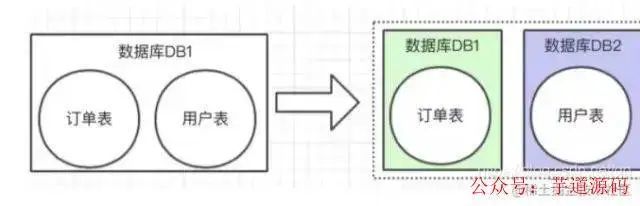
缺点:垂直分隔的缺点比较明显,数据不在一张表中,会增加join 或 union之类的操作
知道了两个知识后,我们来看一下分库分表的方案
1.取模方案:
拆分之前,先预估一下数据量。比如用户表有4000w数据,现在要把这些数据分到4个表user1 user2 uesr3 user4。
比如id = 17,17对4取模为1,加上 ,所以这条数据存到user2表。
❝
注意:进行水平拆分后的表要去掉
auto_increment自增长。这时候的id可以用一个id 自增长临时表获得,或者使用redis incr的方法。❞
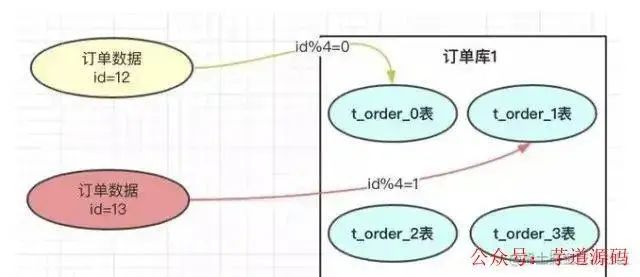
优点:数据均匀的分到各个表中,出现热点问题的概率很低。
缺点:以后的数据扩容迁移比较困难难,当数据量变大之后,以前分到4个表现在要分到8个表,取模的值就变了,需要重新进行数据迁移。
2.range 范围方案
以范围进行拆分数据,就是在某个范围内的订单,存放到某个表中。比如id=12存放到user1表,id=1300万的存放到user2 表。
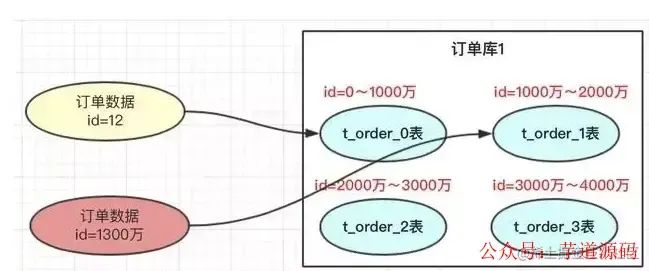
优点:有利于将来对数据的扩容
缺点:如果热点数据都存在一个表中,则压力都在一个表中,其他表没有压力。
❝
我们看到以上两种方案 都存在缺点 但是却又是互补的,那么我们将这两个方案结合会怎样呢?
❞
3.hash取模和range方案结合
如下图 我们可以看到 group 组存放id 为0~4000万的数据,然后有三个数据库 DB0 DB1 DB2,DB0里面有四个数据库,DB1 和DB2 有三个数据库
假如id为15000 然后对10取模(为啥对10 取模 因为有10个表),取0 然后 落在DB_0,然后在根据range 范围,落在Table_0 里面。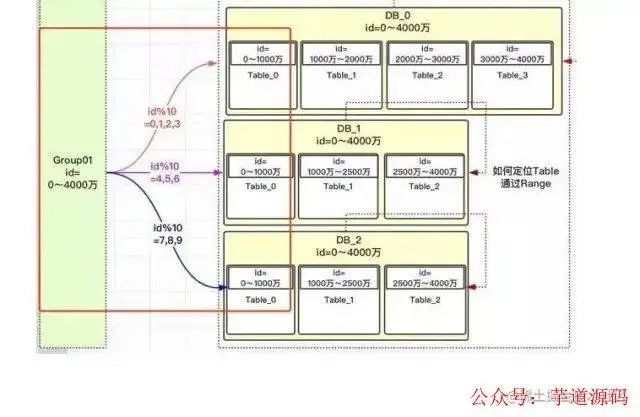 总结:采用hash取模和range方案结合 既可以避免热点数据的问题,也有利于将来对数据的扩容
我们已经了解了 mysql分区和分表的知识 那我们看一下这两个技术有何不同以及适用场景
分区分表的区别
1、实现方式上
mysql的分表是真正的分表,一张表分成很多表后,每一个小表都是完整的一张表,都对应三个文件,一个
.MYD数据文件,.MYI索引文件,.frm表结构分区不一样,一张大表进行分区后,他还是一张表,不会变成二张表,但是他存放数据的区块变多了。
2、提高性能上
分表重点是存取数据时,如何提高mysql并发能力上;
而分区呢,如何突破磁盘的读写能力,从而达到提高mysql性能的目的。
3、实现的难易度上
1、分表的方法有很多,用merge来分表,是最简单的一种方式。这种方式根分区难易度差不多,并且对程序代码来说可以做到透明的。如果是用其他分表方式就比分区麻烦了。
2、分区实现是比较简单的,建立分区表,根建平常的表没什么区别,并且对开代码端来说是透明的
分区分表的联系
1、都能提高mysql的性高,在高并发状态下都有一个良好的表现。
2、分表和分区不矛盾,可以相互配合的,对于那些大访问量,并且表数据比较多的表,我们可以采取分表和分区结合的方式,访问量不大,但是表数据很多的表,我们可以采取分区的方式等。
分库分表存在的问题
1、事务问题
在执行分库分表之后,由于数据存储到了不同的库上,数据库事务管理出现了困难。如果依赖数据库本身的分布式事务管理功能去执行事务,将付出高昂的性能代价;如果由应用程序去协助控制,形成程序逻辑上的事务,又会造成编程方面的负担。
2、跨库跨表的join问题
在执行了分库分表之后,难以避免会将原本逻辑关联性很强的数据划分到不同的表、不同的库上,这时,表的关联操作将受到限制,我们无法join位于不同分库的表,也无法join分表粒度不同的表,结果原本一次查询能够完成的业务,可能需要多次查询才能完成。
3、额外的数据管理负担和数据运算压力
额外的数据管理负担,最显而易见的就是数据的定位问题和数据的增删改查的重复执行问题,这些都可以通过应用程序解决,但必然引起额外的逻辑运算。
例如,对于一个记录用户成绩的用户数据表userTable,业务要求查出成绩最好的100位,在进行分表之前,只需一个order by语句就可以搞定,但是在进行分表之后,将需要n个order by语句,分别查出每一个分表的前100名用户数据,然后再对这些数据进行合并计算,才能得出结果。
方案三:冷热归档
为什么要冷热归档:其实原因和方案二类似,都是降低单表数据量,树的高度变低,查询经历的磁盘io变少,则可以提高效率 如果大家的业务数据,有明显的冷热区分,比如:只需要展示近一周或一个月的数据。那么这种情况这一周喝一个月的数据我们称之为热数据,其余数据为冷数据。那么我们可以将冷数据归档在其他的库表中,提高我们热数据的操作效率。
接下来讲一下归档的过程
创建归档表 创建的归档表 原则上要与原表保持一致
归档表数据的初始化
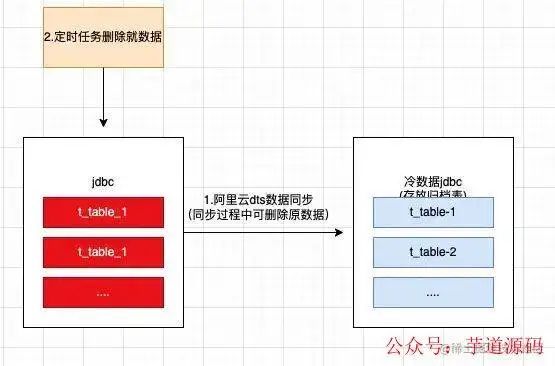
业务增量数据处理过程
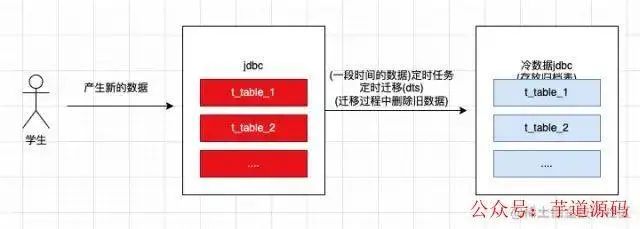
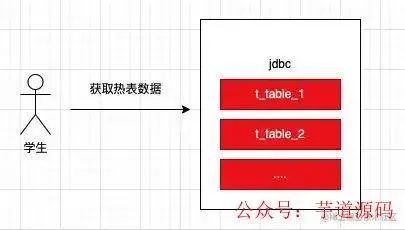
数据的获取过程
以上三种方案我们如何选型
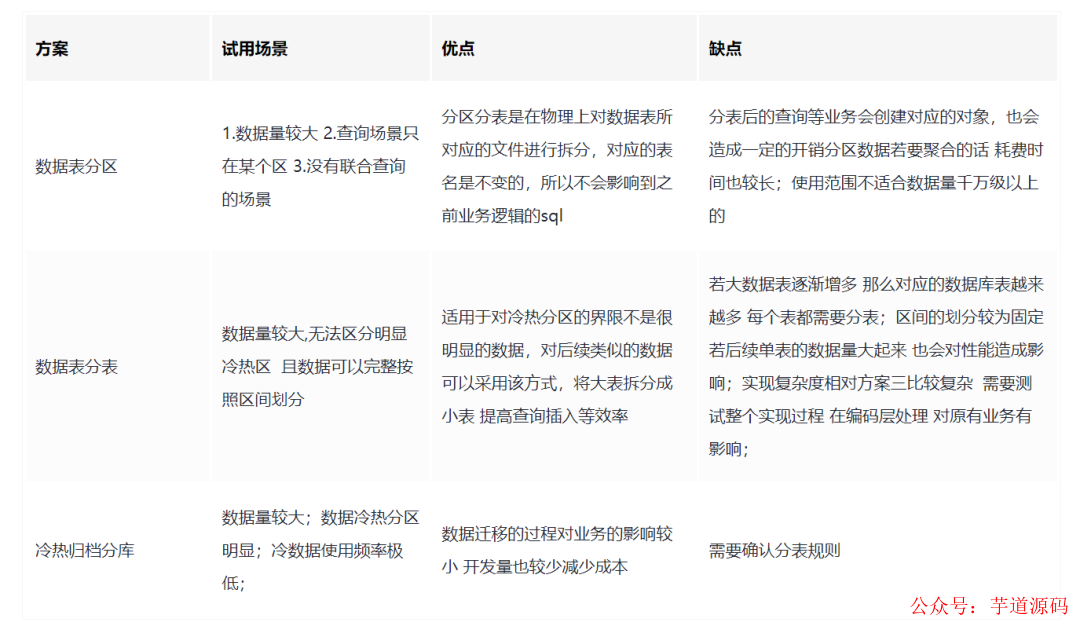
大家可以根据自己的业务场景,去选择合适自己业务的方案,我这边就给大家提供一下思路~
那么到了这里,我要讲的内容就差不多结束了,如果有什么不对的,或者有什么疑惑,欢迎大家指点!
欢迎加入我的知识星球,全面提升技术能力。
👉 加入方式,“长按”或“扫描”下方二维码噢:
星球的内容包括:项目实战、面试招聘、源码解析、学习路线。
文章有帮助的话,在看,转发吧。
谢谢支持哟 (*^__^*) 2672


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


