MQ消息积压,把公司系统整挂了!

MQ消息积压,把我整吐血了 我之前在一家餐饮公司待过两年,每天中午和晚上用餐高峰期,系统的并发量不容小觑。为了保险起见,公司规定各部门都要在吃饭的时间轮流值班,防止出现线上问题时能够及时处理。我当时在后厨显示系统团队,该系统属于订单的下游业务。用户点完菜下单后,订单系统会通过发kafka消息给我们系统,系统读取消息后,做业务逻辑处理,持久化订单和菜品数据,然后展示到划菜客户端。这样厨师就知道哪个订单要做哪些菜,有些菜做好了,就可以通过该系统出菜。 阅读详情

👉 这是一个或许对你有用的社群

🐱 一对一交流/面试小册/简历优化/求职解惑,欢迎加入「芋道快速开发平台」知识星球。下面是星球提供的部分资料: 

71d629141429042b539cadf1c6fb2517.gif

👉这是一个或许对你有用的开源项目

国产 Star 破 10w+ 的开源项目,前端包括管理后台 + 微信小程序,后端支持单体和微服务架构。

功能涵盖 RBAC 权限、SaaS 多租户、数据权限、商城、支付、工作流、大屏报表、微信公众号、CRM 等等功能:

  • Boot 仓库:https://gitee.com/zhijiantianya/ruoyi-vue-pro

  • Cloud 仓库:https://gitee.com/zhijiantianya/yudao-cloud

  • 视频教程:https://doc.iocoder.cn

【国内首批】支持 JDK 21 + SpringBoot 3.2.2、JDK 8 + Spring Boot 2.7.18 双版本 

来源:苏三说技术


前言

我之前在一家餐饮公司待过两年,每天中午和晚上用餐高峰期,系统的并发量不容小觑。为了保险起见,公司规定各部门都要在吃饭的时间轮流值班,防止出现线上问题时能够及时处理。

我当时在后厨显示系统团队,该系统属于订单的下游业务。

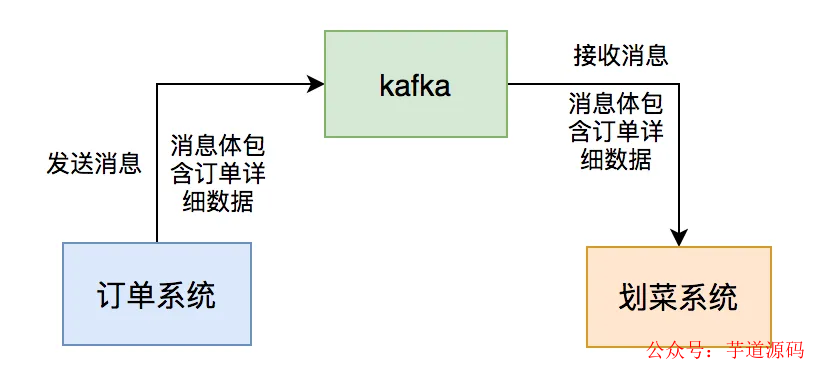
用户点完菜下单后,订单系统会通过发kafka消息给我们系统,系统读取消息后,做业务逻辑处理,持久化订单和菜品数据,然后展示到划菜客户端。

这样厨师就知道哪个订单要做哪些菜,有些菜做好了,就可以通过该系统出菜。系统自动通知服务员上菜,如果服务员上完菜,修改菜品上菜状态,用户就知道哪些菜已经上了,哪些还没有上。这个系统可以大大提高后厨到用户的效率。
b7b0d39e3ca55f0acb00b1e441e8d6bc.png

这一切的关键是消息中间件:kafka,如果它出现问题,将会直接影响到后厨显示系统的用户功能使用。

这篇文章跟大家一起聊聊,我们当时出现过的消息积压问题,希望对你会有所帮助。

基于 Spring Boot + MyBatis Plus + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能

  • 项目地址:https://github.com/YunaiV/ruoyi-vue-pro

  • 视频教程:https://doc.iocoder.cn/video/

1 第一次消息积压

刚开始我们的用户量比较少,上线一段时间,mq的消息通信都没啥问题。

随着用户量逐步增多,每个商家每天都会产生大量的订单数据,每个订单都有多个菜品,这样导致我们划菜系统的划菜表的数据越来越多。

在某一天中午,收到商家投诉说用户下单之后,在平板上出现的菜品列表有延迟。

厨房几分钟之后才能看到菜品。

我们马上开始查原因。

出现这种菜品延迟的问题,必定跟kafka有关,因此,我们先查看kafka。

果然出现了消息积压。

通常情况下,出现消息积压的原因有:

  1. mq消费者挂了。

  2. mq生产者生产消息的速度,大于mq消费者消费消息的速度。

我查了一下监控,发现我们的mq消费者,服务在正常运行,没有异常。

剩下的原因可能是:mq消费者消费消息的速度变慢了。

接下来,我查了一下划菜表,目前不太多只有几十万的数据。

看来需要优化mq消费者的处理逻辑了。

我在代码中增加了一些日志,把mq消息者中各个关键节点的耗时都打印出来了。

发现有两个地方耗时比较长:

  1. 有个代码是一个for循环中,一个个查询数据库处理数据的。

  2. 有个多条件查询数据的代码。

于是,我做了有针对性的优化。

将在for循环中一个个查询数据库的代码,改成通过参数集合,批量查询数据。

有时候,我们需要从指定的用户集合中,查询出有哪些是在数据库中已经存在的。

实现代码可以这样写:

public List<User> queryUser(List<User> searchList) {
    if (CollectionUtils.isEmpty(searchList)) {
        return Collections.emptyList();
    }

    List<User> result = Lists.newArrayList();
    searchList.forEach(user -> result.add(userMapper.getUserById(user.getId())));
    return result;
}

这里如果有50个用户,则需要循环50次,去查询数据库。我们都知道,每查询一次数据库,就是一次远程调用。

如果查询50次数据库,就有50次远程调用,这是非常耗时的操作。

那么,我们如何优化呢?

具体代码如下:

public List<User> queryUser(List<User> searchList) {
    if (CollectionUtils.isEmpty(searchList)) {
        return Collections.emptyList();
    }
    List<Long> ids = searchList.stream().map(User::getId).collect(Collectors.toList());
    return userMapper.getUserByIds(ids);
}

提供一个根据用户id集合批量查询用户的接口,只远程调用一次,就能查询出所有的数据。

多条件查询数据的地方,增加了一个联合索引,解决了问题。

这样优化之后, mq消费者处理消息的速度提升了很多,消息积压问题被解决了。

基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能

  • 项目地址:https://github.com/YunaiV/yudao-cloud

  • 视频教程:https://doc.iocoder.cn/video/

2 第二次消息积压

没想到,过了几个月之后,又开始出现消息积压的问题了。

但这次是偶尔会积压,大部分情况不会。

这几天消息的积压时间不长,对用户影响比较小,没有引起商家的投诉。

我查了一下划菜表的数据只有几百万。

但通过一些监控,和DBA每天发的慢查询邮件,自己发现了异常。

我发现有些sql语句,执行的where条件是一模一样的,只有条件后面的参数值不一样,导致该sql语句走的索引不一样。

比如:order_id=123走了索引a,而order_id=124走了索引b。

有张表查询的场景有很多,当时为了满足不同业务场景,加了多个联合索引。

MySQL会根据下面几个因素选择索引:

  1. 通过采样数据来估算需要扫描的行数,如果扫描的行数多那可能io次数会更多,对cpu的消耗也更大。

  2. 是否会使用临时表,如果使用临时表也会影响查询速度;

  3. 是否需要排序,如果需要排序则也会影响查询速度。

综合1、2、3以及其它的一些因素,MySql优化器会选出它自己认为最合适的索引。

MySQL优化器是通过采样来预估要扫描的行数的,所谓采样就是选择一些数据页来进行统计预估,这个会有一定的误差。

由于MVCC会有多个版本的数据页,比如删除一些数据,但是这些数据由于还在其它的事务中可能会被看到,索引不是真正的删除,这种情况也会导致统计不准确,从而影响优化器的判断。

上面这两个原因导致MySQL在执行SQL语句时,会选错索引。

明明使用索引a的时候,执行效率更高,但实际情况却使用了索引b。

为了解决MySQL选错索引的问题,我们使用了关键字force index,来强制查询sql走索引a。

这样优化之后,这次小范围的消息积压问题被解决了。

3 第三次消息积压

过了半年之后,在某个晚上6点多钟。

有几个商家投诉过来,说划菜系统有延迟,下单之后,几分钟才能看到菜品。

我查看了一下监控,发现kafka消息又出现了积压的情况。

查了一下MySQL的索引,该走的索引都走了,但数据查询还是有些慢。

此时,我再次查了一下划菜表,惊奇的发现,短短半年表中有3千万的数据了。

通常情况下,单表的数据太多,无论是查询,还是写入的性能,都会下降。

这次出现查询慢的原因是数据太多了。

为了解决这个问题,我们必须:

  1. 做分库分表

  2. 将历史数据备份

由于现阶段做分库分表的代价太大了,我们的商户数量还没有走到这一步。

因此,我们当时果断选择了将历史数据做备份的方案。

当时我跟产品和DBA讨论了一下,划菜表只保留最近30天的数据,超过几天的数据写入到历史表中。

这样优化之后,划菜表30天只会产生几百万的数据,对性能影响不大。

消息积压的问题被解决了。

4 第四次消息积压

通过上面这几次优化之后,很长一段时间,系统都没有出现消息积压的问题。

但在一年之后的某一天下午,又有一些商家投诉过来了。

此时,我查看公司邮箱,发现kafka消息积压的监控报警邮件一大堆。

但由于刚刚一直在开会,没有看到。

这次的时间点就有些特殊。

一般情况下,并发量大的时候,是中午或者晚上的用餐高峰期,而这次出现消息积压问题的时间是下午。

这就有点奇怪了。

刚开始查询这个问题一点头绪都没有。

我问了一下订单组的同事,下午有没有发版,或者执行什么功能?

因为我们的划菜系统,是他们的下游系统,跟他们有直接的关系。

某位同事说,他们半小时之前,执行了一个批量修改订单状态的job,一次性修改了几万个订单的状态。

而修改了订单状态,会自动发送mq消息。

这样导致,他们的程序在极短的时间内,产生了大量的mq消息。

而我们的mq消费者根本无法处理这些消息,所以才会产生消息积压的问题。

我们当时一起查了kafka消息的积压情况,发现当时积压了几十万条消息。

要想快速提升mq消费者的处理速度,我们当时想到了两个方案:

  1. 增加partion数量。

  2. 使用线程池处理消息。

但考虑到,当时消息已经积压到几个已有的partion中了,再新增partion意义不大。

于是,我们只能改造代码,使用线程池处理消息了。

为了开始消费积压的消息,我们将线程池的核心线程和最大线程数量调大到了50。

这两个参数是可以动态配置的。

这样调整之后,积压了几十万的mq消息,在20分钟左右被消费完了。

这次突然产生的消息积压问题被解决了。

解决完这次的问题之后,我们还是保留的线程池消费消息的逻辑,将核心线程数调到8,最大线程数调到10。

当后面出现消息积压问题,可以及时通过调整线程数量,先临时解决问题,而不会对用户造成太大的影响。

注意:使用线程池消费mq消息不是万能的。该方案也有一些弊端,它有消息顺序的问题,也可能会导致服务器的CPU使用率飙升。此外,如果在多线程中调用了第三方接口,可能会导致该第三方接口的压力太大,而直接挂掉。

总之,MQ的消息积压问题,不是一个简单的问题。

虽说产生的根本原因是:MQ生产者生产消息的速度,大于MQ消费者消费消息的速度,但产生的具体原因有多种。

我们在实际工作中,需要针对不同的业务场景,做不同的优化。

我们需要对MQ队列中的消息积压情况,进行监控和预警,至少能够及时发现问题。

没有最好的方案,只有最合适当前业务场景的方案。


欢迎加入我的知识星球,全面提升技术能力。

👉 加入方式,“长按”或“扫描”下方二维码噢:
18326f398f870be92af3ca2cec8df3de.png

星球的内容包括:项目实战、面试招聘、源码解析、学习路线。

2d54075305e8afc5d18f6ae35bf05d27.png

1365b06e21982be458232a9820767ad3.png838fc6ad437c540f58565a2817514865.png2ac47a4edadfd28649728cf671c8fd18.pngc60b6c51b3a2439b020e6fe5386b28bb.png

文章有帮助的话,在看,转发吧。
谢谢支持哟 (*^__^*)
【我想进大厂!】超全面试题总结.消息队列MQ篇 事务消息就是MQ提供的类似XA的分布式事务能⼒,通过事务消息可以达到分布式事务的最终⼀致性。半事务消息就是MQ收到了⽣产者的消息,但是没有收到⼆次确认,不能投递的消息。实现原理如下:1.⽣产者先发送⼀条半事务消息到MQ2.MQ收到消息后返回ack确认3.⽣产者开始执⾏本地事务4.如果事务执⾏成功发送commit到MQ,失败发送rollback5.如果MQ⻓时间未收到⽣产者的⼆次确认commit或者rollback,MQ对⽣产者发起消息回查6.⽣产者查询事务执⾏最终状态7. 阅读详情

相关推荐

从ARM转战TI DSP:手把手教你用CCS 10.1.1搭建F280049C的第一个工程(含CMD文件避坑指南)

本文详细介绍了从ARM开发转向TI DSP(TMS320F280049C)的完整流程,包括CCS 10.1.1开发环境配置、工程搭建、CMD文件避坑指南以及外设开发实战。特别针对ARM开发者常见的DSP特性差异问题提供了解决方案,帮助初学者快速入门DSP开发。

weixin_42536058的博客 373

mq消息积压中突然mq挂了或者mysql挂了怎么处理

在现代互联网应用架构中,消息队列(MQ)与关系型数据库(MySQL)是不可或缺的两大组件。消息队列用于解耦系统模块、平滑流量峰值;而MySQL则承担着数据持久化的重要职责。然而,当这两个关键组件之一甚至同时发生故障时,系统的稳定性和数据一致性将面临巨大挑战。本文将探讨在MQ消息积压中突然挂了,或者MySQL挂了,甚至两者同时挂了的情况下,如何进行有效的故障处理和恢复。

yjq125931902的博客 1503

从零到一:用CubeMX和485模块快速上手多摩川绝对式编码器(附清零操作详解)

本文详细介绍了如何使用STM32CubeMX和485模块快速上手多摩川绝对式编码器,包括硬件连接、STM32配置、协议解析及清零操作。通过具体的代码示例和调试技巧,帮助开发者高效实现编码器数据读取和清零功能,特别适合STM32单片机开发者参考。

weixin_30599769的博客 193

MQ消息丢失的可能原因与解决方案

当我们使用消息队列(MQ)作为分布式系统中的核心组件时,消息丢失是一个常见的问题。消息丢失可能导致数据不一致或功能故障,因此对于许多应用程序来说是不可接受的。本文将介绍几种常见的MQ消息丢失的原因,并提供相应的解决方案。

果酱 の 博客 8321

我的AI学习 ai维护工具之langfuse

as_type: Optional[Literal[‘generation’]] = None, # 将记录定义为 Observation (LLM 调用)transform_to_string: Optional[Callable[[Iterable], str]] = None # 将输出转为 string。要用LangFuse的云服务,首先要在LangFuse官网上注册,注册完后将页面拉倒最后,点免费的SignUp,API文档:https://api.reference.langfuse.com/

liubaobin的博客 4096

C++上机——2023年“信息与未来”小学生编程思维展示官方题解

本次活动前三题是“根据问题描述实现代码”类型的问题,题解和示例代码由人工智能GPT-4直接阅读题面后生成――只要熟悉C++的语法和基本的编程、调试,即可解决p1、p2、p3。后三题有一定的算法性,我们给出命题思路和一些可能的解法。注意:本题解是面向指导教师的;指导教师在讲解时可以根据学生掌握程度进行调整。

qq_39127687的博客 2297

浅尝消息队列(ActiveMQ)

消息队列使用

jzhuoyqing的博客 419

电源完整性必看!用SIwave提取PDN阻抗曲线的3个关键设置与常见报错解决

本文深入探讨了在SIwave中进行电源完整性(PI)仿真时,提取PDN阻抗曲线的三个核心设置要点。重点解析了端口阻抗设为0.1欧姆的物理意义与SYZ参数仿真中的阻抗匹配原则,并提供了针对常见收敛性问题和模型误差的实战排查思路,旨在帮助工程师获得更精确可靠的仿真结果,为去耦电容优化提供依据。

b9c0d的博客 353

小项目不想引入 MQ?试试 Debezium!

这么多技术框架,为什么选debezium?看起来很多。但一一排除下来就debezium和canal。sqoop,kettle,datax之类的工具,属于前大数据时代的产物,地位类似于web领域的structs2。而且,它们基于查询而非binlog日志,其实不属于CDC。首先排除。flink cdc是大数据领域的框架,一般web项目的数据量属于大材小用了。同时databus,maxwell相对比较冷门,用得比较少。最后不用canal的原因有以下几点。

Java技术栈,分享最主流的Java技术 949

《QGIS快速入门与应用基础》209:重叠标注处理(移除/偏移)

系统讲解了QGIS中处理标注重叠问题的核心方法与实操流程。文章首先阐述了重叠标注处理的底层逻辑,即 先预防、再调整、后兜底 的递进式策略,并详细介绍了设置入口与界面布局。重点讲解了偏移处理这一首选方案,包括基础方向设置、最大偏移距离与步长配置、以及自动换行等进阶优化规则。针对不同要素类型(点、线、面)提供了行业规范的偏移方向设置建议,并给出从稀疏到密集场景的完整参数推荐值。最后以城市POI点图层为例,演示了5步偏移设置流程,帮助用户实现 无重叠、无压盖、重点突出 的专业标注效果。

LuckyHanMo的博客 672

Android Telephony主要模块及功能

Telephony的代码主要由五个模块组成 1.Telephony Frameworks 代码区域: frameworks/opt/telephony/ 其中主要的文件在如下目录 /frameworks/opt/telephony/src/java/com/android/internal/telephony/ 其中比较常见的有以下几类文件 1.BaseCommands、RIL构成R

泊客 7729

rabbitmq服务器进程突然挂掉问题

相关错误: /var/log/rabbitmq/startup_err错误日志 Crash dump was written to: erl_crash.dump eheap_alloc: Cannot allocate 762886488 bytes of memory (of type “heap”). Aborted (core dumped) celery-rank错误日志 [2019-0...

u012146058的博客 1万+

基于FPGA的最大功率点跟踪(MPPT)系统开发 - MATLAB实现

最大功率点跟踪(Maximum Power Point Tracking,MPPT)是太阳能光伏系统中的重要技术,它通过调整太阳能电池板的工作点,以最大化输出功率。通过FPGA系统设计和硬件验证,我们可以实现太阳能光伏系统中的最大功率点跟踪。这种基于FPGA的MPPT系统具有高性能和灵活性,适用于太阳能光伏系统中的实时最大功率点跟踪。MPPT算法的选择对于系统的性能至关重要。在本文中,我们选择使用Perturb and Observe(P&O)算法,它是一种常用的基于光伏阵列电压和电流测量的迭代算法。

CoderExtra的博客 387

【夯实RabbitMQ】MQ消息积压问题如何解决?

目录 一、MQ消息积压问题 二、解决方案 一、MQ消息积压问题 产生原因有可能是 消费端宕机 消费端消费能力不足 生产端发送流量过大 二、解决方案 方案一:通常的解决方案就是增加消费端实例。说白了就是增加机器。如果出现线上事故,能申请多少机器就申请多少机器,争取在最短的时间内消费掉积压在MQ中的消息。 方案二:如果申请机器行不通,毕竟公司的机器是有限的,此时可以增加消费端的消费能力。在MQ的配置中配置"最大消费者数量"与"每次从队列中获取的消......

大宇的博客,欢迎访问 2万+

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

消息中间件MQ与RabbitMQ面试题(2020最新版)

文章目录为什么使用MQ?MQ的优点消息队列有什么优缺点?RabbitMQ有什么优缺点?你们公司生产环境用的是什么消息中间件?Kafka、ActiveMQ、RabbitMQ、RocketMQ 有什么优缺点?MQ 有哪些常见问题?如何解决这些问题?什么是RabbitMQ?rabbitmq 的使用场景RabbitMQ基本概念RabbitMQ的工作模式如何保证RabbitMQ消息的顺序性?消息如何分发?消...

ThinkWon的博客 28万+

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

MQ 消息积压怎么办?如何实现零业务损失?五步应急方案避免业务雪崩

消息积压治理的本质是资源与需求的动态平衡艺术事前预防:通过容量规划、代码优化和压力测试构建第一道防线优化生产发送模式合理设置分区数量设计弹性消费架构事中监控:建立全链路监控和智能预警系统实时跟踪生产/消费速率比设置多级积压阈值告警可视化关键性能指标事后应急:制定分级响应预案轻度积压:动态扩容消费者中度积压:限流+降级非核心真正的消息专家不是让系统永不积压,而是当洪水来袭时,能在业务感知前完成疏导。

m0_73735578的博客 825

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

MQ消息队列详解以及MQ重复消费问题

现有ABCDE五个系统,最初的时候BCD三个系统都要调用A系统的接口获取数据,一切都很正常,但是突然,D系统说:我不要了,你不用给我传数据了,A系统无奈,只能修改代码,将调用D系统的代码删除,这时候还没删除呢,E系统发送了请求,但是A系统这时候还没处理完D系统的请求,A系统卒!看下图↓↓↓↓↓↓↓↓↓↓↓。用户发送请求到A系统耗时3ms,A系统发送三条消息到MQ,假如耗时5ms,用户从发送请求到相应3ms+5ms=8ms,仅用了8ms,用户的体验非常好。详情如下图↓↓↓↓↓↓。

python全栈 2378

20240711每日消息队列-------------MQ消息的积压的折磨

MQ积压,没有完美的解决方案,只有最适合当前业务场景的解决方案。

weixin_42678822的博客 1333

消息中间件MQ

RabbitMQ是一款开源的,Erlang编写的,基于AMQP协议的消息中间件。

sinat_42610038的博客 878

MQ消息队列详解

记录学习过程

毛豆的博客 7487

字节面试:如何解决MQ消息积压问题?

面试题大全:www.javacn.siteMQ(Message Queue)消息积压问题指的是在消息队列中累积了大量未处理的消息,导致消息队列中的消息积压严重,超出系统处理能力,影响系统性能和稳定性的现象。1.消息积压是哪个环节的问题?MQ 执行有三大阶段:消息生产阶段。消息存储阶段。消息消费阶段。很显然,消息堆积是出现在第三个消息消费阶段的。2.如何解决?消息积压问题的处理取决于消息积压的类型,...

磊哥聊Java 828

MQ-如何保证消息不丢不重

如何保证消息不丢不重

Younger 1754
上一篇: 代码质量一塌糊涂,特么离职了,新来的人都不知道从哪里看起...
下一篇: SpringBoot 如何做到无感刷新token?
公众号-芋道源码
博客等级 码龄10年 1636粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值