图解 SQL 的执行顺序,一目了然!

图解 SQL 执行顺序 这是一条标准的查询语句:比如写了一个SQL语句,那么它的关键字顺序和执行顺序是下面这样的:在SELECT语句执行这些步骤的时候,每个步骤都会产生一个虚拟表,然后将这个虚拟表传入下一个步骤中作为输入。需要注意的是,这些步骤隐含在SQL的执行过程中,对于我们来说是不可见的。 阅读详情

👉 这是一个或许对你有用的社群

🐱 一对一交流/面试小册/简历优化/求职解惑,欢迎加入「芋道快速开发平台」知识星球。下面是星球提供的部分资料: 

603993d4aaa3c544b616158328e8f890.gif

👉这是一个或许对你有用的开源项目

国产 Star 破 10w+ 的开源项目,前端包括管理后台 + 微信小程序,后端支持单体和微服务架构。

功能涵盖 RBAC 权限、SaaS 多租户、数据权限、商城、支付、工作流、大屏报表、微信公众号等等功能:

  • Boot 地址:https://gitee.com/zhijiantianya/ruoyi-vue-pro

  • Cloud 地址:https://gitee.com/zhijiantianya/yudao-cloud

  • 视频教程:https://doc.iocoder.cn

来源:blog.youkuaiyun.com/weixin_44141495
/article/details/108744720/


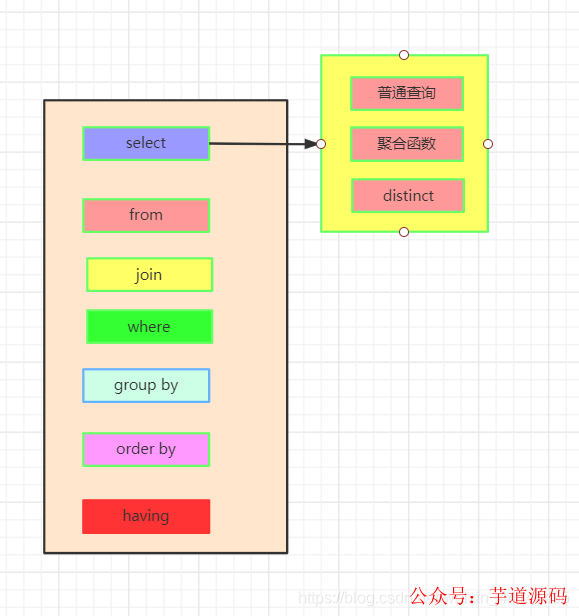
这是一条标准的查询语句:
fbb2fcfecac289b3431866ef9c726396.png

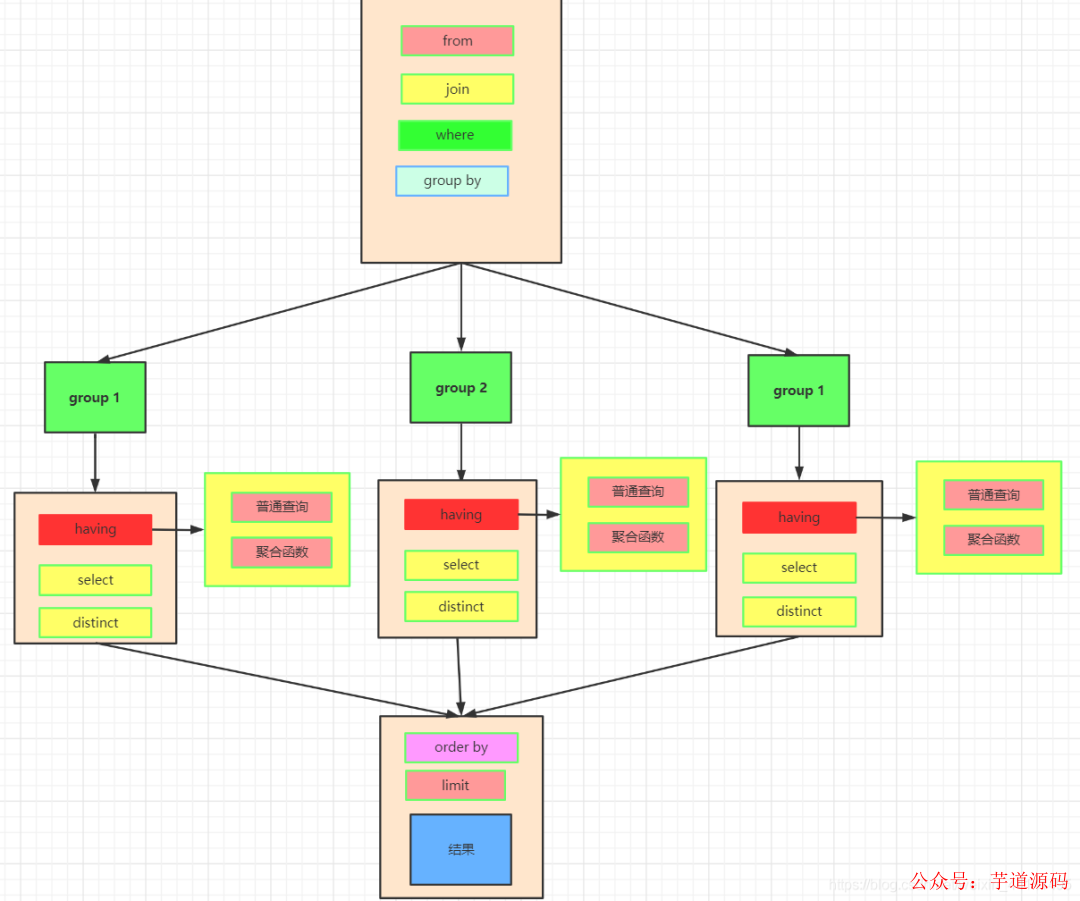
这是我们实际上SQL执行顺序:

  • 我们先执行from,join来确定表之间的连接关系,得到初步的数据

  • where对数据进行普通的初步的筛选

  • group by 分组

  • 各组分别执行having中的普通筛选或者聚合函数筛选。

  • 然后把再根据我们要的数据进行select,可以是普通字段查询也可以是获取聚合函数的查询结果,如果是集合函数,select的查询结果会新增一条字段

  • 将查询结果去重distinct

  • 最后合并各组的查询结果,按照order by的条件进行排序

dbfb44486b323368779540aa8f75aaaa.png

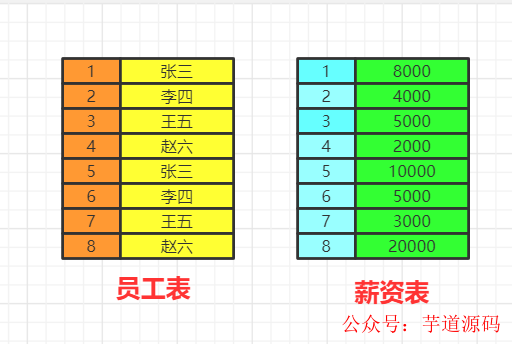
数据的关联过程

数据库中的两张表

7bdbba560344a06fbd78e2e1d69efab2.png

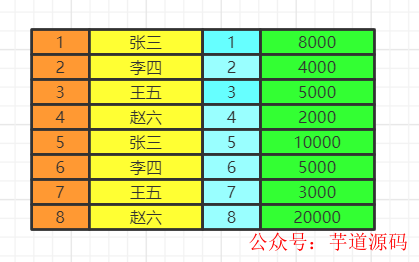
from&join&where

用于确定我们要查询的表的范围,涉及哪些表。

选择一张表,然后用join连接

from table1 join table2 on table1.id=table2.id

选择多张表,用where做关联条件

from table1,table2 where table1.id=table2.id

我们会得到满足关联条件的两张表的数据,不加关联条件会出现笛卡尔积。

d2d12075eba8331ff0bcceb24b923b08.png

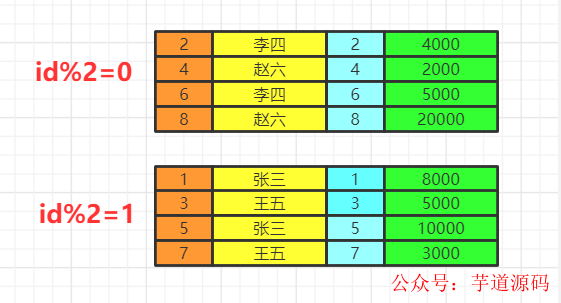
group by

按照我们的分组条件,将数据进行分组,但是不会筛选数据。

比如我们按照即id的奇偶分组
952e9a728df82c387c99cd48f2d29960.png

having&where

having中可以是普通条件的筛选,也能是聚合函数。而where只能是普通函数,一般情况下,有having可以不写where,把where的筛选放在having里,SQL语句看上去更丝滑。

使用where再group by

先把不满足where条件的数据删除,再去分组

使用group by再having

先分组再删除不满足having条件的数据,这两种方法有区别吗,几乎没有!

举个例子:

100/2=50,此时我们把100拆分(10+10+10+10+10…)/2=5+5+5+…+5=50,只要筛选条件没变,即便是分组了也得满足筛选条件,所以where后group by 和group by再having是不影响结果的!

不同的是,having语法支持聚合函数,其实having的意思就是针对每组的条件进行筛选。我们之前看到了普通的筛选条件是不影响的,但是having还支持聚合函数,这是where无法实现的。

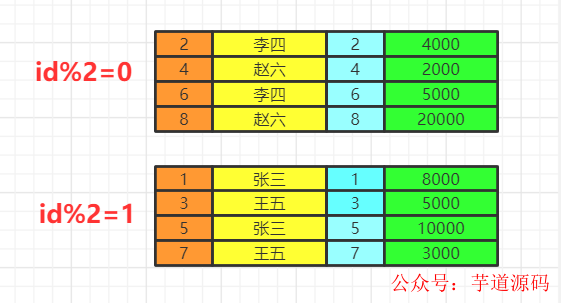
当前数据分组情况
2a34db6620b4cbcb2837f0a9360c46e3.png

执行having的筛选条件,可以使用聚合函数。筛选掉工资小于各组平均工资的having salary<avg(salary)
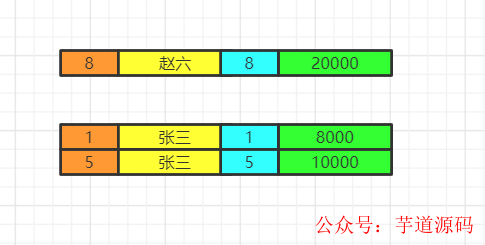
daa5d147d7bc75dcb7645e45631ca116.png

select

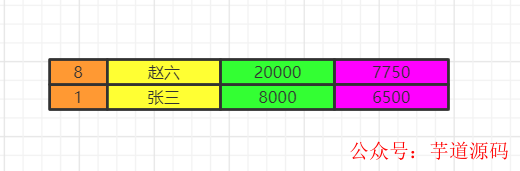
分组结束之后,我们再执行select语句,因为聚合函数是依赖于分组的,聚合函数会单独新增一个查询出来的字段,这里用紫色表示,这里我们两个id重复了,我们就保留一个id,重复字段名需要指向来自哪张表,否则会出现唯一性问题。最后按照用户名去重。

select employee.id,distinct name,salary, avg(salary)
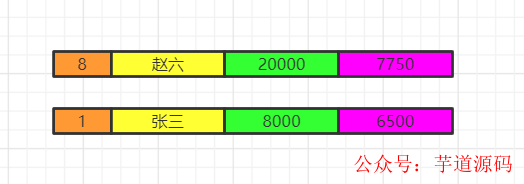
c08f49621a9770a60aa9f0904a862d05.png

将各组having之后的数据再合并数据。

d3766addda3f4ab80057c6f56e017e69.png

order by

最后我们执行order by 将数据按照一定顺序排序,比如这里按照id排序。如果此时有limit那么查询到相应的我们需要的记录数时,就不继续往下查了。
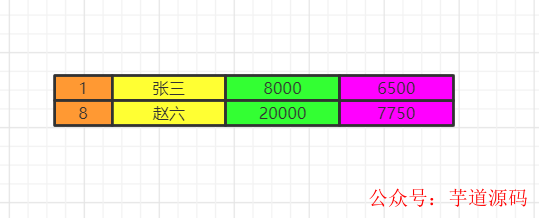
86948ec5b9f0980eacd74d6c4ddcabb7.png

limit

记住limit是最后查询的,为什么呢?假如我们要查询年级最小的三个数据,如果在排序之前就截取到3个数据。实际上查询出来的不是最小的三个数据而是前三个数据了,记住这一点。

我们如果limit 0,3窃取前三个数据再排序,实际上最少工资的是2000,3000,4000。你这里只能是4000,5000,8000了。
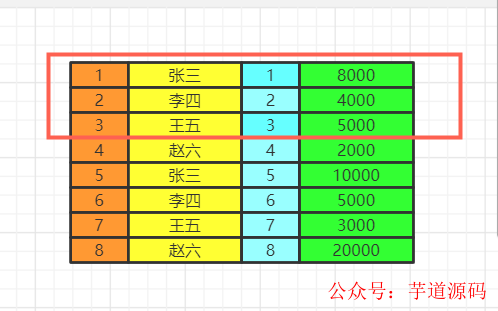
cea5673735731b0bfad496af1f989b44.png

欢迎加入我的知识星球,全面提升技术能力。

👉 加入方式,“长按”或“扫描”下方二维码噢:
702a5cfcdb6f3f5378a18c92a1fb8528.png

星球的内容包括:项目实战、面试招聘、源码解析、学习路线。

2f65493cdd3ccf28342a94431d94b25e.png

e5ccaed0c4f7ee08b5a6c27d294a4ab6.png9f13d013a97d27324c82fd8a4ebc7784.png67f187603313ae7b4f83f52c54e8f2ae.png00bfcaae621c581b685cd11186d7df21.png

文章有帮助的话,在看,转发吧。
谢谢支持哟 (*^__^*)
芋道源码 商城模块 数据库 sql文件 yudaosql-mall.sql 芋道源码 商城模块 数据库 sql文件,放心下载。已自用。 立即下载

相关推荐

若依芋道源码文档加sql 拒绝任何人割韭菜

免费免费免费免费免费免费免费免费免费免费看不惯恶心的人

免费获取芋道源码ruoyi-vue-pro和yudao-cloud的sql脚本,持续更新!

ruoyi-vue-pro和yudao-cloud都属于芋道源码,但用过的人都知道,这两个开源项目下有商城、ERP、CRM等模块,这些模块的SQL需要加入芋道源码的知识星球才能获取,加入费用为199元,有点小贵!芋道源码的ruoyi-vue-pro和yudao-cloud都已经发布到GoldPanKit上,通过GoldPanKit构建项目不仅可以免费获取到SQL,还能选配功能模块,调整包名,自动配置数据库。

Caesar's blog 1万+

2025芋道源码-BPM工作流模块-初始化sql语句-mysql版本

芋道源码是一个开源项目,它提供了基于工作流管理系统(BPM)的解决方案。工作流是业务流程管理中的核心概念,它定义了在企业运营中为了完成某一特定业务目标所必须的步骤、规则和角色。工作流管理系统则是一种软件工具,它通过自动化和监控业务流程来确保这些流程的顺利执行,从而提升效率和减少错误。 在这个特定的文件中,我们关注的是"初始化sql语句-mysql版本",这部分代码涉及到了在使用MySQL数据库时,如何初始化BPM工作流模块所需的数据库结构。初始化过程涉及到创建和配置数据库表,这些表通常是用来存储工作流的定义、任务、流程实例、历史记录和其他相关数据的。 根据提供的描述,这份初始化sql语句是针对使用最新jdk17版本代码的系统。JDK17是Java平台的开发工具包,它为Java应用程序提供运行环境。这表明芋道源码BPM工作流模块被设计为与较新的Java环境兼容,这意味着它能够利用最新的Java特性和性能提升。 文件中的biz_bpm.sql是压缩包中的唯一文件,它显然是一个SQL脚本文件。SQL(Structured Query Language)是一种用于管理和操作关系数据库的标准编程语言。该脚本文件包含了用于创建和初始化芋道源码BPM工作流模块所需数据库表的SQL命令。 具体而言,该文件可能包含创建表的语句,如"CREATE TABLE",以及为这些表插入初始数据的语句,如"INSERT INTO"。这些表可能包括任务表、用户表、角色表、工作流定义表等。它们共同构成了BPM工作流模块的基础数据结构。 这些表的创建和初始化是部署工作流管理系统时不可或缺的步骤。数据库表的设计对系统的性能和可扩展性至关重要。在设计这些表时,需要考虑到数据的一致性、完整性和优化查询性能等因素。 芋道源码BPM工作流模块的初始化sql语句是为在MySQL数据库中配置工作流管理系统而准备

芋道源码(含全部SQL文件)springboot2版本已同步至最新版本v2.6.0

芋道源码SpringBoot 2.6.0版本已更新,包含用户贡献的最新SQL文件。通过金镐技术社区KIT平台可获取源码:1)访问站点选择工厂源码;2)填写参数构建基础版本;3)可选装商城/CRM等插件模块。构建完成后按说明初始化数据库即可启动。推荐使用KIT客户端批量执行SQL脚本,另有轻量级开源后台系统EVA可供选择。(149字)

Caesar's blog 6290

芋道源码-BPM工作流模块-初始化sql语句-mysql版本

芋道源码是一个开源项目,它提供了基于工作流管理系统(BPM)的解决方案。工作流是业务流程管理中的核心概念,它定义了在企业运营中为了完成某一特定业务目标所必须的步骤、规则和角色。工作流管理系统则是一种软件工具,它通过自动化和监控业务流程来确保这些流程的顺利执行,从而提升效率和减少错误。 在这个特定的文件中,我们关注的是"初始化sql语句-mysql版本",这部分代码涉及到了在使用MySQL数据库时,如何初始化BPM工作流模块所需的数据库结构。初始化过程涉及到创建和配置数据库表,这些表通常是用来存储工作流的定义、任务、流程实例、历史记录和其他相关数据的。 根据提供的描述,这份初始化sql语句是针对使用最新jdk17版本代码的系统。JDK17是Java平台的开发工具包,它为Java应用程序提供运行环境。这表明芋道源码BPM工作流模块被设计为与较新的Java环境兼容,这意味着它能够利用最新的Java特性和性能提升。 文件中的biz_bpm.sql是压缩包中的唯一文件,它显然是一个SQL脚本文件。SQL(Structured Query Language)是一种用于管理和操作关系数据库的标准编程语言。该脚本文件包含了用于创建和初始化芋道源码BPM工作流模块所需数据库表的SQL命令。 具体而言,该文件可能包含创建表的语句,如"CREATE TABLE",以及为这些表插入初始数据的语句,如"INSERT INTO"。这些表可能包括任务表、用户表、角色表、工作流定义表等。它们共同构成了BPM工作流模块的基础数据结构。 这些表的创建和初始化是部署工作流管理系统时不可或缺的步骤。数据库表的设计对系统的性能和可扩展性至关重要。在设计这些表时,需要考虑到数据的一致性、完整性和优化查询性能等因素。 芋道源码BPM工作流模块的初始化sql语句是为在MySQL数据库中配置工作流管理系统而准备的。它适用于在jdk17环境下开发的应用程序,该系统通过一系列的数据库表来管理工作流相关的数据,其中包括了8张表。开发者在部署时需要运行biz_bpm.sql脚本以完成数据库的初始化工作

张量分解浅谈(四 Tucker 分解)

学完了SVD算法之后,我们继续回到张量几大分解的学习上来,本期学习的主要内容是张量的 Tucker 分解 以及 前面的CP分解还留下一点没有说完,正好一并补齐!后面的公式我将采用颜色标记,红色代表必须掌握,蓝色尽量掌握! 在这之前先附一张图,包含了各种运算符号的名称含义,大部分是前面说过或者使用过的: Tensor decomposition一 . Tucker 分解公式介绍和原理二 . 张量的 n-Rank 一 . Tucker 分解公式介绍和原理 我们先来看一张被使用过很多次的Trucker 分解图

欢迎来到 豪哥 的博客 1万+

面试难题:深度图解 SQL 执行顺序,一目了然!

因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享点击关注#互联网架构师公众号,领取架构师全套资料 都在这里0、2T架构师学习资料干货分上一篇:2T架构师学习资料干货分享大家好,我是互联网架构师!这是一条标准的查询语句:这是我们实际上SQL执行顺序:我们先执行from,join来确定表之间的连接关系,得到初步的数据where对数据进行普通的初步的筛选group by 分组各组分...

emprere的博客 189

Python+Flask+Echarts打造全国气象数据可视化分析大屏

本文详细介绍了如何使用Python+Flask+Echarts构建全国气象数据可视化分析大屏,实现实时监控、趋势分析和快速决策。通过Python强大的数据处理能力、Flask的轻量级优势和Echarts的交互体验,打造高效的气象数据可视化系统,提升农业、物流等行业的决策效率。

weixin_29061531的博客 1061

SQL 执行顺序图解

SQL 执行顺序图解

Boy_Martin的博客 1667

Anaconda 2026.07 安装配置完全指南:从下载到PyCharm整合

Python 环境管理一直是开发者绕不开的课题,而 Anaconda 作为集成了 conda 与 300+ 科学计算包的发行版,极大降低了环境配置门槛。其核心价值在于通过虚拟环境实现不同项目的依赖隔离,避免版本冲突。但在实际安装与配置过程中,用户常因版本差异、镜像源访问慢、与 IDE 集成不畅等问题陷入困境。本文以 Anaconda 2026.07 为例,系统讲解从官方渠道或国内镜像源下载、安全校验、安装选项分析、conda 命令初始化,到配置清华镜像源、创建指定 Python 版本的虚拟环境,再到与 Py

weixin_32520095的博客 420

记录LeNet的硬件加速器设计(一)

LeNet的硬件加速器设计实现。

2301_81029398的博客 3546

【最全最详细】图解 SQL 的执行顺序

分组结束之后,我们再执行select语句,因为聚合函数是依赖于分组的,聚合函数会单独新增一个查询出来的字段,这里用紫色表示,这里我们两个id重复了,我们就保留一个id,重复字段名需要指向来自哪张表,否则会出现唯一性问题。我们之前看到了普通的筛选条件是不影响的,但是having还支持聚合函数,这是where无法实现的。然后把再根据我们要的数据进行select,可以是普通字段查询也可以是获取聚合函数的查询结果,如果是集合函数,select的查询结果会新增一条字段。用于确定我们要查询的表的范围,涉及哪些表。

wufaqidong1的博客 5877

CAN XL和10Base-T1S全对比:在区域架构中如何选择最适合的车载通信协议?

本文深入对比了CAN XL和10Base-T1S在车载网络架构中的性能差异,通过实测数据和典型应用场景分析,为区域架构设计提供选型指南。重点探讨了带宽、延迟、成本等关键指标,帮助工程师在ADAS传感器部署和车身控制网络优化中做出明智选择。

pear55的博客 597

图解 SQL 的执行顺序,优雅

因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享这是一条标准的查询语句:这是我们实际上SQL执行顺序:我们先执行from,join来确定表之间的连接关系,得到初步的数据where对数据进行普通的初步的筛选group by 分组各组分别执行having中的普通筛选或者聚合函数筛选。然后把再根据我们要的数据进行select,可以是普通字段查询也可以是获取聚合函数的查询结果,如果是...

1643

火山引擎实时对话AI实战:5分钟搞定WebRTC+大模型+ASR/TTS全链路集成

本文详细介绍了如何利用火山引擎的实时对话AI解决方案,快速集成WebRTC、大模型、ASR和TTS服务,构建低延迟、高保真的实时语音对话应用。通过实战代码示例,从环境准备、音频流管理到全链路串联与性能优化,为开发者提供了一套端到端的集成指南,适用于智能客服、在线教育等互动场景。

weixin_29051245的博客 1132

【2026最新】3分钟Windows极速部署OpenClaw,完整可复制命令+全链路避坑指南

很多新手在Windows环境部署OpenClaw时,总会遇到各种玄学问题:WSL环境配置失败、Docker镜像拉取超时、容器启动后无法访问、权限报错、数据丢失……网上大量教程要么是Linux环境的,要么是早已过时的旧版本配置,照着操作不仅没法3分钟部署,反而要花几小时踩坑填坑。

2601_94871597的博客 495

第三章:SQL编程系列-深度解析SQL执行顺序:从逻辑到物理的完整流程图解

在数据库开发领域,SQL语句的编写看似简单,但其底层执行逻辑却隐藏着精密的优化机制。许多开发者误以为SQL会按照书写顺序逐行执行,实际上数据库引擎会通过解析、优化、执行三个阶段,将逻辑语句转化为物理操作计划。本文将通过动态流程图和实际案例,揭示SQL从文本到结果的完整执行链路。

唐可盐的专栏 1401

yolov26改进 | Neck/颈部创新篇 | 独创HFPN利用分层特征融合块HFFB模块融合多层次特征改进yolov26(全网独家创新)

本文提出了一种创新的分层特征融合模块HFFB(Hierarchical Feature Fusion Block)来改进YOLOv26的neck部分,构建了名为HFPN的新型特征金字塔网络。该模块通过三分支结构融合局部特征(CNN提取)、全局特征(Swin Transformer提取)和中间特征,并包含空间注意力(SA)、通道注意力(CA)和残差反向MLP(IRMLP)等组件来优化特征融合效果。实验表明,该方法能针对不同尺度目标(大/中/小)进行自适应检测,可根据具体数据集需求选择不同配置。文章详细提供了核

Snu77的博客 486

图解 SQL 执行顺序,通俗易懂!

分组结束之后,我们再执行select语句,因为聚合函数是依赖于分组的,聚合函数会单独新增一个查询出来的字段,这里用紫色表示,这里我们两个id重复了,我们就保留一个id,重复字段名需要指向来自哪张表,否则会出现唯一性问题。不同的是,having语法支持聚合函数,其实having的意思就是针对每组的条件进行筛选。我们之前看到了普通的筛选条件是不影响的,但是having还支持聚合函数,这是where无法实现的。用于确定我们要查询的表的范围,涉及哪些表。按照我们的分组条件,将数据进行分组,但是不会筛选数据。

m0_69632475的博客 731

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

图解 SQL 执行顺序,清晰明了

SQL 执行顺序图解

ytp552200ytp的博客 981

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: 不好意思,list.contain 去重该换换了!
下一篇: 字节二面:10Wqps会员系统,如何设计?
公众号-芋道源码
博客等级 码龄10年 1637粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值