clickhouse学习笔记(一)基础概念与架构

ClickHouse学习笔记(一):ClickHouse架构概述(为什么ClickHouse这么快呢?) ClickHouse是一款MPP架构的数据库,它没有采用Hadoop生态中的主从架构,而是使用了多主对等网络结果,同时它也是基于关系模型的ROLAP方案。 阅读详情

简介

Clickhouse是Yandex公司在2009年开始开发,2016年开源的一款用于OLAP(Online Analytical Processing,联机分析处理)的基于MPP(Massively Parallel Processing,大规模并行处理)架构的列式存储数据库系统。其主要适用领域为商业智能领域(俗称BI领域),其次在广告流量、Web/APP流量、电信、电子商务等领域中有广泛的应用。

技术关键词

OLAP、MPP、列式存储

OLAP

联机分析处理主要关注在对大规模数据进行多维度复杂查询分析。因此,系统更加注重读性能,不适用于频繁写入操作的场景。相关的数据库有greenplum,Doris

MPP

大规模并行处理是一种分布式数据处理技术,多个节点并行处理数据以提升数据的处理性能。与其他的分布式架构普遍采用的主从架构不同的是,MPP采用的是非共享架构,每个节点都是独立节点,通过专用网络进行连接并提供服务。这种架构具有避免单点故障、易于横向扩展的优点。

列式存储

列式存储是按列组织数据和保存,与传统的按行存储数据不同,列式存储是将每一列的数据按顺序存储在一起,而不是将一行数据存储在一起。这样带来的好处是:
数据压缩:同一列的数据类型一样,可以采用更高效数据压缩算法
快速查询:只需要查询对应列的数据,减少查询的数据量
坏处:
删除困难:删除一行数据需要查询所有列的数据文件,对对应数据进行删除
写入效率低:一行数据需要拆分成多个列数据进行存储,执行的调用次数比行式存储要多

Clickhouse架构

官方文档有非常详细的介绍,这里仅做一些个人归纳理解
https://clickhouse.com/docs/zh/academic_overview#page-9-0

系统架构
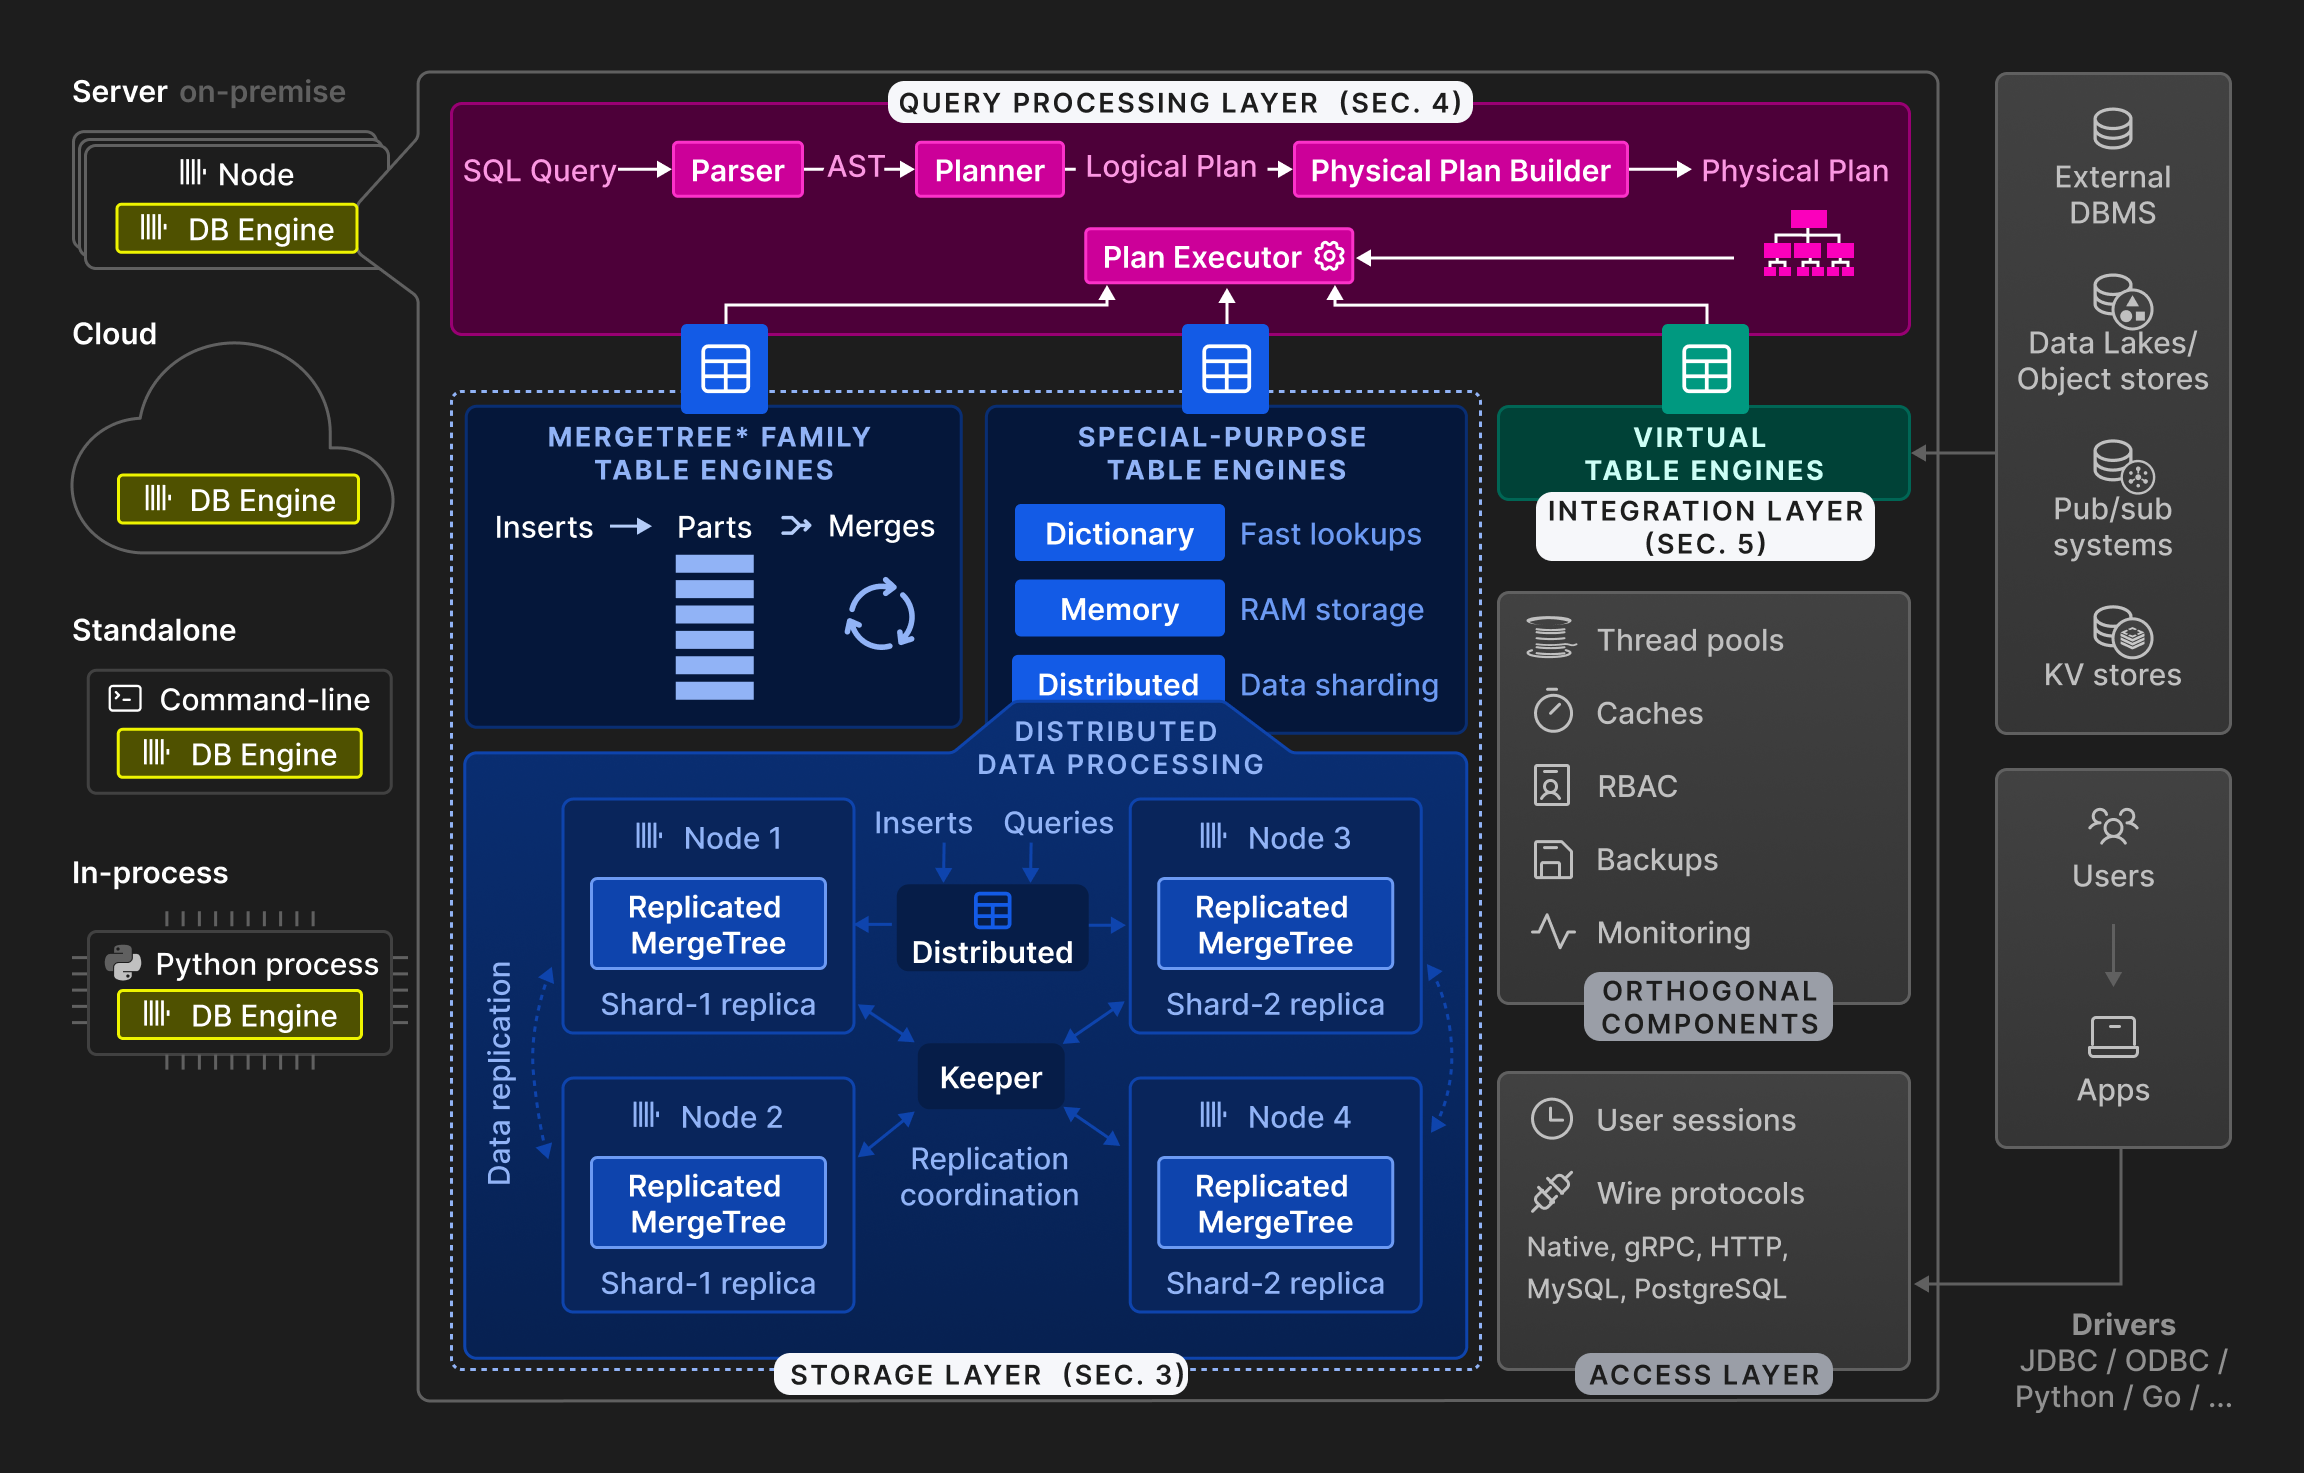
Clickhouse系统结构图,来自Clickhouse官网文档
如图所示,Clickhouse引擎分为三层:查询处理层(Query Processing Layer)、存储层(Storage Layer)和集成层(Intergation Layer)。此外,还有访问层(Access Layer)用于用户会话访问和与其他应用程序的通信,以及正交组件(Orthogonal Components)用于系统辅助工作。(详细的描述可以参考官方文档)

查询处理层

查询处理层按照传统的范式,解析输入查询,生成对应的AST树并构建执行计划进行查询。查询的语言支持标准SQL(大小写敏感),易于使用。

存储层

存储层由多种表引擎组成。表引擎可以分为以下三类:
MergeTree系列表引擎:Clickhouse用于主要持久化的表引擎。该系列表引擎是基于 LSM 树的理念,表被拆分成水平有序的parts,并由后台进程持续合并
特殊用途的表引擎:这些表引擎是用于加速或分布查询执行的,如字典、缓存等
虚拟表引擎:用于与外部系统(如关系数据库(例如 PostgreSQL、MySQL)、发布/订阅系统(例如 Kafka、RabbitMQ )或键值存储(例如 Redis))进行双向数据交换

集成层

集成层用于集成外部数据源,通过连接外部数据源,查询外部数据进行数据补充。如果仅用外部数据源的话,该层就类似于一个中间层,可以查询外部数据。如果使用了数据绑定的话,可以将外部数据源的数据同步到本地进行持久化。

核心特性

多主架构

Clickhouse采用了Multi-Master的多主架构。每个节点都是Master,节点间地位对等,不需要通信。客户端访问任意节点都能得到同样的结果。在架构上,天然避免了单点故障的问题和支持灵活的横向伸缩,非常适合多数据中心,异地多活的场景。集群不同节点的数据一致性上,Clickhouse需要使用ClickHouse Keeper和分布式表设置进行不同数据同步。简单描述,ClickHouse Keeper用于提供分布式协调服务,在任意节点上创建库和表时,节点会通过Keeper获取集群中其他节点信息进行副本和数据的同步。

列式存储

列式存储是将数据按列进行保存。这样做的好处在于能有效减少查询时所需要扫描的数据量。假设一个表有50个字段,100行数据,一个查询要求获取前5个字段的数据。按行存储是将这100行的数据全部扫描出来,加载到内存中,取出每行前5个字段。按列存储是直接取出前5个字段的数据。这样按列存储需要扫描的数据量明显小于按行存储,因此查询性能较高。在Clickhouse中,列数据的存储是有序(按照Primary key进行排序)分区(根据Primary key的数据)
另外,同一列的数据类型是一样的,重复项的可能性也更高。因此可以针对相同类型的数据采用效率更高的数据压缩算法,数据的相似性也会使压缩率更高。Clickhouse默认使用LZ4压缩算法。

向量化执行引擎

向量化执行是使用了CPU的SIMD指令(Single Instruction Multiple Data),即单条指令操作多条数据。个人理解,列式存储为向量化执行提供了前提条件。在执行统计操作时,由于采用了列式存储,输入是可以同类多行可以直接运算的数据,并且可以并发计算。如果是按行存储,需要从行数据进行提取再进行运算,并且由于行数据有冗余的数据,导致有效加载的数据量不及按列存储,并发度没那么高,因此向量化执行的收益不大。

多样化表引擎

Clickhouse将存储层进行了抽象,把存储引擎作为一层独立的接口,支持各种各样的表引擎。用户可以根据实际的场景需要选择对应的表引擎。

结语

本文对Clickhouse使用的技术和系统架构进行了一些总结归纳。列式存储 + 向量化执行 + MergeTree 引擎的组合为Clickhouse提供强劲的性能,非常适合实时海量数据分析场景,是目前最佳的OLAP的数据库解决方案之一。

参考文献

1 Robert Schulze, Tom Schreiber, Ilya Yatsishin, Ryadh Dahimene, and Alexey Milovidov. 2024. ClickHouse - Lightning Fast Analytics for Everyone. https://www.vldb.org/pvldb/vol17/p3731-schulze.pdf
2 朱凯.《ClickHouse原理解析与应用实践》


ClickHouse架构概览 —— Clickhouse 架构篇(一) 本文介绍了ClickHouse的整体架构,并对ClickHouse中的一些重要的抽象对象进行了分析。然后此基础上,结合数据库的几个常用的操作,介绍了这些抽象对象的运作机制。ClickHouse 使用的是MPP(Massively Parallel Processing,大规模并行处理)架构,该架构集群中的任意一台服务器都可以单独对外提供服务,是一个多主的结构。 阅读详情

相关推荐

clickhouse基础教程

一、基础概念 Clickhouse由俄罗斯Yandex公司开源的数据库,专为OLAP而设计。 Yandex是俄罗斯最大的搜索引擎公司,官方宣称ClickHouse 日处理记录数”十亿级”。 发布之初跑分要超过很多流行的商业MPP数据库软件,对标老东家HP的Vertica和GP 官方的性能测试显示比vertica快5倍,比GP快10倍。 但是: clickhouse直接可以安在各种版本的Linux系统上,macos可以通过docker来安装 官方没有提供设计和架构文档,只有开源的C++源码 不理睬Hadoop

Im ok的博客哦 1万+

ClickHouse笔记

ClickHouse笔记 文章目录ClickHouse笔记第 1 章 ClickHouse 入门列式储存的好处:第 2 章 ClickHouse 的安装第 3 章 数据类型整型浮点型布尔型Decimal 型字符串枚举类型时间类型数组第 4 章 表引擎表引擎的使用TinyLogMemoryMergeTreepartition by 分区(可选)primary key 主键(可选)二级索引数据 TTLReplacingMergeTreeSummingMergeTree第 5 章 SQL 操作第 6 章 副本第

wbo 1205

Clickhouse 的分布式架构说明——Clickhouse 架构篇(五)

ClickHouse通过高度协调配合的存储引擎和计算引擎,实现了令人惊叹的单机性能,但是再强的单机性能也会遇到瓶颈,此时分布式架构就成为解决单机瓶颈的一个选择。本文介绍ClickHouse分布式架构的原理及使用方法。本文介绍了ClickHouse的分布式架构及其运作机制。ClickHouse的强项并不在分布式架构上,其自身的分布式能力也只是聊胜于无。应当将ClickHouse应用到其擅长的领域,不用过分追求强大的分布式能力。

奔跑的蜗牛的博客 4277

【OLAP】ClickHouse学习笔记

ClickHouse是俄罗斯开源的列式存储数据库(DBMS),使用C++编写,主要用于在线分析处理查询(OLAP)能够使用 SQL 查询实时生成分析数据报告。ClickHouse适合处理已经处理过的宽表。

zuzhiang的博客 598

ClickHouse 基础(一)

ClickHouse 基础

chinusyan的专栏 1433

ClickHouse、Doris、 Impala等MPP架构详解

我们常用的大数据计算引擎有很多都是MPP架构的,像我们熟悉的Impala、ClickHouse、Druid、Doris等都是MPP架构。采用MPP架构的很多OLAP引擎号称:亿级秒开。本文分为三部分讲解,第一部分详解MPP架构,第二部分剖析MPP架构与批处理架构的异同点,第三部分是采用MPP架构的OLAP引擎介绍。MPP是系统架构角度的一种服务器分类方法。目前商用的服务器分类大体有三种:SMP(对称多处理器结构)NUMA(非一致存储访问结构)MPP(大规模并行处理结构)

weixin_42795092的博客 3479

ClickHouse学习笔记

ClickHouse学习笔记

qq_40691970的博客 3336

一、Docker/安装包部署ClickHouse

其中18138372fad4b94533cd4881f03dc6c69296dd897234e0cee83f727e2e6b1f63生成方式。

青啊青斯博客 6818

ClickHouse基础概念与架构

1.背景介绍 1. 背景介绍 ClickHouse 是一个高性能的列式数据库管理系统,主要用于实时数据处理和分析。它由 Yandex 开发,并且被广泛应用于各种场景,如实时监控、日志分析、数据报告等。ClickHouse 的核心特点是高速、高效、实时,它可以处理大量数据并提供快速的查询速度。 2. 核心概念与联系 在了解 ClickHouse 的核心概念之前,我们需要了解一些基本概念: ...

AI天才研究院 1184

ClickHouse的架构与基本概念

ClickHouse的架构与基本概念

日常分享数据分析开发、编程语言内容 2291

ClickHouse 的相关概念与springBoot的整合

摘要:本文介绍了ClickHouse作为列式存储OLAP数据库的特点、优劣势及适用场景,并与传统关系型数据库进行了对比分析。文章指出ClickHouse适合大数据分析场景,但不适用于高频事务处理。同时详细讲解了ClickHouse与SpringBoot整合时的注意事项,包括MyBatis适配问题和特殊变量映射处理,提供了类型转换器解决方案。

杨杨杨~~的博客 1112

ClickHouse 核心概念详解

ClickHouse 核心概念总结 ClickHouse 是一款高性能列式 OLAP 数据库,其核心设计围绕快速查询和大数据吞吐。主要特点包括: 表引擎机制:MergeTree 系列引擎(支持去重、预聚合等)决定数据存储和处理方式 列式存储:独立存储每列数据,查询时只读取必要列,显著减少 I/O 智能索引:稀疏索引(每8192行标记)配合ORDER BY键实现高效数据定位 分区策略:按日期等规则分区,支持快速删除和查询裁剪 分布式架构:通过Distributed表引擎和ReplicatedMergeTree

csdn_tom_168的博客 999

ClickHouse 与其他数仓架构的对比——Clickhouse 架构篇(四)

本文介绍了3种常用的数据仓库(Hive, HBase, Kylin)解决方案的架构以及与ClickHouse的不同之处。这3种数据仓库解决方案都是基于分布式的前提进行的优化,而ClickHouse另辟蹊径,通过提高单机能力实现一定程度上的实时OLAP引擎,这种思路值得我们细细品味。数据文件的组织会影响查询的性能。按行存储的数据相比于按列存储的数据在分析时相对更慢。

奔跑的蜗牛的博客 3393

ClickHouse基础概念和架构介绍

1.背景介绍 1. 背景介绍 ClickHouse 是一个高性能的列式数据库,主要用于实时数据处理和分析。它由 Yandex 开发,并在 2016 年发布为开源项目。ClickHouse 的设计目标是提供低延迟、高吞吐量和高可扩展性,以满足实时数据处理和分析的需求。 ClickHouse 的核心特点包括: 基于列存储的数据结构,减少磁盘I/O和内存使用。 支持多种数据类型,包括数值类型、...

AI天才研究院 1252

Clickhouse—基础架构

首先介绍了ClickHouse的集群结构,可以理解为peer 2 peer ,这样就没有单点问题了其次介绍了ClickHouse 内部结构,我们理解了数据是怎么表示和处理的。

4万+

ClickHouse的核心概念与架构

关系型数据库系统中,常见的两种数据存储方式是列存储和行存储。行存储(Row-store):将表中的记录按照行的形式存储在磁盘上,即每行记录都是放在一起的。行存储适合于对完整记录进行频繁访问的场景,例如在OLTP(在线事务处理)系统中。列存储(Column-store):将表中的记录按照列的形式存储在磁盘上,即每列记录都是放在一起的。列存储适合于对聚合函数(例如COUNT()SUM()AVG()等)进行频繁访问的场景,例如在OLAP(在线分析处理)系统中。

AI天才研究院 883

clickhouse集群搭建实战

修改 config.xml 文件,将末尾的以下配置删掉,因为目前clickhouse镜像服务启动都是使用主机模式,需要手动配置 tcp_port、http_port、interserver_http_port,如果未删除掉,启动的时候会有端口异常报错。分区键,大多数情况下,不需要分区键,如果确实需要分区,通常不需要比按月更细粒度的分区,按月分区,使用 toYYYYMM(data_column):联机分析处理,是数据仓库的核心部分,支持复杂的分析操作,侧重决策支持,并且提供直观易懂的查询结果。

wrfc_hgy的博客 1953

ClickHouse笔记.pdf

ClickHouse笔记,系统的描述了行式存储,列式存储,ClickHouse的优缺点,单击版搭建以及集群搭建。

上一篇: elasticsearch学习(五)文档CRUD
赤月幼狼
博客等级 码龄10年 20粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

赤月幼狼

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值