用scikit-learn学习K-Means聚类

python的scikit-learn机器学习库实现kmeans聚类(参数、方法、实例、评估) 本文主要为scikit-learn中kmeans的介绍 kmeans主要参数 n_clusters: k值 max_iter:最大迭代次数。 如果数据集不是凸集,可能很难收敛,此时可以通过指定最大的迭代次数让算法可以及时退出循环。 n_init:使用不同的初始化质心运行算法的次数。由于K-Means的结果会受初... 阅读详情

转载自:刘建平http://www.cnblogs.com/pinard/p/6169370.html


 在K-Means聚类算法原理中,我们对K-Means的原理做了总结,本文我们就来讨论用scikit-learn来学习K-Means聚类。重点讲述如何选择合适的k值。

1. K-Means类概述

    在scikit-learn中,包括两个K-Means的算法,一个是传统的K-Means算法,对应的类是KMeans。另一个是基于采样的Mini Batch K-Means算法,对应的类是MiniBatchKMeans。一般来说,使用K-Means的算法调参是比较简单的。

    用KMeans类的话,一般要注意的仅仅就是k值的选择,即参数n_clusters;如果是用MiniBatchKMeans的话,也仅仅多了需要注意调参的参数batch_size,即我们的Mini Batch的大小。

    当然KMeans类和MiniBatchKMeans类可以选择的参数还有不少,但是大多不需要怎么去调参。下面我们就看看KMeans类和MiniBatchKMeans类的一些主要参数。

2. KMeans类主要参数

    KMeans类的主要参数有:

    1) n_clusters: 即我们的k值,一般需要多试一些值以获得较好的聚类效果。k值好坏的评估标准在下面会讲。

    2)max_iter: 最大的迭代次数,一般如果是凸数据集的话可以不管这个值,如果数据集不是凸的,可能很难收敛,此时可以指定最大的迭代次数让算法可以及时退出循环。

    3)n_init:用不同的初始化质心运行算法的次数。由于K-Means是结果受初始值影响的局部最优的迭代算法,因此需要多跑几次以选择一个较好的聚类效果,默认是10,一般不需要改。如果你的k值较大,则可以适当增大这个值。

    4)init: 即初始值选择的方式,可以为完全随机选择'random',优化过的'k-means++'或者自己指定初始化的k个质心。一般建议使用默认的'k-means++'。

    5)algorithm:有“auto”, “full” or “elkan”三种选择。"full"就是我们传统的K-Means算法, “elkan”是我们原理篇讲的elkan K-Means算法。默认的"auto"则会根据数据值是否是稀疏的,来决定如何选择"full"和“elkan”。一般数据是稠密的,那么就是 “elkan”,否则就是"full"。一般来说建议直接用默认的"auto"

3. MiniBatchKMeans类主要参数

    MiniBatchKMeans类的主要参数比KMeans类稍多,主要有:

    1) n_clusters: 即我们的k值,和KMeans类的n_clusters意义一样。

    2)max_iter:最大的迭代次数, 和KMeans类的max_iter意义一样。

    3)n_init:用不同的初始化质心运行算法的次数。这里和KMeans类意义稍有不同,KMeans类里的n_init是用同样的训练集数据来跑不同的初始化质心从而运行算法。而MiniBatchKMeans类的n_init则是每次用不一样的采样数据集来跑不同的初始化质心运行算法。

    4)batch_size:即用来跑Mini Batch KMeans算法的采样集的大小,默认是100.如果发现数据集的类别较多或者噪音点较多,需要增加这个值以达到较好的聚类效果。

    5)init: 即初始值选择的方式,和KMeans类的init意义一样。

    6)init_size: 用来做质心初始值候选的样本个数,默认是batch_size的3倍,一般用默认值就可以了。

    7)reassignment_ratio: 某个类别质心被重新赋值的最大次数比例,这个和max_iter一样是为了控制算法运行时间的。这个比例是占样本总数的比例,乘以样本总数就得到了每个类别质心可以重新赋值的次数。如果取值较高的话算法收敛时间可能会增加,尤其是那些暂时拥有样本数较少的质心。默认是0.01。如果数据量不是超大的话,比如1w以下,建议使用默认值。如果数据量超过1w,类别又比较多,可能需要适当减少这个比例值。具体要根据训练集来决定。

    8)max_no_improvement:即连续多少个Mini Batch没有改善聚类效果的话,就停止算法, 和reassignment_ratio, max_iter一样是为了控制算法运行时间的。默认是10.一般用默认值就足够了。

4. K值的评估标准

    不像监督学习的分类问题和回归问题,我们的无监督聚类没有样本输出,也就没有比较直接的聚类评估方法。但是我们可以从簇内的稠密程度和簇间的离散程度来评估聚类的效果。常见的方法有轮廓系数Silhouette Coefficient和Calinski-Harabasz Index。个人比较喜欢Calinski-Harabasz Index,这个计算简单直接,得到的Calinski-Harabasz分数值 s s越大则聚类效果越好。

    Calinski-Harabasz分数值 s s的数学计算公式是:

s(k)=tr(Bk)tr(Wk)m−kk−1

    其中m为训练集样本数,k为类别数。 Bk 为类别之间的协方差矩阵, Wk 为类别内部数据的协方差矩阵。 tr 为矩阵的迹。

    也就是说,类别内部数据的协方差越小越好,类别之间的协方差越大越好,这样的Calinski-Harabasz分数会高。在scikit-learn中, Calinski-Harabasz Index对应的方法是metrics.calinski_harabaz_score.

5. K-Means应用实例

    下面用一个实例来讲解用KMeans类和MiniBatchKMeans类来聚类。我们观察在不同的k值下Calinski-Harabasz分数。

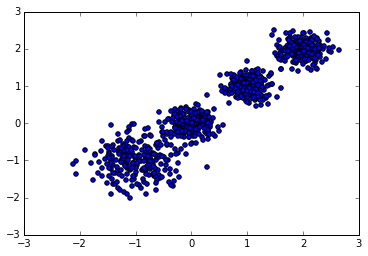
    首先我们随机创建一些二维数据作为训练集,选择二维特征数据,主要是方便可视化。代码如下:

复制代码
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
from sklearn.datasets.samples_generator import make_blobs
# X为样本特征,Y为样本簇类别, 共1000个样本,每个样本4个特征,共4个簇,簇中心在[-1,-1], [0,0],[1,1], [2,2], 簇方差分别为[0.4, 0.2, 0.2]
X, y = make_blobs(n_samples=1000, n_features=2, centers=[[-1,-1], [0,0], [1,1], [2,2]], cluster_std=[0.4, 0.2, 0.2, 0.2], 
                  random_state =9)
plt.scatter(X[:, 0], X[:, 1], marker='o')
plt.show()
复制代码

    从输出图可以我们看看我们创建的数据如下:

   现在我们来用K-Means聚类方法来做聚类,首先选择k=2,代码如下:

from sklearn.cluster import KMeans
y_pred = KMeans(n_clusters=2, random_state=9).fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=y_pred)
plt.show()

    k=2聚类的效果图输出如下:

    现在我们来看看我们用Calinski-Harabasz Index评估的聚类分数:

from sklearn import metrics
metrics.calinski_harabaz_score(X, y_pred)  

    输出如下:

3116.1706763322227

    现在k=3来看看聚类效果,代码如下:

from sklearn.cluster import KMeans
y_pred = KMeans(n_clusters=3, random_state=9).fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=y_pred)
plt.show()  

    k=3的聚类的效果图输出如下:

    现在我们来看看我们用Calinski-Harabaz Index评估的k=3时候聚类分数:

metrics.calinski_harabaz_score(X, y_pred)  

    输出如下:

2931.625030199556

    可见此时k=3的聚类分数比k=2还差。

    现在我们看看k=4时候的聚类效果:

from sklearn.cluster import KMeans
y_pred = KMeans(n_clusters=4, random_state=9).fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=y_pred)
plt.show()

    k=4的聚类的效果图输出如下:

    现在我们来看看我们用Calinski-Harabasz Index评估的k=4时候聚类分数:

metrics.calinski_harabaz_score(X, y_pred)  

    输出如下:

5924.050613480169

    可见k=4的聚类分数比k=2和k=3都要高,这也符合我们的预期,我们的随机数据集也就是4个簇。当特征维度大于2,我们无法直接可视化聚类效果来肉眼观察时,用Calinski-Harabaz Index评估是一个很实用的方法。

    现在我们再看看用MiniBatchKMeans的效果,我们将batch size设置为200. 由于我们的4个簇都是凸的,所以其实batch size的值只要不是非常的小,对聚类的效果影响不大。

复制代码
for index, k in enumerate((2,3,4,5)):
    plt.subplot(2,2,index+1)
    y_pred = MiniBatchKMeans(n_clusters=k, batch_size = 200, random_state=9).fit_predict(X)
    score= metrics.calinski_harabaz_score(X, y_pred)  
    plt.scatter(X[:, 0], X[:, 1], c=y_pred)
    plt.text(.99, .01, ('k=%d, score: %.2f' % (k,score)),
                 transform=plt.gca().transAxes, size=10,
                 horizontalalignment='right')
plt.show()
复制代码

   对于k=2,3,4,5对应的输出图为:

    可见使用MiniBatchKMeans的聚类效果也不错,当然由于使用Mini Batch的原因,同样是k=4最优,KMeans类的Calinski-Harabasz Index分数为5924.05,而MiniBatchKMeans的分数稍微低一些,为5921.45。这个差异损耗并不大。



Scikit-Learn学习笔记——k-means聚类:图像识别、色彩压缩 k-means聚类 k-means是一种无监督学习模型——聚类算法的一种算法。k-means算法可以在不带标签的多维数据集中寻找确定数量的簇。 最优的聚类结果需要符合一下两个假设 “簇中心点“是属于该簇的所有数据点坐标的算术平均值 一个簇的每个点到该簇中心点的距离,比到其他簇中心点的距离短。 #简单演示k-means算法 %matplotlib in... 阅读详情

相关推荐

Scikit-learn K-Means++:一种高效的聚类算法

综上所述,Scikit-learn K-Means++算法是一种高效的聚类算法,通过更智能地初始化簇中心来提高聚类结果的准确性。我们可以使用Scikit-learn库的KMeans类来实现K-Means和K-Means++算法,并通过参数调整来获得更好的聚类结果。具体来说,K-Means++算法首先选择一个随机的簇中心c1,然后对于每个样本xi,计算它到已有簇中心的最短距离D(xi),将这个距离平方作为权重,按照概率分布选择下一个簇中心。Scikit-learn K-Means++:一种高效的聚类算法。

. 739

k-means+python︱scikit-learn中的KMeans聚类实现( + MiniBatchKMeans)

之前一直用R,现在开始学python之后就来尝试用Python来实现Kmeans。 之前用R来实现kmeans的博客:笔记︱多种常见聚类模型以及分群质量评估(聚类注意事项、使用技巧) 聚类分析在客户细分中极为重要。有三类比较常见的聚类模型,K-mean聚类、层次(系统)聚类、最大期望EM算法。在聚类模型建立过程中,一个比较关键的问题是如何评价聚类结果如何,会用一些指标来评价。 ....

素质云笔记 18万+

《遥感大模型生产级实战:从数据到决策的端到端AI工程》系列第三部分:城市洪涝灾害应急响应与评估平台实战-文章 14:项目二启动与多源异构数据对齐

我们将系统性地梳理城市洪涝场景下的所有关键数据源,从天上的卫星(光学与SAR)、空中的无人机,到地面的物联网传感器和社交媒体信息流,深入剖析每种数据在洪涝响应中的独特价值、获取方式与内在局限性。本章的核心将是一个详尽的、生产级的数据对齐技术全景,我们将分步解决三大核心对齐难题:空间对齐(将所有数据投影到统一的地理坐标系)、时间对齐(处理不同采样频率的时间序列)以及最困难的语义对齐(将文本描述与物理观测相关联)。

panshengwu的博客 2003

python——k-means聚类(余弦距离,用轮廓系数确定聚类系数K)

    用scikit-learn进行k-means聚类,默认使用欧式距离,为了用余弦距离作为度量,找了一个在生物信息学里比较常用的库:Biopython。Biopython为k-means聚类提供了各种距离函数,包括余弦距离、皮尔逊相似度量、欧式距离等。    另外,为了确定一个合理的聚类系数,采用轮廓系数作为衡量标准:    轮廓系数取值为[-1, 1],其值越大越好。from sklearn...

chenxjhit的博客 2万+

水气泵控制原理,三角波发生电路,LM331M/TR芯片,高速运放芯片

气泵的控制采用闭环控制,根据气泵的FG反馈信号进行反馈调节,由于气泵的反馈信号是脉冲反馈,即频率改变,占空比不变,即需要通过F/V转换芯片转换成电压信号,变为电压与转速成正比,其电压进入比较器与基准电压进行比较,将比较结果进行运算并进行PWM控制信号。水泵的控制采用闭环控制,根据水泵的pwm信号进行反馈调节,水泵的反馈信号是脉冲反馈,即频率改变,占空比不变,即需要通过F/V转换芯片转换成电压信号,变为电压与转速成反比,其电压进入比较器与基准电压进行比较,将比较结果进行运算并对PWM控制信号。

m0_51010122的博客 2856

zynq 7010/020 AMP双核通信-Vitis2023/2024

在platform cpu1设置中添加;注意value中使用空格分开程序思路:比较简单。

weixin_43310175的博客 917

机器学习笔记:python中scikit-learn库的K-Means类

目录K-Means类概述KMeans类主要参数MiniBatchKMeans类主要参数K值的评估标准K-Means应用实例 K-Means类概述 在scikit-learn中,包括两个K-Means的算法,一个是传统的K-Means算法,对应的类是KMeans。另一个是基于采样的Mini Batch K-Means算法,对应的类是MiniBatchKMeans。一般来说,使用K-Means的算法调...

weixin_44781900的博客 973

西门子AI面试问答(STAR法则回答实例)

通过建立良好的沟通渠道、倡导透明和积极的沟通,并建立信任和共享目标的文化,我成功地改善了团队合作的氛围和效果。对于一些存在分歧和冲突的情况,我采用了积极的解决问题的态度,促进双方的沟通和理解,寻找共同的利益点和解决方案。我的成果得到了评委和观众的认可,并为我的学术发展和进一步的科学研究奠定了基础。首先,我主动与团队成员进行一对一的沟通,倾听他们的观点和意见,了解他们在合作中遇到的问题和需求。我还参加了学校组织的科学俱乐部和研究小组,与其他热衷科学的同学一起进行讨论和实验,加深我的理解和实践技能。

kashine的博客 7249

Scikit-learn Python机器学习 - 聚类分析算法 - K-Means(K均值)

Scikit-learn Python机器学习 - 聚类分析算法 - K-Means(K均值)

java1234的博客 879

手把手教你用Isograph Reliability Workbench 14.0绘制可靠性方框图(RBD)

本文详细介绍了如何使用Isograph Reliability Workbench 14.0绘制可靠性方框图(RBD),从软件安装、界面设置到基础项目创建和高级功能应用,手把手指导工程师完成系统可靠性分析。通过实际案例演示,帮助用户掌握RBD建模技巧,提升系统可靠性评估效率。

weixin_26765287的博客 623

实验2 存储器设计与实现【计算机组成原理】

实验2 存储器设计与实现【计算机组成原理】

小心星的博客 2398

使用scikit-learn学习K-Means聚类

步骤: K-Means 聚类算法的大致意思就是“物以类聚,人以群分”: (1)首先输入 k 的值,即我们指定希望通过聚类得到 k 个分组; (2)从数据集中随机选取 k 个数据点作为初始中心点(质心); (3)对集合中每一个小弟,计算与中心点的距离,离哪个中心点距离近,就属于哪个中心点。 (4)这时每一个中心点下都聚集了一些样本,这时候召开选举大会,每一群选出新的中心点(即通过算法选出新的质心)。...

MyNotes 2437

FLUENT Meshing Watertight Geometry工作流入门 - 4 局部加密区域

总结一下本课程中学到的内容:我们了解了如何使用模型中特定兴趣区域的BOI和FOI局部尺寸控制来加密网格。然后,了解了如何使用Box类型的局部细化区域。最后,学习了Ansys Fluent Meshing Watertight Geometry Workflow的Offset Surface类型创建局部细化区域任务。

B_etter_Man的博客 6643

学习:用scikit-learn学习K-Means聚类

复制链接 在K-Means聚类算法原理中,我们对K-Means的原理做了总结,本文我们就来讨论用scikit-learn来学习K-Means聚类。重点讲述如何选择合适的k值。 1. K-Means类概述 在scikit-learn中,包括两个K-Means的算法,一个是传统的K-Means算法,对应的类是KMeans。另一个是基于采样的Mini Batch K-Means算法,对应的类是MiniB...

czp_374的博客 390

JavaScript教程-字符集,Unicode转义序列,标识符,数据类型,数字,未定义值,浮点数,字符串,引用数据类型,类型检测,类型转换,运算符,关系运算符,

前端学习

VAN 212

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

python聚类分析sklearn_用scikit-learn学习K-Means聚类

在K-Means聚类算法原理中,我们对K-Means的原理做了总结,本文我们就来讨论用scikit-learn来学习K-Means聚类。重点讲述如何选择合适的k值。1. K-Means类概述在scikit-learn中,包括两个K-Means的算法,一个是传统的K-Means算法,对应的类是KMeans。另一个是基于采样的Mini Batch K-Means算法,对应的类是MiniBatchKMe...

weixin_39801158的博客 985

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

scikit-learn学习之K-means聚类算法与 Mini Batch K-Means算法

====================================================================== 本系列博客主要参考 Scikit-Learn 官方网站上的每一个算法进行,并进行部分翻译,如有错误,请大家指正 转载请注明出处 ========================================================...

Thinkgamer博客 5万+

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

机器学习之 k-means聚类——基于Scikit-Learn

《Python数据科学手册》笔记 聚类算法直接从数据的内在性质中学习最优的划分结果或者确定离散标签类型。 一、k-means需要达到的效果 k-means算法在不带标签的多维数据中寻找确定数量的簇,聚类结果应符合以下两个假设: ①“簇中心点”是属于该簇的所有数据点坐标的算术平均值。 ②一个簇的每个点到该簇中心点的距离,比到其他簇中心点的距离短。 例如图1的二维数据,应用k-means算...

elma_tww的博客 523

机器学习之SKlearn(scikit-learn)的K-means聚类算法

Scikit learn 也简称 sklearn, 是机器学习领域当中最知名的 python 模块之一.

人工智能研究所的博客 2096

sklearn聚类模型评估代码_2019-10-16 机器学习-聚类算法-K-means(K-均值聚类)-原理解析-代码实现(Scikit-learn)...

今天我们来看一个非常常见和使用的无监督机器学习算法——K-均值聚类(K-means)首先我们先了解一下这个算法的大致背景:首先要知道什么是聚类聚是一个将数据集中在某些方面相似的数据成员进行分类组织的过程,聚类就是一种发现这种内在结构的技术,聚类技术经常被称为无监督学习。通俗的说,就是比如我们去海南种水稻,水稻田里面有各种各样的水稻,每株水稻的高低颜色还有其他很多特征都不一样,我们更具这些特征对水稻...

weixin_33272631的博客 223

scikit-learn学习之K-means聚类算法与 Mini Batch K-Means算法 [转自别的作者,还有其他sklearn翻译]

http://blog.youkuaiyun.com/gamer_gyt/article/details/51244850 ====================================================================== 本系列博客主要参考 Scikit-Learn 官方网站上的每一个算法进行,并进行部分翻译,如有错误,请大家指正    转

sherri_du的博客 3137
上一篇: K-Means聚类算法原理
下一篇: 关于奇异值以及奇异值分解SVD的思考
相国大人
博客等级 码龄10年 1009粉丝 132原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值