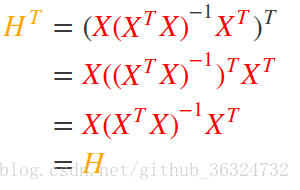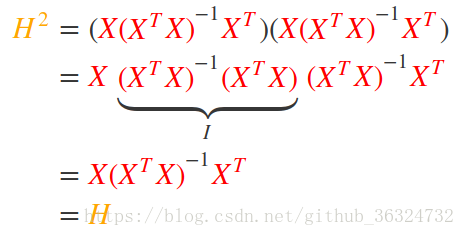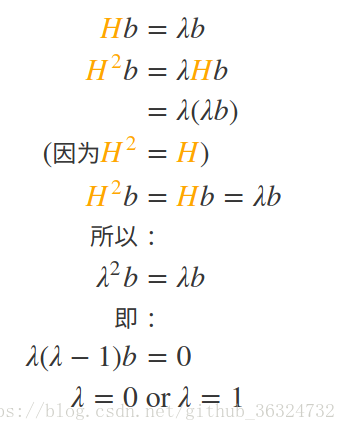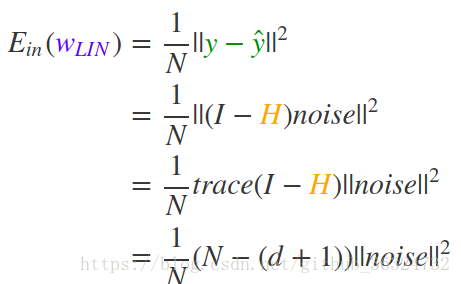台大机器学习基石 Lecture 9 - Linear Regression

[机器学习入门] 经典台大李宏毅机器学习课程从这里开始 TOPIC CONTENTS BLOG PDF VIDEO 【1】Learning Map(学习导图) blog pdf video 【2】Regression:Case Study ;回归:案例研究 blog pdf video 【3】Gradient Descent ;梯度下降 blog pdf video 【4 阅读详情

这节课开始介绍一些常见算法,这次Lecture介绍了最常见的Linear Regression线性回归算法。
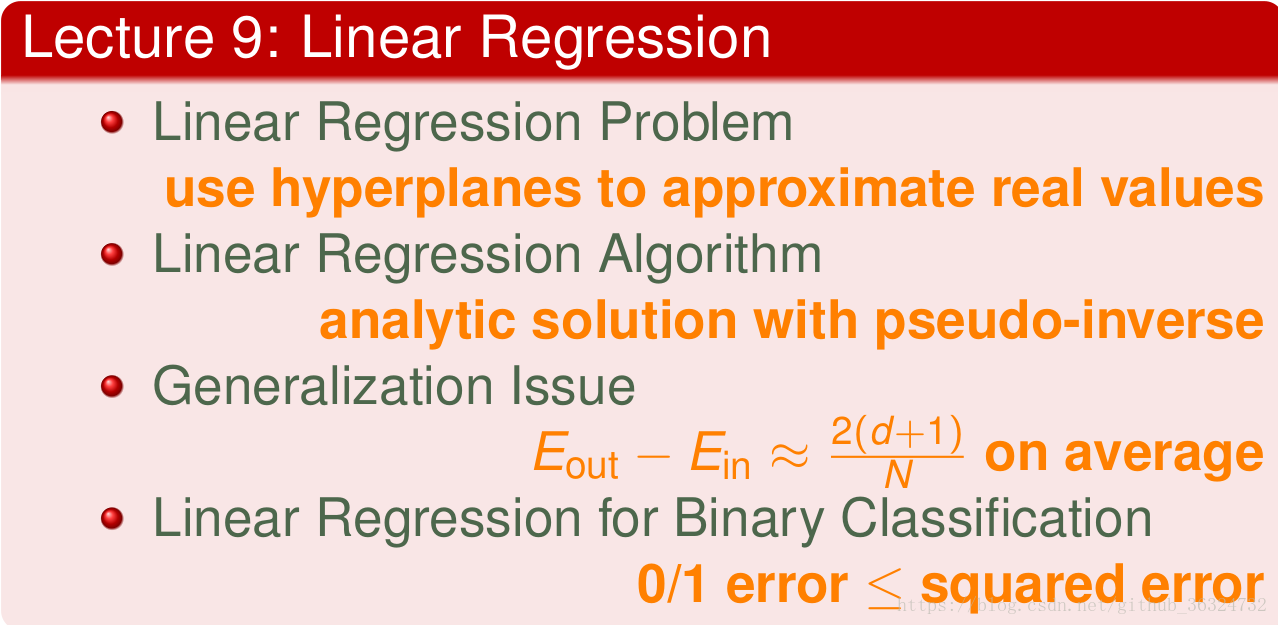
Linear Regression Problem

在Linear Regression模型下的hypothesis为h(x) = \sum_{i = {0}}^{d} w_ix_i = w^Tx,特征集为d维,加上常数项后就为d + 1维(所以注意i从0开始)。在线性回归中,误差的衡量常采用平方误差(squared error):err(\hat{y}_n,y_n) = (\hat{y}_n-y_n)^2,相关的记号已经在上一节课解释过啦~

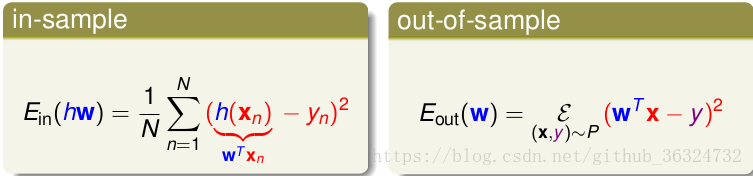
而Linear Regression的目标就是找到一条直线(平面)来使得残差(residuals)最小,根据之前的知识我们很容易知道,在机器学习中这分为in-sample和out-of-sample两部分,根据之前关于VC Bound延伸的证明,只要研究E_{in}就可以了。

E_{in}(h) = \frac{1}{N}\sum_{n=1}^N(\hat{y}_n - y_n)^2 = \frac{1}{N}\sum_{n=1}^N(h(x_n) - y_n)^2

\Rightarrow E_{in}(w) = \frac{1}{N}\sum_{n=1}^N(w^Tx_n-y_n)^2

我们将E_{in}从一个以x为变量的函数,转化为了一个以w为变量的函数,从而我们只要寻找E_{in}(w)\sim w的最小值就可以得到最优的结果。要注意的是这里的输入集(x,y)中x和y都是可能带noise的,但是这并不影响。

根据红色石头的笔记,这是采用最小二乘法的方法来测量错误,但有以下注意点——

这里提一点,最小二乘法可以解决线性问题和非线性问题。线性最小二乘法的解是closed-form,即X=(ATA)−1ATyX=(ATA)−1ATy,而非线性最小二乘法没有closed-form,通常用迭代法求解。本节课的解就是closed-form的。关于最小二乘法的一些介绍,请参见我的另一篇博文:

最小二乘法和梯度下降法的一些总结

主要就是在使用最小二乘法在线性与非线性时对应解法的区别。

Linear Regression Algorithm

现在的问题就转化为了如何求E_{in}(w)?

E_{in}({w}) = \frac{1}{N}\sum_{n=1}^{N}(\color{Blue}{w^T} \color{Red}{x_n} \color{black}{-} \color{Purple}{y_n} \color{black})^2=\frac{1}{N}\sum_{n=1}^{N}(\color{red}{x_n^T} \color{blue}{w} \color{black}{-} \color{Purple}{y_n} \color{black})^2(利用向量内积可交换让式子美观些)

= \frac{1}{N}\begin{Vmatrix} \color{red}{x_1^T}\color{blue}{w}-\color{Purple}{y_1}\\\ \color{red}{x_2^T}\color{blue}{w}-\color{Purple}{y_2}\\\ ...\\\ \color{red}{x_N^T}\color{blue}{w}-\color{Purple}{y_N} \end{Vmatrix}^2= \frac{1}{N} \begin{Vmatrix} \color{red}{\begin{bmatrix} --x_1^T--\\\ --x_2^T--\\\ ...\\\ --x_N^T-- \end{bmatrix}} \color{blue}{w} \color{black}{-} \color{Purple}{\begin{bmatrix} y_1\\\ y_2\\\ ...\\\ y_3 \end{bmatrix}} \end{Vmatrix}^2(连加一串的w_{LIN}平方可以写成整个向量长度的平方)

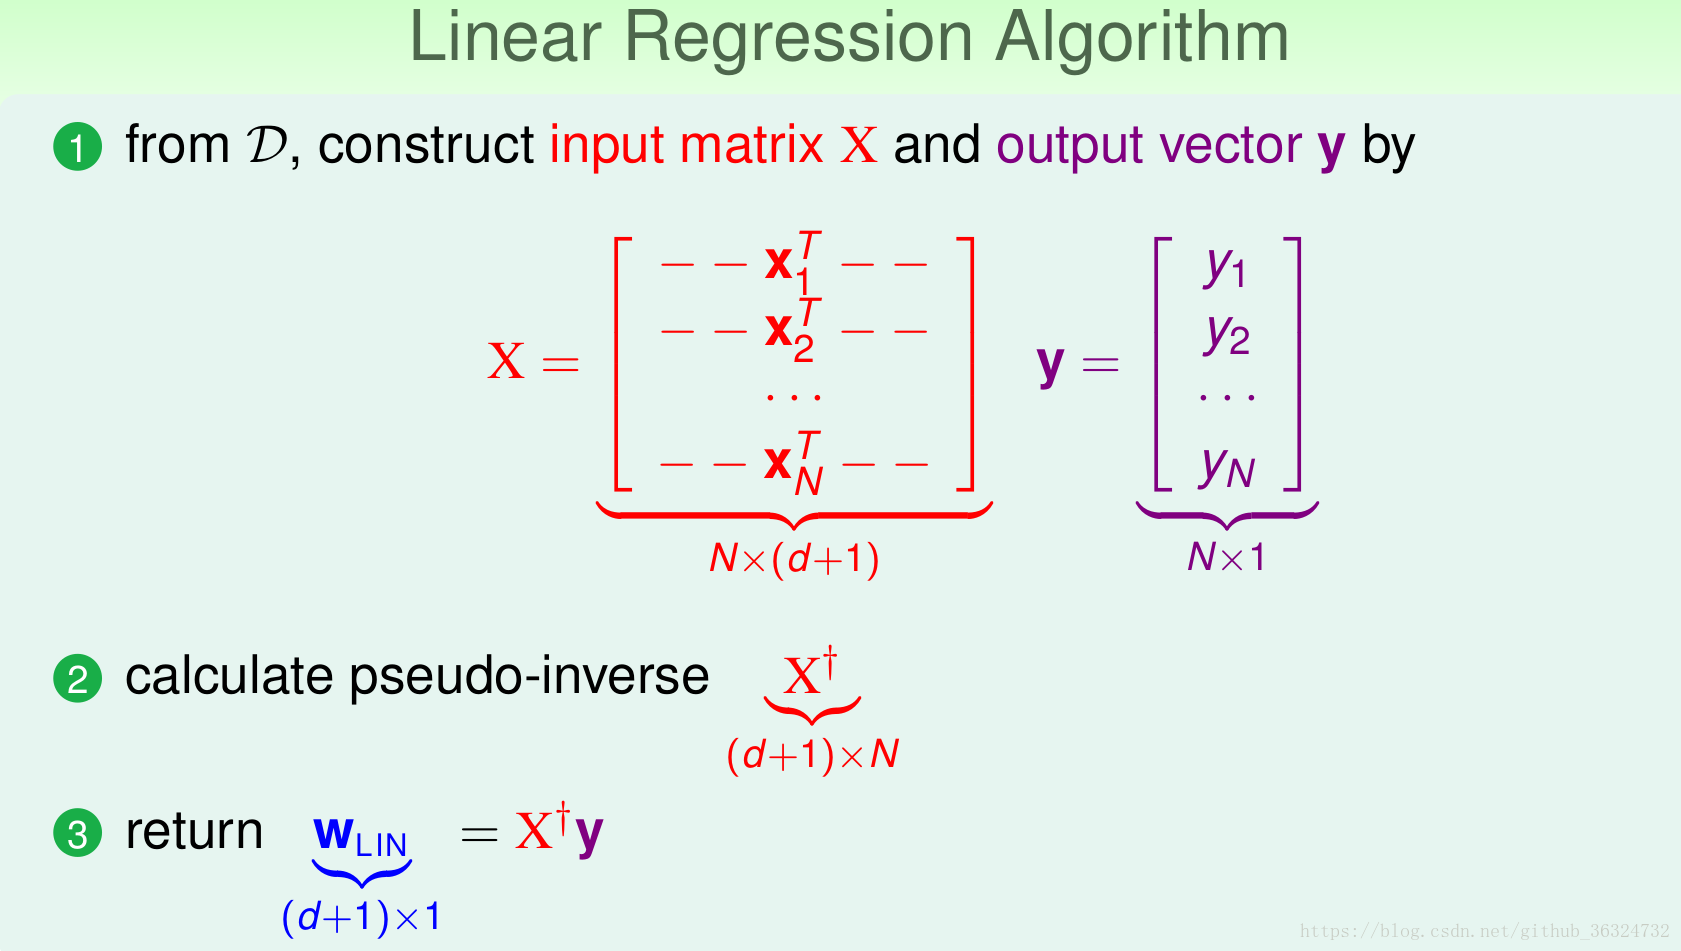
= \frac{1}{N}\left \| \color{red}{X} \color{blue}{w} \color{black}{-} \color{Purple}{y} \color{black} \right \|^2(X为N * (d + 1),w为(d + 1) * 1,y为N * 1)

从而我们得到\underset{\color{blue}{w} \color{black}}{min}E_{in}(\color{blue}{w} \color{black}) = \frac{1}{N}\left \| \color{red}{X} \color{blue}{w} \color{black}{-} \color{Purple}{y} \color{black} \right \|^2,是一个以w为变量的函数,连续(continuous)、处处可微(differentiable)的凸函数(convex)。
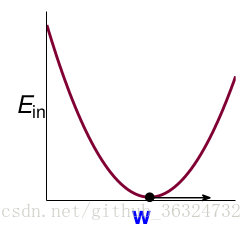
对于求这类函数的极值,只要让其一阶导数 = 0,对于多元函数,只要各方向偏导数 = 0,函数在某点梯度 = 0。

E_{in}(\color{blue}{w} \color{black})\equiv \begin{bmatrix} \frac{\partial E_{in}}{\partial \color{blue}{w}_0 \color{black}}(\color{blue}{w} \color{black})\\ \frac{\partial E_{in}}{\partial \color{blue}{w}_1 \color{black}}(\color{blue}{w} \color{black})\\ ...\\ \frac{\partial E_{in}}{\partial \color{blue}{w}_d \color{black}}(\color{blue}{w} \color{black}) \end{bmatrix} = \begin{bmatrix} 0\\ 0\\ ...\\ 0 \end{bmatrix},找到这样的w_{LIN}就可以。

w将式子展开——

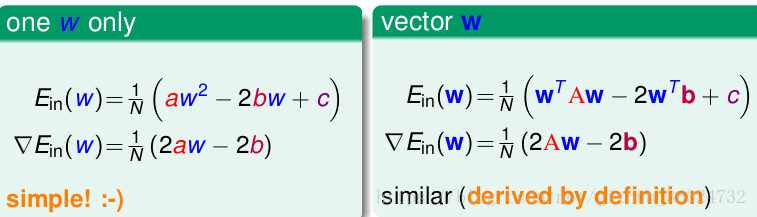
E_{in}(\color{blue}{w} \color{black}) = \frac{1}{N}\left \| \color{red}{X} \color{blue}{w} \color{black}{-} \color{Purple}{y} \color{black} \right \|^2 = \frac{1}{N}(\color{blue}{w^T} \color{red}{X^TX} \color{blue}{w} \color{black} - 2\color{blue}{w^T} {\color{DarkRed}{X^Ty} } + \color{Purple}{y^Ty})

从一维向高维来推广

 所以有:

\triangledown E_{in}( {\color{Blue}{w}}) = \triangledown \frac{1}{N}({\color{Blue}{w^T}} {\color{Red}{X^TX}} {\color{Blue}{w}}-2{\color{Blue}{w^T}}{\color{DarkRed} X^Ty}+{\color{Purple}{y^Ty}})=\frac{2}{N}({\color{red}{X^TX}}{\color{blue}{w}}-{\color{DarkRed}{X^Ty}}) = {\color{Orange}0}

于是,我们就得到了关于最优解时关于w的方程

  • {\color{Red}X^TX}可逆,也就是上文提到的closed-form解,就有{\color{Blue}w_{LIN}} = ({\color{Red}X^TX})^{-1} {\color{Red}X^T}{\color{Purple}{y}} = {\color{Red}X^\dagger} {\color{Purple}{y}},其中{\color{Red}X^\dagger} = ({\color{Red}X^TX})^{-1} {\color{Red}X^T}是伪逆矩阵(pseudo-inverse)
  • {\color{Red}X^TX}不可逆,这时求出广义逆矩阵{\color{Red}X^\dagger}

用以{\color{Blue}w_{LIN}}为参数的线性方程对原始数据做预测,可以得到拟合值\hat{y}=\color{Red}{X}\color{Blue}{w_{LIN}}={\color{red}{XX^{\dagger}}}\color{Purple}{y},其中{\color{Orange} H} = {\color{red}{XX^{\dagger}}}称为帽子矩阵(Hat Matrix)。

于是Linear Regression Algorithm的流程如下——
Generalization Issue

现在的问题是,\color{Blue}{w_{LIN}}={\color{red}{X^{\dagger}}}\color{Purple}{y}是否是一个机器学习算法?

  • 这不属于机器学习范畴。因为这种closed-form解的形式跟一般的机器学习算法不一样,而且在计算最小化误差的过程中没有用到迭代。
  • 这属于机器学习范畴。因为从结果上看,和都实现了最小化,而且实际上在计算逆矩阵的过程中,也用到了迭代。

我们先看一下Hat Matrix {\color{Orange}H}的几何含义

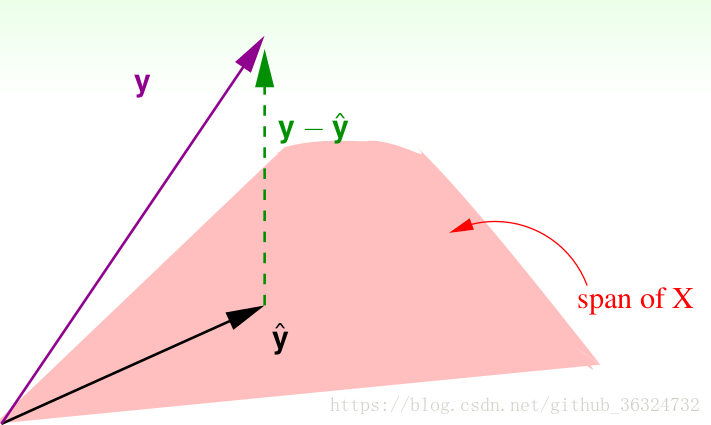
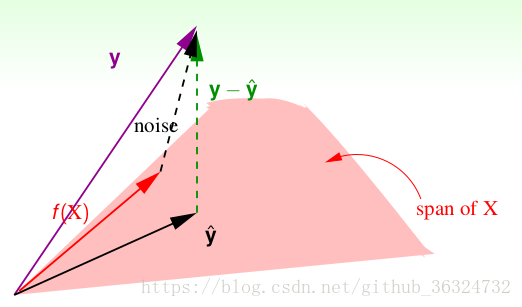
 在N维实数空间\mathbb{R}^N中,X是N * (d + 1)的

  • \hat{y}=\color{Red}{X}\color{Blue}{w_{LIN}}是\color{red}X的一个线性组合,\color{red}X的一个column对应\mathbb{R}^N下的一个向量,共有d + 1个向量,\hat{y}在这d + 1个向量所构成的平面{\color{Red} span}上;
  • 所以我们就是要在这个平面{\color{Red} span}上找到一个向量\hat{y}使得它与真实值之间距离|y-\hat{y}|最短。那么只要\hat{y}是y在平面上的投影,也就是(y-\hat{y})\perp \color{red}{span}时,|y-\hat{y}|最短;
  • 之前的Hat Matrix {\color{Orange}H}就是进行投影的矩阵。有{\color{Orange}H}{\color{Purple}y} = \hat{y},(I-{\color{Orange}{H}}){\color{Purple}{y}}={\color{Purple}y}-\hat{y}(I是单位矩阵)
  • {\color{Orange}{H}} = {\color{red}X} ( {\color{red}X^TX}) ^{-1} {\color{red}{X^T}}

接下来探究一下{\color{Orange}H}的性质——

  • 对称性(symetric),即{\color{Orange}H}=\color{Orange}{H^T}

  • 幂等性(idempotent),即{\color{Orange}H^2} = {\color{Orange}H}

  • 半正定(positive semi-definite),即所有特征值为非负数:(以下\lambda为特征值,b为对应的特征向量)

  • trace(I-{\color{Orange}{H}}) = N-(d+1) ,trace是矩阵的迹。用物理意义来解释这个式子——

假设y = {\color{Red} f(x)\in span} + noise,之前已经讲了{\color{Orange}H}作用于向量是得到向量在{\color{Red} span}上的投影,而I - {\color{Orange}H}作用于向量得到与{\color{Red} span}垂直的向量,于是(I - {\color{Orange}H})noise = y - \hat{y}。

 因此就平均而言,有:

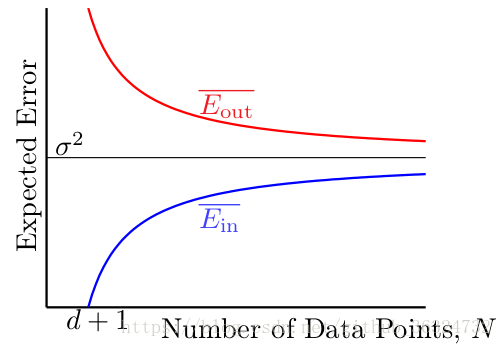
{\color{red}{\overline{E_{in}}}}=\text{noise level}\cdot(1-\frac{d+1}{N})

{\color{blue}{\overline{E_{out}}}}=\text{noise level}\cdot(1+\frac{d+1}{N})这个式子的推导就比较复杂了...

我们就发现{\color{red}{\overline{E_{in}}}}与{\color{blue}{\overline{E_{out}}}}都收敛于\sigma ^2(noise level),并且他们之间的差被\frac{2(d + 1)}{N}限制住。

虽然与VC Bound不同,VC Bound是通过最差错误概率来推导E_{in}与E_{out}接近,这里是从平均的角度,仍然能证明LinReg算法能够学习!

Linear Regression for Binary Classification

现在有一个问题就是能不能让线性回归来作线性分类问题呢?

我们看到有下面的差异——
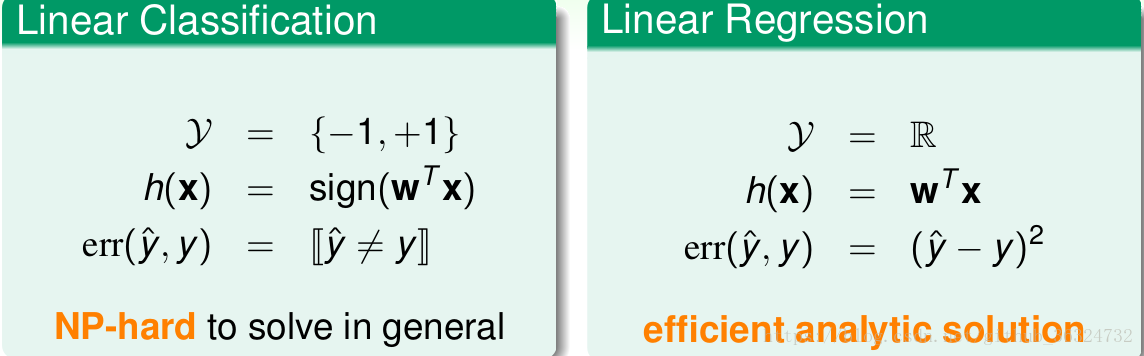
那么如果我们用\{-1, +1\} \subset \mathbb{R}来做线性分类呢?

  • 直观来看,却是可以替代,只是少算了一个sign()的步骤,并且LinReg效率更高;
  • 作图来看LinReg的曲线一直在LinClassfication的线之上,因此可以作为linear classification的宽松错误上界。
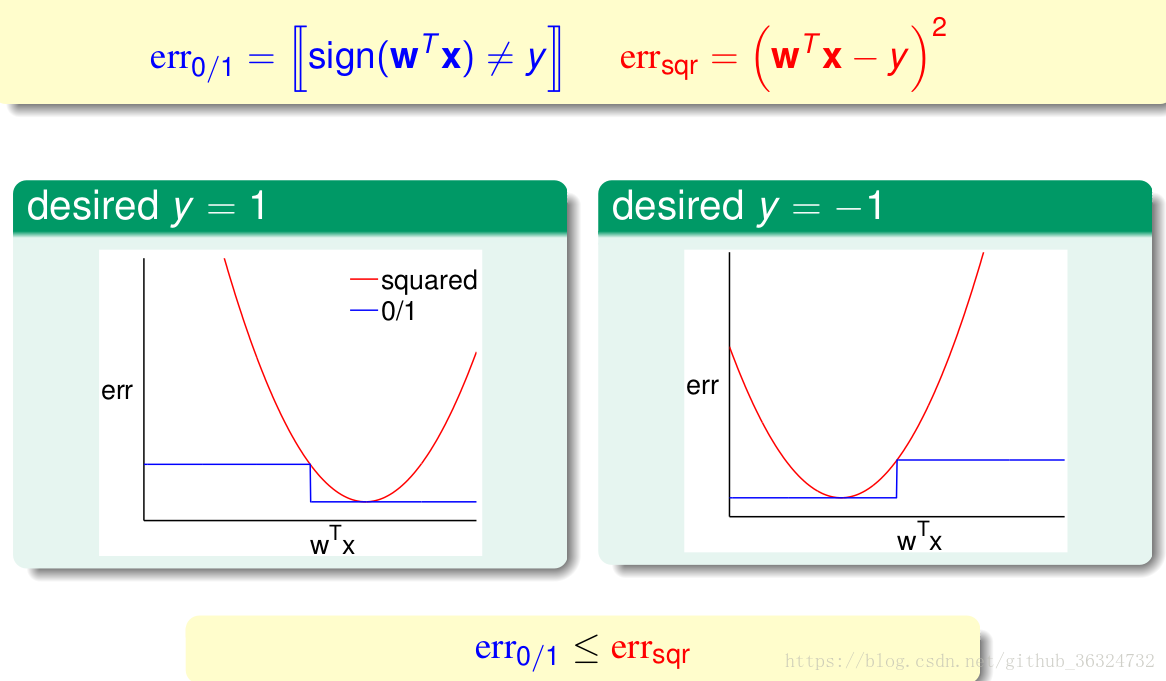
这里的trade-off的对象是算法的效率与error bound的紧密程度。

实际中甚至可以先做一个regression来求一个初始化参数值,然后再应用诸如PLA/Pocket这类的算法降低error。

 

斯坦福CS229机器学习课程2026版:从理论推导到代码实现的完整学习指南 机器学习作为人工智能的核心技术,其本质是通过算法让计算机从数据中学习规律并做出预测。其原理基于统计学、优化理论和概率论,通过构建模型最小化预测误差来实现智能决策。这项技术的价值在于能够处理海量数据、发现复杂模式,广泛应用于推荐系统、自然语言处理、计算机视觉等领域。对于希望深入理解算法本质而非仅停留在调包层面的开发者而言,掌握模型背后的数学推导与实现能力至关重要。斯坦福大学的CS229课程正是为此设计的经典理论课程,它系统覆盖从线性模型、支持向量机到神经网络等核心算法,强调通过公式推导和代码实践来构建扎实的机 阅读详情

相关推荐

【信息科学与工程学】【数据科学】第十八篇 数值分析 系列二 数值算法设计01

编号类型领域问题问题的数学分析及数值分析算法逐步推理思考的数学表达式参数列表及参数的边界范围及条件及常数关联知识1数值积分数值逼近计算定积分 I=∫ab​f(x)dx的近似值。数学分析:将积分区间等分,利用插值多项式近似被积函数,构造机械求积公式。数值分析:Newton-Cotes公式是等距节点的插值型求积公式。高阶公式(n≥8)因Cotes系数有正负,数值不稳定。偶阶公式(如Simpson)具有n+1次代数精度。为提高精度,常采用复化求积法(将区间细分后应用低阶公式)。

weixin_49199313的博客 161

【应用回归分析】CH3 回归参数的估计4——回归诊断

回归诊断简要介绍

m0_72318954的博客 2280

三极管吸潮失效分析案例

案例背景三极管也称为晶体三极管,它被视为电子电路中最重要的器件之一。三极管顾名思义具有三个电极,它最主要的功能是电流放大和开关作用。本次失效案例中的三极管在仓库存放一段时间后,在PCBA测试过程中集中发生不良。分析过程1.外观检测对失效样品进行外观检测,未发现明显破损、裂纹等不良。2.X-ray检测对失效样品进行X-ray检测,金线、绑定点未发现异常。3.开封检测对失效样品进行开封检测,发现存在键合点脱落的现象,键合点附近的晶圆破损。4.SEM检测对失效样品进行SEM检测,发现晶圆键合点位置有裂纹和破损,金

sy220504的博客 1044

台大林轩田·机器学习基石记要

台大林轩田·机器学习基石记要昨天开始看林轩田的机器学习基石,从今天起开始去粗取精 本文在差不多是随堂笔记,可读性不好。。第一讲比较基础,一些概念自己早已经理解了,所以不再做笔记,有点印象的是讲到了ML、DL、AI的一些联系与区别,ML主要是想从数据中学习/逼近一个理想的函数f(x)第二讲讲到了PLA,感知器学习算法,并且证明了线性可分时感知器收敛定理(与Haykin的Neural Networks

qiusuoxiaozi的博客 1万+

WinCC动态选择报警记录案例

本例中需要确认查询的时间段以及查询的关键字,然后通过一个按钮来执行报警数据查询脚本,并把查询出的结果加载到当前报警控件中。<本例中数据查询脚本的思路是根据选项组所选定的参数加载相应的归档变量到在线趋势控件,根据设定的查询时间范围设定控件时间轴的开始时间及结束时间。本文以 WinCC V8.0为例,介绍如何动态的查询WinCC报警记录,包括关键字查询/时间&关键字查询,如图1所示。<在WinCC变量管理中创建不同的变量组,并在变量组下创建相应的变量,如图2 所示(下图并非实际变量值)。

weixin_45072604的博客 2717

《Linux运维总结:Ubuntu22.04忘记root密码解决方案》

《Linux运维总结:Ubuntu22.04忘记root密码解决方案》

东城绝神 4462

机器学习基石9--Linear Regression

一、引入线性回归问题           Linear Regression是常见的一种机器学习算法。这里引入信用卡的例子,解决给用户发放信用卡额度的问题,【额度问题】这是一个回归问题。                             我们把用户的年龄、年收入等描述为特征存进X, 是常数项,为权重。我们写成向量形式 :,看起来非常像perceptron,不同的是 这里没用符号函数 。...

liuhehe123的博客 650

WPS和Excel通用!省市区四级联动下拉菜单保姆级教程(附最新行政区划数据包)

本文详细介绍了在WPS和Excel中实现省市区四级联动下拉菜单的完整教程,包含2024年最新行政区划数据的获取与整理方法。通过名称管理器和INDIRECT函数的组合,以及WPS的特色功能,帮助用户高效准确地录入四级行政区划信息,提升数据录入效率并减少错误。

s1t2u3的博客 617

幂等矩阵(Idempotent matrix)

在线性代数中,幂等矩阵是指一个矩阵乘以自己等于自己。也就是说,当且仅当MM==M时,M是幂等的;因此,M必须是方阵。从这个方面看,幂等矩阵是矩阵环的幂等元组成。 举例和这两个矩阵分别为和的幂等矩阵。 实数的幂等矩阵分析 如果矩阵是幂等的,则如下公式成立:                       (1)                        (2)          ...

qingsong1001的专栏 4万+

Android System Slice应用加载分析,及启用Slice后,锁屏日期第一次开机正常显示,但后面锁屏不显示问题分析

最近发现Android P上锁屏界面,日期不显示,发现从P开始后,出现了Slice来允许应用以模块化,可交互的方式,插入多个使用场景。Android P的system UI 也使用到了这一特性,表现为锁屏时间,日期,勿扰图标,闹钟等。 如何使用Slice 以System UI中KeyguardSliceView.java来说明它的使用方法 首先,我们打开System UI 的mk 文件,可以看到以...

qq_33595823的博客 3036

计算机技术发展5大阶段,现阶段计算机技术应用及发展

【摘要】现代计算机科学技术的发展和普及运用,为世界各国民众基础性生产生活实践活动的组织开展路径造成了深刻影响,本文围绕现阶段计算机技术应用及发展,择取两个具体方面,展开了简要分析。【关键词】计算机技术;应用;发展改革开放以来,计算机设备的广泛运用,促进了计算机科学技术的逐步发展成熟。计算机科学技术是具备新兴表现特征的尖端应用技术,其在现代工业生产和社会生活实践活动过程中的广泛引入运用,给世界各国基...

weixin_42126677的博客 2637

林轩田机器学习基石Lecture 9:Linear_Regression

@Lecture 9:Linear_Regression Linear Regression Problem 回归问题:输出空间为实数空间(连续) 希望观测值和预测值的差值越小越好 Err Measure: Linear Regression Algorithm 这一节讲如何最小化Ein的问题 先用矩阵形式对Ein进行展开简化 求Ein的最小值,即求Ein关于w的梯度为0 的点 对E...

qq_42580910的博客 245

使用Qt和MX Component插件实现与菱PLC的通信

在本文中,我们介绍了如何使用Qt和MX Component插件实现与菱PLC的通信。我们首先安装和配置了MX Component插件,并在Qt项目中初始化和使用MX Component来连接、读取和写入PLC的数据。安装完成后,您需要在Qt项目中配置MX Component的路径,以便Qt可以找到所需的库文件。在本文中,我们将探讨如何使用Qt和MX Component插件来实现与菱PLC的通信。在主函数中,我们将初始化MX Component,并创建一个与PLC通信的示例。在上面的代码中,我们使用了。

TlScratch的博客 996

Lecture 9: Linear Regression

Lecture 9: Linear Regression 【参考】https://redstonewill.com/232/ 【概括】 介绍了Linear Regression。 从问题出发,想要找到一条直线拟合实际数据值; 利用最小二乘法,用解析形式推导了权重w的closed-form解; 用图形的形式证明了linear regression是可以进行机器学习的; 证明linear regressin这种方法可以用在binary classification上,虽然上界变宽松了,但是仍然能得到不错的学习

weixin_43860935的博客 210

ADS基础教程12 - 参数扫描

在硬件设计、仿真以及调试阶段,很多时候需要找到一个合理的参数来使设计处于最优状态。前面所讲的调优方式是其中的最直接的手段。因此,本文将介绍ADS中如何指定元器件的参数为变量,并可以对变量设置相应的约束条件,来实现的变量进行多组参数的仿真结果的展示。在图形显示界面,添加一个Plot,并添加参数结果。此时,结果中会显示出所有的扫描结果。参数扫描的要素包含:新建变量、变量参数设置、扫描模型设置三个方面。如果找不到该图标,在菜单栏单击右键,弹出的对话框将。,弹出的选项卡中,将添加两个变量。点击菜单栏的仿真按钮。

XZ_ZC的博客 8164

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

机器学习基石 Lecture9: Linear Regression

机器学习基石 Lecture9: Linear RegressionLinear Regression ProblemLinear Regression AlgorithmGeneralization IssueLinear Regression for Binary Classification Linear Regression Problem 回到下发信用卡的例子。之前的例子里需要判断的是是...

无所知的博客 365

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

机器学习基石笔记-Lecture 9 Linear regression

线性回归的任务是对于一个输入,给出输出的实数,保证和真实输出相差越小越好。因为假设空间是线性的,所以最后的g会是直线或者平面。 通常的误差衡量方法是使用平方误差 接下来的问题是如何最小化 Ein 将Ein写成矩阵形式, 注意到Ein是w的函数,是连续的、可微的、凸函数。 对w求偏导使之为0则可以求出最优点。 这是一个关于w的一次方程。 在不可逆时,它的 p...

weixin_30614587的博客 112

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Coursera—Andrew Ng机器学习—课程笔记 Lecture 4_Linear Regression with Multiple Variables 多变量线性回归

假设两个特征,房屋尺寸的值为 0-2000 平方英尺,而房间数量的值为 0-5,对应的代价函数等高线图会显得很扁(skewed elliptical shape),梯度下降算法需要非常多。针对代价函数 J(Θ) 的每一项 J(Θj) ,设其偏导数为0。正规方程的思想:假设代价函数 J(Θ) 的偏导数等于0,求解方程,得到使代价函数 J(Θ) 最小的参数 Θ。此时模型中的参数是一个 n+1 维的向量,任何一个训练实例也都是 n+1 维的向量,特征矩阵 X 的维度是 m * (n+1)。

m0_63654706的博客 335

Lecture note 3: Linear and Logistic Regression in TensorFlow

Lecture note 3: Linear and Logistic Regression in TensorFlow

qq_32799915的博客 437

[翻译]斯坦福CS 20SI:基于Tensorflow的深度学习研究课程笔记,Lecture note 3: Linear and Logistic Regression in TensorFlow

“CS 20SI: TensorFlow for Deep Learning Research” Prepared by Chip Huyen Reviewed by Danijar HafnerLecture note 3: Linear and Logistic Regression in TensorFlow 个人翻译,部分内容较简略,建议参考原note阅读1. tensorflow的线

wangyuweihx的博客 1287

斯坦福CS229机器学习课程2026版:中文字幕与课件资源高效学习指南

机器学习作为人工智能的核心分支,其基础理论是理解现代算法模型的关键。从监督学习到无监督学习,其原理建立在统计学与优化理论之上,通过算法从数据中自动学习规律,为预测与决策提供支持。这一技术价值在于将数据转化为可行动的洞察,广泛应用于推荐系统、计算机视觉、自然语言处理等领域。对于希望系统掌握机器学习核心的学习者,斯坦福CS229课程提供了从线性回归到前沿模型的完整知识体系。本文聚焦于该课程2026年夏季最新版本,其配套的**中文字幕**和**官方课件**极大降低了学习门槛,并提供了从资源获取、学习路径规划到实践

weixin_30562507的博客 400

【原】Coursera—Andrew Ng机器学习—课程笔记 Lecture 4_Linear Regression with Multiple Variables 多变量线性回归...

Lecture 4 Linear Regression with Multiple Variables 多变量线性回归 4.1 多维特征 Multiple Features4.2 多变量梯度下降 Gradient Descent for Multiple Variables4.3 梯度下降法实践 1-特征缩放 Gradient Descent in Practice I - Feature Sc...

weixin_30301183的博客 202

斯坦福CS229机器学习课程2026版:系统学习权威指南与高效实践路径

机器学习作为人工智能的核心分支,其核心在于通过算法从数据中学习规律并进行预测或决策。其基本原理涉及模型构建、损失函数定义与优化算法迭代,旨在最小化预测误差。掌握机器学习理论对于构建智能系统、实现数据驱动决策具有重要技术价值,广泛应用于推荐系统、计算机视觉、自然语言处理等领域。本文聚焦于斯坦福大学CS229《机器学习》课程2026年夏季最新版,该资源以其权威性和系统性著称,提供了完整的课件与学习路径。课程内容覆盖了从监督学习到深度学习的完整知识体系,并融入了对Transformer等前沿架构的基础理论解读。对

weixin_34248487的博客 423

机器学习与模式识别 考点压缩 100%命中率

机器学习与模式识别 期末考点压缩 两天学完 力挽狂澜!

2301_80226956的博客 885

High-Resolution Image Synthesis with Latent Diffusion Models 基于潜在扩散模型的高分辨率图像合成

Robin Rombach 1 * Andreas Blattmann1 * Dominik Lorenz 1 Patrick Esser ® Björn Ommer 1 1 Ludwig Maximilian University of Munich & IWR, Heidelberg University, Germany ° Runway ML慕尼黑路德维希-马克西米利安大学 & 德国海德堡大学 IWR ° Runway MLhttps://github.com/CompVis/latent-diff

u013250861的博客 140

台湾大学林轩田机器学习基石课程学习笔记16(完结) -- Three Learning Principles

我的优快云博客地址:红色石头的专栏 我的知乎主页:红色石头 我的微博:RedstoneWill的微博 我的GitHub:RedstoneWill的GitHub 我的微信公众号:红色石头的机器学习之路(ID:redstonewill) 欢迎大家关注我!共同学习,共同进步! 上节课我们讲了一个机器学习很重要的工具——Validation。我们将整个训练集分成两...

红色石头的专栏 2万+
上一篇: 台大机器学习基石 Lecture 8 - Noise and Error
下一篇: 台大机器学习基石 Lecture 10 - Logistic Regression
ZayneHuang
博客等级 码龄10年 5粉丝 116原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值