基于丹摩DAMODEL部署Segment Anything 模型,智能分割一切图片

segment-anything本地部署使用 阅读详情

前言

最近在研究图像处理的过程中,接触到了Mate开源的图像分割项目segment-anything,看了他们官网的demo演示,感觉很神奇,也有有趣,上传一张图片,点击一下就能将点击的物体切割出来,很类似自动物体识别,智能抠图。于是决定深入研究需学习一番。要研究学习一个模型,必不可少地要用到GPU计算,这个时候我突然想起来之前注册的丹摩(DAMODEL)送了不少代金劵,于是租借一台GPU服务器来部署学习这个模型。文末有关于丹摩平台的介绍。

租借GPU服务器

点击此处,丹摩登录入口,登录丹摩
在这里插入图片描述
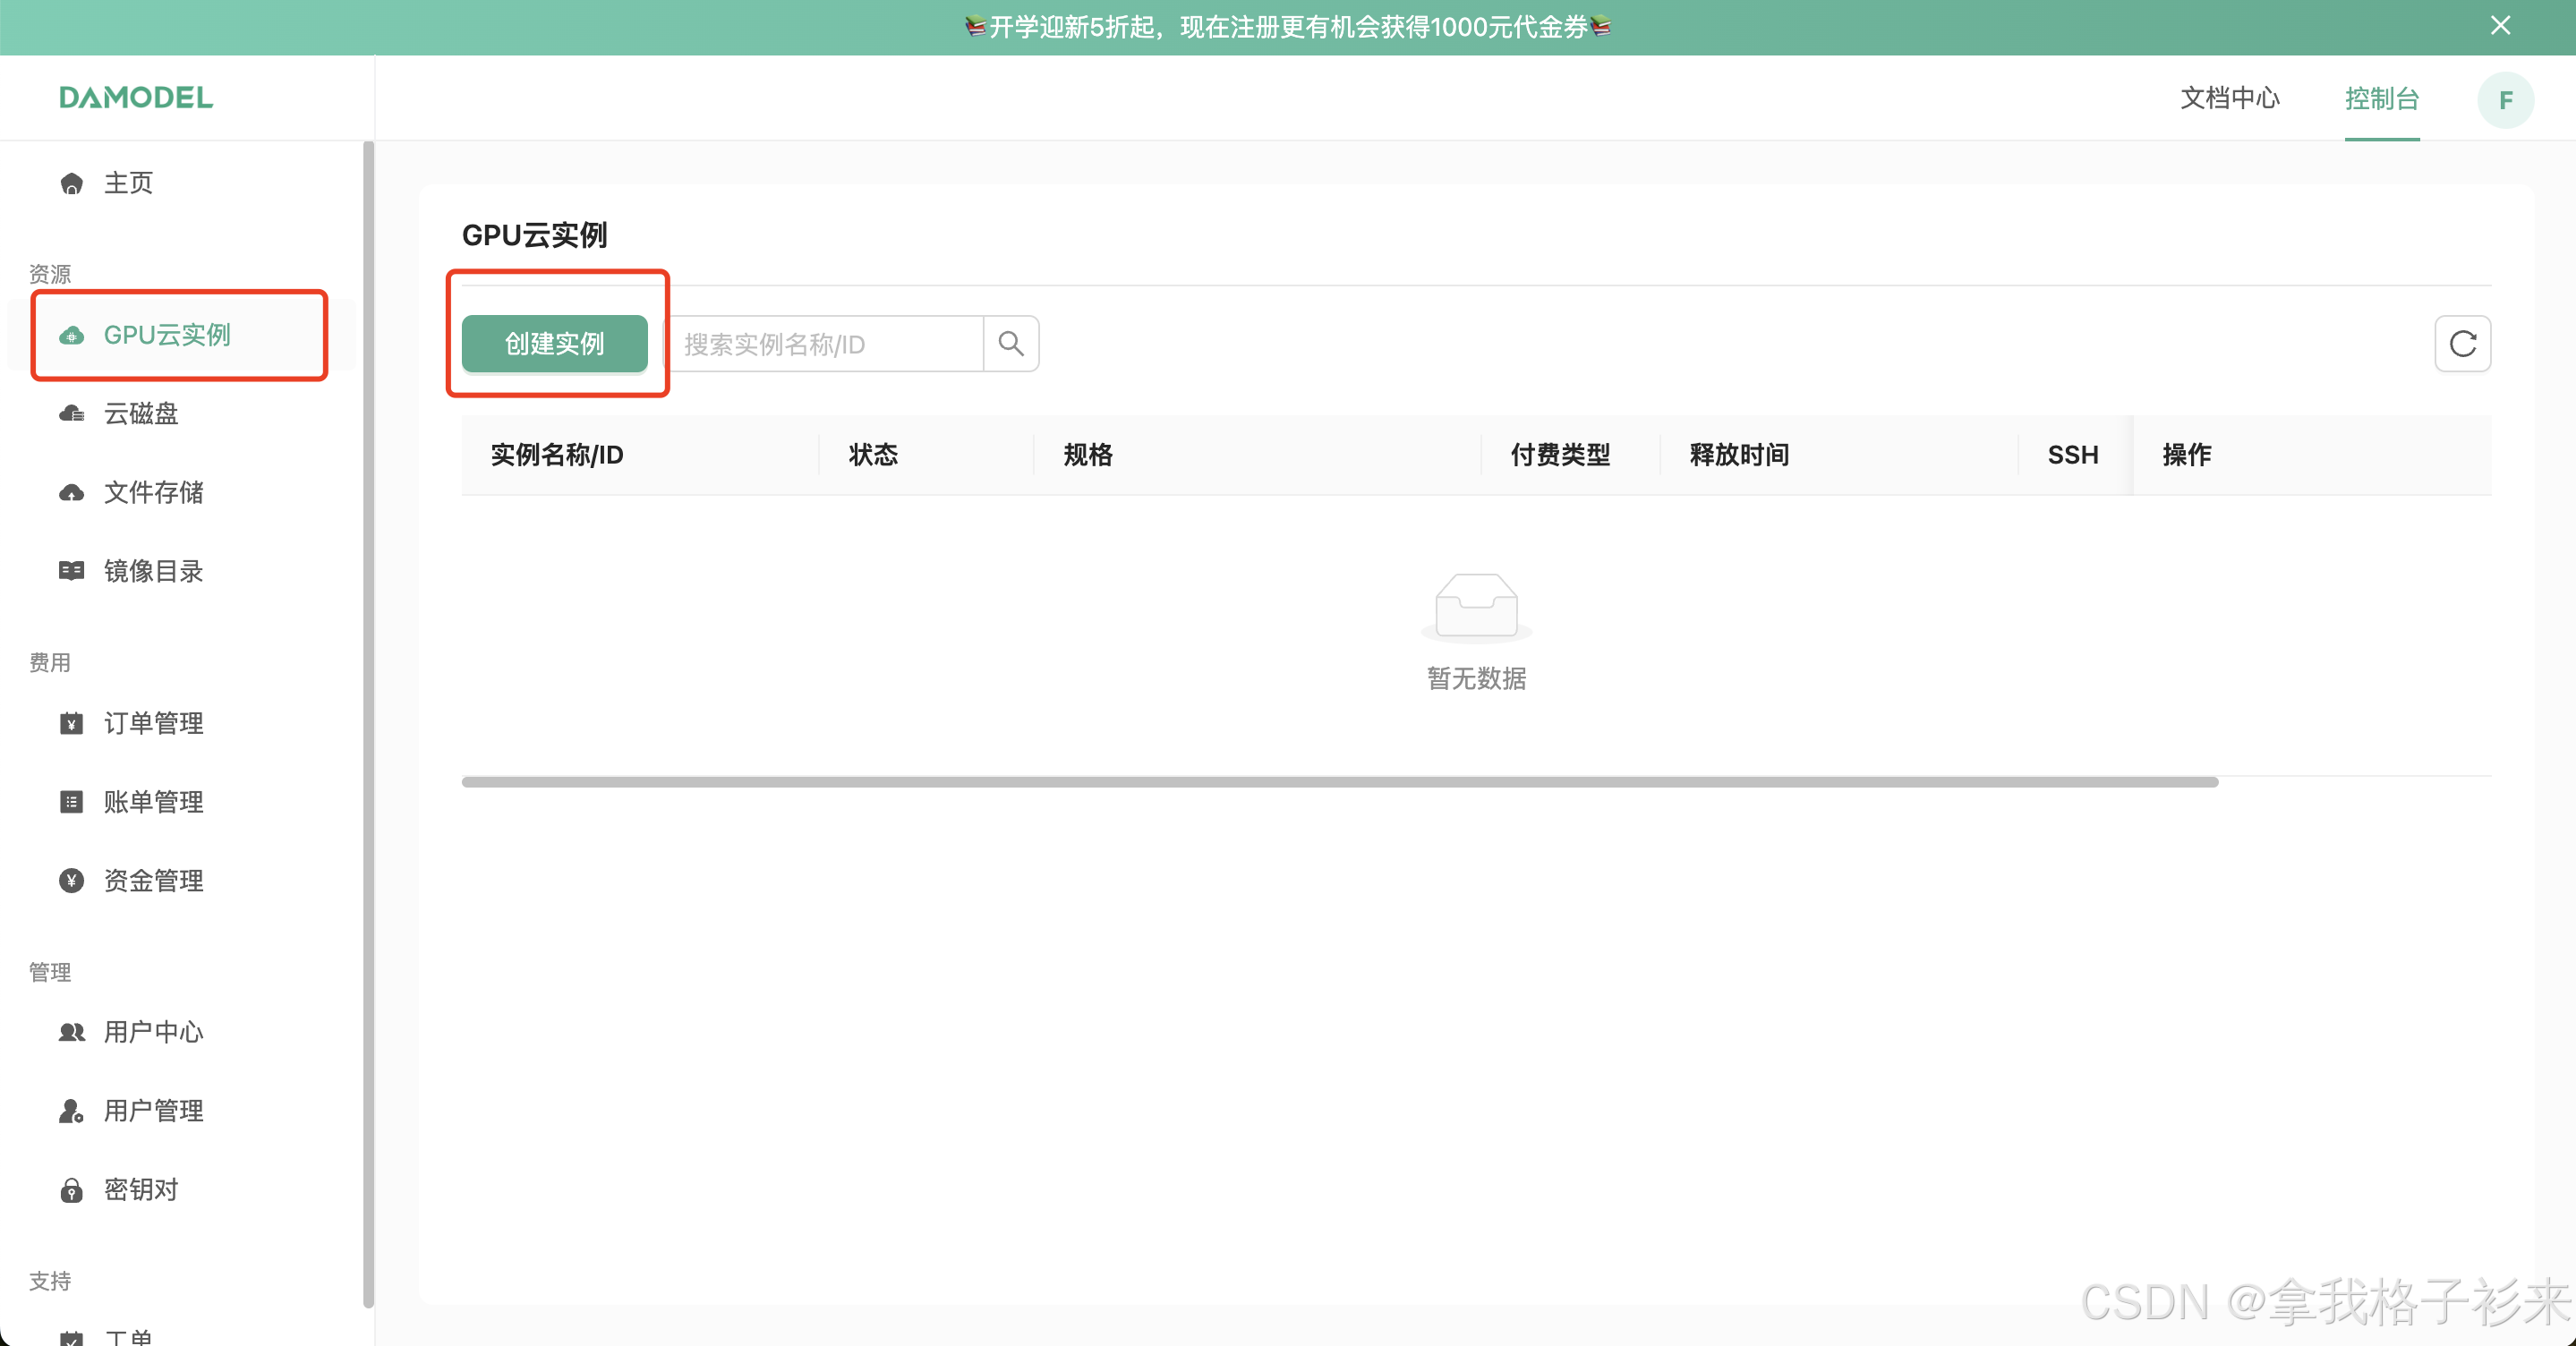
点击左侧菜单的GPU云实例,然后点击创建实例,
规格我们选择如下:

镜像选择
PyTorch 2.3.0
Python 3.10.14
系统 Ubuntu-22.04
CUDA版本:12.1

在这里插入图片描述
内置了CUDA,可自由选择PyTorch,PythonCUDA版本,这是我选择丹摩的重要原因。这些基础设置要是每次人为去安装配置,将会浪费大量时间。

注意:segment-anything 模型的要求 python>=3.8 , pytorch>=1.7, torchvision>=0.8

选择配置后,点击右下角的立即创建。
稍等片刻实例就会创建成功。
在这里插入图片描述

点击操作栏的JupyterLab 就能够打开实例中已经安的Jupyter。

你也可以使用访问链接和密码 来访问服务器的终端。

访问Jupyter进行编码
在这里插入图片描述

终端登录
在这里插入图片描述

Segment Anything 模型介绍

在这里插入图片描述
Segment Anything Model(SAM)可根据输入提示(如点或方框)生成高质量的对象遮罩,并可用于为图像中的所有对象生成遮罩。该模型已在一个包含 1100 万张图像和 11 亿个遮罩的数据集上进行过训练,在各种分割任务中都具有很强的零误差性能。
在这里插入图片描述

配置环境

通过上面的步骤我们已经进入到了GPU实例的终端,接下来我们要在这个实例上部署Segment Anything 模型。

要在实例中安装Segment Anything 模型,有两种方式

第一种:在实例的终端中执行下面的命令

pip install git+https://github.com/facebookresearch/segment-anything.git

第二种:你也可以执行下面的命令来安装

git clone git@github.com:facebookresearch/segment-anything.git
cd segment-anything; pip install -e .

安装还需要安装相关的依赖库

pip install opencv-python pycocotools matplotlib onnxruntime onnx

环境安装过程
在这里插入图片描述

通过上面的步骤,我么现在已经安装好了模型运行的环境。

下载模型,运行模型

安装好模型的运行环境后,我们需要下载官方训练好的分隔模型,一共有三个 分别是

这里以大杯ViT-H SAM model 模型为例,使用浏览器下载,大概有2.4G。然后我们将其上传到丹摩平台的文件存储。
在这里插入图片描述
如果直接在实例中下载,会比较漫长。通过上传到文件存储就会自动挂载到实例中,这里存储的根文件对应到实例中目录 /root/shared-storage
在这里插入图片描述
文件上传成功后,我们可以在实例的终端中看到这些文件。如下图:
在这里插入图片描述
文件和服务都准备好后,我们下面开始测试一下模型,处理分割一些文件。

测试模型

我们使用上传的模型,对一张图片进行分割,然后分割后的图片,放到一个目录里。
原始图片de.png
在这里插入图片描述

然后我们进入 segment-anything的目录,执行下面的指令。

python scripts/amg.py --checkpoint /root/shared-storage/sam_vit_h_4b8939.pth --model-type vit_h --input /root/shared-storage/de.png --output /home/imgoutput

使用sam_vit_h_4b8939.pth模型将 de.png 图片进行分割,分割后的图片存放在/home/imgoutput目录中。
执行过程如下:
在这里插入图片描述

进入/home/imgoutput目录,可以看到有一个de目录,de就是图片的名称。
在这里插入图片描述
一张图片分割了39个图片,我们看一下这些分割的图片是什么样的。分割后的图片如下图: 在这里插入图片描述
文件 matedata.csv的内容如下:
在这里插入图片描述
到这里我们已经成功地将模型部署到GPU的实例中了。
运行一次该模型,消耗的资源还是比较小的,在丹摩的实例监控图上,基本看不到资源的负载太大的起伏如下图:
在这里插入图片描述

运行Demo

上面我们已经使用模型将图片分割出来了,那么下面看一下,该如何使用官方提供的demo,查看一个图片的分割块。

这里是官方提供的一个demo,这个demo简单展示了如何使用Segment Anything 模型切割出来的数据,展示效果如下:

下面我教大家将该demo运行起来。
首先在jupyter中运行下面的代码,

import numpy as np
import cv2
from segment_anything import SamPredictor, sam_model_registry
checkpoint = "/root/shared-storage/sam_vit_h_4b8939.pth"
model_type = "vit_h"
sam = sam_model_registry[model_type](checkpoint=checkpoint)
sam.to(device='cuda')
predictor = SamPredictor(sam)
image = cv2.imread('/root/shared-storage/de.png')
predictor.set_image(image)
image_embedding = predictor.get_image_embedding().cpu().numpy()
np.save("de_embedding.npy", image_embedding)

运行后会生成一个de_embedding.npy文件将该文件下载到本地,并放在segment-anythingdemo/src/assets/data/目录中
在这里插入图片描述

然后再运行以下指令导出web使用的onnx模型

python scripts/export_onnx_model.py --checkpoint /root/shared-storage/sam_vit_h_4b8939.pth --model-type vit_h --output /root/shared-storage/sam_vit_h_onnx_example.onnx

正常运行完成后,将/root/shared-storage/sam_vit_h_onnx_example.onnx文件放置在项目目录segment-anything/demo/model/sam_vit_h_onnx_example.onnx

然后在 demo目录 修改App.tsx的引用文件路径
在这里插入图片描述

最后在demo目录运行

yarn && yarn start

浏览器打开启动的服务,一般是 http://localhost:8081/

看一下动态效果图:
在这里插入图片描述
鼠标放置在某一色块上,该色块就会被增加一层阴影,标识被识别,分割出来啦。如果要做成官网那种交互效果还需要花点前端的功夫。
如果有人需要,我也可以努力尝试做出官方的效果。
在这里插入图片描述

丹摩平台介绍

DAMODEL(丹摩智算)是专为 AI 打造的智算云,致力于提供丰富的算力资源与基础设施助力 AI 应用的开发、训练、部署。

平台特性:

  • 💡 超友好!

    配备 124G 大内存和 100G 大空间系统盘,一键部署,三秒启动,让 AI 开发从未如此简单!

  • 💡 资源多!

    从入门级到专业级 GPU 全覆盖,无论初级开发还是高阶应用,你的需求,我们统统 Cover!

  • 💡 性能强!

    自建 IDC,全新 GPU,每一位开发者都能体验到顶级的计算性能和专属服务,大平台值得信赖!

  • 💡 超实惠!

    超低价格体验优质算力服务,注册即送优惠券!还有各类社区优惠活动,羊毛薅不停!

总结

通过使用丹摩DAMODEL部署Segment Anything 模型,我们了解了平台的使用方法,平台的各种资源使用,实例规格,也知道了在部署Segment Anything 模型需要注意哪些事项。再部署模型后,后续我们可以集成一个后端开发框架,让用户上传图片,然后进行图片切割,做成一个智能抠图的产品或服务。

【项目学习】记录segment-anything、SAM及衍生自动标注工具使用 记录segment-anything、SAM及衍生标注工具使用 阅读详情

相关推荐

Segment Anything Model (SAM)本地部署,及应用于自己的数据集完成分割

官网提供了一些demo,交互式地分割展示,可以试一下官网demo提供了3种分割方式。

MayYou_SSS的博客 3万+

计算机视觉:分割一切AI大模型segment-anything

Segment Anything Model (SAM)来源于Facebook公司Meta AI实验室。据Mata实验室介绍,SAM 已经学会了关于物体的一般概念,并且它可以为任何图像或视频中的任何物体生成 mask,甚至包括在训练过程中没有遇到过的物体和图像类型。SAM 足够通用,可以涵盖广泛的用例,并且可以在新的图像领域上即开即用,无需额外的训练。在深度学习领域,这种能力通常被称为零样本迁移(这种能力正是GPT4 震惊世界的一大原因).

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 8603

LangGraph实战:用Plan-and-Execute模式5步搭建智能问答机器人(附Tavily搜索集成)

本文详细介绍了如何利用LangGraph的Plan-and-Execute模式,通过规划、执行、动态调整三个核心阶段,构建一个能够处理复杂多步骤问题的智能问答机器人。文章提供了从环境配置、状态管理到核心节点(规划、执行、重新规划)实现的完整实战指南,并集成了Tavily搜索工具,展示了如何将智能任务规划应用于实际信息查询场景。

weixin_29258297的博客 343

【深度学习】SAM(Segment-Anything)代码详解

当为true的时候会返回3个mask,对于模棱两可的prompt比如一个点,多输出可以比单单输出产生更高质量的Mask,如果只有一个mask是被需要的,可以通过quality score 来筛选mask,对于非模棱两可的输入,比如多个prompt,将multmask_output设置为false可以得到更好的结果return_logits。这个文件包含三层的封装,最外层是sam_model_registry,它提供了统一的接口,用来选择vit_h,vit_l,vit_b,默认使用vit_h。

千禧皓月的博客 1万+

避坑指南:DeepSeek Function calling流式输出中的常见问题与解决方案

本文深入探讨了在DeepSeek Function Calling中实现流式输出时常见的参数拼接、函数依赖管理和错误处理等核心挑战。针对流式响应中参数碎片化的问题,提供了健壮的参数拼接方案与状态管理策略。同时,文章详细阐述了如何管理函数调用顺序、处理条件性执行,并构建了分阶段的错误处理与重试机制,旨在帮助开发者构建稳定、高效的流式AI应用。

weixin_29062671的博客 204

光猫改桥接后,一根网线搞定IPTV和上网的保姆级教程(附VLAN配置避坑点)

本文详细介绍了光猫改桥接后如何通过单线复用技术实现IPTV和上网功能共存。从VLAN配置原理到具体操作步骤,包括光猫超级管理员权限获取、VLAN绑定设置及路由器IPTV功能配置,提供了全面的保姆级教程。特别针对常见问题如IPTV信号丢失、网速下降等给出了实用解决方案,帮助用户轻松避坑。

weixin_29927965的博客 1807

基于Segment Anything 模型的智能抠图开发的产品原型,基于官网案例升级改造

最近在研究图像处理的过程中,接触到了Mate开源的 Segment Anything模型,花点时间研究了一番,之前也写了一篇部署模型的教程,感兴趣的同学可以查看一下之前的文章Segment Anything模型 人工智能计算机视觉研究分割任何物体模型 (SAM):Meta AI 推出的一种新型 AI 模型,只需单击即可“剪切”任何图像中的任何物体SAM 是一种可提示的分割系统,具有对不熟悉的物体和图像的零样本泛化能力,无需额外的训练。

知无涯 1万+

手把手教你用Nangate 45nm开源工艺库搞定数字电路仿真(附FreePDK资源)

本文详细介绍了如何使用Nangate 45nm开源工艺库进行数字电路仿真,包括环境搭建、关键文件解析、仿真环境配置及低功耗设计等实战内容。特别推荐FreePDK资源,帮助读者快速掌握从理论到实践的全流程操作,适用于学术研究和小规模数字电路设计。

weixin_30352645的博客 491

【Python&语义分割】Segment Anything(SAM)模型详细使用教程+代码解释(一)

Segment Anything可以实现对任意物体的识别和分割提供了简单易用的接口,用户只需要通过提示,即可进行物体识别和分割操作,今天给大家分享一下SAM的源码。

Remote Sensing迷途小书童 2万+

光互联技术演进:OIO、OBO、NPO、CPO四种方案对比与选型指南

光互联技术是解决高速数据中心和AI算力集群带宽瓶颈的关键路径。其核心原理是将光电转换点从面板向交换芯片逐步拉近,以缩短电通道、降低功耗并改善信号完整性。按照光电转换位置与芯片的距离,光互联可分为OIO、OBO、NPO和CPO四种技术路线,各自在功耗、可维护性和成熟度上存在显著差异。在AI训练集群、运营商网络等场景中,选型需综合考量功耗预算、运维体系和供应链生态。本文深入拆解这四种方案的技术细节、工程挑战与部署策略,为光互联技术选型提供实操参考。

weixin_33393017的博客 173

[机器学习] 第二章 模型评估与选择 2.ROC:roc_curve原理及源代码详解

代码见:https://github.com/Carrie-Yi/machine_learning/tree/main/roc_curve

心宝的博客 1496

Segment Anything使用手册(交互式数据标柱|自动数据标柱)

主要内容包含segment-anything项目的安装、基于SamPredictor对单点输入生成mask、基于SamPredictor对多点输入生成mask、基于SamAutomaticMaskGenerator自动生成mask。Segment Anything项目是一个可以对任何图像进行分割的项目,其论文介绍可以查看https://blog.youkuaiyun.com/a486259/article/details/131137939,其测试网站为 https://segment-anything.com。

a486259的博客 1万+

HSM 网络安全 信息安全

HSM HSM信息安全功能 汽车电子网络安全中HSM 的应用场景 选择适合汽车电子网络安全的 HSM 符合汽车安全标准和法规要求的HSM HSM 在汽车电子网络安全中的可靠性和安全性 评估汽车电子网络的安全性 汽车 HSM(Hardware Security Module)模块开发 汽车 HSM(Hardware Security Module)模块测试

天赐好车的博客 1243

从0到1全流程使用 segment-anything

全流程使用 segment-anythin

碳学长的博客 7105

具身智能(26):RDK S100的LeRobot或Agile X piper机械臂控制模型

本文档详细介绍了基于ROS2的机器人控制模型架构与标定数据联动机制。核心采用"感知-规划-控制"闭环流程,通过激光雷达、相机和IMU的融合数据实现厘米级定位(≤1cm)。文档包含两大控制模型配置:1)RDKLeRobot模型,重点说明PID参数调节和标定文件路径设置;2)AgileXPiper模型,强调驱动安装与外部标定文件集成。针对常见问题提供解决方案,如控制指令无响应需验证标定路径,运动偏差过大需重新标定等。最后给出批量部署方案,通过复制基准配置文件实现多机器人快速配置,要求定位偏差

码农17年的博客 179

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

【segment-anything】- Meta 开源万物可分割 AI 模型

Meta 开源万物可分割 AI 模型:segment anything model (SAM)。 本文列举了一些资料,并从SAM的功能介绍、数据集、数据标注、图像分割方法介绍,研发思路以及对未来的展望来展开详细介绍。并综合了一些评价谈论,放眼当下和展望未来,给出了一些个人的想法和看法。

KEEP的博客 6924

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

DAMODEL丹摩|丹摩平台操作指南

本文章主要介绍丹摩平台的使用流程,包括网站地址,网站注册流程以及使用教程,详细如下,咱们接着往下看GPU云实例该模块记录当前账号上的GPU云实例信息,包含总实例数,运行中的数量,即将到期数量和即将释放的数量存储空间该模块记录存储空间的使用情况,包含累计使用量,累计镜像使用量和累计文件存储使用量,以及每小时存储空间的使用情况费用该模块记录当前账号上的费用信息,包含账户余额,以及今天消费的金额情况常用文档该模块中记录丹摩平台常用的操作文档,可以点击文档浏览丹摩平台的相关知识点,非常方便新手入门使用。

2401_88842840的博客 2514

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Meta:segment anything

令人惊讶的是,我们发现一个简单的设计可以满足所有三个约束条件:一个强大的图像编码器计算图像嵌入,一个提示编码器嵌入提示,然后两个信息源在一个轻量级的掩码解码器中进行组合以预测分割掩码。在自然语言处理领域,以及近年来的计算机视觉领域,基础模型是一种有前途的发展,通常可以通过“提示”技术实现对新数据集和任务的零样本和小样本学习。其次,我们发现在使用提示工程的零-shot转移协议下,在各种下游任务中,包括边缘检测、目标提议生成、实例分割以及文本到掩模预测的初步探索中,我们都获得了一致强劲的定量和定性结果。

2021

segment-anything介绍

segment-everything介绍

qq_30150579的博客 8470

DAMODEL丹摩|从创建到连接

DAMODEL(丹摩智算)是专为 AI 打造的智算云,致力于提供丰富的算力资源与基础设施助力 AI 应用的开发、训练、部署。

SHJ220769的博客 1638

Segment Anything(SAM)的demo的简单使用

cmd命令:注意notebooks/images/是指你的输入图片路径,output是指的输出mask的路径,后面的--device cpu如果加了,就会采用cpu跑,不然会默认GPU。进行安装即可,对了我是用的anconda环境,建议创建一个新的虚拟环境,避免干扰自己的其他配置,注意python版本一定要>=3.8。识别是最基础也是最重要的,那么分割在识别里面更是重中之重,所以这个大模型分割真的是:一个字“6”.我们都知道在CV领域比较重要的处理图像的几个方向有:识别,测量(标定),三维物体重建等。

Helloorld_1的博客 2万+

丹摩|丹摩智算平台评测与使用体验

丹摩智算平台结合了数据处理、机器学习、深度学习与可视化分析等多种功能,目标是简化数据科学工作的流程。用户可以在没有复杂环境搭建的前提下,利用云端的强大计算资源进行开发与实验。通过本次评测,我们深入体验了丹摩智算平台的强大功能,尤其是在数据处理、可视化与机器学习模型训练方面的优势。若您正寻求一款高效的云计算平台来开展数据科学项目,丹摩智算平台无疑是非常值得尝试的选择。您的反馈与讨论是推动我们不断改进的重要动力,欢迎您在平台内外分享您的体验与想法!

2401_88810025的博客 1494

图像万物分割——Segment Anything算法解析与模型推理

这个模型(SAM)训练完成之后,以使其具备"promptable"(可提示)的性质,因此意味着它可以零样本(zero-shot)地适应新的数据集和任务,而无需先对数据进行标注和训练。作者对该模型进行了广泛的评估,发现它在许多任务上的零样本表现通常与完全监督的性能相媲美,甚至更好。

知来者逆的博客 1万+

丹摩DAMODEL超算平台 | 搭建Llama3.1深入体验

丹摩DAMODEL超算平台 | 搭建Llama3.1深入体验

wei_shuo的博客 1万+

丹摩|丹摩智算平台使用教学与操作指南

总的来说,我对DAMODEL平台的评测结果非常满意。它不仅提供了高性能的GPU资源和丰富的API接口,还非常注重灵活性和便捷性。这些特点让我能够更专注于研究本身,而不是被繁琐的操作所困扰。我相信,在未来的发展中,DAMODEL平台将会越来越完善,为更多的研究者提供更高效、更便捷的计算服务。我相信,在大家的共同努力下,AI大模型的学习与发展一定会取得更加辉煌的成就!

ty666_的博客 898

丹摩|丹摩智算平台评测:高效云端计算的卓越体验

在AI技术蓬勃发展的今天,丹摩智算平台犹如一颗璀璨的新星,为众多研究者和炼丹师们提供了强大的计算支持。

2401_83509671的博客 563
上一篇: 使用一个网站链接来按照目录下载存放网站资源,使用资源列表批量下载资源,自动分目录存放
下一篇: 基于ThingsBoard的Rest API与 MQTT API 来获取设备历史数据训练模型,并实时预测异常,将异常结果上传到ThingsBoard,创建告警
拿我格子衫来
拿我格子衫来 领域专家: 前端开发技术领域 领域专家: 前端开发技术领域
博客等级 码龄10年 6万+粉丝 858原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

拿我格子衫来

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值