调用AI 通过相机识别地标

React Native集成Vision AI:从零构建地标识别应用实战指南 计算机视觉(CV)作为人工智能的核心分支,其核心原理是让机器理解和解释视觉世界。通过图像识别、目标检测等技术,CV能够从像素数据中提取有意义的信息。这项技术的核心价值在于将非结构化的视觉数据转化为结构化的知识,从而赋能各类应用。在移动开发领域,结合跨平台框架与云端AI服务,可以快速构建出功能强大的智能应用。本文聚焦于一个典型的工程实践场景:使用React Native框架,集成Google Cloud Vision API等云端服务,实现一个完整的地标识别应用。内容涵盖从图像获取与预处理、服务集成、状态管理 阅读详情

https://www.youtube.com/watch?v=ViRfnLAR_Uc&list=PLQkwcJG4YTCRJxkPPDBcKqDWrfF5qanQs&index=3学习视频

TensorFlow Hub 机器学习模型的代码库

找到地标模型

如何在Android上使用ts模型

https://blog.tensorflow.org/2018/03/using-tensorflow-lite-on-android.html

1.下载模型后放在 asset 下
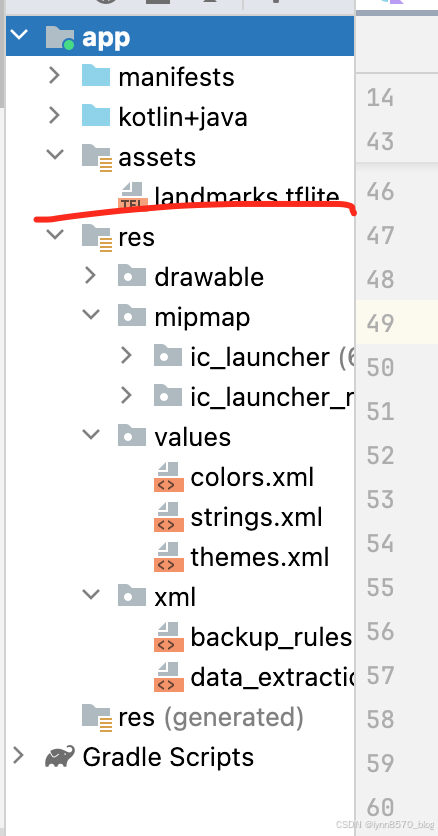
这个模型大概就有50M了

添加依赖

 val cameraxVersion = "1.3.0-rc01"

    implementation("androidx.camera:camera-core:$cameraxVersion")
    implementation("androidx.camera:camera-camera2:$cameraxVersion")
    implementation("androidx.camera:camera-lifecycle:$cameraxVersion")
    implementation("androidx.camera:camera-video:$cameraxVersion")

    implementation("androidx.camera:camera-view:$cameraxVersion")
    implementation("androidx.camera:camera-extensions:$cameraxVersion")

    implementation("org.tensorflow:tensorflow-lite-task-vision:0.4.0")
    implementation("org.tensorflow:tensorflow-lite-gpu-delegate-plugin:0.4.0")
    implementation("org.tensorflow:tensorflow-lite-gpu:2.9.0")

我们希望可以通过ts模型识别图片,这个结果我们放在 Classification 中,自己定义

data class Classification(
    val name: String,
    val score: Float
)

定义一个识别接口,然后我们可以有TS模型识别,以后有其他的模型,也可以实现其他的模型进行切换

interface LandmarkClassifier {
    fun classify(bitmap: Bitmap, rotation: Int): List<Classification>
}

实现通过ts的API处理bitmap,识别,读取结果


class TfLiteLandmarkClassifier(
    private val context: Context,
    private val threshold: Float = 0.5f,
    private val maxResults: Int = 3
): LandmarkClassifier {

    private var classifier: ImageClassifier? = null

    //创建图片识别 classifier
    private fun setupClassifier() {
        val baseOptions = BaseOptions.builder()
            .setNumThreads(2)
            .build()
        //基础参数
        val options = ImageClassifier.ImageClassifierOptions.builder()
            .setBaseOptions(baseOptions)
            .setMaxResults(maxResults)
            .setScoreThreshold(threshold)
            .build()

        //从asset创建
        try {
            classifier = ImageClassifier.createFromFileAndOptions(
                context,
                "landmarks.tflite",
                options
            )
        } catch (e: IllegalStateException) {
            e.printStackTrace()
        }
    }

    override fun classify(bitmap: Bitmap, rotation: Int): List<Classification> {
        if(classifier == null) {
            setupClassifier()
        }

        //处理bitmap
        val imageProcessor = ImageProcessor.Builder().build()
        val tensorImage = imageProcessor.process(TensorImage.fromBitmap(bitmap))

        val imageProcessingOptions = ImageProcessingOptions.builder()
            .setOrientation(getOrientationFromRotation(rotation))
            .build()

        //ts 的 api
        val results = classifier?.classify(tensorImage, imageProcessingOptions)


        //把结果flapmap,
        //合并,然后根据名字 distinct
        return results?.flatMap { classications ->
            classications.categories.map { category ->
                Classification(
                    name = category.displayName,
                    score = category.score
                )
            }
        }?.distinctBy { it.name } ?: emptyList()
    }

    private fun getOrientationFromRotation(rotation: Int): ImageProcessingOptions.Orientation {
        return when(rotation) {
            Surface.ROTATION_270 -> ImageProcessingOptions.Orientation.BOTTOM_RIGHT
            Surface.ROTATION_90 -> ImageProcessingOptions.Orientation.TOP_LEFT
            Surface.ROTATION_180 -> ImageProcessingOptions.Orientation.RIGHT_BOTTOM
            else -> ImageProcessingOptions.Orientation.RIGHT_TOP
        }
    }
}

我们在相机的Analyzer中使用分析器

LandmarkRecognitionTensorflowTheme {
                //分析器
                val analyzer = remember {
                    LandmarkImageAnalyzer(
                        classifier = TfLiteLandmarkClassifier(
                            context = applicationContext
                        ),
                        onResults = {
                            classifications = it
                        }
                    )
                }
                val controller = remember {
                    LifecycleCameraController(applicationContext).apply {
                        setEnabledUseCases(CameraController.IMAGE_ANALYSIS)
                        setImageAnalysisAnalyzer(
                            ContextCompat.getMainExecutor(applicationContext),
                            analyzer
                        )
                    }
                }
                Box(
                    modifier = Modifier
                        .fillMaxSize()
                ) {
                    CameraPreview(controller, Modifier.fillMaxSize())

                }
            }
        }

处理图片,根据ts 的文档,把图片裁剪处理成321*321

而且为了性能问题

并不是每一帧都是分析,所以加了 frameSkipCounter‘

每60帧才分析,提高性能体验,

最后别忘了关掉imageproxy

class LandmarkImageAnalyzer(
    private val classifier: LandmarkClassifier,
    private val onResults: (List<Classification>) -> Unit
): ImageAnalysis.Analyzer {

    private var frameSkipCounter = 0

    override fun analyze(image: ImageProxy) {
        if(frameSkipCounter % 60 == 0) {
            val rotationDegrees = image.imageInfo.rotationDegrees
            val bitmap = image
                .toBitmap()
                .centerCrop(321, 321)

            val results = classifier.classify(bitmap, rotationDegrees)
            onResults(results)
        }
        frameSkipCounter++

        image.close()
    }
}

最后我们把结果显示出来

在result中

  var classifications by remember {
                    mutableStateOf(emptyList<Classification>())
                }
 Column(
                        modifier = Modifier
                            .fillMaxWidth()
                            .align(Alignment.TopCenter)
                    ) {
                        classifications.forEach {
                            Text(
                                text = it.name,
                                modifier = Modifier
                                    .fillMaxWidth()
                                    .background(MaterialTheme.colorScheme.primaryContainer)
                                    .padding(8.dp),
                                textAlign = TextAlign.Center,
                                fontSize = 20.sp,
                                color = MaterialTheme.colorScheme.primary
                            )
                        }
                    }

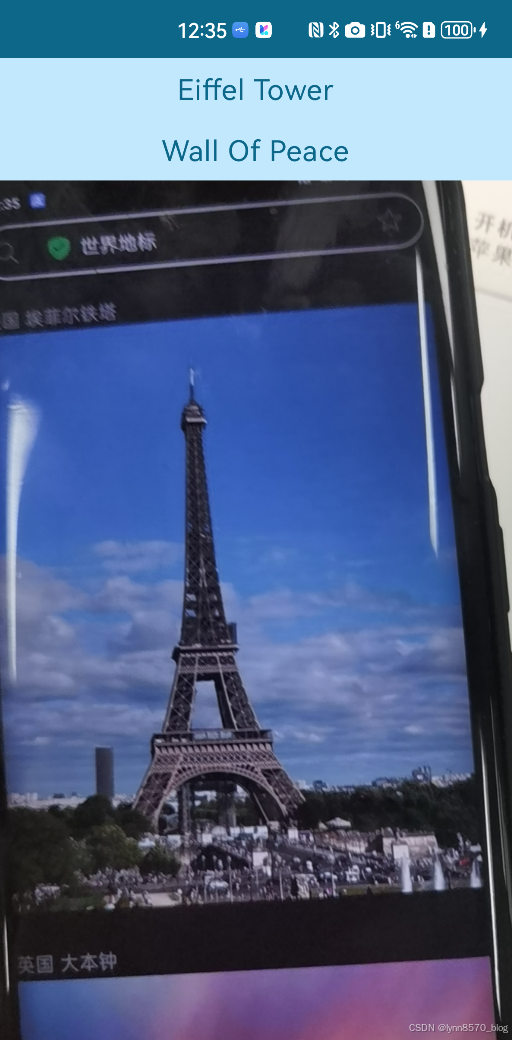
效果

图片识别,显示

2、低分辨率实时图像中的地标识别与人体姿态估计 本文介绍了一种在低分辨率实时图像中进行地标识别与人体姿态估计的新方法。该方法结合了深度学习技术,利用COCO预训练机械模型、多级S形(MUSIG)激活函数和边界框算法,实现了对人体关键点的高效识别。通过在KTH数据集上的实验验证,该方法在关键点检测方面优于现有技术。文章还讨论了其在安防监控、智能体育训练及虚拟现实等领域的应用前景,并提出了未来优化方向。 阅读详情

相关推荐

从HSPICE到Spectre:手把手教你搞定不同SPICE仿真器的网表转换(附避坑指南)

本文详细介绍了从HSPICE到Spectre的SPICE仿真器网表转换方法,包括核心语法差异、分步转换流程和常见问题排查。通过实战案例和避坑指南,帮助工程师高效解决不同SPICE仿真器间的兼容性问题,提升集成电路设计效率。

weixin_29745609的博客 369

AI人工智能课题:图像识别地标识别系统的设计与实现(基于百度智能云AI接口)

AI人工智能课题:图像识别地标识别系统的设计与实现(基于百度智能云AI接口)。研究思路与研究方法、可行性: 本研究的思路是基于百度智能云AI接口,使用图像识别API实现地标识别,并与地理位置数据和地标特征描述进行关联。后台功能需求分析和前端功能需求分析: 后台功能需求包括:图像上传和处理、地标识别和信息提取、地标数据管理和存储。研究内客和创新点: 本研究的内客是设计和实现一种能够自动识别图像中地标的系统。与现有的图像识别地标系统相比,本系统使用百度智能云AI接口,具有开发简洁、计算资源需求低等优点。

杭州.黄老师 5892

AI系统架构设计实战:AI应用架构师的深度指南

核心概念:AI系统架构是指设计和组织人工智能系统各个组件(包括数据、算法、计算资源、集成接口等)的结构框架,以及这些组件之间的交互方式和原则。它为AI应用提供了技术蓝图,决定了系统的性能、可扩展性、可维护性和可靠性。数据的本质:数据是对客观事物的符号表示,是可识别的、抽象的符号。在AI系统中,数据不仅是输入,也是系统学习和改进的基础。数据就像AI系统的"燃料",其质量和数量直接决定了AI系统的能力边界。

AI天才研究院 1203

百度AI攻略:地标识别

1.需求及方案: 在我以前的一个帖子https://ai.baidu.com/forum/topic/show/943365里面讲了怎么通过图像分割来旅游。 这一次我要说一下怎么通过地标识别+百度百科带大家来看遍/认识天下名胜。 2.平台接入 地标识别接入网址:https://console.bce.baidu.com/ai/#/ai/imagerecognition/overview/i...

2750

VMD分子可视化实战:5个隐藏技巧让你的科研图像秒变顶刊级别

本文深入探讨了VMD分子可视化软件在科研图像美化中的5个高阶技巧,旨在帮助研究者将分子结构图提升至顶刊级别。内容涵盖原子色彩与材质的艺术化定制、沉浸式分子环境构建、专业构图与视角控制、数据驱动的动态可视化以及自动化工作流建立,通过精细的色彩映射、光照调整、周期性边界展示和脚本自动化,显著增强图像的科学叙事性与视觉冲击力。

weixin_29240343的博客 423

若依前后端分离版实战:MQTT集成保姆级教程(含MQTTX测试工具使用)

本文详细介绍了在若依前后端分离架构中集成MQTT协议的完整流程,包括环境搭建、核心配置、安全实践及性能优化。通过MQTTX测试工具的使用和实战代码示例,帮助开发者快速实现物联网场景下的实时通信功能,提升系统稳定性和效率。

weixin_30664051的博客 458

CameraX系列四:图片分析

图片分析 图片分析用例为您的应用提供可供 CPU 访问的图片来执行图片处理、计算机视觉或机器学习推断。应用会实现对每个帧运行的analyze()方法。 实现 通过将执行图片分析的执行程序和ImageAnalysis.Analyzer参数传递到setAnalyzer()方法来处理图片。不管任何时候,您只能注册一个分析器:注册新的分析器会替换现有分析器。 本主题中的代码示例展示了如何执行此操作,以及如何将图片分析用例和预览用例绑定到LifecycleOwner。如需了解如何创建预览用例,请...

qq_33209777的博客 3761

智能客服系统知识库数据清洗

数据清洗(Data Cleaning)是确保智能客服知识库高效运行的重要环节,主要涉及。| 分类 & 标签优化 | 重新组织 FAQ,创建关键字索引 || 定期更新 | 结合用户反馈,每 1-3 个月优化 |才能提供更优质、正确的回答,提升客户满意度!、Zendesk、Intercom 等)中,: FAQ 或客服回答中可能存在。,会影响 AI 匹配的准确性。是一个持续优化的过程,

z1941563559的博客 2103

Android NDK开发详解相机之机器学习套件分析器

原生开发套件 (NDK) 是一套工具,使您能够在 Android 应用中使用 C 和 C++ 代码,并提供众多平台库,您可使用这些平台库管理原生 activity 和访问实体设备组件,例如传感器和触控输入。NDK 可能不适合大多数 Android 编程初学者,这些初学者只需使用 Java 代码和框架 API 开发应用

hnjzfwy的博客 233

【图像去噪(Image Denoising)】关于【图像去噪】专栏的相关说明,包含适配人群、专栏简介、专栏亮点、阅读方法、定价理由、品质承诺、关于更新、去噪概述、文章目录、资料汇总、问题汇总(更新中)

你是否在全网苦寻【图像去噪(ImageDenoising)】的相关资料?你的目标是否是看懂【图像去噪(ImageDenoising)】的相关论文,复现代码,跑出结果,并试图创新?你是否需要发表【图像去噪(ImageDenoising)】的相关论文毕业?你是否需要做【图像去噪(ImageDenoising)】的相关项目,开发软件,研究算法,获得专利或者软著?只要是与【图像去噪(ImageDenoising)】有关的问题,那么请继续往下看。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 2万+

Python爬虫实战:模拟登录知乎 – 通过加密参数和验证码实现自动登录

通过本篇博客的讲解,我们学习了如何通过 POST请求 和 验证码识别,模拟登录知乎并爬取用户信息、问题数据。随着爬虫技术的发展,面对更复杂的反爬虫机制,我们可以不断调整策略,以绕过这些防护,实现数据的自动化抓取。

2201_76125261的博客 731

Android摄像头识别多个二维码并绘制识别区域

说起Android扫描二维码,可能很多人都会想到用zxing,个人感觉不是很好用,后来使用华为的“统一扫码服务”,用着还行,不用开发者再辛苦钻研不同手机的分辨率以及方向了,如今机器学习热度这么高,各大厂商已经把条码识别归入机器学习SDK,本文要介绍的就是使用谷歌的 CameraX以及机器学习,实现二维码识别,超级简单!3、从官方的示例代码复制两份代码。

jjf19891208的专栏 5515

华为OD机试真题 新系统2026-04-08 C++ 实现【直捣黄龙】

小王在玩一款叫做直捣黄龙的小游戏,在该游戏中他需要从入口位置进入敌营,绕过哨兵的层层封锁,达到敌军司令部实施斩首行动。 敌军阵营是一个n*n的矩阵,入口在坐标(0,n/2),敌军司令部在坐标(n-1,n/2),每个 哨兵警戒以自己为中心的9宫格,一旦被哨兵发现则行动失败。

MISAYAONE的博客 263

百度人工智能API的调用_微信小程序。

微信小程序–智能接口 通过微信小程序开发调用百度人工智能接口,从而实现很多有趣的功能。 文章目录微信小程序--智能接口前言一、百度智能云的认识1-1 注册1-2 页面说明1-3 功能初识1-4 api 接口二、百度智能接口的创建2-1 创建接口2-1-1 点击创建新应用2-1-2 应用名称2-2 api 接口的疏导--图像识别为例2-2-1 百度自己的案例2-2-2 接口简介2-2-2 请求接口2-2-4 Access Token三:微信小程序案例开发3-1 微信小程序-相机3-1-1 ca

zzxhahaha的博客 6234

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【使用攻略】之【地标识别】-快速接入小程序

为什么80%的码农都做不了架构师?>>> ...

weixin_33877092的博客 836

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Qwen3-VL视觉识别能力实测:名人、地标、动植物精准识别

Qwen3-VL作为国产多模态大模型,实现了从图像识别到深度理解的跨越。它能精准识别名人、动植物与地标,结合上下文生成专业解读,甚至可作视觉代理操作界面或生成前端代码。支持长上下文、多语言、离线部署,已在内容审核、生态监测、智能导览等场景落地应用。

weixin_42350014的博客 964

Qwen3-VL识别人物、地标、动植物:预训练覆盖‘万物识别’场景

Qwen3-VL通过增强视觉编码、多任务预训练和内生OCR能力,实现对图像中物体、文字、空间关系的深度理解,支持细粒度识别与跨语言场景应用,兼顾效率与精度,适用于文旅、教育、无障碍等多种现实场景。

weixin_30789053的博客 771

大规模户外环境的具有地标的语义SLAM

点击上方“3D视觉工坊”,选择“星标”干货第一时间送达项目论文地址:https://arxiv.org/pdf/2001.01028v1.pdf 代码:https://github.c...

3D视觉工坊 1164

React Native集成云端视觉AI:快速构建地标识别应用实战

计算机视觉作为人工智能的核心分支,其核心原理是让机器理解和处理图像信息。通过深度学习模型,计算机可以识别图像中的物体、场景和特征。这项技术的巨大价值在于将强大的视觉感知能力赋能给各类应用,尤其在移动端场景中,能极大增强用户体验与交互智能。在工程实践中,开发者无需从零训练复杂模型,而是可以高效整合成熟的云端视觉AI服务。本文以构建一个地标识别应用为例,详细解析了如何利用React Native框架,结合云端Vision API,实现从图像采集、预处理、安全调用到结果展示的全流程。其中,重点探讨了图片压缩、网络

weixin_32576389的博客 372

人脸遮挡检测_遮挡斜面的人脸地标检测

人脸遮挡检测Facial landmarks detection or facial keypoints detection has a lot of uses in computer vision like face alignment, drowsiness detection, Snapchat filters to name a few. The most widely known mod...

weixin_26752765的博客 1360

iOS 27 相机新 Siri 模式上线:功能强大但仍有小问题待解决

Siri 模式目前可在 iOS 27 开发者测试版中使用,它是相机模式继照片、视频、人像和全景之后的又一新增功能。当通过相机看到某个东西时,只需轻点 Siri 模式图标,之后可以语音询问 Siri 相关信息,对其进行 Google 搜索,或者直接将物品图像发送给 Siri 进行分析。

IT界那些事儿 39

打造自己的智能相机:接入阿里万物识别API思路

本文介绍了如何在星图GPU平台上自动化部署万物识别-中文-通用领域镜像,快速构建本地化智能相机系统。通过简单配置即可实现对照片的实时中文语义识别,典型应用于手机相册自动打标、普通摄像头物品识别等场景,支持CPU/GPU灵活运行,开箱即用。

weixin_32098457的博客 304

HyperLandmark终极指南:如何实现高效精准的106点人脸地标检测?

想要打造完美的人脸美颜、智能美妆或者精准的活体检测应用吗?HyperLandmark作为一款良心级开源人脸标定算法,提供了业界领先的106点人脸地标检测解决方案,让您轻松实现移动端高效精准的人脸特征分析!🚀 ## 什么是HyperLandmark? HyperLandmark是一个专业的**人脸地标检测**开源项目,支持在移动设备上实时定位106个人脸关键点。无论是面部轮廓、眼睛、鼻子还是嘴

gitblog_00073的博客 523

Qwen3-VL图像识别能力再升级:覆盖名人、地标、动植物等千类目标

Qwen3-VL在视觉理解上实现突破,支持细粒度目标识别、空间关系推理与长视频语义分析,可精准识别名人、地标、动植物等千类对象,并融合OCR、多语言处理与GUI操作能力,让AI真正‘看懂’并‘做到’。

weixin_35238815的博客 1024

v-html解析的相对地址img 显示不出来_人工智能专题作品解析——APPInventor安卓应用开发AI图像识别简单应用...

人工智能专题作品解析——APPInventor安卓应用开发《AI图像识别简单应用》本程序使用APPInventor 2019桌面板.一、思路平时忙于工作和学习,很少涉猎其它领域的知识,但生活中又会遇到很多自己不熟悉,或是不了解的动物、植物、果蔬、菜品、车型等等,于是就想到人工智能图像识别。时间的关系,只做了动物、植物、果蔬、菜品、货币、车型这6个方面,后续想补充logo识别、红酒识别、地...

weixin_39600291的博客 1223

人工智能在健身领域的应用:姿态识别和康复训练矫正+代码+部署(AI 健身教练来分析深蹲等姿态)

姿态识别+康复训练矫正(AI 健身教练姿态分析) 目录 姿态估计 姿势分析的正面和侧视图的直觉 姿势构建 AI 健身教练来分析深蹲 用于姿势分析的正面和侧视图的直觉 使用 MediaPipe 姿势构建 AI 健身教练来分析深蹲 深蹲时的状态图解释 设计应用程序时的关键概念 角度计算

qq1309399183的博客 1069
上一篇: CoroutineWorker 压缩图片示例
下一篇: Android上的AES加密
lynn8570_blog
博客等级 码龄10年 254粉丝 87原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值