常见的排序算法(四)( 归并排序,计数排序 , 基数排序)

经典算法之二分查找 优化算法:int mid = left + ((right - left) >> 1); #include<stdio.h> int main() { int arr[] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 }; int k = 5; int sz = sizeof(arr) / sizeof(arr[0]);//计算数组中元素个数 int left = 0;//数组最左边数的下标 int right = sz - 1;//数组最右边数的下标 while (left <= right)//防止交叉 { int mid = (lef. 阅读详情

   归并排序(MERGE-SORT)是建立在归并操作上的一种有效的排序算法,该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。

  (如果读者不太了解什么叫分治法,可以去看看《算法导论》第一二章。)

归并过程为:比较a[i]和a[j]的大小,若a[i]≤a[j],则将第一个有序表中的元素a[i]复制到r[k]中,并令i和k分别加上1;否则将第二个有序表中的元素a[j]复制到r[k]中,并令j和k分别加上1,如此循环下去,直到其中一个有序表取完,然后再将另一个有序表中剩余的元素复制到r中从下标k到下标t的单元。归并排序的算法我们通常用递归实现,先把待排序区间[s,t]以中点二分,接着把左边子区间排序,再把右边子区间排序,最后把左区间和右区间用一次归并操作合并成有序的区间[s,t]。
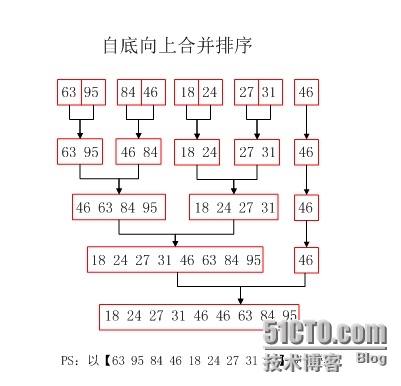
wKioL1dFtx3St-_hAAEZNaX-y2Q525.jpg

代码如下:

void Merge(int* a,int left, int mid, int right, int* tem)
{
	assert(a);
	assert(tem);
	int i = 0;
	int indix = mid+1;
	int begin = left;
	while(begin <= mid && indix <= right)
	{
		if(a[begin] > a[indix])
			tem[i++] = a[indix++];
		else
			tem[i++] = a[begin++];
	}
	while(begin <= mid) 
	tem[i++] = a[begin++];

	while( indix <= right)
		tem[i++] = a[indix++];

	for(int j = 0; j < i; j++)   将排好序的数组重新赋值给a
	{
		a[j+left] = tem[j];
	}
}

void mergsort(int* a,int left, int right,int*  tem)
{
	assert(a);
	assert(tem);
	int mid;
	if(left < right)
	{
		mid = (left + right)/2;
		mergsort(a,left,mid,tem);
		mergsort(a,mid+1,right,tem);
		Merge(a,left,mid,right,tem);
	}
}

bool MergeSort(int* a, int n)  
{  
	assert(a);
    int *p = new int[n];   开辟一个跟a一样大的空间,用来存放排序好的数据。
    if (p == NULL)  
        return false;  
    mergsort(a, 0, n - 1, p);  
    delete[] p;  
    return true;  
}

以上是递归算法

既然有递归算法,那也就有非递归的算法

void merge_sort(int * a, int length)
{
	assert(a);
        int i, left_min, left_max, right_min, right_max, next;  
        int *tmp = (int*)malloc(sizeof(int) * length); 

        if (tmp == NULL)
		{  
                printf("Error: out of memory\n");  
        }  

        for (i = 1; i < length; i *= 2)  
                for (left_min = 0; left_min < length - i; left_min = right_max)
				{   
                        right_min = left_max = left_min + i;  
                        right_max = left_max + i;  
                        if (right_max > length)  
                                right_max = length;  
                        next = 0;  

                        while (left_min < left_max && right_min < right_max)  
                                tmp[next++] = a[left_min] > a[right_min] ? 
								a[right_min++] : a[left_min++];  

                        while (left_min < left_max)  
                                a[--right_min] = a[--left_max]; 

                        while (next > 0)  
                                a[--right_min] = tmp[--next];  
                }  
        free(tmp);  
}

由此便可以看出递归和非递归在思想上是一致的,只是实现的方法不同罢了。

时间复杂度为O(nlogn) 这是该算法中最好、最坏和平均的时间性能。

空间复杂度为 O(n)

比较操作的次数介于(nlogn) / 2和nlogn - n + 1。

赋值操作的次数是(2nlogn)。归并算法的空间复杂度为:0 (n)

归并排序比较占用内存,但却是一种效率高且稳定的算法。


计数排序

计数排序是一个非基于比较的排序算法,该算法于1954年由 Harold H. Seward 提出。它的优势在于在对一定范围内的整数排序时,它的复杂度为Ο(n+k)(其中k是整数的范围),快于任何比较排序算法。


算法思想编辑

计数排序对输入的数据有附加的限制条件:

1、输入的线性表的元素属于有限偏序集S;

2、设输入的线性表的长度为n,|S|=k(表示集合S中元素的总数目为k),则k=O(n)。

在这两个条件下,计数排序的复杂性为O(n)。

计数排序的基本思想是对于给定的输入序列中的每一个元素x,确定该序列中值小于x的元素的个数(此处并非比较各元素的大小,而是通过对元素值的计数和计数值的累加来确定)。一旦有了这个信息,就可以将x直接存放到最终的输出序列的正确位置上。例如,如果输入序列中只有17个元素的值小于x的值,则x可以直接存放在输出序列的第18个位置上。当然,如果有多个元素具有相同的值时,我们不能将这些元素放在输出序列的同一个位置上,因此,上述方案还要作适当的修改。


算法过程编辑

假设输入的线性表L的长度为n,L=L1,L2,..,Ln;线性表的元素属于有限偏序集S,|S|=k且k=O(n),S={S1,S2,..Sk};则计数排序可以描述如下:

1、扫描整个集合S,对每一个Si∈S,找到在线性表L中小于等于Si的元素的个数T(Si);

2、扫描整个线性表L,对L中的每一个元素Li,将Li放在输出线性表的第T(Li)个位置上,并将T(Li)减1。

void CountSort(int* a,int size)
{
	int max = a[0];
	int min = a[0];
	for(int i = 1; i<size; i++)
	{
		if(a[i] > max)
			max = a[i];

		if(a[i] < min)
			min = a[i];
	}

	int* tem = new int[max-min +1]();
	
	for(int i =0; i < size; i++)
		tem[a[i] - min]++;

	int indix = 0;
	for(int i = 0; i< (max-min +1); i++)
	{
		
		while(tem[i] > 0)
		{
			a[indix++]= i + min;
			--tem[i];
		}
	}

	delete[] tem;
}

基数排序

基数排序(radix sort)属于“分配式排序”(distribution sort),又称“桶子法”(bucket sort)或bin sort,顾名思义,它是透过键值的部份资讯,将要排序的元素分配至某些“桶”中,藉以达到排序的作用,基数排序法是属于稳定性的排序,其时间复杂度为O (nlog(r)m),其中r为所采取的基数,而m为堆数,在某些时候,基数排序法的效率高于其它的稳定性排序法。

其实他的实现,就想稀疏实现稀疏矩阵一样,读者可以在此借鉴,并且与之比较。

int Maxbit(int* a, int size)  //计算数组中最大值得位数。
{
	int bit = 1;
	int num = 10;
	for(int i =0; i<size;i++)
	{
		if(a[i] > num)
		{
			++bit;
			num *= 10;
		}
	}
	return bit;
}

void RadixSort(int* a, int size)
{
	int indix = Maxbit(a,size);
	int* tem = new int[size];    //记录该值
	int* count = new int[size];  //记录次数
	int radix = 1;            进位所用的值
	for(int i = 0; i<indix;i++)
	{
		for(int j = 0;j < size; j++)
		{
			count[j] = 0;
		}

		for(int j = 0; j<size; j++)
		{
			int k = (a[j]/radix) % 10;
			count[k]++;
		}
		for(int j = 1; j<size; j++)
			count[j] = count[j-1] +count [j];
		for(int j= size-1;j>=0;j--)
		{
			int k = (a[j]/radix) % 10;
			tem[count[k] -1] = a[j];
			count[k]--;
		}

		for(int j = 0;j < size; j++)
		{
			a[j] = tem[j];
		}

		radix = radix * 10;
		
	}

	delete[] tem;
	delete[] count;
}

 以上形象图解可看上篇博文中的超链接,给予读者形象的理解和解答

  这篇博文列举了归并排序,计数排序 , 基数排序,基本可以掌握其中概要,管中窥豹,不求甚解。如果你有任何建议或者批评和补充,请留言指出,不胜感激,更多参考请移步互联网。

十大排序算法详解(二)归并排序、堆排序、计数排序、桶排序、基数排序 归并排序、堆排序、计数排序、桶排序、基数排序 阅读详情

相关推荐

算法 (四)排序算法的稳定性及其总结、桶排序(计数排序、基数排序)

1、排序算法的稳定性及其总结 对于数组中相同的数,在排序后还能不能保持相对位置不变,比如1112233344445,虽然是一样的,但是希望相对位置不要变 冒泡排序稳定 插入排序稳定 选择排序不稳定 归并排序稳定(先排左区,再排右区,可以做到稳定) 快排不稳定(4443 — 3444)(也就是说parttion过程做不到小于一个数放左边,然后这些数相对次序还不变) 堆排不稳定(44455,heap...

PizAn的博客 3290

复习数据结构:排序算法(四)——归并排序

基本思想:基于分治法,即把待排序的数组序列,分为若干个子序列,对每个子序列排序,然后再把所有有序的子序列合并为一个整体有序的序列。分析可知,如果拿任何一个元素作为子序列,那么所有子序列就已经是有序的,而归并排序的关键就在于如何合并,也就是“归并”。     归并排序是外排序,稳定排序,时间复杂度是O(nlogn).     详细说归并排序的过程:1个

bigfacesafdasgfewgf 764

【OpenCV】手眼标定实战:从原理到calibrateHandEye的完整实现

本文详细解析了机器人视觉中的手眼标定原理与实战,重点介绍了如何使用OpenCV的calibrateHandEye函数实现从数据采集到结果验证的完整流程。文章深入剖析了AX=XB核心方程,区分了眼在手上与眼在手外两种配置,并提供了详细的代码示例与避坑指南,帮助开发者精准建立相机与机械臂末端的坐标转换关系,是机器人精准抓取的关键技术。

weixin_29046611的博客 510

关于二分查找的一个坑 :mid = left + (right - left) / 2 和 mid = (left + right) / 2 的 区别

mid = left + (right - left) / 2 和 mid = (left + right) / 2 的 区别 本人在刷leetcode时,遇到了二分查找,直接手撕,提交,发现超时(其实是bug),看了题解发现,woc,一样的代码居然我的跑不起来(其实不一样)。 跑不起来的原因就是mid = (left + right) / 2 容易溢出!因为left+right很容易超过int范围!而mid = left + (right - left) / 2 不容易溢出,所以建议以后写二分时要用mid

weixin_45745283的博客 3750

噪声整形与过采样实战:从N-bit ADC到DSM的SQNR优化指南

本文深入探讨了噪声整形与过采样技术在DSM(Delta-Sigma调制器)中的应用,重点分析了量化器位数(N)、滤波器阶数(L)和过采样率(OSR)对SQNR优化的影响。通过实战案例和参数协同优化策略,帮助工程师在音频处理和通信系统设计中实现更优的信号质量。

weixin_42561040的博客 340

VS2022离线安装包 - 下载安装教程

VS2022离线安装包 - 下载安装教程

鲤籽鲲的博客 3万+

归并排序 & 计数排序 & 基数排序 & 冒泡排序 & 选择排序 ----> 内部排序性能比较...

2.3 归并排序 接口定义: int merge(void* data, int esize, int lpos, int dpos, int rpos, int (*compare)(const void* key1, const void* key2)); 返回值:成功 0;失败 -1。 int merge_sort(void* data, int size, i...

weixin_33836874的博客 226

一窥Memory测试算法及自我修复机制

摘要 为了满足新一代设备的需求,Memory的大小每三年就会增加4倍。深亚微米设备包含大量面积更小、访问速度更快的Memory。针对此类设计制定自动测试策略可以减少ATE(自动测试设备)的时间和成本。 内存故障的行为与经典的“Stuck-At”故障不同。因此,Memory的故障模型(由于其阵列结构)与标准逻辑的设计也是不同的。Memory测试除了进行故障检测和定位,还可以实现用冗余单元对...

路科验证 2万+

十大经典排序算法详解(三)-堆排序,计数排序,桶排序,基数排序

十大经典排序算法-堆排序,计数排序,桶排序,基数排序 1-堆排序 算法思想: 算法图解: 示例代码: 在这里插入代码片 复杂度分析: 2-计数排序 算法思想: 算法图解: 示例代码: 在这里插入代码片 复杂度分析: 3-桶排序 算法思想: 算法图解: 示例代码: 在这里插入代码片 复杂度分析: 4-基数排序 算法思想: 算法图解: 示例代码: 在这里插入代码片 复杂度分析: ...

lovely__RR的博客 4万+

全网最全vue2技术栈实现AI问答机器人功能(流式与非流式两种接口方法)

markdown-it | markdown-it 中文文档上面的是 markdown-it 中文文档链接 ,供参考使用核心的东西就这些啦,如果有其他想问的,评论区留言即可~博客写作不易,希望大家多多支持,多多捧场~~~最后给大家分享一下 typed.js 网址,网上比较多,我觉得这个比较好理解一些Typed.js - Type your heart out (mattboldt.github.io)[这里是图片011]https://mattboldt.github.io/typed.js/

m0_74825108的博客 3060

高级技能-高可用和容灾-两地三中心、异地多活架构

两地三中心和异地多活是当前主流的跨地域高可用架构方案。两地三中心通过生产中心、同城灾备和异地灾备的组合,提供多级容灾能力,适合对数据安全要求高的行业。异地多活则采用单元化设计,多个站点同时服务,提升资源利用率,但需解决网络延迟、数据冲突等挑战。两种架构在RTO/RPO、一致性、改造成本等方面各具特点,企业应根据业务规模、一致性要求和预算进行选择,可考虑从同城双活起步,逐步向异地多活演进。混合架构可能是平衡容灾与多活的务实方案。

zhongjianfeng100的博客 169

常见排序算法(插入排序,希尔排序,选择排序,堆排序,冒泡排序,快速排序,归并排序,计数排序,基数排序,桶排序)

常见排序算法(插入排序,希尔排序,选择排序,堆排序,冒泡排序,快速排序,归并排序,计数排序,基数排序,桶排序)

2301_80288511的博客 3163

Ubuntu搭建Pytorch环境(Anaconda、Cuda、cuDNN、Pytorch、Python、Pycharm、Jupyter)

Ubuntu搭建Pytorch环境(Anconda、Cuda、Pytorch、Python、Pycharm、Jupyter)

funfan的博客 1万+

排序算法:桶排序、计数排序、基数排序

  相关博客: 排序算法:冒泡排序、插入排序、选择排序、希尔排序 排序算法:归并排序、快速排序 排序算法:桶排序、计数排序、基数排序 排序算法:堆排序 十大排序算法小结 这篇博客将主要介绍三种时间复杂度是O(n)的排序算法:桶排序、计数排序、计数排序。因为这些排序算法的时间复杂度都是线性的,所以也把这类排序算法称为线性排序。之所以能够做到线性的时间复杂度,主要原因是这几个算法是非基于...

张维鹏的博客 4838

基于YOLOv8的包装商品智能检测系统完整指南—含论文、代码

《基于YOLOv8的包装商品智能检测系统》摘要: 本文提出了一套完整的零售商品自动检测解决方案,利用YOLOv8深度学习框架实现高精度、高效率的商品识别。系统针对SKU110K大规模商品数据集(含11,762张高密度货架图像)进行优化,包含数据预处理、模型训练、推理检测和可视化界面全流程。详细介绍了从CSV标注到YOLO格式的转换方法、环境配置指南及技术架构设计。该系统可应用于智能零售、物流仓储等多个场景,有效解决人工盘点效率低、误差大的痛点。实验表明,该系统具备毫秒级检测速度和批量处理能力,为商业数字化转

FJN110的博客 209

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

数据结构复习指导之归并排序、基数排序、计数排序

归并排序与上述基于交换、选择等排序的思想不一样,归并的含义是将两个或两个以上的有序表合并成一个新的有序表。

心碎烤肠的博客 1821

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

算法——十大排序(冒泡排序,选择排序,堆排序,插入排序,归并排序,快速排序,希尔排序,计数排序,基数排序,桶排序)

排序算法准备算法模板冒泡排序(Bubble Sort)定义执行流程代码实现选择排序(Selection Sort)定义执行流程代码实现插入排序(Insertion Sort)定义执行流程代码实现希尔排序(Shell Sort)定义执行流程代码实现堆排序(Heap Sort)定义执行流程代码实现归并排序(Merge Sort)定义执行流程代码实现快速排序(Quick Sort)定义执行流程代码实现计数排序(Counting Sort)定义执行流程代码实现基数排序(Radix Sort)定义执行流程代码实现桶排

mazouri的博客 5023

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【Python排序算法】一文掌握十大排序算法,冒泡排序、插入排序、选择排序、归并排序、计数排序、基数排序、希尔排序和堆排序

一文掌握十大排序算法,冒泡排序、插入排序、选择排序、归并排序、计数排序、基数排序、布尔排序、桶排序和堆排序

qq_35831906的博客 2543

万字长文,链表排序算法——冒泡排序、选择排序、插入排序、归并排序、快速排序、计数排序、桶排序、基数排序精讲及python实现

在数组排序中,常见的排序算法有:冒泡排序、选择排序、插入排序、希尔排序、归并排序、快速排序、堆排序、计数排序、桶排序、基数排序等。而对于链表排序而言,因为链表不支持随机访问,访问链表后面的节点只能依靠next指针从头部顺序遍历,所以相对于数组排序问题来说,链表排序问题会更加复杂一点。下面先来总结一下适合链表排序与不适合链表排序的算法:冒泡排序选择排序插入排序归并排序快速排序计数排序桶排序基数排序。希尔排序。堆排序。希尔排序为什么不适合链表排序?希尔排序:希尔排序中经常涉及到对序列中第。

白话机器学习 4820

九种经典排序算法详解(冒泡排序,插入排序,选择排序,快速排序,归并排序,堆排序,计数排序,桶排序,基数排序)

综述 最近复习了各种排序算法,记录了一下学习总结和心得,希望对大家能有所帮助。本文介绍了冒泡排序、插入排序、选择排序、快速排序、归并排序、堆排序、计数排序、桶排序、基数排序9种经典的排序算法。针对每种排序算法分析了算法的主要思路,每个算法都附上了伪代码和C++实现。 电梯直达 1. 冒泡排序 2. 插入排序 3 .选择排序 4. 快速排序 5. 归并排序 6. 堆排序 7. ...

胡LiuJia@BLOG 6729

常见排序算法及Java实现

常见排序算法及Java代码实现

xike1024的博客 1852

常见的排序算法

排序算法可谓数据结构模块中的重中之重,常见的哈希表,二叉树,搜索树/平衡树,位图等数据结构只是处理实际问题的抽象方法,实际在处理接受或生成的数据集时,排序算法显得尤其重要,排序算法家族很庞大,其中包括了冒泡排序,选择排序,插入排序,堆排序,快速排序,归并排序,基数排序,计数排序,希尔排序,箱排序,树型排序等众多算法,每种排序都有各自的特性,没有好坏之分,只有在特定的场景使用合适的排序算法才是上策,单纯的来比显得太过绝对,没有可比性。因为实际需求及各方面条件的限制使得排序算法的可选范围往往只缩小到某一种或某几

Xiao__Tian__的博客 9912

排序算法之非比较排序(基数排序和计数排序)

计数排序和基数排序

m0_64770095的博客 1331

【数据结构】排序 —— 归并排序(mergeSort)、计数排序、基数排序

海量数据的排序问题外部排序:排序过程需要在磁盘等外部存储进行的排序 前提:内存只有 1G,需要排序的数据有 100G因为内存中因为无法把所有数据全部放下,所以需要外部排序,而归并排序是最常用的外部排序先把文件切分成 200 份,每个 512 M分别对 512 M 排序,因为内存已经可以放的下,所以任意排序方式都可以进行 2路归并,同时对 200 份有序文件做归并过程,最终结果就有序了。

明志の博客 1710
上一篇: 常见的排序算法(三) 交换排序(冒泡排序,快速排序)
下一篇: Fedora 20 的vim配置和ctags安装
Csoul89757
博客等级 码龄10年 34粉丝 72原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值