论文阅读:MambaVision: A Hybrid Mamba-Transformer Vision Backbone

CVPR 2025 | MambaVision:一种混合 Mamba-Transformer 视觉骨干网络 接着,我们添加了 conv2 层,同时保留 Mamba 原有的门控机制(而非采用拼接操作),此时 ImageNet Top-1 准确率达到 81.3%,MS COCO 边界框 AP 达到 45.3、掩码 AP 达到 41.0,ADE20K mIoU 达到 45.7%。最后,通过采用拼接操作,所有指标的性能均实现了显著提升:ImageNet Top-1 准确率提高了 1.0%,MS COCO 边界框 AP 提高了 1.1、掩码 AP 提高了 0.8,ADE20K mIoU 提高了 0.9。 阅读详情
AI摘要

本文介绍新型混合 Mamba - Transformer 主干网络 MambaVision。它重新设计 Mamba 公式,结合 Transformer 模块,解决 Mamba 架构在视觉任务中的问题。该模型包含多分辨率架构,实验表明其在 ImageNet - 1k、MS COCO 等数据集上表现良好,可作为不同视觉任务骨干。

论文地址:arxiv

摘要

作者提出了一种新型的混合 Mamba-Transformer 主干网络。通过重新设计 Mamba 公式,增强了其高效建模视觉特征的能力。

此外,作者还通过对 ViT 与 Mamba 消融研究,实验结果表明了:在最后几层为 Mamba 架构配备几个自注意力模块,可以极大地提高捕获长程空间依赖关系的建模能力。

最后,作者根据他们的发现,设计了一系列具有层次结构的 MambaVision 模型,最终取得了最佳的性能。

正文

Transformer 模型在视觉领域中已经成为了标准架构,但是其计算成本很高。之后 Mamba 模型改进了这个问题,它实现了线性的时间复杂度,并在不同的领域中超越过匹敌 Transformer。

但是基于 Mamba 架构的骨干网络对于需要全局感受野的计算机视觉任务依然有着一定的问题:

  1. 图像像素是二维的,所以不存在与顺序数据相同的顺序依赖性。同时,由于图像是二维的,所以需要更并行与集成的方式考虑。作者认为这导致了在处理空间数据时的低效性。
  2. Mamba 这样的自回归模型是逐步处理数据的,这限制了其在一次前向传播中捕捉与利用全局上下文的能力。但是视觉任务通常需要在理解整体图像的基础上对局部区域做准确的预测。

针对以上的问题,提出了 MambaVision 模型,其核心思想是通过重新设计 Mamba 模块并结合 Transformer 模块,形成一种混合的架构,从而来提升视觉任务的性能。该模型包含多分辨率架构,并利用基于卷积神经网络的残差模块快速提取较大分辨率特征。

经过实验,这个模型在 ImageNet-1 k 数据集上效果很好。
贡献

  • 重新设计了更适合视觉的 Mamba 模块,提高了 Mamba 架构的准确性与图像吞吐量。
  • 证明了在最后的阶段加入自注意力模块可显著提高模型捕捉全局上下文与长距离空间依赖的能力。
  • 提出了 MambaVision 模型,这是一个混合了 Mamba 与 Transformer 的模型。

模型架构
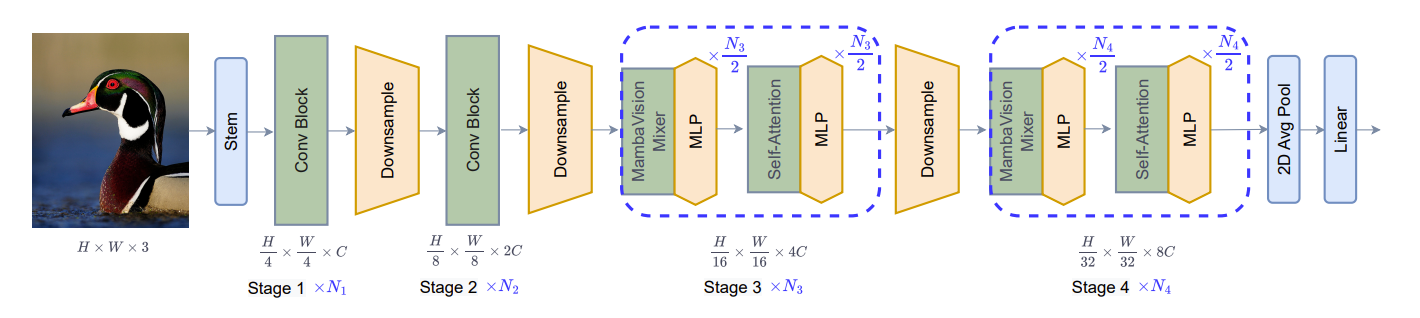
MambaVision 有四个不同的阶段组成,前两个阶段由基于 CNN 的层组成,用于在较高输入分辨率下的快速提取特征。而第三与第四阶段是由 MambaVision 与 Transformer 块组成。

对于尺寸为 H × W × 3 的图像,会先被转换为重叠的补丁,尺寸为 H/4 × W/4 × C,然后通过一个由两个连续的 3*3 的 CNN 层(步幅为 2)组成的 stem 投射到 C 维嵌入空间中。

下采样模块由一个批归一化的 3*3 的 CNN 层(步幅为 2)组成,可以将图像分辨率减半。

而 CNN 块采用以下残差块公式:
z ^ = GELU ( BN ( Conv 3 × 3 ( z ) ) ) \hat{z} = \text{GELU}(\text{BN}(\text{Conv}_{3 \times 3}(z))) z^=GELU(BN(Conv3×3​(z)))
z = BN ( Conv 3 × 3 ( z ^ ) ) + z z = \text{BN}(\text{Conv}_{3 \times 3}(\hat{z})) + z z=BN(Conv3×3​(z^))+z
其中,GELU 为激活函数,BN 为批归一化。

层架构

如果输入 X ∈ R T ∗ C X \in R^{T*C} X∈RT∗C,其中序列长度为 T T T,嵌入维度为 C C C,则在阶段 3 与 4 中,第 n 层的输出可以通过以下公式计算:

X ^ n = Mixer ( Norm ( X n − 1 ) ) + X n − 1 \hat{X}^n = \text{Mixer}(\text{Norm}(X^{n-1})) + X^{n-1} X^n=Mixer(Norm(Xn−1))+Xn−1
X n = MLP ( Norm ( X ^ n ) ) + X ^ n X^n = \text{MLP}(\text{Norm}(\hat{X}^n)) + \hat{X}^n Xn=MLP(Norm(X^n))+X^n
Norm 表示层归一化,而 Mixer 表示令牌混合。

MambaVision 混合模块

以下是其架构:
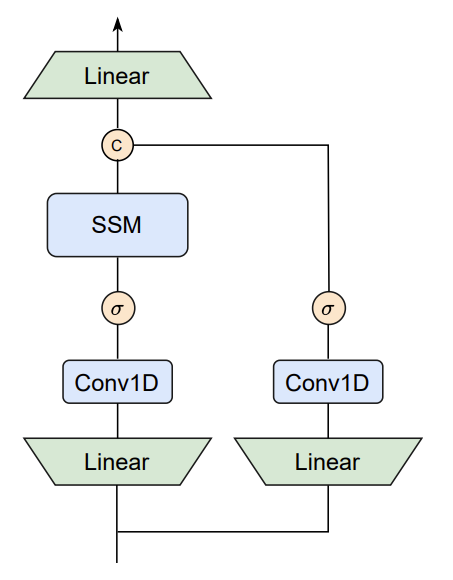
作者做了以下的改动:

  • 使用常规的卷积代替了因果卷积(causal convolution)
  • 增加了一个不含 SSM 的对称分支,这个分支由一个额外的卷积与 SiLU 激活函数(用于补偿由于 SSM 的顺序约束而丢失的内容)。
  • 将两个分支的结果使用 Concat 连接并使用线性层投影(可以最终的特征表示结合了顺序与空间信息,利用两个优势)。

以下是公式的表示:

X 1 = Scan ( σ ( Conv ( Linear ( C , C 2 ) ( X in ) ) ) ) X_1 = \text{Scan}(\sigma(\text{Conv}(\text{Linear}(C, \frac{C}{2})(X_{\text{in}})))) X1​=Scan(σ(Conv(Linear(C,2C​)(Xin​))))
X 2 = σ ( Conv ( Linear ( C , C 2 ) ( X in ) ) ) X_2 = \sigma(\text{Conv}(\text{Linear}(C, \frac{C}{2})(X_{\text{in}}))) X2​=σ(Conv(Linear(C,2C​)(Xin​)))
X out = Linear ( C 2 , C ) ( Concat ( X 1 , X 2 ) ) X_{\text{out}} = \text{Linear} \left(\frac{C}{2}, C\right)(\text{Concat}(X_1, X_2)) Xout​=Linear(2C​,C)(Concat(X1​,X2​))
其中, L i n e a r ( C i n , C o u t ) ( . ) Linear(C_{in},C_{out})(.) Linear(Cin​,Cout​)(.) 表示输入与输出维度分别为 C i n C_{in} Cin​ 与 C o u t C_{out} Cout​ 的线性层。 S c a n Scan Scan 是选择性扫描操作, σ \sigma σ 表示 sigmoid 激活函数(SiLU)。Conv 表示一维卷积,Concat 表示连接操作。

我认为作者计算 X o u t X_{out} Xout​ 的公式写错了,应该是 X out = Linear ( C , C ) ( Concat ( X 1 , X 2 ) ) X_{\text{out}} = \text{Linear} \left(C, C\right)(\text{Concat}(X_1, X_2)) Xout​=Linear(C,C)(Concat(X1​,X2​))

自注意力

使用通用自注意力机制,其公式为:
Attention ( Q , K , V ) = Softmax ( Q K T d h ) V \text{Attention}(Q, K, V) = \text{Softmax}\left(\frac{QK^T}{\sqrt{d_h}}\right)V Attention(Q,K,V)=Softmax(dh​ ​QKT​)V
Q Q Q, K K K, V V V 分别表示查询,键,值, d h d_h dh​ 是注意力头的数量。

模型评估

图像分类

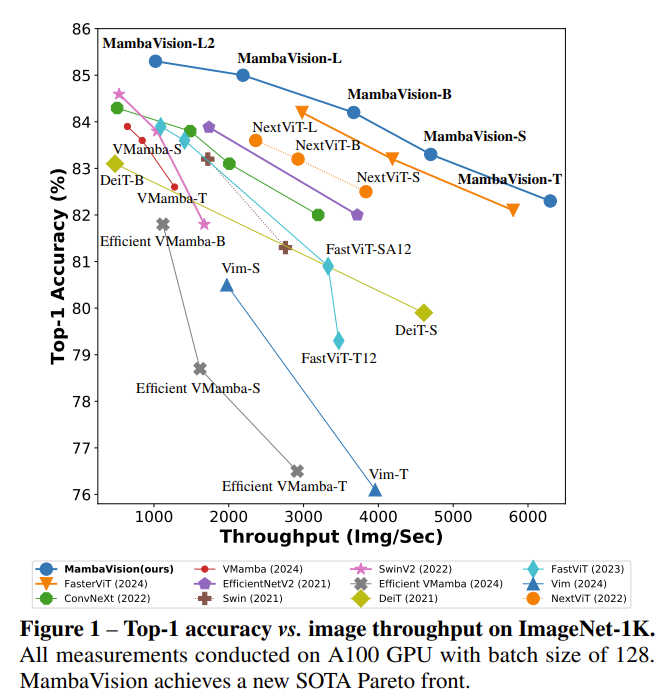
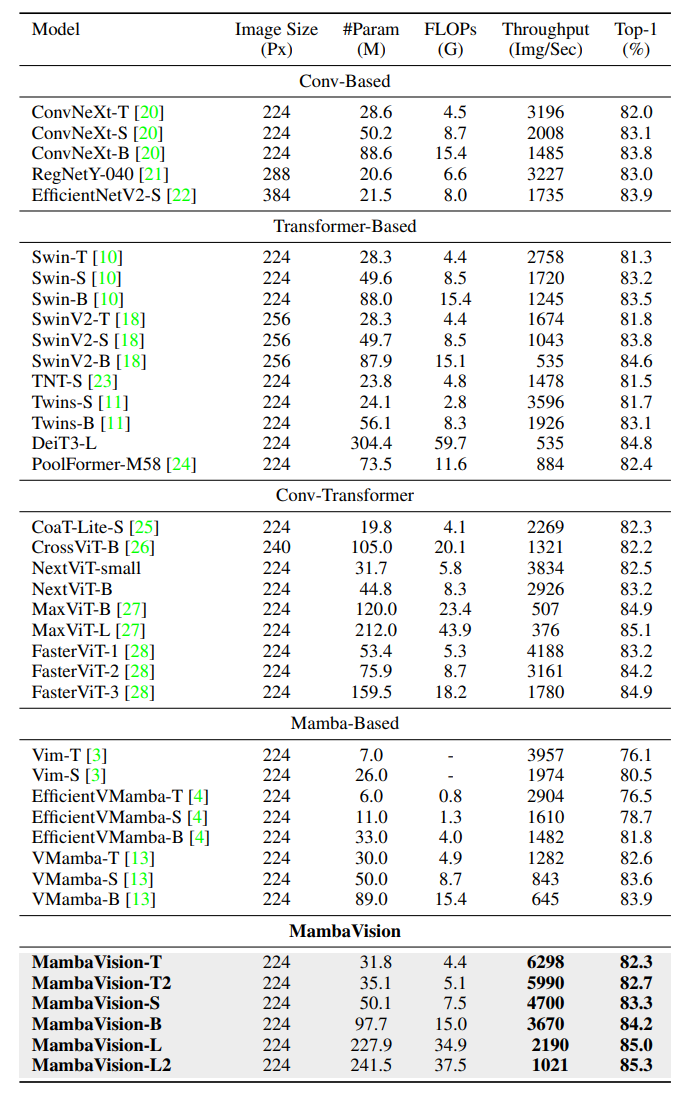
以下是在 ImageNet-1 k 上的结果。实验表示模型大幅度超过了之前的研究。也可以看出来,在准确的同时,计算量也比同等大小的模型低很多。
目标检测与分割

以下展示了 MS COCO 数据集上的目标检测与实例分割结果
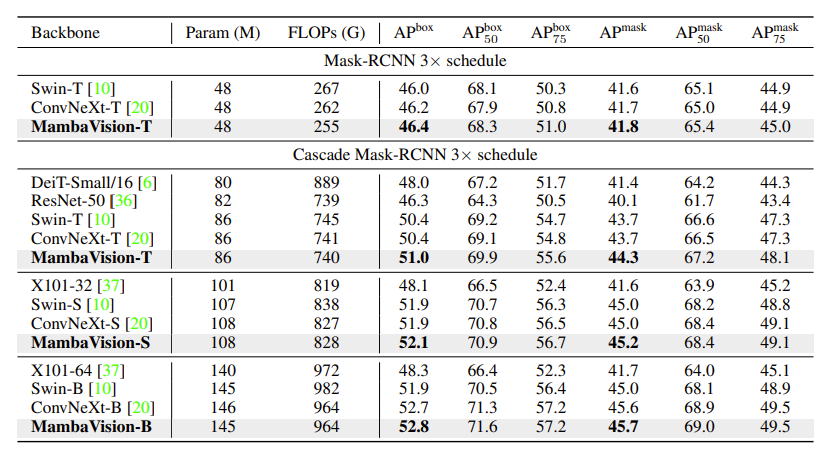
该实验验证了这个视觉骨干的有效性。

以下是在 ADE 20 K 数据集上进行的语义分割测试。
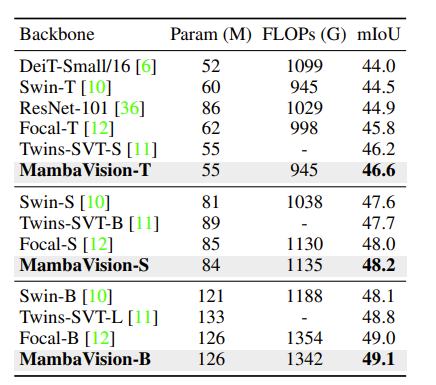
以上实验表明:MambaVision 作为不同视觉任务的骨干是可行的,尤其是在高分辨率下。

消融实验

Token Mixer 的设计
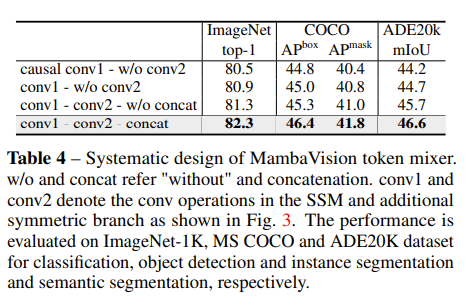
测试了以下的情况:

  • 原始公式:SSM 分支中为因果卷积(casual Conv),无额外分支
  • 将因果卷积换为普通的卷积
  • 添加额外分支,使用与 Mamba 相同的门控机制
  • 添加额外分支,使用连接(模型中使用的方法)
    准确率不断提高。

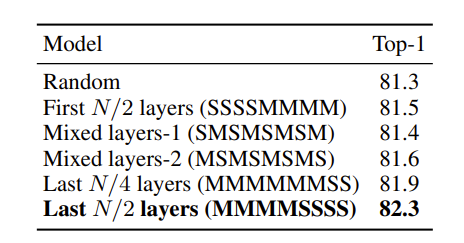
混合模式

通过对 MambaVision 模块与 transformer 模块的不同排列测试,可以发现,前一半全是 MambaVision 模块,后一半全是 transformer 模块的准确率最高。

【论文阅读 | CVPR 2025 |MambaVision:一种混合 Mamba-Transformer 视觉骨干网络】 我们提出了一种新颖的混合 Mamba-Transformer 骨干网络 MambaVision,专为视觉应用量身设计。我们的核心贡献包括重新设计 Mamba 公式,以增强其对视觉特征的高效建模能力。通过全面的消融研究,我们证明了将视觉 Transformer(ViT)与 Mamba 集成的可行性。研究结果表明,在Mamba 架构的最后几层配备自注意力块,能显著提升其捕捉长距离空间依赖关系的能力。基于这些发现,我们推出了一系列 MambaVision 模型,它们采用层次化架构,可满足不同的设计需求。 阅读详情

相关推荐

NIPS 2024 | 混合Mamba用于少样本分割

许多少样本分割(FSS)方法使用交叉注意力来融合支持前景(FG)到查询特征中,尽管其复杂度是二次的。最近的一项进展Mamba也能够很好地捕捉序列内的依赖关系,但其复杂度仅为线性。因此,作者的目标是设计一种交叉(类似注意力)Mamba来捕捉FSS中的序列间依赖关系。一个简单的想法是在支持特征上进行扫描,选择性地将其压缩到隐藏状态中,然后将其用作初始隐藏状态来顺序扫描查询特征。

小白学视觉 300

MambaVision: A hybrid mamba-transformer vision backbone

相反, 空间关系通常是局部的,需要以更并行和综合的方式 考虑。我们提出了一种混合架构,包括了mambaVision Mixer和transformer公式,具体而言,我们研究了不同的集成模式,例如以等参数的方式将transformer模块添加到中期,中间和最终层以及每隔l层,我们的分析表明,在最终阶段利用多个自注意力模块可以显著的增强捕捉全局上下文和长距离空间依赖的能力,引入了mambavision模型,该模型由多分辨率架构组成,并利用基于cnn的残差快快速提取更大分辨率特征。

liguandong 477

防火墙旁挂组网

分析拓扑结构,涉及路由器、交换机、防火墙。步骤包括基础 IP 配置、OSPF、防火墙双机热备、安全策略等。第一步,路由器配置。R5、R6 连接 ISP 和核心交换机,配置接口 IP,然后 OSPF。然后防火墙,双机热备的 HRP、VRRP,还有安全策略。接着交换机,划分 VLAN,配置 TRUNK,加入 OSPF。

weixin_73298423的博客 904

Mamba+Transformer完美融合,效果炸裂!

因模型规模的扩展和需要处理的序列不断变长,transformer逐渐出现计算量激增、计算效率下降等问题,研究者们提出了——,它结合了递归神经网络(RNN)和卷积神经网络(CNN)的特点,以提高处理长序列数据时的计算效率。为帮助同学们获取灵感,我整理了5种今年最新的Mamba结合创新方案,希望能给各位的学术研究提供一些帮助。

m0_73122726的博客 2021

CST局部网格加密实战:从基础设置到Meshgroup高效管理

本文详细解析了CST电磁仿真软件中的局部网格加密技术,重点介绍Meshgroup功能的高效管理方法。通过平行板电容等实战案例,阐述从基础设置到多级加密策略的完整流程,帮助用户精准提升关键区域仿真精度,同时优化计算资源使用效率。

grafana6viz的博客 695

ADS实战指南:负载牵引(Loadpull)在射频功放设计中的关键应用

本文深入解析了负载牵引(Loadpull)技术在射频功率放大器设计中的核心作用与实战方法。通过生动的比喻和详细的ADS软件操作指南,阐述了如何通过系统扫描负载阻抗,在史密斯圆图上绘制等功率线与等效率线,从而精准找到最优阻抗点,以平衡输出功率与效率,是应对5G等现代通信系统严苛要求的必备技能。

weixin_29198045的博客 602

MambaVision: A Hybrid Mamba-Transformer Vision Backbone

对于计算机视觉任务来说,它不像序列任务那样(关注序列顺序),它考虑它周围的信息(上下左右)。计算机视觉任务需要关注全局的信息,但mamba只能看到每一时刻前的序列信息。

m0_74413554的博客 937

药物对接仿真软件:HADDOCK_(16).实践项目:抗体-抗原对接案例

定义分子结构文件。

kkchenjj的博客 580

[CVPR2025] MambaVision: A Hybrid Mamba-Transformer Vision Backbone 一种混合Mamba-Transformer视觉主干

MambaVision:混合Mamba-Transformer视觉骨干网络 MambaVision是一种专为视觉任务设计的新型混合架构,结合了改进的Mamba模块和Transformer模块。其核心创新包括:1)重新设计Mamba公式,通过非因果卷积和对称分支增强视觉特征建模能力;2)提出最优混合策略,在深层引入Transformer模块以捕获长程依赖。实验表明,该架构在ImageNet-1K分类任务上达到84.2%准确率,同时在MS COCO和ADE20K等下游任务中表现优异。消融研究验证了组件设计和集成

geekchen的博客 811

【DeepSeek R1构建本地RAG知识库】数据结构化清洗-工作流自动清洗

在构建本地RAG知识库时,数据结构化清洗是关键但繁琐的步骤。传统方法效率低且易出错,而低代码/无代码平台如Dify提供了更高效的解决方案。Dify通过可视化工作流设计,集成大模型智能处理,支持多格式输入输出,无需编码即可完成复杂的数据清洗任务。文章详细介绍了数据结构化的核心困境、目标、价值及类型,并比较了TXT与Markdown在RAG系统中的适用性。最后,通过Dify平台实战演示了如何在20分钟内完成规则制度文档的结构化清洗,输出标准化数据,展示了自动化工作流在数据处理中的高效性和便捷性。

少说,多做 1223

logisim中,如何设计一个位于十字路口的交通信号灯控制系统?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值。

**My Coding Family** 1347

CVPR2025:MambaVision: A Hybrid Mamba-Transformer Vision Backbone

我们提出了一种新颖的混合 Mamba-Transformer 主干网络 MambaVision,专为视觉应用量身定制。我们的核心贡献包括重新设计 Mamba 的公式,以增强其高效建模视觉特征的能力。通过全面的消融研究,我们证明了将 Vision Transformers (ViT) 与 Mamba 集成的可行性。结果表明,在 Mamba 架构的最终层中引入自注意力模块,可以显著提升其捕捉长距离空间依赖关系的能力。基于这些发现,我们引入了一系列具有分层架构的 MambaVision 模型,以满足各种设计标准。

AbiUni(YY熊) 929

数据分享|2023年OSM道路数据(全国,分省,分市)

首先这个工作非常有必要的,因为我们正常使用的道路的分类都是基于包括城市快速路、城市主干路、城市次干路这个体系的,大家对于这个分类体系应该更熟悉,但是OSM地图的道路分类又不是完全按这个来的,所以非常有必要重新分类;搞清楚道路类型是我们使用道路数据做很多工作的基础,比如我们在使用道路数据的时候,经常需要预估道路的行车速度,而这个速度一般就是根据道路类型来的,比如高架路的车速肯定就比城市支路快很多!下载分为两种情况,第一种是下载小区域的数据,比如下载一个街区的数据,第二种为下载整个中国范围的。

JData_Engineer的博客 4307

CVPR2025论文解析|MambaVision A Hybrid Mamba-Transformer Vision Backbone-water-merged

本文提出了一种新颖的混合Mamba-Transformer主干网络,称为MambaVision,专门针对视觉应用而设计。核心贡献在于重新设计Mamba公式,以增强其对视觉特征进行有效建模的能力。通过对将视觉Transformer(ViT)与Mamba集成的全面消融研究,结果表明,在Mamba架构的最终层配备多个自注意力块显著提高了捕获长距离空间依赖的能力。

SJ_HP的博客 1549

总结一下:电源设计 ≠ 画个电路图就完了

如果你面对一块电源板时,只知道输入输出是多少伏,那你离真正懂它还差十万八千里。你要懂拓扑、理解工作原理、看懂波形、会分析环路、熟练选型,还得懂调试、EMC和热设计——才能自信地说:“我会搞电源了。电源不是一个人能独挑的“电”,而是控制、模拟、热、EMC 多学科交融的“多面体”。这也是为什么它既复杂又迷人✨。

weixin_43199439的博客 144

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【论文解读】MambaVision: A Hybrid Mamba-Transformer Vision Backbone

摘要: 论文《MambaVision: A Hybrid Mamba-Transformer Vision Backbone》提出了一种结合Mamba线性复杂度与Transformer全局建模能力的混合视觉架构。针对Mamba直接处理图像的缺陷(空间关系割裂、局部特征缺失),作者设计了分层混合策略:浅层采用CNN高效降采样,深层融合MambaVision Mixer(SSM分支+对称辅助分支)与Transformer模块。实验表明,该模型在ImageNet分类、COCO检测和ADE20K分割任务中均超越Sw

一碗白开水一 446

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

江大白 | 视觉Transformer与Mamba的创新改进,完美融合(附论文及源码)

在本文中,作者引入了MambaVision,这是首个专门为视觉应用设计的Mamba-Transformer混合骨架。作者提出了重新设计Mamba公式的方法,以增强全局上下文表示的学习能力,并进行了混合设计集成模式的综合研究。

csdn_xmj的博客 5263

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

YOLOV11|YOLO12改进系列指南

YOLOV11V12改进系列指南,仅仅69.9包含YOLOV11V12模型改进方案、含有440+种改进的集合,且含有多种二次创新和原创改进!

qq_37706472的博客 15万+

RTDETR改进专栏(包含RTDETR、YOLOV5-DETR、YOLOV8-DETR)

RTDETR改进专栏(性价比高,创新度高),目前RTDETR改进已经有350+个改进点!

qq_37706472的博客 7万+

MambaVision

NVIDIA摘要我们提出了一种新型的混合Mamba-Transformer主干网络,命名为MambaVision,它专门为视觉应用而设计。我们的核心贡献包括重新设计Mamba公式,以提高其有效建模视觉特征的能力。此外,我们对集成视觉变换器(ViT)与Mamba的可行性进行了全面的消融研究。我们的结果表明,在Mamba架构的最后一层加入多个自注意力模块大大提高了捕获长程空间依赖性的建模能力。基于我们的发现,我们引入了一系列具有分层架构的MambaVision模型,以满足各种设计标准。

qq_45800507的博客 1414

MambaVision:一种Mamba-Transformer混合视觉骨干网络

我们提出了一种新型混合Mamba-Transformer主干网络,称为MambaVision,该网络专为视觉应用而设计。我们的核心贡献包括重新设计Mamba公式,以增强其对视觉特征的高效建模能力。此外,我们还对将视觉Transformer(ViT)与Mamba集成的可行性进行了全面的消融研究。我们的结果表明,在最终层添加几个自注意力模块可以显著提高捕捉长距离空间依赖关系的建模能力。基于我们的发现,我们引入了一系列具有分层架构的MambaVision模型,以满足各种设计标准。

AI浩 2058

【CVPR 2025】 炸场新作!MambaVision 横空出世,重新定义视觉主干网络

MambaVision 是 CVPR 2025 提出的一款混合型 Mamba-Transformer 视觉主干网络,旨在解决 Transformer 在长序列处理中的计算瓶颈。该模型通过融合 Mamba 的线性复杂度序列建模能力和 Transformer 的全局上下文捕捉优势,显著提升了视觉任务的性能。MambaVision 采用四阶段分层架构,前两阶段使用 CNN 快速提取高分辨率特征,后两阶段结合 Mamba 和自注意力模块,实现高效全局与局部建模。实验表明,MambaVision 在图像分类、目标检测

qq_57268469的博客 3629

MambaVision原理和源码调测

后面可以看到代码实现也是按照N/2写的。

寸先生的AI道路 4359

深入浅出一文图解Vision Mamba(ViM)

问题总结:遇见的问题可以参考这个链接,总结的比较全面。Mamba 环境安装踩坑问题汇总及解决方法关键就是下载和mamba_ssm,最好是下载离线的whl文件,然后再用pip进行安装。值得注意的一点就是要用官方项目里的mamba_ssm替换安装在conda环境里的mamba_ssm。2024年04月29日16:57:45,今天已完成环境的安装与即插即用模块实例化和相关论文的分享;在近期会充分学习Mamba后对其理论进行分享,帮助快速简要理解原文Mamba相关理论。

陈嘿萌的博客 2万+

Vision Mamba:使用双向状态空间模型进行高效视觉表示学习

该方法利用位置嵌入对图像序列进行标记,并利用双向状态空间模型对视觉表示进行压缩。ViT可以通过自注意为每个图像块提供数据/块相关的全局上下文通过将图像视为没有2D归纳偏差的补丁序列来进行模态不可知建模,这使其成为多模态应用的优选架构VIT的缺点:处理长距离视觉依赖时的速度和内存使用较差Mamba用于视觉任务的挑战:单向建模和缺乏位置意识本文提出Vision Mamba(Vim),它采用了双向SSM数据相关的全局视觉上下文建模和用于位置感知视觉理解的位置嵌入。

小刘的博客 3837

Transformer和Mamba强强结合!最新混合架构全面开源,推理速度狂飙8倍

最近发现,,效果会比单独使用好很多,这是因为该方法结合了Mamba的长序列处理能力和Transformer的建模能力,可以显著提升计算效率和模型性能。典型案例如大名鼎鼎的Jamba:Jamba利用Transformer架构的元素增强Mamba 结构化状态空间模型技术,提供了 256K 上下文窗口,吞吐量直接超了Transformer三倍。除Jamba外,近日又有不少最新提出的Transformer结合Mamba的研究,效果都很赞,比如Mamba-2-Hybrid,推理速度比Transformer快8倍。

学姐带你玩AI的博客 1万+
上一篇: 论文阅读:VideoMamba: State Space Model for Efficient Video Understanding
下一篇: 论文阅读:A Data-Driven Deep Learning Model for Weekly Sea Ice Concentration Prediction of the 。。。
ghost_him
博客等级 码龄6年 598粉丝 90原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值