基于用户投票的排名算法(五):威尔逊区间

【每周一篇】推荐算法之威尔逊区间法 简单阐述一下自己的学习计划: 【每周一篇】更侧重于理论,希望尽量能够形成一个体系或者完整的脉络 当然,也不排除因为业务或者紧急需求,突然跳到某个领域的可能~ 【每周代码】更侧重于代码实践,可能是fork一个优秀项目,分析核心代码和算法思路,也可能是自己实现一个小项目demo(如果是这个的话,可能会持续好几周都是同一个算法了hhhh) 因为具体工作的空闲时间不定,所以不能保证每周都能更新【一篇】和【... 阅读详情

http://www.ruanyifeng.com/blog/algorithm/

迄今为止,这个系列都在讨论,如何给出"某个时段"的排名,比如"过去24小时最热门的文章"。

但是,很多场合需要的是"所有时段"的排名,比如"最受用户好评的产品"。

这时,时间因素就不需要考虑了。这个系列的最后两篇,就研究不考虑时间因素的情况下,如何给出排名。

一种常见的错误算法是:

  得分 = 赞成票 - 反对票

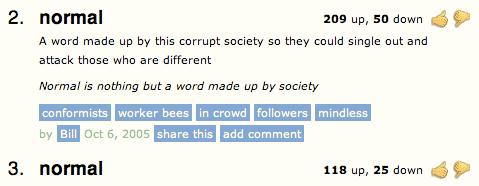
假定有两个项目,项目A是60张赞成票,40张反对票,项目B是550张赞成票,450张反对票。请问,谁应该排在前面?按照上面的公式,B会排在前面,因为它的得分(550 - 450 = 100)高于A(60 - 40 = 20)。但是实际上,B的好评率只有55%(550 / 1000),而A为60%(60 / 100),所以正确的结果应该是A排在前面。

Urban Dictionary就是这种错误算法的实例。
  

另一种常见的错误算法是

  得分 = 赞成票 / 总票数

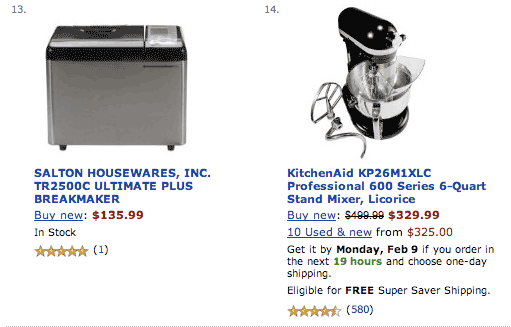
如果"总票数"很大,这种算法其实是对的。问题出在如果"总票数"很少,这时就会出错。假定A有2张赞成票、0张反对票,B有100张赞成票、1张反对票。这种算法会使得A排在B前面。这显然错误。

Amazon就是这种错误算法的实例。
  

那么,正确的算法是什么呢?

我们先做如下设定:

  (1)每个用户的投票都是独立事件。

  (2)用户只有两个选择,要么投赞成票,要么投反对票。

  (3)如果投票总人数为n,其中赞成票为k,那么赞成票的比例p就等于k/n。

如果你熟悉统计学,可能已经看出来了,这是一种统计分布,叫做"二项分布"(binomial distribution)。这很重要,下面马上要用到。

我们的思路是,p越大,就代表这个项目的好评比例越高,越应该排在前面。但是,p的可信性,取决于有多少人投票,如果样本太小,p就不可信。好在我们已经知道,p是"二项分布"中某个事件的发生概率,因此我们可以计算出p的置信区间。所谓"置信区间",就是说,以某个概率而言,p会落在的那个区间。比如,某个产品的好评率是80%,但是这个值不一定可信。根据统计学,我们只能说,有95%的把握可以断定,好评率在75%到85%之间,即置信区间是[75%, 85%]。

这样一来,排名算法就比较清晰了:

  第一步,计算每个项目的"好评率"(即赞成票的比例)。

  第二步,计算每个"好评率"的置信区间(以95%的概率)。

  第三步,根据置信区间的下限值,进行排名。这个值越大,排名就越高。

这样做的原理是,置信区间的宽窄与样本的数量有关。比如,A有8张赞成票,2张反对票;B有80张赞成票,20张反对票。这两个项目的赞成票比例都是80%,但是B的置信区间(假定[75%, 85%])会比A的置信区间(假定[70%, 90%])窄得多,因此B的置信区间的下限值(75%)会比A(70%)大,所以B应该排在A前面。

置信区间的实质,就是进行可信度的修正,弥补样本量过小的影响。如果样本多,就说明比较可信,不需要很大的修正,所以置信区间会比较窄,下限值会比较大;如果样本少,就说明不一定可信,必须进行较大的修正,所以置信区间会比较宽,下限值会比较小。

二项分布的置信区间有多种计算公式,最常见的是"正态区间"(Normal approximation interval),教科书里几乎都是这种方法。但是,它只适用于样本较多的情况(np > 5 且 n(1 − p) > 5),对于小样本,它的准确性很差。

1927年,美国数学家 Edwin Bidwell Wilson提出了一个修正公式,被称为"威尔逊区间",很好地解决了小样本的准确性问题。


在上面的公式中,表示样本的"赞成票比例",n表示样本的大小,表示对应某个置信水平的z统计量,这是一个常数,可以通过查表或统计软件包得到。一般情况下,在95%的置信水平下,z统计量的值为1.96。

威尔逊置信区间的均值为


它的下限值为


可以看到,当n的值足够大时,这个下限值会趋向。如果n非常小(投票人很少),这个下限值会大大小于。实际上,起到了降低"赞成票比例"的作用,使得该项目的得分变小、排名下降。

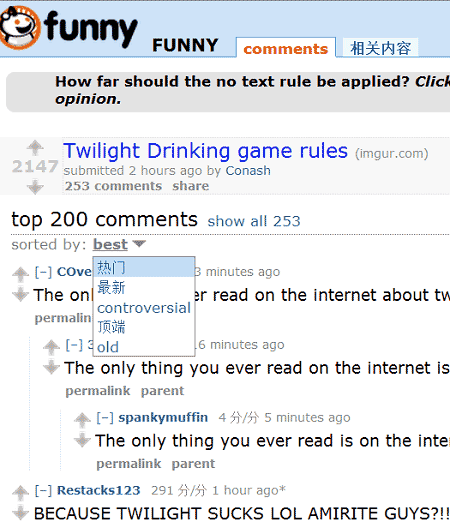
Reddit的评论排名,目前就使用这个算法。
  

Wilson Score 排序算法 威尔逊得分(Wilson Score)排序算法,用于质量排序,针对含有好评和差评的数据,综合考虑评论数与好评率,得分越高质量越高。 u:正例数(好评) v:负例数(差评) n:实例总数(评论总数) p:好评率 z:是正态分布的分位数(一般取值2即可,即95%的置信度) S:表示最终的威尔逊得分。 ... 阅读详情

相关推荐

wilson_score:简单,无依赖的Wilson评分

威尔逊分数 简单,无依赖的 受埃文·米勒(Evan Miller)进行启发 如何使用 5分中有3分正面评价,置信度为95% WilsonScore . lower_bound ( 3 , 5 ) 可以提高分数,尤其是对于少量样本(n <30)。 从0.1.0版本开始,默认情况下启用。 要禁用连续性校正,请使用: WilsonScore . lower_bound ( 3 , 5 , correction : false ) 默认的置信度是95%。 要更改此设置,请使用: WilsonScore . lower_bound ( 3 , 5 , confidence : 0.99 ) 要获取完整间隔,请使用: WilsonScore . interval ( 3 , 5 ) 星级评分 您有一个评级系统,用户可以对1到5星的产品进行评级。 一个产品有两个等级-一个4星和一个5星。

威尔逊置信区间算法

此算法的基础是以用户对某种抉择的二项性为基础,每条可记录的数据都是“0-1”的独立事件,符合泊松分布,于是该类数据很容易归类于二项分布里。二项分布计算置信区间有多种计算公式,最常见的是“正太区间”(Normal approximation interval),但它只适用于样本较多的情况(np > 5 且 n(1 − p) > 5),对于小样本,它的准确性很差。Wilson算法正是解决了...

_Seven°的博客 2万+

Unity Spine动画控制全攻略:播放、回调与停止的实战技巧

本文深入解析Unity中Spine动画的核心控制技巧,涵盖动画播放、轨道分层、事件回调与平滑停止等实战方法。通过封装SpineAnimationController,详细讲解了如何利用动画播放结束回调实现精准的游戏逻辑同步,并提供了避免内存泄漏和动画卡顿的避坑指南,助力开发者打造流畅专业的2D游戏动画系统。

weixin_29021291的博客 378

java 投票算法_基于用户投票的排名算法(五):威尔逊区间

迄今为止,这个系列都在讨论,如何给出"某个时段"的排名,比如"过去24小时最热门的文章"。但是,很多场合需要的是"所有时段"的排名,比如"最受用户好评的产品"。这时,时间因素就不需要考虑了。这个系列的最后两篇,就研究不考虑时间因素的情况下,如何给出排名。一种常见的错误算法是:得分 = 赞成票 - 反对票假定有两个项目,项目A是60张赞成票,40张反对票,项目B是550张赞成票,450张反对票。请问...

weixin_39609541的博客 467

深入LSM6DSL的FIFO连续模式:基于STM32和MEMS库的数据流高效处理指南

本文深入探讨了LSM6DSL的FIFO连续模式,结合STM32硬件平台和ST官方MEMS库,提供了高效的数据流处理方案。通过优化I2C通信时序、中断驱动设计以及动态ODR调整,实现低功耗数据采集与处理,显著提升嵌入式传感器应用的性能和续航能力。

weixin_30387799的博客 349

深入Luckfox Pico的Web界面:从Angular前端到CGI后端的RV1106 IPCWeb全栈解析

本文深入解析了基于瑞芯微RV1106芯片的Luckfox Pico设备上,IPCWeb全栈解决方案的架构与部署。详细介绍了如何通过SDK编译配置,将现代Angular前端框架与高效的C++ CGI后端结合,并利用nginx和FastCGI在嵌入式环境中构建稳定、高性能的Web管理界面,为物联网设备开发提供了完整的实战参考。

3a9bq4r8t2y的博客 277

威尔逊置信区间 php,基于用户投票的排名算法(五):威尔逊区间

迄今为止,这个系列都在讨论,如何给出"某个时段"的排名,比如"过去24小时最热门的文章"。但是,很多场合需要的是"所有时段"的排名,比如"最受用户好评的产品"。这时,时间因素就不需要考虑了。这个系列的最后两篇,就研究不考虑时间因素的情况下,如何给出排名。一种常见的错误算法是:得分 = 赞成票 - 反对票假定有两个项目,项目A是60张赞成票,40张反对票,项目B是550张赞成票,450张反对票。请问...

weixin_33699970的博客 243

学习记录(十一)--Pattern Recognition投稿记录

上一周特别忽然通知统计建模要答辩,确定是否晋级国赛,一直在准备答辩的事情,所以上一周没有总结周汇报,深刻检讨!!!不过结果是好的,我们组第二名晋级哦。这周主要是跟大家分享一下我投稿PR(Pattern Recognition)的一个时间线,以及投稿后的工作。一、PR从投稿到接收的时间线2025.4.3 Major Revision(ddl4.23) 当时正在弄比赛和另一个着急推进的文章2025.5.30 Minor Revision 这次小修基本上只有一些格式和简单一点点问题。

qq_54949944的博客 1918
上一篇: Bandit算法
下一篇: c++map按value排序--将map的pair对保存到vector中,然后写比较仿函数+sort完成排序过程。
青松愉快
博客等级 码龄14年 71粉丝 14原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
