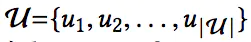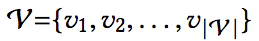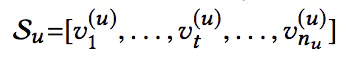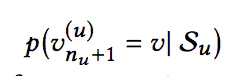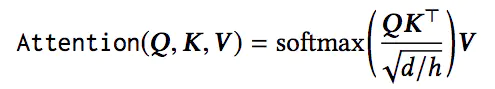
推荐系统遇上深度学习(六十一)-[阿里]使用Bert来进行序列推荐

注意力机制用于推荐系统问题(DIN,DIEN,BERT4Rec,PRM) 当注意力机制都已经变成很tasteless的手法的时候,使用/魔改注意力机制一定要专注讲好自己的故事…即为什么要用Attention,为什么要魔改Attention。 DIN和DIEN都是阿里针对CTR预估的模型,都主要是对用户历史行为数据的进一步挖掘的工作。CTR预估任务是,根据给定广告/物品、用户和大量的上下文情况等信息,对点击进行预测,所以对用户的兴趣理解,历史行为数据非常重要。 Deep Interest Network for Click-Through Rate Prediction(DIN). 阅读详情

本文介绍的论文题目是《BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer》
论文下载地址为:https://arxiv.org/abs/1904.06690

将Transformer运用到推荐系统中,前面也介绍过许多篇相关的论文了,如阿里的DSIN、BST等等,他们都使用Transformer的Encoder部分的网络结构作为模型中的一部分进行使用。同时,在自然语言处理领域,同样使用Transformer的Encoder部分的预训练模型Bert取得了巨大的成功,其一些训练的思路能否同样应用到推荐系统中呢?答案是肯定的,本篇介绍的文章就是如此,一起来了解一下。

1、背景

在推荐系统中,精确捕捉用户的兴趣,是比较关键的。而用户的兴趣是随着历史行为的变化而不断变化的,为了捕捉这种兴趣的变化,一些序列推荐算法被提出。如使用马尔可夫链,使用RNN模型等等。

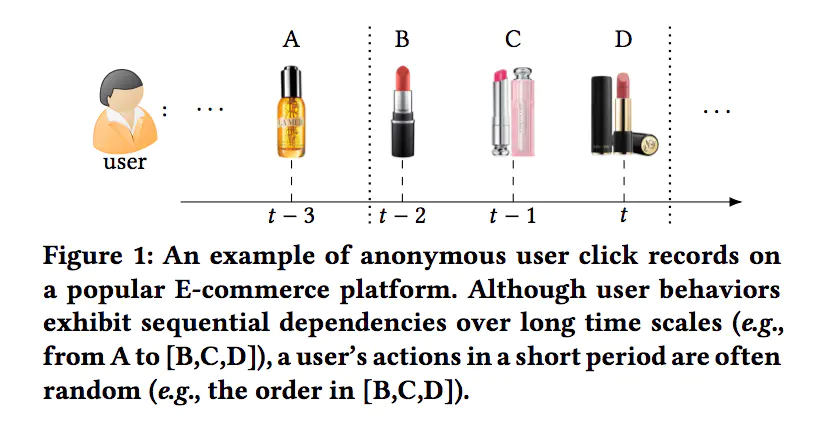
无论是马尔可夫模型还是RNN模型,都是使用用户从前到后的历史行为序列信息,这种单向的结构有时对历史行为序列所能带来的作用是有一定限制的;同时,这种顺序性的假设有时候在实际生活中并不适用,如下图中,三种口红的点击顺序,对于最后的推荐结果影响并不是很大:
因此,本文认为双向模型对于序列推荐来说,更加有效。由于用户的行为序列很像是文本序列,而Bert模型算是当前自然语言处理领域数一数二的模型,其使用Transformer的Encoder进行预训练任务,能够有效利用双向信息,因此本文考虑将Bert用于推荐任务。接下来,咱们就来介绍BERT4Rec模型吧。

2、BERT4Rec模型介绍

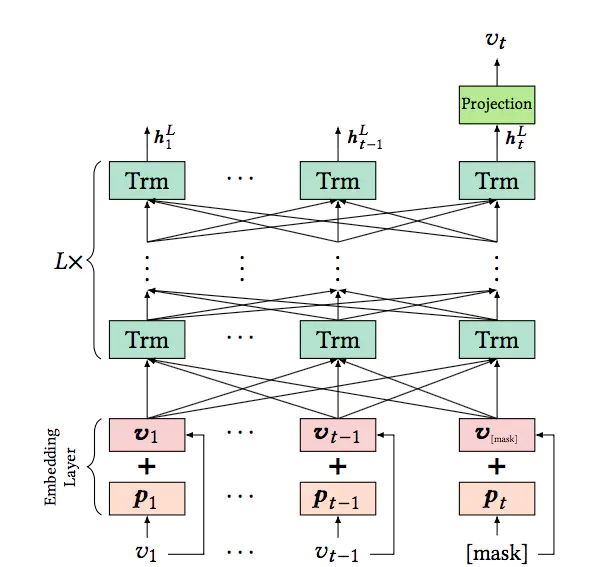
使用BERT进行序列化推荐,其整体的模型结构如下:
2.1 问题定义

在序列化推荐中,我们有如下的符号定义

结构描述
用户集合

物品集合

用户历史行为序列

我们的目标是预测下一时刻用户与每个候选物品交互的概率:

2.2 Embedding Layer

模型的输入主要是用户的历史交互序列,对交互序列中的每一个物品i,其Embedding包含两部分,一部分是物品的Embedding,用vi表示(整个Embedding矩阵用E表示,不仅用在输入层,还用在输出层),另一部分是位置信息的Embedding,用pi表示。这里的pi是可学习的,而不是像最开始提出的Transformer一样是固定的。

另一点需要指出的是,输入并不是使用用户所有的历史行为信息,而是使用最近N个行为。因为用户的行为序列长度差别很大,如果不加限制,可能导致模型过大,性能降低。

2.3 Transformer Layer

Transformer Layer的结构如下:
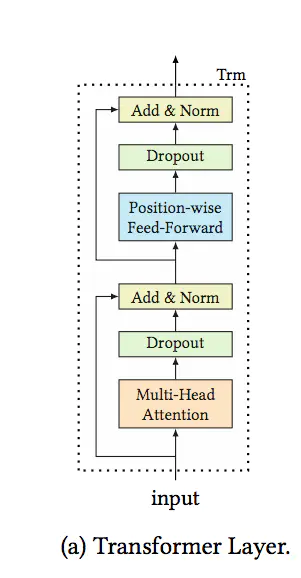
这里具体的Transformer的细节咱就不讲了,之前我写过一篇详细剖析整个过程的文章,感兴趣的同学可以查看:https://www.jianshu.com/p/2b0a5541a17c

对于模型框架中的第l层Transformer Layer,输入为Hl,首先是Multi-Head Self-Attention过程:
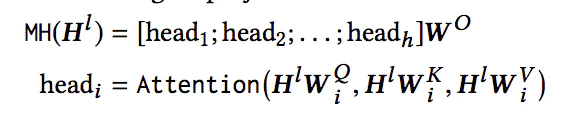
其次是DropOut和Add & Norm过程,这里的Add操作和ResNet类似,使得模型的层数可以非常深,而Norm是我们熟悉的BN操作,其计算方式如下:
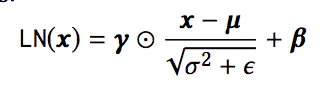
之后是Position-wise Feed-Forward Network,Position-wise的意思是说,每个位置上的输入分别输入到前向神经网络中,计算方式如下:
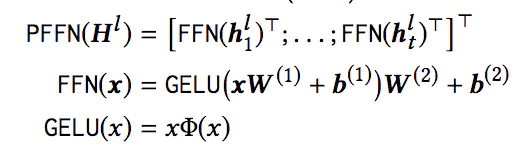
这里采用的激活函数是 Gaussian Error Linear Unit (GELU) ,而非RELU,这个激活函数还是第一次见,其出自论文https://arxiv.org/abs/1606.08415,

GELU的计算公式如下:
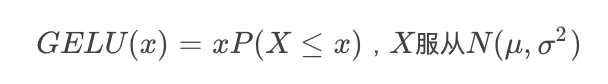
原文中和本文中均使用N(0,1)。GELU和Relu以及ELU的对比图如下:
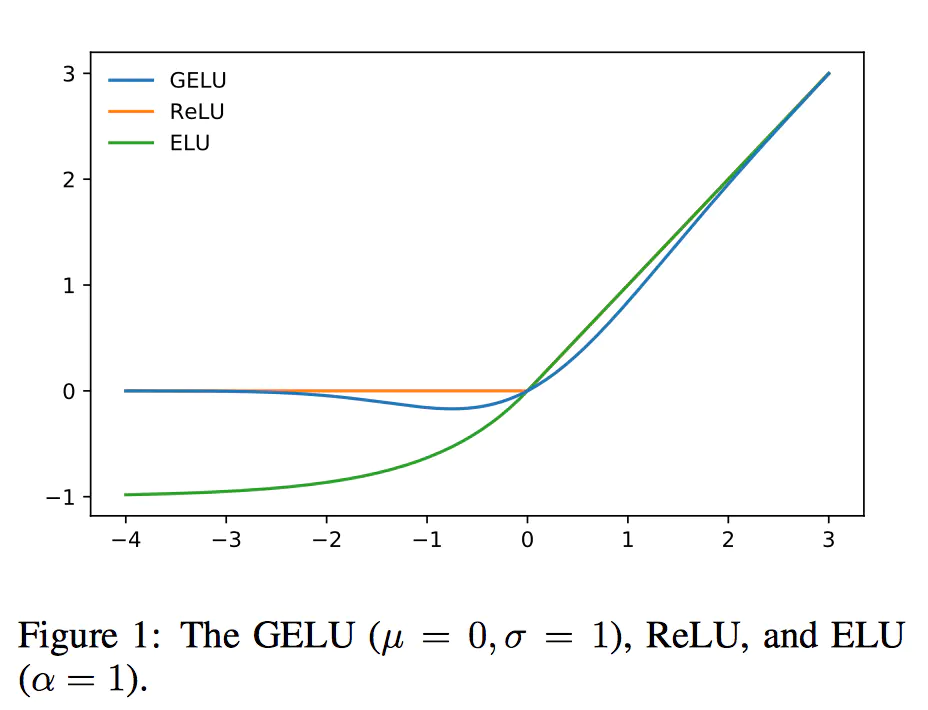
Gelu在relu的基础上加入了统计的特性,在论文中提到的好几个深度学习任务中都取得了更好的实验结果。

最后还是一个Dropout和Add & Norm过程。

2.4 Output Layer

在经过L层的Transformer Layer之后,得到的输出为HL,最后经过两层全连接网络得到最终的输出:
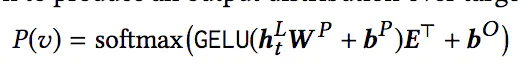
其中,最后一层的参数E,是物品的Embedding矩阵,和输入层是一样的矩阵。

2.5 模型训练和预测

首先再来仔细看一下BERT4Rec的结构,以及对比一下另外两个序列推荐模型:

我们的目的是预测用户下一个要交互的物品vt+1,对于传统的序列推荐模型,如上图中的RNN模型,输入是[v1,v2,...,vt],转换为对应的输出为[[v2,v3,...,vt+1],那么我们自然可以拿最后一个时刻的输出来作为物品进行推荐。

而在BERT4Rec中,并没有这样的转换过程,输入[v1,v2,...,vt-1],其输出只不过是包含了上下文信息的向量[h1,h2,...,ht-1]罢了。在上面的图片中,假设我们要预测用户t时刻的交互物品vt,如果直接把vt作为输入,那么其余每个物品在Transformer Layer中看到目标物品vt的信息,这样就造成了一定程度的信息泄漏。因此图中把对应位置的输入变成了[mask]标记。

训练和预测都可以采用上图中的方式,在预测下一个物品时,在输入序列的最后添加一个[mask]标记,共同作为输入。但是为了提升模型的泛化能力,让模型训练到更多的东西,同时也能够创造更多的样本,在训练阶段,借鉴了BERT中的Masked Language Model的训练方式,随机的把输入序列的一部分盖住(即变为[mask]标记),让模型来预测这部分盖住地方对应的物品:
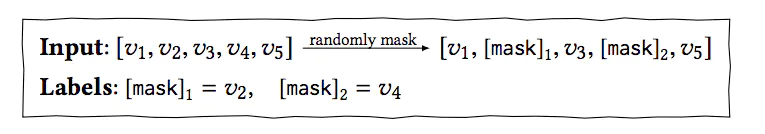
采用这种训练方式,最终的损失函数为:
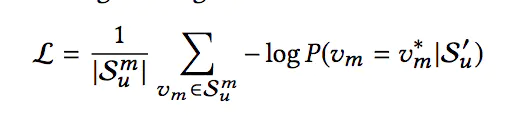
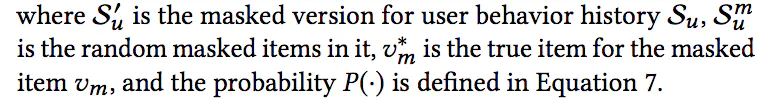
3、实验结果

简单看一下实验结果吧。

文章首先对比了模型和一些Base模型在4个数据集上的表现:
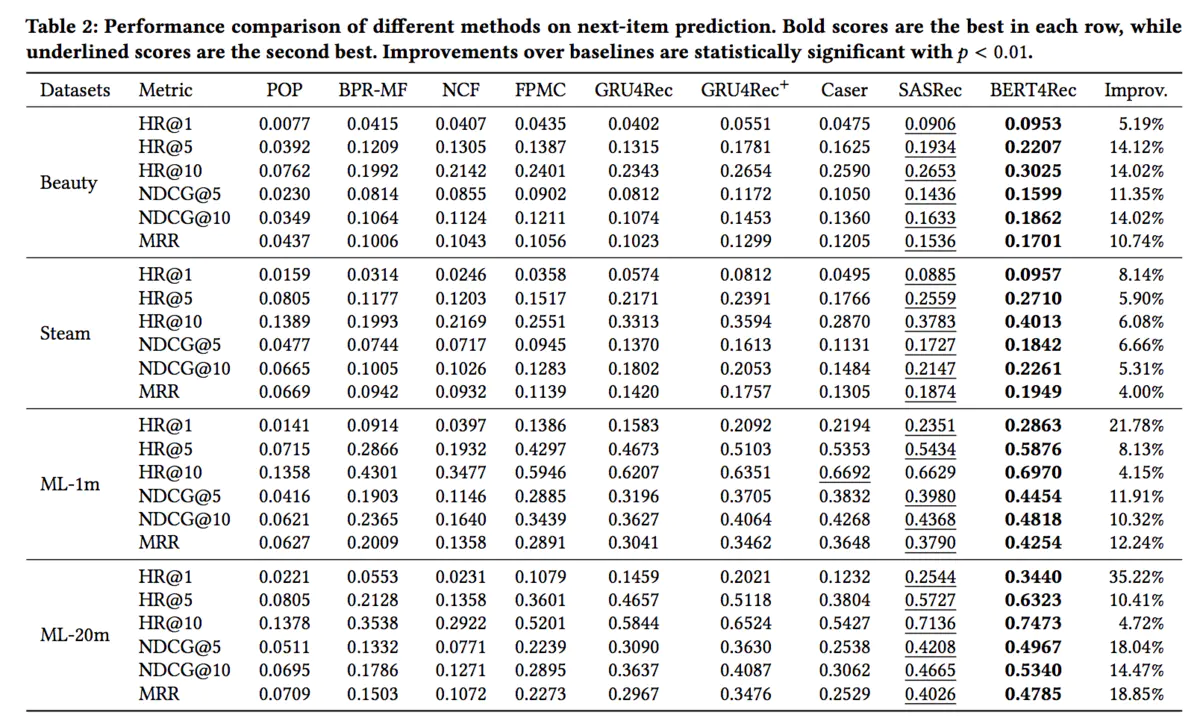
可以看到BERT4Rec模型相较于Base模型,其性能都有较大提升。

接下来,是参数的对比,首先是Embedding的长度d:
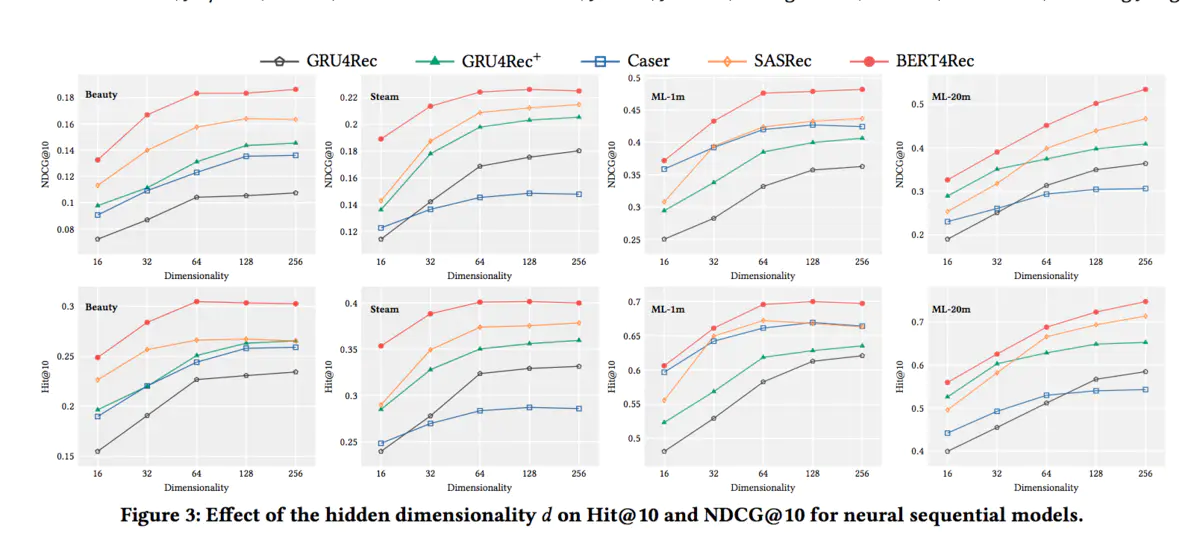
Embedding的长度越长,模型的效果更好。随后是训练时盖住物品的比例:
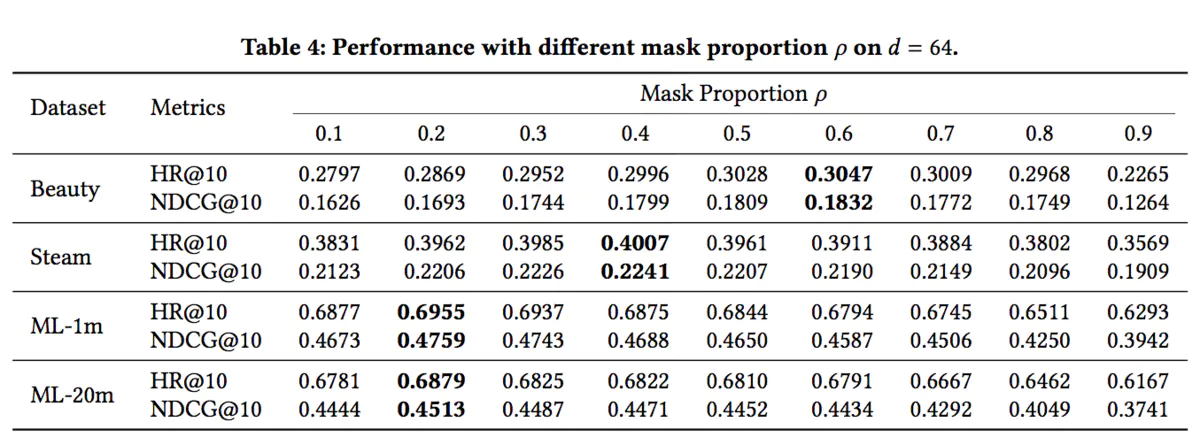
对于不同的数据集来说,最佳比例并不相同。然后是序列的最大长度N:
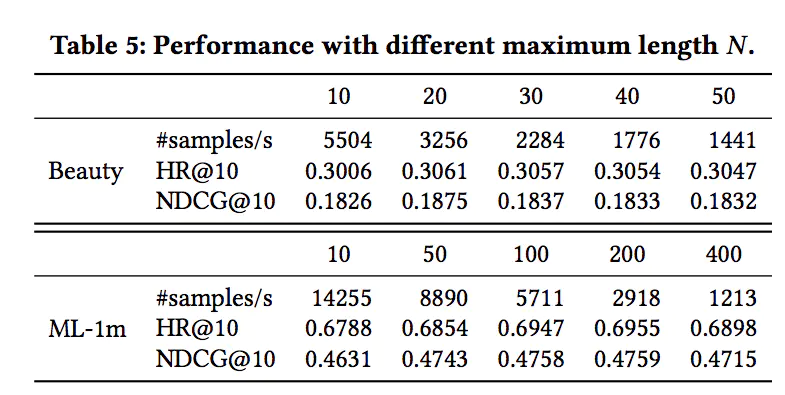
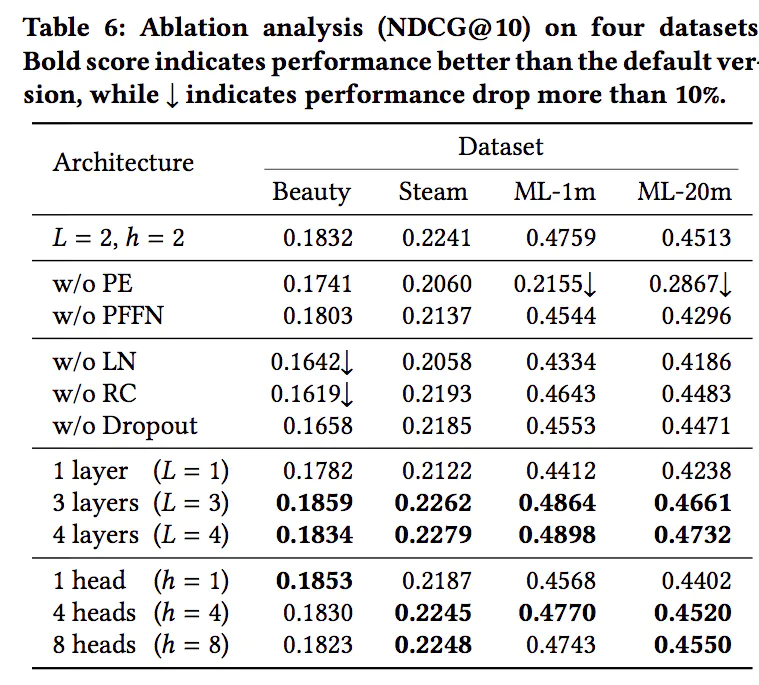
同样,不同的训练集,最佳的序列长度也不相同。最后,是对模型结构的一些对比试验,主要有是否使用PE(positional embedding),是否使用PFFN(position-wise feed-forward network),是否使用LN(layer normalization),是否使用RC(即Add操作,residual connection),是否使用Dropout,以及Transformer Layer的层数和Multi-head Attention中head的个数,结果如下:
4、BERT4Rec VS BST

好了,啰嗦了这么多,最后再多说一点,咱们之前也介绍过一个使用Transformer的推荐模型BST(Behavior Sequence Transformer),其结构如下:
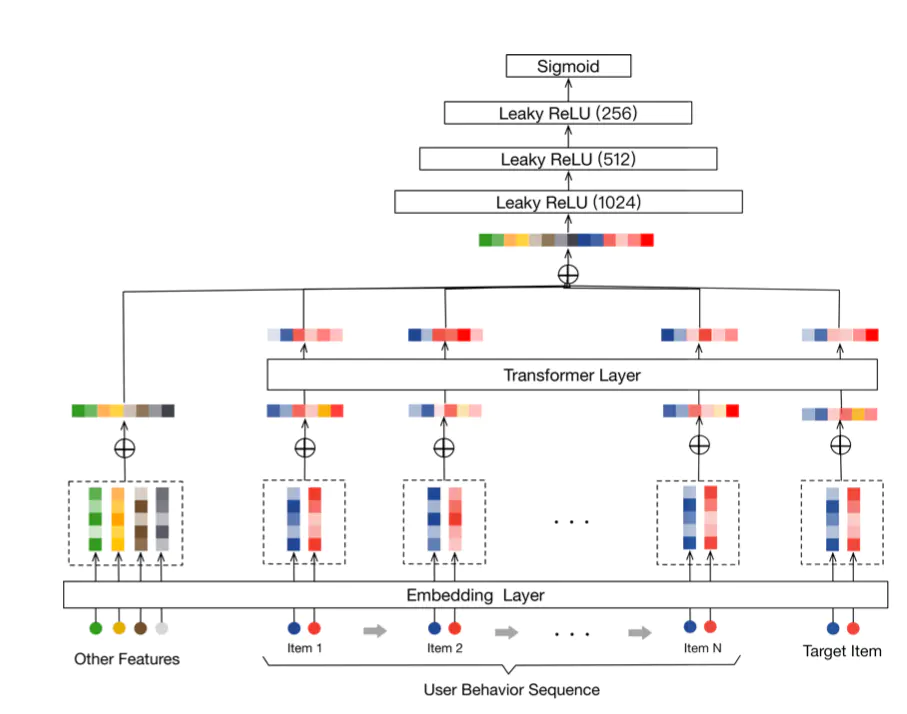
对BST模型来说,需要输入一个target item,模型输出的是点击这个target item的概率;而对BERT4Rec模型来说,模型一次性输出所有候选物品的点击概率,因此在参数差不多的情况下,但从性能而非预测精度来说,BERT4Rec肯定是更好的。因此个人认为,BST用在精排阶段更加合适,而BERT4Rec可以用于召回阶段,也可用于精排阶段。

智能推荐系统:协同过滤与深度学习结合 阅读详情

相关推荐

【EMNLP2019】最新5篇论文推荐,BERT,对话系统,知识图谱,注意力机制等.zip

【EMNLP2019】最新5篇论文推荐,主要涉及BERT,对话系统,知识图谱,注意力机制等。内容丰富,欢迎大家下载学习。

聊天机器人之 BERT4Rec, 使用Bert进行序列推荐

目录0. 本文概览1. BERT4Rec简介2. 背景3. BERT4Rec模型介绍3.1 问题定义3.2 模型结构3.4 Embedding层3.5 Output层3.6 模型训练和预测4. 实验5. 个人感悟6. Reference 0. 本文概览 今天给大家介绍一篇BERT用于推荐系统的文章,题目是《BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer》,文章作者都

Chatopera 2877

基于BERT的推荐系统模型开发详解.pdf

摘要 - 数据准备:构建用户商品特征,文本词化,历史交互记录。 - 模型构建:Encoder用BERT获取语义特征,输出层点积或全连接。 - 模型训练:添加注意力掩码,预训练+fine-tune,混合精度。 - Online服务:用户特征提取,BERT推理,部署API。 - 效果评估:NDCG, Hit Rate, A/B测试,用户反馈。 - BERT表示学习和fine-tuning的能力,使其非常适合推荐系统。 - 通过对各个组件的深入理解和代码实践,可以建立高性能的BERT推荐系统。

一个专为推荐系统定制的BERT!

点击下面卡片,关注我呀,每天给你送来AI技术干货!炼丹笔记干货作者:一元,四品炼丹师来自:来自炼丹笔记U-BERT: Pre-training User Representations...

zenRRan的博客 1037

电子元器件基础:电阻、电容、电感的特性与应用解析

本文深入解析了电子元器件中电阻、电容和电感三大基础元件的核心特性、工作原理与选型应用。电阻作为电路中的‘交通警察’,控制电流与分配电压,其额定功率与精度是关键选型参数。文章结合实战经验,详细阐述了它们在电源滤波、信号处理及高频电路中的不同表现与避坑指南,是电子设计与维修的必备基础知识。

weixin_29213655的博客 379

【Cubietruck】Qt5.8.0 x64、x86、armhf三个版本的编译安装

一、       Preparation 以下环境配置支持虚拟机和实体机,但是实体机生产效率会相对高一点,实体机编译Qt的速度是虚拟机两倍以上。 若使用虚拟机,推荐使用VirtualBox,开源免费,尽量不要使用Vmware破解版。   Download List   名称 链接 下载项目 OS https://mirro

beatfan的博客 3658

【知识图谱】基于BERT的食品推荐知识图谱问答系统

• BERT命名实体识别(NER):使用预训练的BERT模型进行NER,准确识别用户问题中的关键实体(如疾病名称和食品名称),处理复杂句子结构。基于BERT和知识图谱的食品推荐问答系统为用户提供便捷平台,帮助了解特定疾病的食品建议。• 系统回答:“高血压患者适合吃的食物包括芹菜、燕麦、香蕉等。食品对应疾病:输入食品名称,推荐该食品对哪些疾病有益或有害。• 知识图谱:存储疾病与食品的关系,快速检索相关推荐信息。疾病推荐食品:输入疾病名称,推荐适合食用的食品。疾病忌口食品:输入疾病名称,推荐需要避免的食品。

知识靠谱的博客 676

CUDA系列-Stream-1

This section describes static aspects of the CUSW_UNIT_STREAM unit’s architecture.和stream相关的其它Unit主要有Channel,Sync,Memmgr A CUDA stream is a software FIFO queue that allows commands like kernel launch and memcpy to be enqueued in it. The enqueued commands

weixin_43360707的博客 734

【转载】一文读懂BERT(原理篇)

一文读懂BERT(原理篇) 2018年的10月11日,Google发布的论文《Pre-training of Deep Bidirectional Transformers for Language Understanding》,成功在 11 项 NLP 任务中取得 state of the art 的结果,赢得自然语言处理学界的一片赞誉之声。 本文是对近期关于BERT论文、相关文章、代码进行学习后的知识梳理,仅为自己学习交...

lcomecon的博客 1106

Transformer在CV里太耗算力?手把手拆解Restormer的MDTA与GDFN模块

本文深度解析了CVPR2022最佳论文提名作品Restormer的创新模块MDTA与GDFN,有效解决了Transformer在计算机视觉领域的高计算复杂度问题。通过通道注意力降维和门控前馈网络设计,Restormer在图像恢复重建任务中显著降低计算量,同时保持高性能,为实时图像处理提供了可行方案。

weixin_30258901的博客 446

Git救援:如何从误操作中恢复未提交的更改

摘要:本文探讨了误操作git reset --hard导致未提交更改丢失后的恢复方法。首先分析git reflog的局限性,随后介绍利用IDE本地历史记录(如IntelliJ IDEA和VS Code)进行文件恢复的具体步骤。最后建议使用文件系统恢复工具(如Linux的extundelete或Windows的Recuva)作为备选方案。文章强调定期提交的重要性,同时提供了意外发生时可行的恢复策略,帮助开发者尽可能挽回丢失的工作内容。(149字)

2501_90323865的博客 129

RS Meet DL(六十一)-[阿里]使用Bert来进行序列推荐

本文介绍的论文题目是《BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representat...

小小挖掘机 160

VisionMaster脚本调试(VS)

使用VS调试VisionMaster 脚本

yu_fujiang的专栏 3295

大厂,阿里,腾讯,Bert模型推荐系统 ,项目,bert推荐讲解集合

*Bert模型推荐系统 ,项目,bert推荐讲解集合 阿里工程师————bert4rec下载地址:https://arxiv.org/pdf/1904.06690.pdf RS Meet DL(六十一)-[阿里]使用Bert来进行序列推荐,https://mp.weixin.qq.com/s/y23s_Y8Der12NMVw9y2NEA BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Tr

qq_39018604的博客 529

【用unity实现100个游戏之15】开发一个类保卫萝卜的Unity2D塔防游戏1(附项目源码)

当今,塔防游戏已经成为游戏市场上备受欢迎的一类游戏类型。《保卫萝卜》作为其中的经典之作,深受玩家喜爱。本项目旨在基于《保卫萝卜》的玩法和特点,开发一个Unity2D塔防游戏,让玩家可以在游戏中体验到精彩的策略对抗与刺激的关卡挑战。本项目将通过Unity引擎进行开发,利用2D游戏开发相关技术,包括但不限于精灵动画、碰撞检测、UI界面设计等。我们将实现萝卜作为关键角色的防守任务,并设计各种怪物和防御塔,使得游戏具有多样的战术策略和游戏乐趣。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 4924

LLC型自驱动半桥谐振变换器:电压电流变化与自然换向解析

变换器的工作状态经历了多个阶段,从模态一的关断状态,到模态二和三的电流供电状态,每个阶段都得到了合理的设计和优化。的工作原理,尤其是在半个周期内的电压和电流变化。上图 展示了该变换器在工作时的电压和电流波形,它为我们揭示了变换器如何通过精确的电流和电压控制,优化性能并实现高效能转换。,并根据负载情况调整电流和电压的工作模式,能够极大提升变换器的效率,尤其是在零电压开通和自然换向的设计中,发挥着关键作用。这意味着,电流会随着时间周期的变化,呈现典型的振荡波形,从而达到良好的电流控制。是两个关键的电流变量。

weixin_43199439的博客 279

推荐系统-论文阅读

1使用Bert来进行序列推荐-阿里 《BERT4Rec: Sequential Recommendation with Bidirectional Encoder》 局限性:之前的模型时从左到右的、单向结构限制了用户行为序列中隐藏表示的能力;它们通常假定一个严格有序的序列,而这并不总是实用的。 提出了 bert4rec 是应用deep biderectional self-attention ...

serenysdfg的博客 628

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

深度学习在搜索推荐上的应用survey

深度学习在搜索推荐上的应用参考文章 阿里搜索团队智能内容生成实践 【阿里云开发者社区文章】 DNN在YouTube推荐上的应用【论文精读Deep Neural Network for YouTube Recommendation】 用深度学习(CNN RNN Attention)解决大规模文本分类问题 - 综述和实践(安利阿里淘宝搜素推荐事业部大牛清凇) DNN论文分享 - Item2vec 推荐系统遇上深度学习--阿里DMR:Matching和Ranking相结合的点击率预估模型..

Toby的博客 391

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

推荐系统与Attention机制——详解Attention机制

什么是Attention机制? Attention机制的本质来自于人类视觉注意力机制。人们在看东西的时候一般不会从到头看到尾全部都看,往往只会根据需求观察注意特定的一部分。 简单来说,就是一种权重参数的分配机制,目标是协助模型捕捉重要信息。具体一点就是,给定一组<key,value>,以及一个目标(查询)向量query,attention机制就是通过计算query与每一组key的相...

caizd2009的博客 7442

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

KDD2020|阿里联合清华提出多兴趣框架ComiRec用于序列推荐(已开源)

Controllable Multi-Interest Framework for RecommendationYukuo Cen, Jianwei Zhang, Xu Zou, Chan...

hestendelin的专栏 1253

结构体怎么使用本体内的数据作为vector向量初始化参数_BERT4REC:使用Bert进行推荐...

阿里最近有一篇BERT4RC,对我们的工作产生了启发,因为文章的思路非常简单、直接,就是BERT换了个场景应用,因此我们这片文章主要围绕BERT相关的概念从简单到复杂一步步展开,最后说一下他们是怎么用BERT的。为什么需要在推荐中引入attention机制:在介绍attention机制之前,我们先说一下为什么在推荐中需要attention。深度学习在推荐系统的应用中,最经典的范式是Embeddin...

weixin_39547298的博客 366

这本书把大模型推荐系统的核心都讲透了

自 2022 年 11 月 30 日 OpenAI 发布 ChatGPT 以来,大模型技术掀起了新一轮人工智能浪潮。ChatGPT 在各个领域(如人机对话、文本摘要、内容生成、问题解答、识图、数学计算、代码编写等)取得了比之前算法好得多的成绩,很多方面都超越了人类专家的水平,特别是人机对话具备了一定的共情能力,这让 AI 领域的工作者和普通大众都相信 AGI(Artificial GeneralIntelligence,通用人工智能)时代马上就要来临了。

2401_84204413的博客 1190

BERT4Rec:基于双向transformer编码表示的序列化推荐

BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer 摘要 这篇阿里提出的论文,将BERT中提出的双向transformer编码器用于序列化推荐中。然而在双向深度模型中,同时基于左右两个条件会使训练不起作用,因为每个item都可以直接看到terget item。...

qq_35148758的博客 2146

推荐系统十年演进(2015–2025)

推荐系统十年演进(2015–2025) 2015年推荐系统以协同过滤和矩阵分解为主,CTR约5–10%,延迟分钟级;2025年已发展为多模态VLA大模型主导,CTR超30%,延迟降至毫秒级,实现实时意图级推荐。中国厂商(阿里、字节、腾讯等)从跟随Netflix Prize到全球领跑,技术路线历经深度学习(2017)、Transformer(2021)到多模态自进化(2025),推动推荐从内容匹配跃迁至深层意图理解,覆盖电商、社交、机器人等全域场景。量子计算与自进化模型进一步强化系统鲁棒性,标志着推荐系统进入

jzwspace的专栏 1116

推荐系统技术全解析:从协同过滤到大模型推荐

推荐系统的目标非常简单:在海量信息中,为用户推荐最可能感兴趣的内容。用户太多↓内容太多↓如何精准匹配问题。推荐系统是人工智能领域最成功的落地应用之一,也是互联网平台增长的核心引擎。从最初的热门推荐,到协同过滤、矩阵分解、深度学习,再到今天的大模型推荐,推荐系统正在不断向着“理解用户”的方向演进。未来的推荐系统将不再只是简单地预测点击率,而是成为真正能够理解用户需求、辅助用户决策的智能助手。

anew___的博客 287
上一篇: hive出现java.lang.OutOfMemoryError: GC overhead limit exceeded
下一篇: hive mapreduce reducer 调优
青松愉快
博客等级 码龄14年 71粉丝 14原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值