Python进阶11_字典dict和集合set的秘密

Python从入门到实战:系统学习路径与爬虫数据分析项目指南 Python作为一门语法简洁、生态丰富的编程语言,其核心价值在于能够高效处理数据自动化任务与科学计算。理解其基础语法、面向对象编程原理是构建复杂应用的基石,而掌握requests、BeautifulSoup、Pandas、Matplotlib等核心库则能解锁网络爬虫与数据分析两大关键技术领域。这些技术通过模拟请求、解析文档、数据清洗、聚合分析与可视化,将原始信息转化为商业洞察,广泛应用于舆情监控、市场研究、自动化报表等场景。本文聚焦于Python学习路径规划,并通过豆瓣电影爬虫与销售数据分析等实战案例,具体 阅读详情

本节你将看到关于字典dict和集合set更加深入的原理,尤其是关于散列在其中的作用,将回答以下问题:

  • Python 里的 dict 和 set 的效率有多高?
  • 为什么它们是无序的?
  • 为什么并不是所有的 Python 对象都可以当作 dict 的键或 set 里的元素?
  • 为什么 dict 的键和 set 元素的顺序是跟据它们被添加的次序而定的,
  • 为什么不应该在迭代循环 dict 或是 set 的同时往里添加元素?

dict 和 set 的效率有多高

这里做了一个对比实验:对比容器的大小对 dict、set 或 list 的 in 运算符效率的影响。
实验的过程:创建了一个有 1000万个双精度浮点数的数组,名叫 haystack。另外还有一个包含了 1000 个浮点数的 needles数组,其中 500 个数字是从 haystack 里挑出来的,另外 500 个肯定不在 haystack 里。
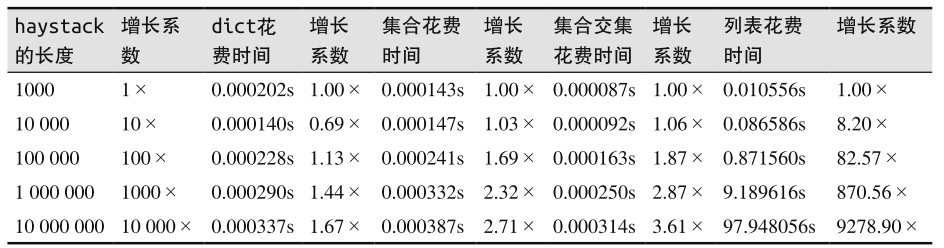
对比实验的结果

实验的结果:

  • 最快的时间来自“集合交集花费时间”
  • 最糟糕的表现来自“列表花费时间”这一列,由于列表背后没有散列支持in运算,所以每次搜索都需要完整的循环一遍.
  • 不管查询有多少个元素的字典或集合,所耗费的时间都能忽略不计

为什么集合和字典查询如此之快?

import sys
import timeit

#SETUP='''
import array
selected = array.array('d')
with open('selected.arr','rb') as fp:
    selected.fromfile(fp,{size})
if {container_tpye} is dict:
    haystack = dict.fromkeys(selected,1)
else:
    haystack = {container_tpye}(selected)
if {verbose}:
    print(type(haystack),end='  ')
    print('haystack:%10d' % len(haystack),end=' ')

needles = array.array('d')
with open('not_selected.arr','rb') as fp:
    needles.fromfile(fp,500)
needles.extend(selected[::{size}//500])
if{verbose}:
    print(' needles: %10d' % len(needles),end='  ')
#'''
---------------------------------------------------------------------------

FileNotFoundError                         Traceback (most recent call last)

<ipython-input-2-0d4afc3d560e> in <module>
      5 import array
      6 selected = array.array('d')
----> 7 with open('selected.arr','rb') as fp:
      8     selected.fromfile(fp,{size})
      9 if {container_tpye} is dict:


FileNotFoundError: [Errno 2] No such file or directory: 'selected.arr'

字典中的散列表

散列表背后是什么

**散列表:**是一个稀疏数组
**稀疏数组:**总是有空白元素的数组
散列表里的单元通常叫作表元(bucket),就是最小的单元元素.
例如:dict字典散列表:每一个键值对就是一个表元,每个表元由两部分组成:

  • 一个是对键的引用
  • 一个是对值的引用
    既然是引用那么每个表元的空间大小是一致的,可以通过偏移量来读取某个表元.

python中的一个原则:保证大概还有三分之一的表元是空的,所以在快要达到这个阈值的时候,原有的散列表会被复制到一个更大的空间里面。
散列表几个特性,如下

散列值和相等性

**散列值:**把一个对象放入散列表,那么首先要计算这个元素键的散列值,通过hash()来获得.

  • 内置的 hash() 方法可以用于所有的内置类型对象。
  • 如果两个对象在比较的时候是相等的,那它们的散列值必须相等,否则散列表就不能正常运行了。
  • 如果 1 == 1.0 为真,那么 hash(1) == hash(1.0) 也必须为真
散列表的算法

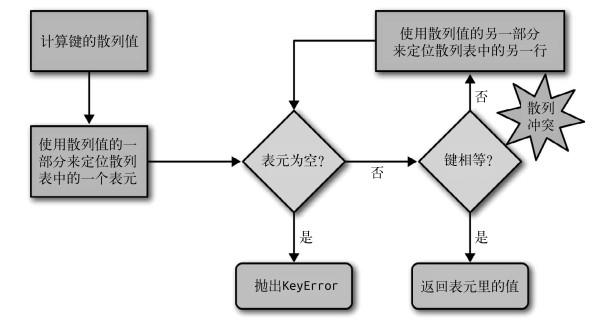
为了获取 my_dict[search_key] 背后的值,散列表的具体的算法的流程如下:

  • Python 首先会调用 hash(search_key) 来计算search_key 的散列值,把这个值最低的几位数字当作偏移量,在散列表里查找表元(具体取几位,得看当前散列表的大小)。
  • 若找到的表元是空的,则抛出 KeyError 异常。
  • 若不是空的,则表元里会有一对 found_key:found_value。

散列表的算法

a = 1
b = 1.0
c = 1.0001
d = 1.0002
print(hash(a))
print(hash(b))
print(hash(c))
print(hash(d))
1
1
230584300921345
461168601842689

散列表给dict带来的优缺点

键必须是可散列的

可散列的对象需要符合如下三个要求:

  • 支持 hash() 函数,并且通过 hash() 方法所得到的散列值是不变的
  • 支持通过 eq() 方法来检测相等性
  • 若 a == b 为真,则 hash(a) == hash(b) 也为真

*所有由用户自定义的对象默认都是可散列的,因为它们的散列值由 id() 来获取

字典在内存上的开销巨大

由于字典使用了散列表,而散列表又必须是稀疏的.

键查询很快

dict 的实现是典型的空间换时间:字典类型有着巨大的内存开销,但它们提供了无视数据量大小的快速访问——只要字典能被装在内存里。

键的次序取决于添加顺序

当往 dict 里添加新键而又发生散列冲突的时候,新键可能会被安排存放到另一个位置。

往字典里添加新键可能会改变已有键的顺序

无论何时往字典里添加新的键,Python 解释器都可能做出为字典扩容的决定。扩容导致的结果就是要新建一个更大的散列表,并把字典里已有的元素添加到新表里。

不要对字典同时进行迭代和修改。

DIAL_CODES = [ 
        (86, 'China'), 
        (91, 'India'), 
        (1, 'United States'), 
        (62, 'Indonesia'), 
        (55, 'Brazil'), 
        (92, 'Pakistan'), 
        (880, 'Bangladesh'), 
        (234, 'Nigeria'), 
        (7, 'Russia'), 
        (81, 'Japan'), 
    ] 

d1 = dict(DIAL_CODES)
print('d1:',d1.keys())
d2 = dict(sorted(DIAL_CODES))
print('d2:',d2.keys())
# 数据元组的顺序是按照国家名字的英文拼写来决定的
d3 = dict(sorted(DIAL_CODES,key =lambda x:x[1]))
print('d3:',d3.keys())
#这些字典是相等的,因为它们所包含的数据是一样的
assert (d1 == d2 and d2 == d3)
d1: dict_keys([86, 91, 1, 62, 55, 92, 880, 234, 7, 81])
d2: dict_keys([1, 7, 55, 62, 81, 86, 91, 92, 234, 880])
d3: dict_keys([880, 55, 86, 91, 62, 81, 234, 92, 7, 1])

set的实现以及导致的结果

set 和 frozenset 的实现也依赖散列表,但在它们的散列表里存放的只有元素的引用.

  • 集合里的元素必须是可散列的。
  • 集合很消耗内存。
  • 可以很高效地判断元素是否存在于某个集合。
  • 元素的次序取决于被添加到集合里的次序。
  • 往集合里添加元素,可能会改变集合里已有元素的次序。

分享关于人工智能,机器学习,深度学习以及计算机视觉的好文章,同时自己对于这个领域学习心得笔记。想要一起深入学习人工智能的小伙伴一起结伴学习吧!扫码上车!

瓦力人工智能 - 扫码上车

CTF竞赛Python自动化脚本编写指南:从环境搭建到实战案例 在网络安全和CTF竞赛领域,自动化脚本是提升解题效率的核心技术。其基本原理是将重复性、机械化的操作转化为程序指令,由计算机高效执行,从而让选手专注于核心的逻辑分析与策略思考。这项技术的核心价值在于解放人力,实现解题流程的标准化与复用,尤其在时间紧迫的竞赛环境中至关重要。从应用场景来看,自动化脚本广泛应用于Web渗透测试的参数爆破、逆向工程的交互式解题、密码学的编码解码以及杂项题目的数据分析等环节。本文聚焦于使用Python语言实现CTF自动化,通过requests库处理网络请求、pwntools进行交互控制 阅读详情

相关推荐

Python爬虫实战:7种策略绕过Cloudflare反爬虫检测

在Web数据采集领域,反爬虫机制是开发者必须面对的技术挑战。其核心原理是通过分析HTTP请求特征、客户端指纹和行为模式,区分自动化脚本与真实用户。从技术价值看,理解并应对这些机制不仅能提升数据采集的稳定性,也是学习现代Web安全防护的重要实践。常见的应用场景包括市场研究、舆情监控和合规数据聚合。针对Cloudflare这类广泛使用的安全服务,本文聚焦于请求头模拟、无头浏览器、代理轮换等实战技巧,帮助开发者构建更稳健的采集方案。

dielucuan8830的博客 465

Python集合set实战:数据去重、权限校验与高性能成员检测

集合(set)是Python中基于哈希表实现的无序唯一容器,其O(1)平均时间复杂度的成员检测能力,使其成为高频‘存在性判断’场景(如黑名单校验、权限比对、去重清洗)的首选数据结构。相比列表的O(n)线性查找,set通过哈希定位规避遍历开销,在电商风控、SaaS权限系统、日志分析等真实工程场景中可将响应延迟降低数十倍。它天然支持交并差等集合论运算,语义清晰且性能优越;但需严格满足元素可哈希性、唯一性与无序性约束。本文聚焦set在数据清洗与RBAC权限校验中的落地实践,涵盖初始化避坑、discard与remo

csdndownload11123的博客 451

Python全栈实战:从环境搭建到爬虫与数据分析项目贯通

Python作为一门通用编程语言,其核心价值在于将抽象的逻辑转化为可执行的自动化脚本。其工作原理基于解释器逐行执行代码,并通过丰富的第三方库生态扩展能力边界。在工程实践中,Python尤其擅长处理数据密集型任务,这使其成为数据科学和自动化领域的首选工具。网络爬虫技术基于HTTP协议,通过模拟浏览器请求获取网页数据,而数据分析则依赖于Pandas、NumPy等库对数据进行清洗、转换和可视化,从而提取有价值的信息。这两个技术模块的结合,构成了从数据获取到洞察的完整闭环,广泛应用于市场研究、舆情监控和业务决策支持

weixin_30430169的博客 460

Python笔记(五)——Dict(字典)和set(集合)

目录 字典集合的常见用法 一、字典(dict) 二、集合(set) 具体介绍: 一、Dict(字典) 1.1 字典的定义“{ }” 1.2 Python之访问dict 1.3 Python之遍历dict 1.4 Python添加字典元素 1.5 删除字典元素 1.6 Python中dict的特点 二、set(集合) 2.1 set的创建 2.2 Python之访问set...

qq_37764129的博客 1284

2026生产级AI Agent实战:Python+Bedrock+Strands全栈搭建

AI Agent已从概念演进为现代软件基础设施,其核心是具备自主推理循环、工具调用、状态记忆与人工干预能力的智能体。区别于传统脚本,Agent通过目标驱动而非步骤驱动实现自动化,技术价值在于提升系统可观察性、可审计性与业务闭环效率。典型应用场景覆盖政务热线、电商售后、金融风控与智能制造等需多系统协同的领域。本文聚焦真实工程落地,以Python为开发语言、Amazon Bedrock为模型底座、Strands Agents SDK为框架选型,详解环境隔离、工具强类型设计、钩子编排、上下文管理及Fargate生

cuyi7076的博客 458

PLC模拟量输入电路设计:±10V与±20mA信号调理全解析

在工业自动化和数据采集系统中,模拟量输入是连接物理世界与数字控制的核心桥梁。无论是变送器输出的4-20mA电流环,还是伺服驱动与信号发生器提供的±10V电压信号,PLC和采集模块都需要在复杂现场环境下稳定、精准地完成信号采集。理解信号体制的原理——电流环抗长线干扰、电压环响应快——是设计模拟输入前端的基础。通过精密电阻网络实现分压与采样,利用运放完成双极性到单极性的电平搬移,配合TVS与滤波电路保障可靠性,并经过ADC量化与校准流程,最终构建出兼顾精度、成本和工业级鲁棒性的完整信号链路。本文面向硬件工程师与

weixin_29163797的博客 302

创建一个1000w个随机浮点数的数组

一个浮点数组的创建,存入文件和读取文件。 1 from array import array #引入array类型 2 from random import random 3 4 floats = array('d',(random() for i in range(10**7))) #利用生成器表达式来建立一个双精度的浮点型数组(类型代码‘d’) 5 #print(fl...

weixin_30679823的博客 428

kaggle——信用卡欺诈检测项目实战

笔记第一步:了解题目,确定任务第二步:场景分析第三步:数据预处理看是否有缺失值查看样本类别分布数据不均衡解决办法数据值标准化/归一化第四步:特征工程1)查看特征分布情况,把不同类别下特征分布相差不大的特征删除掉2)特征缩放第五步:模型训练处理不平衡样本交叉验证求取最好的模型参数第六步:模型评估使用下采样数据训练与测试使用下采样数据训练与测试(不同的阈值对结果的影响)使用下采样数据训练,原始数据进行测试原始数据进行K折交叉验证使用原始数据进行训练和测试查看ROC曲线逻辑回归阈值选择过采样总结 第一步:了解题目

weixin_45942265的博客 1万+

python----字典的小秘密

定义 {key1:value1,key2:value2} 对应 {键:值,键:值} key不可变,必须唯一;value可修改,可以不唯一 python语言中通过字典类型实现映射 字典的功能 1、字典的创建 >>>a={"name":"kitty","age":18} #直接写出字典的形式 >>>a {'name': 'kitty', 'age': 18} >>>a=dict(name="kitty",age=18) #dict表示字典

Kittymiaomiao的博客 293

手把手教你用单结晶体管搭建简易振荡电路(含电路图和波形分析)

本文详细介绍了如何使用单结晶体管(UJT)搭建简易振荡电路,包括电路设计、波形分析和实战技巧。通过具体的电路图和参数计算,帮助电子爱好者和工程师快速掌握UJT振荡器的设计与调试方法,适用于脉冲信号生成和时钟源制作等应用场景。

weixin_29207533的博客 518

电机控制必看!SVPWM谐波优化:5段式与7段式全参数对比测试

本文通过实测数据,对比分析了电机控制中5段式与7段式SVPWM控制算法的谐波性能。实验表明,7段式SVPWM在电流波形质量(THD)和低速性能上更优,而5段式SVPWM则在开关损耗和效率方面表现突出。文章为工程师在不同应用场景(如对噪音、效率或动态响应的侧重)下的算法选型提供了清晰的依据和实用的工程指南。

weixin_28331555的博客 179

Python中字典(dict)和集合(set)区别与联系

集合(set) 与 字典(dict)的区别

L29979264458的博客 7017

【Mode】多模干涉仪的设计 Multi-mode interferometer(MMI)

与 Splitter 器件一样,MMI 器件也是一种常见的分光器件,可以根据用户的需求将光束分成不同的比例。本文,我们将介绍如何仿真 MMI 器件。这里我们使用的是 1x2 MMI,其本质上是由四个部分组成的,中间的矩形多模式干涉区域以及左右两侧的三个 taper 模式转换区域。之前的教程中我们也提及了,为了获取稳定的模式场分布,通常,我们需要进行模式收敛性扫描。这里以官网给出的案例为例。如何提取 S 参数我们先暂时不做介绍,后续有时间了我们再做介绍。

u011699626的博客 1220

Python中字典创建、遍历、添加

Python中字典创建、遍历、添加 字典是Python中唯一的键-值类型,是Python中非常重要的数据结构,因其用哈希的方式存储数据,其复杂度为O(1),速度非常快。下面列出字典的常用的用途. 一、字典中常见方法列表 #方法 #描述 -------------------------------------------------------...

weixin_42894309的博客 3335

YOLO26涨点改进 | 全网独家,注意力创新改进篇 | Arxiv2025 | YOLO26引入MSLA多尺度线性注意力模块,高效提取多尺度特征和建模长程依赖,含多种创新改进,助力有效涨点

本文提出了一种多尺度线性注意力模块(MSLA)来优化YOLO26模型。MSLA通过并行使用不同尺寸的深度可分离卷积(3×3至9×9)提取多尺度特征,并结合线性注意力机制高效建模全局依赖关系。该模块显著提升了模型对多尺度目标的检测能力,同时保持了轻量化特性。实验表明,MSLA能有效增强小目标检测和复杂场景下的分割精度。文章详细介绍了MSLA的网络结构、核心优势及实现代码,并提供了两种集成MSLA的YOLO26改进方案,为实时目标检测任务提供了高效解决方案。

Ai缝合怪、助力小伙伴高效发论文 312

基于C#通过PLCSIM ADV仿真软件实现与西门子1500PLC的S7通信方法演示

基于C#通过PLCSIM ADV仿真软件实现与西门子1500PLC的S7通信方法演示

Robot_PLC_HMI_Automation 3164

支持字典_Python进阶11_字典dict和集合set的秘密

本节你将看到关于字典dict和集合set更加深入的原理,尤其是关于散列在其中的作用,将回答以下问题:Python 里的 dict 和 set 的效率有多高?为什么它们是无序的?为什么并不是所有的 Python 对象都可以当作 dict 的键或 set 里的元素?为什么 dict 的键和 set 元素的顺序是跟据它们被添加的次序而定的,为什么不应该在迭代循环 dict 或是 set 的同时往里添加元...

weixin_39853523的博客 117

13、超声断层乳腺图像融合算法:乳腺癌诊断新突破

本文介绍了一种新型超声断层乳腺图像融合算法,通过结合超声透射(UTTc、UTTα)和反射断层图像(URT),实现对乳腺组织的多参数自动可视化。该算法能有效区分良性与恶性肿瘤,具有高准确性、无辐射、低成本等优势,适用于大规模乳腺癌早期筛查。初步临床测试验证了其可行性,未来有望成为乳腺癌诊断的新标准。

9q8w7e6r5的博客 156

python集合set底层原理_Python进阶11_字典dict和集合set的秘密

本节你将看到关于字典dict和集合set更加深入的原理,尤其是关于散列在其中的作用,将回答以下问题:Python 里的 dict 和 set 的效率有多高?为什么它们是无序的?为什么并不是所有的 Python 对象都可以当作 dict 的键或 set 里的元素?为什么 dict 的键和 set 元素的顺序是跟据它们被添加的次序而定的,为什么不应该在迭代循环 dict 或是 set 的同时往里添加元...

weixin_39737492的博客 257

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

Python五大核心数据容器详解:从设计哲学到实战性能调优

在编程中,数据结构是组织和存储数据的核心基础,其设计直接影响程序的性能和可维护性。Python作为一门高级语言,内置了列表、元组、字符串、集合和字典五大核心数据容器,它们分别基于不同的底层原理实现,如动态数组和哈希表,以平衡数据的可变性、访问效率和内存使用。理解这些容器的可变性与不可变性、存储机制和性能差异,对于编写高效、优雅的代码至关重要。例如,列表适用于需要频繁修改的顺序数据,而字典凭借其哈希表实现,在键值查找上具有O(1)的平均时间复杂度,非常适合快速映射场景。在实际工程中,这些容器广泛应用于数据清洗

weixin_34062469的博客 347

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

从零构建AI助手工作流:OpenClaw实战指南与自动化效率提升

自动化工作流是现代软件工程中提升效率的核心技术,通过将重复性任务自动化,开发者可以专注于更高价值的创造性工作。其原理在于通过事件触发、任务编排和系统集成,实现跨平台、跨应用的协同操作。在技术价值上,自动化不仅能减少人为错误、提升执行速度,还能实现7x24小时不间断运行。常见的应用场景包括CI/CD流水线、数据同步、监控告警等。本文以开源AI助手OpenClaw为例,深入探讨如何利用其模块化设计构建个性化自动化方案,特别是通过技能链(Skill Chaining)和工作流编排,将多个独立功能组合成智能助理,实

weixin_33739541的博客 435

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Bulbs类型系统TypeSystem深度揭秘:Python与图数据库数据类型无缝转换的秘密

Bulbs 是一个面向 **Neo4j、Rexster、Titan** 等图数据库的 **Python 持久化框架**,它的核心能力之一是 **TypeSystem(类型系统)**:当你在 Python 代码里操作 `Person`、`Age` 这些对象时,TypeSystem 负责把 **Python 数据类型**与**图数据库存储格式**之间做**无缝转换**,让开发者完全不需要关心底层 JS

gitblog_00542的博客 669

Python进阶实战:从类型系统到并发编程的专家技巧

Python作为动态类型语言,其类型系统通过Type Hints实现了静态类型检查的能力,配合mypy工具能在编译期捕获类型错误。在并发编程领域,asyncio的事件循环机制通过协程实现高并发IO操作,但需要注意任务调度策略以避免性能下降。这些技术在企业级应用中能显著提升代码健壮性和执行效率,特别是在微服务架构和数据处理流水线等场景。本文通过类型注解配置、asyncio批处理模式等实战案例,演示如何规避多线程数据竞争等典型问题,其中类型注解可使维护成本降低50%以上,而正确的asyncio任务分批策略能提升

weixin_34375251的博客 301

Python零基础入门实战:从环境搭建到爬虫与数据分析项目整合

Python作为一门简洁高效的编程语言,其核心价值在于将复杂逻辑转化为可执行的代码,广泛应用于自动化、数据处理和人工智能等领域。其工作原理基于解释器逐行执行,结合丰富的第三方库生态,能够快速构建解决实际问题的应用。在技术实践中,掌握Python意味着获得了数据获取、处理与分析的关键能力。网络爬虫技术通过模拟浏览器请求,能够从互联网上自动化地收集公开数据,为后续分析提供原材料。而数据分析则依赖于Pandas等库对数据进行清洗、转换和探索,以发现规律并支持决策。这两个技术场景的结合,构成了从数据采集到价值提取的

weixin_34216107的博客 499

Python列表18个高频问题:从原理到生产避坑指南

Python列表作为最基础的可变序列类型,其底层是动态数组,具备O(1)随机访问但O(n)插入删除的典型特征;理解其内存连续性、引用共享机制与浅拷贝语义,是避免线上事故的关键。列表推导式因绕过解释器开销而比for循环快3倍,而`list(dict.fromkeys())`已成为保持顺序去重的事实标准。在日志解析、风控过滤、爬虫去重等真实场景中,错误使用`in`查找、循环中`remove()`、`list(set())`等操作极易引发数据错乱或性能雪崩。掌握深浅拷贝差异、`enumerate`替代`range

weixin_33981932的博客 384

Python饼图实战:用Pandas+Matplotlib打造专业级数据可视化

饼图作为基础构成型图表,核心价值在于直观呈现互斥且穷尽的分类占比关系。其原理依赖于角度与面积的严格比例映射,避免3D变形、透视失真等视觉误导。技术价值体现在可控性、可复用性与跨平台稳定性——相比Plotly交互依赖或Seaborn支持薄弱,Pandas的value_counts()提供健壮的数据聚合能力,Matplotlib的plt.pie()则赋予像素级样式掌控力,完美适配PPT汇报、PDF报告及内网系统嵌入等工程场景。本文聚焦Python Pie Chart与Pandas协同实践,覆盖数据清洗、百分比精

weixin_33711647的博客 284
上一篇: 深度学习笔记11_机器学习工作流程
下一篇: 深度学习笔记12_卷积神经网络
瓦力人工智能
博客等级 码龄16年 137粉丝 68原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值