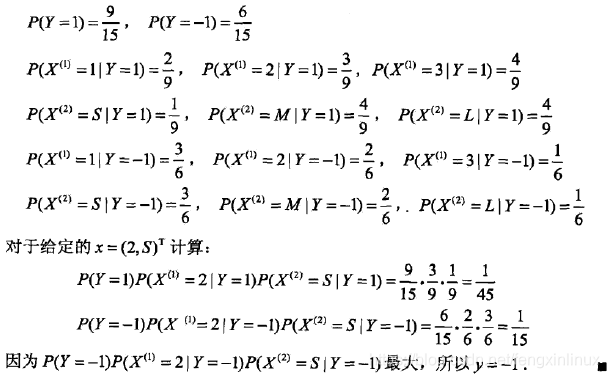机器学习-朴素贝叶斯

因果推断(二):3个基本假设 因果推断的三个假设:稳定单位处理假设、正值假设、条件独立假设 阅读详情

朴素贝叶斯介绍

朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法。之所以叫朴素,是因为朴素贝叶斯法对条件概率分布作了条件独立性的假设。朴素贝叶斯法是典型的生成学习方法。生成方法由训练数据学习联合概率分布P(X,Y),然后求得后验概率分布P(X|Y)。

具体来说,利用训练数据学习P(X|Y)和P(Y)的估计,得到联合概率分布:

P(X,Y)=P(X)P(X|Y)

概率估计方法可以是极大极大似然估计或贝叶斯估计。


基本原理

设输入空间X⊆RnX\subseteq R ^{n}X⊆Rn为n维向量的集合,输出空间为类标记集合Y={c1,c2,…,ck}Y=\left\{ c_{1},c_{2},\ldots ,c_{k}\right\}Y={c1​,c2​,…,ck​},输入特征向量x∈X,输出类标记为 y∈Y,P(X,Y)是X和Y的联合概率分布。
训练数据集为T={(x1,y1),(x2,y2),…,(xn,yn)}T=\left\{ \left( x_{1},y_{1}\right) ,\left( x_{2},y_{2}\right) ,\ldots ,\left( x_{n},y_{n}\right) \right\}T={(x1​,y1​),(x2​,y2​),…,(xn​,yn​)}由P(X,Y)独立同分布产生。
朴素贝叶斯法就是通过训练集来学习联合概率分布P(X,Y),和先验概率分布P(X),进而可以算出最大后验概率。

条件概率分布P(X=x|Y=ckc_kck​)有指数级数量的参数,其估计实际不可能行的。所以,朴素贝叶斯对条件概率分布作了条件独立性的假设。
条件独立性假设是:
P(X=x∣Y=ck)=P(X(1)=x(1),…,X(n)=x(n)∣Y=ck)=∏j=1np(X(j)=x(j)∣Y=ck)\begin{aligned}P(X=x|Y=c_k)=P(X^{\left( 1\right) }=x^{\left( 1\right) },\ldots ,X^{\left( n\right) }=x^{\left( n\right) }|Y=c_k) \\ =\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right) \end{aligned}P(X=x∣Y=ck​)=P(X(1)=x(1),…,X(n)=x(n)∣Y=ck​)=j=1∏n​p(X(j)=x(j)∣Y=ck​)​
条件独立假设等于是说用于分类的特征在类确定的条件下都是条件独立的。这一假设使朴素贝叶斯法变得简单,但有时会牺牲一定的分类准确率。

朴素贝叶斯法分类时,对给定的输入x,通过学习到的模型计算后验概率分布P(Y=ck∣X=x)P(Y=c_k|X=x)P(Y=ck​∣X=x),将后验概率最大的类作为x的类输出。
后验概率计算根据贝叶斯定理算出:
P(Y=ck∣X=x)=P(X=x∣Y=ck)P(Y=ck)∑kP(X=x∣Y=ck)P(Y=ck)P(Y=c_k|X=x)=\dfrac {P(X= x| Y= c_{k}) P( Y= c_{k})}{\sum _{k}P(X= x| Y= c_{k})P(Y= c_{k})}P(Y=ck​∣X=x)=∑k​P(X=x∣Y=ck​)P(Y=ck​)P(X=x∣Y=ck​)P(Y=ck​)​
将条件独立假设代入,可得:
P(Y=ck∣X=x)=P(Y=ck)∏j=1np(X(j)=x(j)∣Y=ck)∑kP(Y=ck)∏j=1np(X(j)=x(j)∣Y=ck),k=1,2,⋅⋅⋅,KP(Y=c_k|X=x)=\dfrac {P( Y= c_{k})\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right) } {\sum _{k}P( Y= c_{k})\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right) },k=1,2,···,KP(Y=ck​∣X=x)=∑k​P(Y=ck​)∏j=1n​p(X(j)=x(j)∣Y=ck​)P(Y=ck​)∏j=1n​p(X(j)=x(j)∣Y=ck​)​,k=1,2,⋅⋅⋅,K

于是,朴素贝叶斯分类器可以表示为:
y=f(x)=arg⁡max⁡ckP(Y=ck)∏j=1np(X(j)=x(j)∣Y=ck)∑kP(Y=ck)∏j=1np(X(j)=x(j)∣Y=ck)y=f(x)=\arg \max _{c_k}\dfrac {P( Y= c_{k})\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right) } {\sum _{k}P( Y= c_{k})\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right) }y=f(x)=argmaxck​​∑k​P(Y=ck​)∏j=1n​p(X(j)=x(j)∣Y=ck​)P(Y=ck​)∏j=1n​p(X(j)=x(j)∣Y=ck​)​
因为分母对所有ckc_kck​都是相同的,所以可以将分母省略,最终得到:
y=f(x)=arg⁡max⁡ckP(Y=ck)∏j=1np(X(j)=x(j)∣Y=ck)y=f(x)=\arg \max _{c_k}P( Y= c_{k})\prod ^{n}_{j=1}p\left( X^{\left( j\right) }=x^{\left( j\right) }|Y=c_k\right)y=f(x)=argmaxck​​P(Y=ck​)∏j=1n​p(X(j)=x(j)∣Y=ck​)


朴素贝叶斯法的参数估计

在朴素贝叶斯法中,我们需要先知道P(Y=ck)P(Y=c_k)P(Y=ck​)和P(X(j)=x(j)∣Y=ck)P(X^{\left( j\right) }=x^{\left( j\right) }|Y={c_k})P(X(j)=x(j)∣Y=ck​)
就这意味着我们需要通过学习估计出P(Y=ck)P(Y=c_k)P(Y=ck​)和P(X(j)=x(j)∣Y=ck)P(X^{\left( j\right) }=x^{\left( j\right) }|Y={c_k})P(X(j)=x(j)∣Y=ck​)
我们可以通过极大似然估计和贝叶斯估计,估计出参数

极大似然估计

先验概率P(Y=ck)P(Y=c_k)P(Y=ck​)的极大似然估计:
P(Y=ck)=∑i=1NI(yi=ck)N,k=1,2,...,KP(Y=c_k)=\dfrac {\sum ^{N}_{i=1}I(y_i=c_k)} {N},k=1,2,...,KP(Y=ck​)=N∑i=1N​I(yi​=ck​)​,k=1,2,...,K

设第j个特征x(j)x^{(j)}x(j)可能取值的集合为{aj1,aj2,…,ajSj}\left\{a_{j1},a_{j2},…,a_{jS_{j}}\right\}{aj1​,aj2​,…,ajSj​​},条件概率P(X(j)=ajl∣Y=ck)P(X^{(j)}=a_{jl}|Y=c_k)P(X(j)=ajl​∣Y=ck​)的极大似然估计是:
P(X(j)=ajl∣Y=ck)=∑i=1NI(xi(j)=ajl,yi=ck)∑i=1NI(yi=ck)P(X^{(j)}=a_{jl}|Y=c_k)=\dfrac {\sum ^{N}_{i=1}I(x^{\left( j\right) }_{i}=a_{jl},y_i=c_k)} {\sum ^{N}_{i=1}I(y_i=c_k)}P(X(j)=ajl​∣Y=ck​)=∑i=1N​I(yi​=ck​)∑i=1N​I(xi(j)​=ajl​,yi​=ck​)​
其中,j=1,2,…,n;l=1,2,…,Sj;k=1,2,…,Kj=1,2,…,n; l=1,2,…,S_j; k=1,2,…,Kj=1,2,…,n;l=1,2,…,Sj​;k=1,2,…,K
xi(j)x^{\left( j\right) }_{i}xi(j)​是第i个样本的第j个特征,ajla_{jl}ajl​是第j个特征可能取的第lll个值,III为指示函数。

贝叶斯估计

用极大似然估计可能会出现所要估计的概率值为0的情况。这会影响到后验概率的计算结果,使分类产生偏差。解决这一问题的方法是采用贝叶斯估计。

条件概率的贝叶斯是:
Pλ(X(j)=ajl∣Y=ck)=∑i=1NI(xi(j)=ajl,yi=ck)+λ∑i=1NI(yi=ck)+SjλP_λ(X^{(j)}=a_{jl}|Y=c_k)=\dfrac {\sum ^{N}_{i=1}I(x^{\left( j\right) }_{i}=a_{jl},y_i=c_k)+λ} {\sum ^{N}_{i=1}I(y_i=c_k)+S_jλ}Pλ​(X(j)=ajl​∣Y=ck​)=∑i=1N​I(yi​=ck​)+Sj​λ∑i=1N​I(xi(j)​=ajl​,yi​=ck​)+λ​
其中λ≥0.

等价于在随机变量各个取值的频数上赋予一个正数λ>0.当λ=0时就是极大似然估计.
常取λ=1,这时称为拉普拉斯平滑。
显然,对于任何的l和kl和kl和k,都有:
Pλ(X(j)=ajl∣Y=ck)>0P_λ(X^{(j)}=a_{jl}|Y=c_k)>0Pλ​(X(j)=ajl​∣Y=ck​)>0
∑l=1SjP(X(j)=ajl∣Y=ck)=1\sum ^{S_j}_{l=1}P(X^{(j)}=a_{jl}|Y=c_k)=1∑l=1Sj​​P(X(j)=ajl​∣Y=ck​)=1

先验概率的贝叶斯估计为:
Pλ(Y=ck)=∑i=1NI(yi=ck)+λN+KλP_λ(Y=c_k)=\dfrac {\sum ^{N}_{i=1}I(y_i=c_k)+λ} {N+Kλ}Pλ​(Y=ck​)=N+Kλ∑i=1N​I(yi​=ck​)+λ​


例子

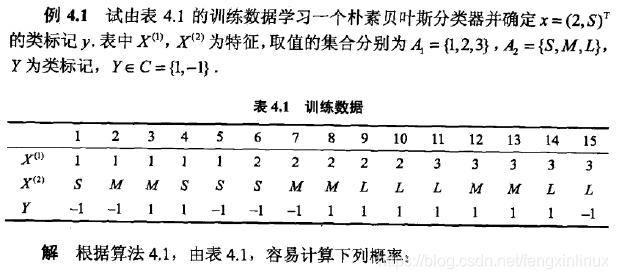
下面的是《统计学习方法》中的例题:
在这里插入图片描述
在这里插入图片描述

机器学习:朴素贝叶斯 概率表示随机事件发生可能性大小的一个数值,随机事件指在相同条件下,可能出现也可能不出现的事件。抛硬币: 当我们抛硬币时,可以正面朝上也可以反面朝上,正面或反面朝上的可能性被称为概率。理想状态下正反概率都是0.5。掷骰子: 掷一个六面的骰子,每个点出现的概率是1/6,因为每个面出现的机会是均等的。抽取商品: 一批商品包含良品和次品,随机抽取一件,抽取良品或次品是一个随机事件,经过大量实验,我们可以得到一个常数,表示抽取次品的概率。 阅读详情

相关推荐

机器学习笔记——朴素贝叶斯算法

本笔记介绍机器学习中朴素贝叶斯算法。

haopinglianlian的博客 1511

带你理解朴素贝叶斯分类算法

文章目录分类问题综述朴素贝叶斯分类例题分析朴素贝叶斯算法的朴素一词解释朴素贝叶斯分类的优缺点 转载来源:https://zhuanlan.zhihu.com/p/26262151 贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。而朴素朴素贝叶斯分类是贝叶斯分类中最简单,也是常见的一种分类方法。这篇文章我尽可能用直白的话语总结一下我们学习会上讲到的朴素贝叶斯分类算法,希望有利于他人理解。 分类问题综述 对于分类问题,其实谁都不会陌生,日常生活中我们每天都进行着分类过程。例如

郝伟老师的博客——大数据、并行计算与人工智能时代 1149

智能座舱-语音交互系统

从什么是智能座舱、智能座舱的发展驱动因素、智能座舱的构成要素三个方面梳理我对智能座舱的基础认识之后,为了加深“智能座舱产品入门”课程中语音交互部分知识的理解,我从什么是语音交互、语音交互的底层技术、智能座舱的语音交互等方面,对智能座舱语音交互系统相关的知识进行了梳理与总结。

GUOSA0928的博客 1440

机器学习贝叶斯分类器

6.1.1 背景知识 贝叶斯方法分析的特点是用概率表示不确定性。 贝叶斯决策论是在概率框架下试试决策的基本方法。 在分类问题情况下,在所有相关概率都已知的理想情形下,贝叶斯决策考虑如何基于这些概率和误判损失来选择最优的类别标记。 概率基本概念: 先验概率(P(Y)):即根据往年经验及其他因素预测的事件的概率。 后验概率(P(Y|X)):即在先验概率的情况下根据其他因素推测的概率。 联合概率:表示两个事件共同发生的概率。 6.1.2 贝叶斯决策论 贝叶斯定理: 估计后验概率P(c|x)主要困难:类条件概率P

DHYYYYYY的博客 1180

为Codex添加任务完成提示音:提升开发效率的实用技巧

在自动化脚本开发和模型训练过程中,实时获取任务状态反馈是提升工作效率的关键。通过Hook机制,开发者可以在代码执行的关键节点注入自定义逻辑,实现各种自动化操作。Codex的Hook系统特别适合用于任务完成提醒,其post_execution节点能准确捕获执行结束事件。技术实现上,只需简单配置TOML文件并编写音频播放脚本,就能让系统在任务完成时自动播放提示音。这种声音反馈机制尤其适用于长时间运行的批量任务和模型训练场景,实测可提升30%以上的工作效率。结合动态音效选择和跨平台兼容方案,该技巧还能扩展为桌面通

weixin_26767391的博客 533

10xGenomics官方可视化工具——Loupe Browser

Loupe Browser是⼀款10xGenomics开发的交互式桌⾯应⽤程序,⽤于探索10x单细胞数据,可以用来找出感兴趣的细胞、找出显著差异表达的基因、鉴定细胞类型、探索细胞亚类和数据共享。

weixin_47195452的博客 3352

贝叶斯定理与条件独立假设:朴素贝叶斯分类方法深度解读

今天给大家分享的是朴素贝叶斯算法,这个算法在实际使用中不是很多,因为现在很多算法已经发展的很好,性能上也比朴素贝叶斯算法的好很多,因此在实际中我们其实看到在实际应用中朴素贝叶斯算法的使用已经比较少,即使出现,最终的效果也是不及其他算法的,但是作为简单、基础的算法之一,我们掌握该算法的原理还是非常有必要的,同时在实际论文研究中也经常会使用贝叶斯算法的改进版,所以大家可以多了解了解。大家也可以根据贝叶斯定理的前验分布和条件概率分布求出某个数据特征的后验概率,从而可以得出数据的类别,大家可以指定。

weixin_50249953的博客 2078

科研绘图系列:R语言circos图(circos plot)

科研绘图系列:R语言circos图(circos plot)

专注生信领域 3430

如何理解朴素贝叶斯法中的“特征条件独立”

文章目录介绍参考文献 介绍 朴素贝叶斯法对条件概率分布做了条件独立性假设。那么什么叫条件独立性假设呢?它是说 用于分类的特征 在类确定的条件下 都是 条件独立 的。 我们不能将条件独立性假设和独立性假设划为等号。 以下面的一个简单的贝叶斯网为例,c 是标签,a、b 是特征。 我们知道: p(a,b,c)=p(c)p(a∣c)p(b∣c)p(a,b,c)=p(c)p(a|c)p(b|c)p(a,b,c)=p(c)p(a∣c)p(b∣c) 当 c 给定的时候,可得: p(a,b∣c)=p(a,b,c)p(c)

MD 6360

如何为 Claude Code 配置代理与网络环境

那么大概率不是软件问题,而是。因为 Claude Code 是运行在终端里的,不是浏览器。

sg_knight的专栏 3479

【华为OD技术面】 - 考到的Lettcode手撕算法代码真题目录

【华为OD技术面 - 考到的Lettcode手撕算法代码真题目录

算法大师! 7810

机器学习之朴素贝叶斯

在机器学习领域,朴素贝叶斯算法以其简单高效、易于实现的特点占据着重要地位。无论是文本分类、垃圾邮件过滤还是情感分析,朴素贝叶斯都展现出了强大的实用价值。本文将带您深入了解朴素贝叶斯算法的核心原理、常见模型、实现过程以及实际应用场景。

2302_76756558的博客 1359

汽车IVI中控开发入门及进阶(九):显示屏

显示屏Display panel和触控屏Touch panel,可以说随着汽车四化的进展,屏越来越多,越来越大,越来越高清,成为IVI中控、智能座舱系统的重要组成部分。比如如下一个电阻触摸屏。正文:显示屏主要功能就是显示,车载内容和信息的传递全靠显示屏,目前车载显示屏的种类可以分为:LCD液晶显示屏(TFT(薄膜晶体管)驱动的有源矩阵液晶显示,再细分IPS、TFT、SLCD,这几个子类)、LED显示屏(用 LED发光二极管作为背光光源)、OLED 显示屏。

码农17年的博客 2526

机器学习——朴素贝叶斯

贝叶斯定理是关于随机事件 A 在 B 条件下发生的概率:在贝叶斯定理中,每个名词都有约定俗成的名称:P(A|B)是已知 B 发生后 A 的条件概率P(A)是 A 的先验概率P(B|A)是已知 A 发生后 B 的条件概率2.贝叶斯的推导我们可以从条件概率的定义推导出贝叶斯定理。根据条件概率的定义,在事件 B 发生的条件下事件 A 发生的概率为同样地,在事件 A 发生的条件下事件 B 发生的概率为:结合这两个方程式,我们可以得到这个引理有时称作概率乘法规则。

qq_53142796的博客 1120

【我的Android进阶之旅】Android自定义View实现一个游戏摇杆,来实现监听遥动的方向或者监听摇动的角度的功能

一、需求描述 去年有个需求,需要使用自定义View实现一个游戏摇杆,来识别上下左右摇动的方向。 有点类似下面这样的王者荣耀游戏摇杆的效果 二、业界已有的参考资料 在下面这篇博客介绍了如何自定义游戏摇杆 2.1 博客介绍 Android自定义摇杆 2.1.1 功能 支持自适应大小 支持2个方向、4个方向、8个方向的摇动监听 支持摇动角度获取 可选回调模式 支持可摇动区域自定义 支持摇杆自定义 支持设置图片、色值、Shape图形 2.1.2 效果图 2.1.3 设置回调方式 setCallBac

字节卷动 1409

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

机器学习之朴素贝叶斯原理

机器学习之朴素贝叶斯原理

SKIp121whats112的博客 2345

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

ML机器学习算法(二): 朴素贝叶斯(Naive Bayes)

机器学习算法机器学习算法(二): 朴素贝叶斯(Naive Bayes)1.1朴素贝叶斯的介绍1.2朴素贝叶斯的应用 机器学习算法(二): 朴素贝叶斯(Naive Bayes) 1.1朴素贝叶斯的介绍 朴素贝叶斯算法(Naive Bayes, NB) 是应用最为广泛的分类算法之一。它是基于贝叶斯定义和特征条件独立假设的分类器方法。由于朴素贝叶斯法基于贝叶斯公式计算得到,有着坚实的数学基础,以及稳定的分类效率。NB模型所需估计的参数很少,对缺失数据不太敏感,算法也比较简单。当年的垃圾邮件分类都是基于朴素贝叶斯分

weixin_42182413的博客 180

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

朴素贝叶斯Naive Bayes-机器学习ML

参考: 1.《统计学习方法》李航 2.先验概率与后验概率的区别:http://blog.youkuaiyun.com/ouyang_linux007/article/details/7566339 3.朴素贝叶斯方法(Naive Bayes)原理和实现:http://blog.youkuaiyun.com/tanhongguang1/article/details/45016421#拉普拉斯平滑

Twinkle 1724

【机器学习】朴素贝叶斯

它被称为“朴素”,是因为它假设特征之间是相互独立的,这意味着给定分类的条件下,每个特征发生的概率都是独立的。当训练集中某特征值未在某个类别中出现时,P(Xi∣Y)=0P(Xi​∣Y)=0,导致整个后验概率为0。原始估计:P("viagra"∣正常)=0/100=0P("viagra"∣正常)=0/100=0。P(X∣Y):类条件概率(类别 Y 下特征 X 出现的概率)P(Y∣X):后验概率(给定特征 X 时类别 Y 的概率)P(X):边际概率(特征 X 的边缘概率):避免零概率,保持概率总和为1。

2501_90800687的博客 947

机器学习下的朴素贝叶斯

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 例如:第一章 Python 机器学习入门之pandas的使用 提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录系列文章目录前言一、pandas是什么?二、朴素贝叶斯1.高斯朴素贝叶斯2.伯努利朴素贝叶斯3.多项式朴素贝叶斯总结 前言 提示:这里可以添加本文要记录的大概内容: 例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。

YJ语 427

ml.js分类算法实战:KNN、朴素贝叶斯、SVM三大核心方法详解

欢迎来到机器学习在JavaScript中的终极指南!今天我们将深入探讨ml.js这个强大的JavaScript机器学习库,特别聚焦于三大核心分类算法:KNN、朴素贝叶斯和SVM。无论你是前端开发者想要在浏览器中实现机器学习,还是Node.js开发者寻求轻量级解决方案,ml.js都提供了完整的工具链。通过本文的实战教程,你将掌握如何使用这些算法解决实际的分类问题。 ## 为什么选择ml.js进行机

gitblog_00234的博客 481

spark中ml机器学习库的朴素贝叶斯模型实现中文文本信息的文类预测

数据预处理原始数据如图所示,我们要提取用户的输入文本信息,即“日本件如何收费” 首先过滤掉其他不含用户输入的文本行 然后以特定字符“含中文”为切割 提取文本信息中文分词采用ansj中文分词工具,对预处理后的数据进行分词建立训练语料自定义五个类别及其标签:0 运费、1 寄件、2 人工、3 改单、4 催单、5 其他业务类。 从原数据中挑选一部分作为训练语料和测试语料 建立模型测试并保存impo

皮皮虾的博客 1416

机器学习sklearn-朴素贝叶斯

目录 概述 sklearn中的朴素贝叶斯 高斯朴素贝叶斯 概述 算法得出的结论,永远不是100%确定的,更多的是判断出了一种“样本的标签更可能是某类的可能 性”,而非一种“确定”。 我们通过某些规定,比如说,在决策树的叶子节点上占比较多的标签,就是叶子节点上所有 样本的标签,来强行让算法为我们返回一个固定结果。但许多时候,我们也希望能够理解算法判断出的可能性本身。 每种算法使用不同的指标来衡量这种可能性。比如说,决策树使用的就是叶子节点上占比较多的标签所占的比例(接口pr.

kongqing23的博客 2901

【机器学习】朴素贝叶斯详解

朴素贝叶斯分类alpha:拉普拉斯平滑系数。

2201_75415080的博客 1238
上一篇: 统计学习方法——K近邻模型
下一篇: ES6 Promise用法总结
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值