组装一台intel n95纯Linux Server服务器

voyo vmac minipc 安装 ubuntu16.04 手记 voyo vmac minipc  安装 ubuntu16.04 手记树莓派用了4年多,新的版本3B+号称千兆网,其实只有300M,没有更新的动力,遂入了 voyo vmac minipcN3450 功耗6W,4核心,适合长期运行,4G内存,128GSSD  + 机械硬盘,千兆网,usb3.0 x3 ,都很全唯一比不上树莓派的就是噪音大了点,树莓派根本没有声音...1. 制作启动U盘使用Rufus... 阅读详情

前言

笔者自己的电脑是macmini m4,平时都是使用虚拟机来充当Linux服务器(系统Ubuntu Server),但是毕竟是ARM CPU,而且黄金内存,开不了几个虚拟机(加内存不划算),所以组装了intel n95的小主机(便宜),自己可以加内存,但是这类CPU内存为单通道,pcie分配不合理,有点不如n5xxx系列(这个又不支持avx指令集,支持双通道和pcie 3.0x4 ssd),也可以使用intel 12代酷睿(比较贵),最近龙虾🦞比较火,刚好可以跑🦞,就算出问题了,也就这个小主机有问题。

心得感悟

安装win10

笔者先安装win10,先跑个分

intel n95主板的BIOS建议先开启CPU C-states,否则单核睿频不正常,关闭CSM和secure boot,调整boot的启动顺序,当然也可以设置pl1和pl2,内存频率等(意义不大)

测试在15w默认pl1下,win10运行流畅(ssd加持),跑分达到intel 8100T的水平,当个电视盒子没问题,hdmi2.0原生接口
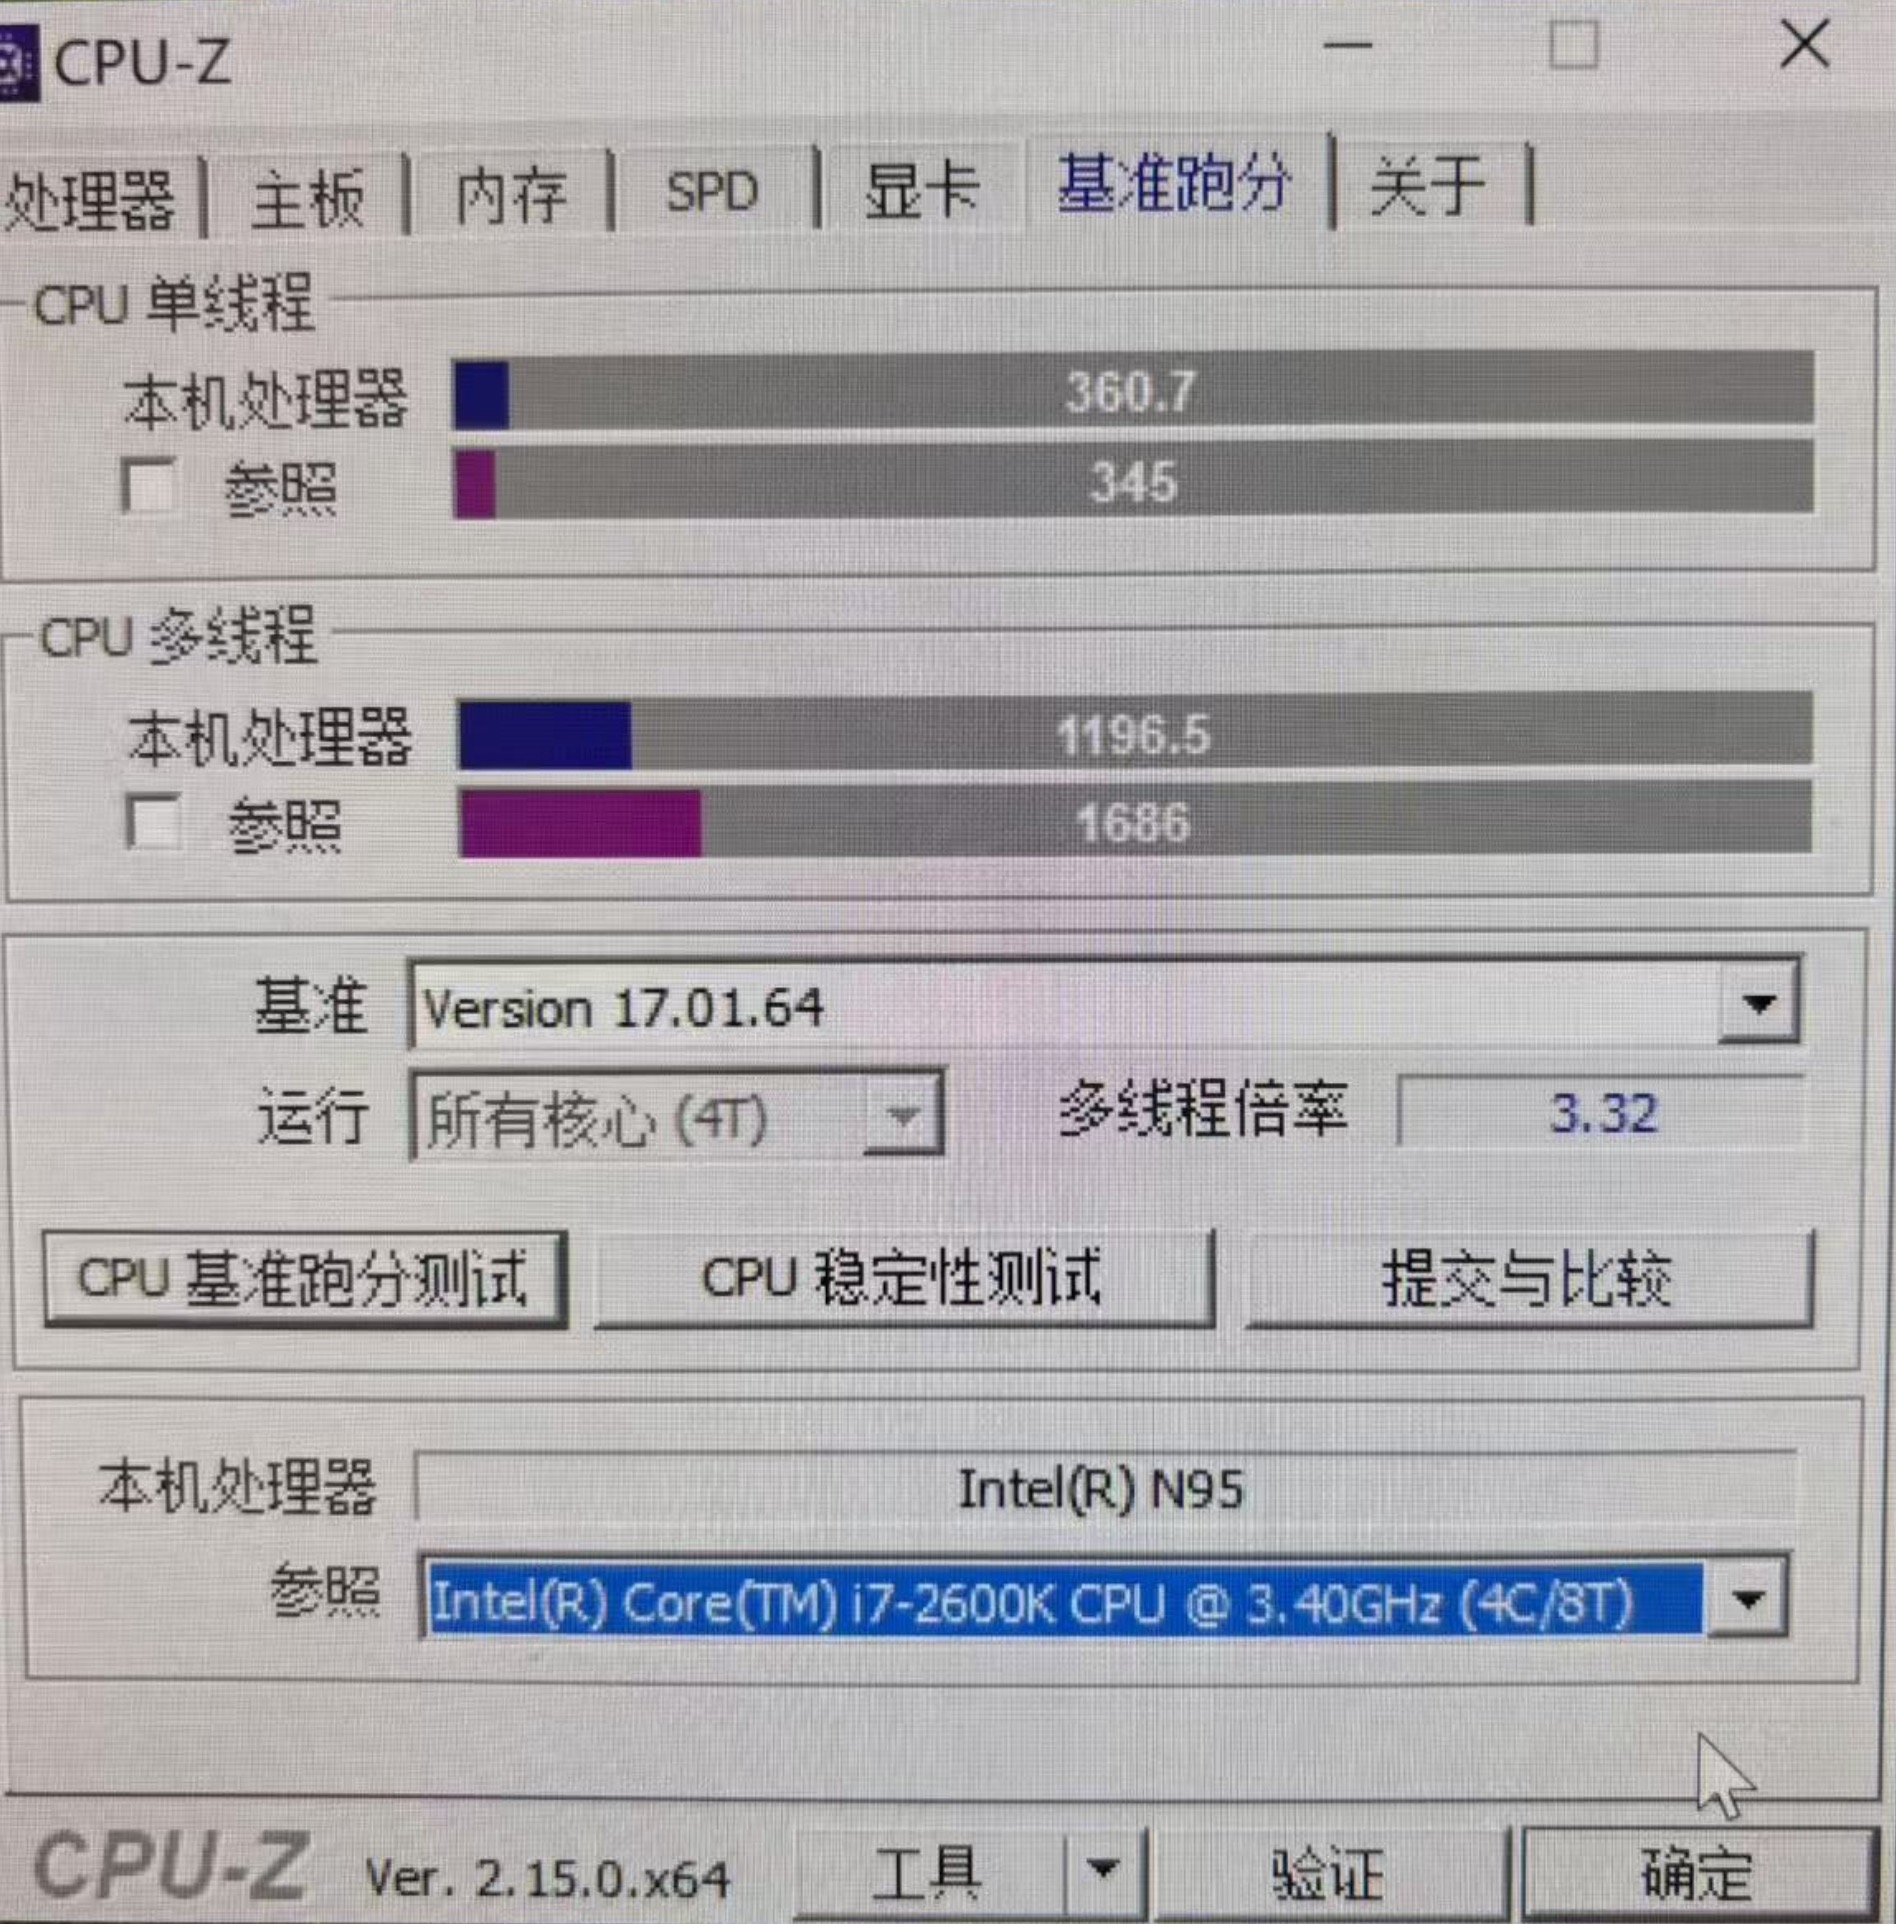
这类12代小核cpu,支持avx指令集,性能得到大幅度提升。前提是功耗给够,至少15w。

UbuntuServer

下载Ubuntu Server,烧录u盘,然后安装系统,注意Ubuntu Server22.04lts最小化安装默认是没有文本编辑命令的,vi都没有,建议不要最小化安装,或者插网线,笔者的无线网卡安装没法配置

安装时,建议选上open ssh Server,方便远程

无线网卡如果是intel ax200这类型的(内核自带驱动),可以在安装的时候连上,也可以安装好后,手动配置
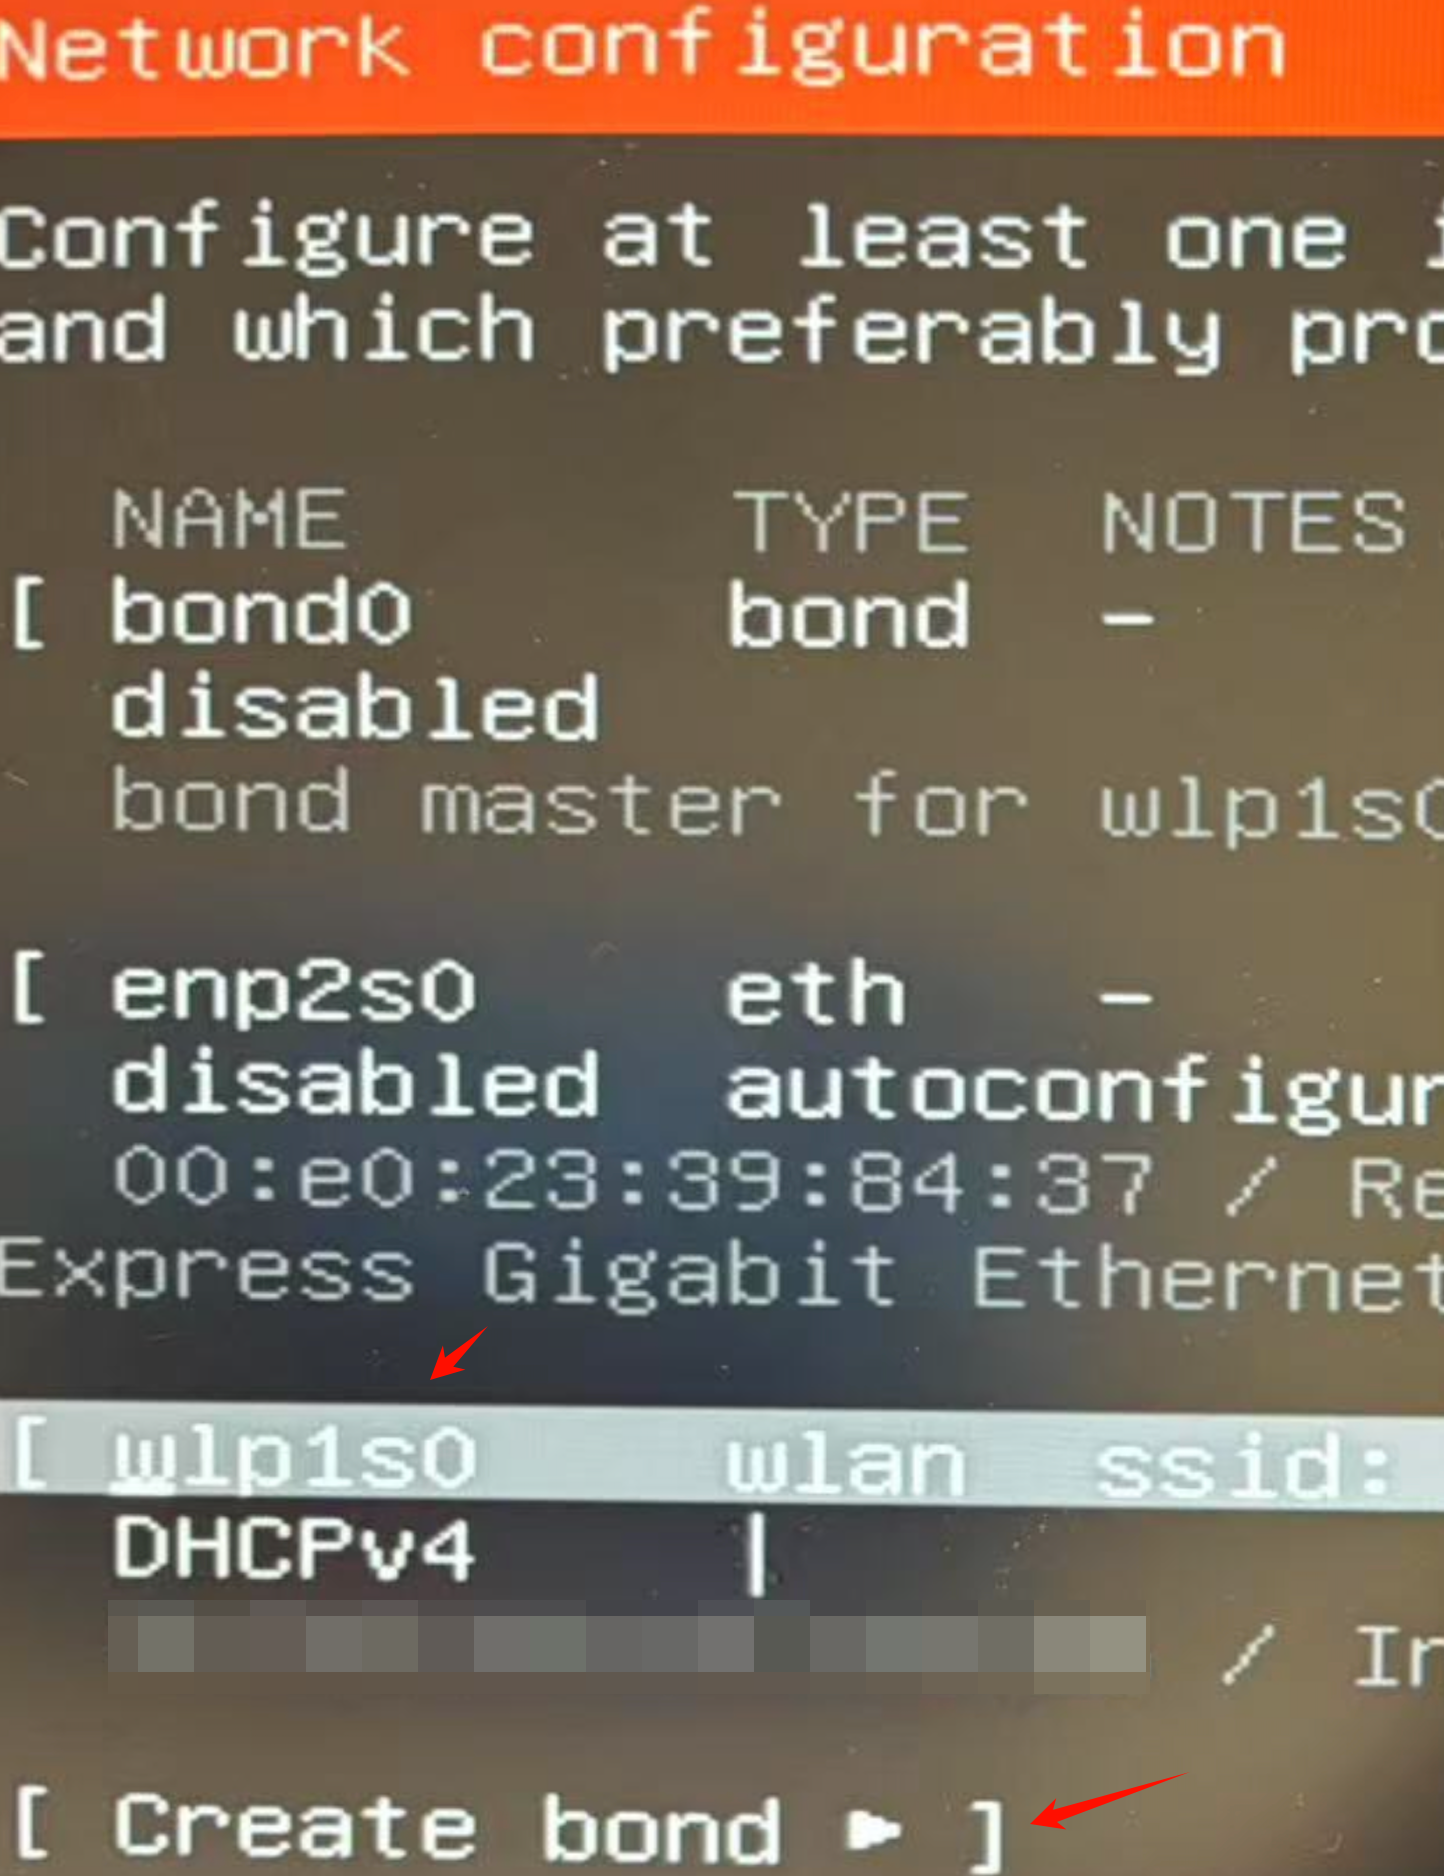
手动配置

使用ip a查看无线网卡在服务器的设备定义,默认自带,ifconfig需要安装net-tools

然后配置,笔者在上面配置了,然后进系统删掉配置,重新实测可以无线上网,笔者的WiFi设备id是wlp1s0

也可以ls /sys/class/net

然后在/etc/netplan下编辑50-cloud-init.yaml,需要root权限

network:
    ethernets: {} #笔者没连网线
    version: 2
    wifis: #wifi配置
        wlp1s0:
            dhcp4: true
            access-points: #如果多个wifi,则access-points配置多个
                "wifi的名称":
                    password: "wifi的密码明文"
            access-points: #如果多个wifi,则access-points配置多个
                "wifi的名称":
                    password: "wifi的密码明文"

然后执行sudo netplan generate & sudo netplan apply

此时wifi就可以连上了,但是虚拟机等场景wifi比较麻烦,所以笔者还是插网线使用,后面作为服务器补充mac的黄金内存,毕竟总价还不到600,后面通过kvm安装虚拟机来充当服务器。

Ubuntu Server网络的坑

配置dhcp,比如动态dhcp

network:
  version: 2
  ethernets:
    enp1s0: # 根据自己的网卡,使用ip a
      dhcp4: true

修改/etc/netplan下的配置每次被还原

而且笔者是最小化安装的,只能使用cat写文件

cat > xxx <<-EOF

 就可以多行编辑覆盖文件,使用EOF(end of file)结束写

cat >> xxx <<-EOF

 追加写

静态dhcp只需要配置好ip 网关就好,也可以使用路由器绑定ip和mac(交换机的能力)

网络不通

启动就会报A start job is running for wait for network to be Configured

可以在cd /etc/systemd/system/network-online.target.wants/的service下添加设置

TimeoutStartSec=5sec

设置一个超时,默认2分钟超时 

Ubuntu其他坑

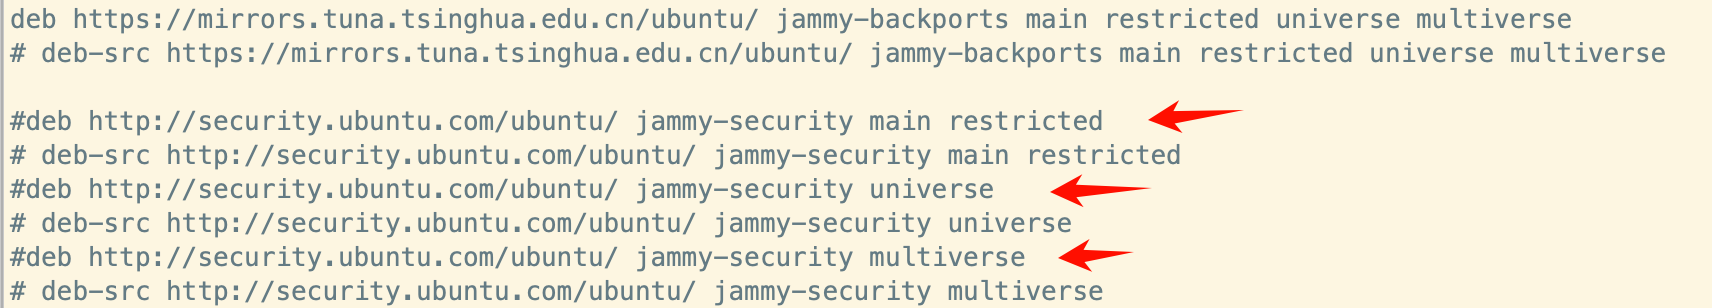
虽然安装时配置了其他源,速度很快,但是security还是原生的,直接关闭吧
扩容磁盘

笔者换了一个磁盘,从nvme换成以前的sata(MLC),从新安装系统未注意,导致128G只使用了60多G,扩容磁盘也遇到坑了,根据网上的教程

huahua@huahua:/$ lsblk
NAME                      MAJ:MIN RM   SIZE RO TYPE MOUNTPOINTS
sda                         8:0    0 119.2G  0 disk 
├─sda1                      8:1    0     1G  0 part /boot/efi
├─sda2                      8:2    0     2G  0 part /boot
└─sda3                      8:3    0 116.2G  0 part 
  └─ubuntu--vg-ubuntu--lv 252:0    0  58.1G  0 lvm  /
root@huahua:/home/huahua# df -h
Filesystem                         Size  Used Avail Use% Mounted on
tmpfs                              366M  1.2M  365M   1% /run
efivarfs                           192K   89K   99K  48% /sys/firmware/efi/efivars
/dev/mapper/ubuntu--vg-ubuntu--lv   57G  5.5G   49G  11% /
tmpfs                              1.8G     0  1.8G   0% /dev/shm
tmpfs                              5.0M     0  5.0M   0% /run/lock
/dev/sda2                          2.0G  103M  1.7G   6% /boot
/dev/sda1                          1.1G  6.2M  1.1G   1% /boot/efi
tmpfs                              366M   12K  366M   1% /run/user/1000

可以看到硬盘并未分配完成,虽然做服务器,但是偶尔可以当个smb中转吧。要利用起来

可以看到笔者的磁盘使用安装时默认的分区,sda1 sda2 sda3,设备为sda文件,其中sda3是主分区,对应/,分区跟磁盘格式有关联,可以看到笔者的格式为EXT4,主流格式

root@huahua:/# lsblk --fs /dev/sda3
NAME                    FSTYPE      FSVER    LABEL UUID                                   FSAVAIL FSUSE% MOUNTPOINTS
sda3                    LVM2_member LVM2 001       uJ81Jd-SlNe-tjXQ-EP4m-6y24-Bqcg-hsCoii                
└─ubuntu--vg-ubuntu--lv ext4        1.0            b2ec6080-7e9e-4d69-aeca-a83bb5221620     48.5G    10% /

先扩分区,笔者的主分区需要扩,在lsblk看是3分区

root@huahua:/# sudo growpart /dev/sda 3
NOCHANGE: partition 3 is size 243671695. it cannot be grown

然后resize

root@huahua:/# sudo resize2fs /dev/sda3
resize2fs 1.47.0 (5-Feb-2023)
resize2fs: Device or resource busy while trying to open /dev/sda3
Couldn't find valid filesystem superblock.

报错了,根据这个错误搜索,给出的解决思路都不对,说被占用啥的,实际上是需要分配空闲磁盘

root@huahua:/# lvextend -l +100%free /dev/mapper/ubuntu--vg-ubuntu--lv
  Size of logical volume ubuntu-vg/ubuntu-lv changed from 58.09 GiB (14872 extents) to <116.19 GiB (29744 extents).
  Logical volume ubuntu-vg/ubuntu-lv successfully resized.

成功,resize看看

root@huahua:/# resize2fs /dev/mapper/ubuntu--vg-ubuntu--lv
resize2fs 1.47.0 (5-Feb-2023)
Filesystem at /dev/mapper/ubuntu--vg-ubuntu--lv is mounted on /; on-line resizing required
old_desc_blocks = 8, new_desc_blocks = 15
The filesystem on /dev/mapper/ubuntu--vg-ubuntu--lv is now 30457856 (4k) blocks long.

root@huahua:/# df -h
Filesystem                         Size  Used Avail Use% Mounted on
tmpfs                              366M  1.2M  365M   1% /run
efivarfs                           192K   89K   99K  48% /sys/firmware/efi/efivars
/dev/mapper/ubuntu--vg-ubuntu--lv  115G  5.5G  104G   6% /
tmpfs                              1.8G     0  1.8G   0% /dev/shm
tmpfs                              5.0M     0  5.0M   0% /run/lock
/dev/sda2                          2.0G  103M  1.7G   6% /boot
/dev/sda1                          1.1G  6.2M  1.1G   1% /boot/efi
tmpfs                              366M   12K  366M   1% /run/user/1000

成功扩容,把未使用的磁盘用起来,免得浪费。

总结

时代变化很快,以前macmini2018是intel cpu,而且可以自己安装内存,现在已经arm cpu,内存已经是黄金内存了,还得益于炒ai概念,否则8G永流传,不过intel 12代性能提升还可以,所以干脆组装了专门的服务器,测试小主机满载也就23w左右,平时10w左右,还是x86的,在docker环境下很友好,毕竟很多镜像还是基于x86基础镜像做的,如果ARM自己编译也很麻烦。

Ubuntu Server实测可以使用wifi,但是因为没有图形界面,所以还是插网线,扔到角落,如果后面不用了还可以当电视盒子,毕竟电脑和电视收费2次的情况也很恶心。

双槽EPYC 9654服务器组装实战:高性价比数据中心级搭建指南 EPYC处理器是AMD面向数据中心与高性能计算推出的x86服务器CPU系列,基于Zen 4架构与Infinity Fabric互连技术,具备多核高带宽、NUMA拓扑和PCIe 5.0原生支持等关键特性。其性能原理依赖于内存控制器集成、CCD模块化设计及低延迟芯片间通信,技术价值体现在虚拟化密度、AI推理吞吐与数据库并发能力的显著提升。典型应用场景包括Proxmox/ESXi虚拟化集群、生物信息学基因比对、本地大模型推理(如Llama 3-70B)及Ceph分布式存储节点。本文聚焦EPYC 9654双路系统的 阅读详情

相关推荐

机器学习推理延迟优化实战:从ONNX到<50ms P95的系统级调优

机器学习推理延迟(ML Latency)并非单纯算法问题,而是横跨模型格式、硬件拓扑、内存管理、网络协议与服务编排的系统工程。其核心原理在于:生产环境推理多为I/O与内存带宽受限(I/O-Bound/Memory-Bound),而非计算受限(Compute-Bound);优化关键在于端到端延迟分解与硬件感知部署(Hardware-Aware Deployment)。技术价值体现在将实验室模型转化为稳定满足P95<50ms SLA的高可用推理服务,支撑推荐、搜索、实时风控等低延迟敏感场景。本文聚焦ONNX模型

abxlep7702的博客 404

在Mac上安装Linux的行为是否应该被鄙视?

我用一台Mac mini安装 ubuntu server运行 owncloud和自己写的软件好多年了,因为全金属,散热很好。因为做服务器,散热能够常年工作正常甚至比CPU内存硬盘可靠性要重要的多。这一点Intel NUC的风扇我个人觉得没有MacMini的靠谱。如果说图形界面,新版有touch bar,macbook pro / air装linux很麻烦了,外接键盘才能用。直接买一台NUC,或买华为的linux笔记本更好,不然还要交微软税,再把系统删掉装Linux,有些笔记本uefi还是锁的比如surfac

地推 1118

本地代码助手全平台部署实战:从识破GPT-5.4谣言到VSCode深度集成

本地代码助手是面向开发者的基础智能编程工具,其核心原理在于将开源大模型(如Qwen2.5-Coder、CodeLlama)通过量化推理(GGUF)、上下文感知引擎(LSP集成)和编辑器协议(VSCode+OpenAI API兼容)构建为可离线运行的工程级Agent。相比依赖云端API的传统方案,本地化部署保障数据主权、支持全项目上下文理解,并满足政企信创与嵌入式开发等强合规场景需求。技术价值体现在低延迟响应(首token<800ms)、中文代码任务高准确率(实测超94%)及VSCode中函数级智能辅助(自动

weixin_34198762的博客 372

02 | 云虚拟机(一):云端“攒机”,有哪些容易忽视的要点?

在今天这一讲中,我先帮助你了解了云虚拟机的一些理论知识,尤其是一些体系结构方面的特点。然后,我们进入了创建云虚拟机的实操环节,了解了相关的流程和步骤,也讨论了其中所牵涉的一些注意事项。强烈建议自己也动手操作一下,完成从创建到连接的全过程,形成一个直观的感受。我们把这一讲的要点总结如下:云虚拟机是最重要的 IaaS 服务之一,它基于计算存储分离的架构进行构建;云虚拟机的创建过程,由地域、机型、操作系统、存储、网络等多方面选项共同构成;云虚拟机可使用云厂商自有操作系统,与云有较好的适配;

qq_37756660的博客 1904

Windows本地部署OpenClaw:WSL2+Docker+LM Studio全栈方案

本地智能体(Agent)开发正从云端回归终端,其核心诉求是隐私可控、低延迟响应与模型热切换能力。OpenClaw作为轻量级开源Agent框架,本身不内置推理引擎,依赖外部LLM服务提供语言理解与工具调用能力;而GGUF格式已成为当前主流量化模型封装标准,具备跨平台兼容性与内存效率优势。在Windows生态中,直接部署常面临PowerShell权限混乱、Python环境冲突及GPU支持缺失等工程瓶颈。WSL2提供完整Linux内核能力,Docker实现运行时隔离与环境可复现,LM Studio则以开箱即用的G

weixin_34037515的博客 415

QClaw:腾讯推出的开箱即用本地AI工作流引擎

本地AI工作流引擎是一种面向终端用户的轻量级Agent运行时技术,其核心原理是将模型推理、技能调度与服务通信全部封装于单进程二进制中,通过静态链接、沙箱化技能包(.qcs)和SQLite状态管理,实现零依赖部署。该技术显著降低AI工具使用门槛,具备强隐私性、低延迟响应和跨平台一致性等工程价值,广泛适用于微信办公自动化、PDF/OCR本地处理、COS文件归档等边缘智能场景。QClaw正是这一理念的典型落地,它不依赖Python环境,也无需CUDA手动配置,真正让AI能力下沉到每台笔记本和办公终端。

weixin_34416649的博客 438

mini主机通过内网穿透做成服务器

主要目的本地设备做成服务器,实现ssh远程登录以及内网穿透设备总成本1千多元设备金额16g ddr4 内存条100多元1t 固态300多元极摩客g3599元网线 一根4元本地服务器ubuntu 配置总览安装ssh server 使ubuntu能够被远程登录安装docker 方便不同环境项目快速运行安装curl 方便请求访问及下载安装安装frp客户端,使用内网穿透,方便外网访问(可以使用花生壳,coplar等第三方代替)

LATER 1966

Ollama+AnythingLLM本地知识库实战:私有化RAG落地指南

RAG(检索增强生成)是构建可信AI问答系统的核心范式,其本质是将外部知识与大模型推理动态结合,解决幻觉与信息滞后问题。原理上依赖文档切分、向量嵌入、相似性检索与上下文注入四步闭环;技术价值在于平衡准确性、响应速度与数据主权——尤其适合对隐私敏感、网络受限或需结果可追溯的场景。典型应用包括企业内部文档智能检索、技术手册即时问答、合同与合规材料精准定位等。本文聚焦Ollama与AnythingLLM组合,以轻量架构实现开箱即用的本地RAG能力,覆盖ollama国内镜像源配置、anythingllm离线部署、C

weixin_30689307的博客 381

Kali linux下拓实N95外置网卡驱动安装教程

Kali linux拓实能N95驱动安装教程 1.把linux系统这个文件夹复制到虚拟机 2.已完成复制 3.打开linux系统这个文件 并在文件夹里 点击右键打 然后在终端打开 4.开的终端 5.输入解压命令tar -jxvf RT3070LinuxV2.5.0.3.bz2 root@kali:~/Documents/LINUX 系统# ls RT3070LinuxV

分享交流技术 1万+

Ubuntu 14.04下HHVM+Nginx部署实战:FastCGI架构与JIT调优

FastCGI是一种经典的Web应用通信协议,用于解耦Web服务器与语言运行时;JIT(即时编译)则是提升动态语言执行效率的核心技术。在PHP生态演进中,HHVM通过JIT将PHP代码编译为原生指令,显著提升QPS并降低内存占用,而Nginx作为FastCGI客户端,承担请求路由、SSL终止与连接管理等关键职责。该组合体现了‘网络层与执行层分离’的现代服务架构思想,广泛应用于高并发CMS、遗留系统迁移及离线政务云等场景。本文聚焦Ubuntu 14.04这一典型旧版环境,深入解析HHVM 3.12与Nginx

defkaug153461的博客 543

Claude Code本地化实操指南:CLI构建、Desktop虚拟化与Skill扩展

Claude Code 是 Anthropic 推出的面向开发者的工作流增强工具,其核心价值在于本地 CLI、workspace 运行时与 skill 插件机制三位一体的技术架构。它基于 Rust/TypeScript 混合实现,依赖 WHP/KVM/Virtualization.framework 等系统级虚拟化能力,并通过 OpenAI 兼容协议抽象后端模型调用。该工具链的技术价值在于将大模型能力深度嵌入 IDE 与本地开发环境,实现低延迟、高可控、可审计的 AI 编程辅助。典型应用场景包括 VS Co

weixin_34348174的博客 496

一、Ceph 开局指导手册之服务器初始化配置篇

摘要: 本文详细记录了在三台新华三R4900 G3服务器上部署Ceph集群的环境配置与操作系统安装过程。硬件配置包括双路16核CPU、128GB内存、12块硬盘(2块系统盘RAID1、2块SSD缓存盘、6块8T HDD直通数据盘),网络采用千兆管理网和万兆存储业务网分离。重点描述了RAID卡配置步骤:将两块558GB系统盘配置为RAID1阵列,其余数据盘设为直通模式(expose RAW)以便Ceph直接管理。通过HDM远程挂载openEuler 22.03镜像,调整启动参数完成系统安装。该环境满足Ceph

lss0516的博客 543

【信息科学与工程学】【制造工程】计算机科学与自动化——服务器制造中的学科知识01

由可数可加性:μ(A)=∑k=1∞​μ(Bk​)=limn→∞​∑k=1n​μ(Bk​)=limn→∞​μ(⋃k=1n​Bk​)=limn→∞​μ(An​)。:若limsupAn​=liminfAn​=A,则A中的元素恰是那些“最终总是属于An​”的元素,也是那些“属于无穷多个An​但不属于无穷多个Anc​”的元素。:通过构造一个不相交的序列{Bn​},其中B1​=A1​, Bn​=An​∖(⋃k=1n−1​Ak​)。则⋃n​Bn​=⋃n​An​,且Bn​⊂An​。我们称A为一个“集类”或“集合族”。

weixin_49199313的博客 553

Arch Linux图形化桌面构建全链路指南:X11与Wayland深度实践

Linux图形化桌面本质是硬件抽象层、内核KMS/DRM、用户态显示服务器(X11或Wayland)与桌面环境四层解耦栈的协同系统。其核心原理在于GPU驱动(如i915、amdgpu、nvidia)通过libdrm与内核DRM/KMS通信,再由Xorg或Wayland合成器调度渲染资源,最终交付给Plasma、GNOME等桌面环境。这一架构决定了Arch Linux图形部署不是简单包安装,而是对显示子系统全链路的手动校准——从mkinitcpio集成GPU模块、KMS早期激活,到Display Manage

weixin_34235457的博客 299

BDD测试之Behave使用入门

BDD测试(Behavior-Driven Development Testing)是一种基于“行为驱动开发”(BDD)理念。

想要成为酷盖但是失败的小明 579

DDS器件原理与应用(AD9833 AD9834)

是DDS的核心组成部分,用于实现相位的累加,并输出相应的幅值。相位累加器由M位宽加法器和M位宽寄存器组成,通过时钟控制,将上一次累加结果反馈到加法器输入端实现累加功能,从而使每个时钟周期内的相位递增数为,并取相位累加结果作为地址输出给ROM查找表部分。DDS的相位信息被存放在累加寄存器中,虽然幅值和相位不是线性关系,但寄存器累加值和相位可以是线性关系,很容易用寄存器的累加值表达相位信息。

m0_49968063的博客 6439

y9000p后封机如何验证(by quqi99)

14, 打联想客服(400990888-2-1-6-5), 但客服说默认保修时间就是从生产日期算的, 保修是二选一, 不需要修改这个时间也可通过发票日期找他们修改(保修是这样用的, 平时不用带发票, 但系统显示过保带发票就能修). 另外他说联想官方没有渠道可查询是否被激活(激活是windows的事). 客户说windows在机器生产日期之前或之后安装都有可能, 为什么两个时间相差那么长她也不清楚建议问经销商, 她同时说她们没办法知道是不是后封机.

技术并艺术着 1800

手把手教你用VSCode+SDL在Ubuntu上跑LVGL8.2模拟器(附插件清单)

本文详细介绍了在Ubuntu系统上使用VSCode和SDL库搭建LVGL8.2模拟器环境的完整流程,特别适合嵌入式开发者(如全志F1C100s平台)进行UI设计验证。从环境配置、项目编译到VSCode深度集成,提供了实用技巧和常见问题解决方案,帮助开发者实现'先模拟后真机'的高效开发模式。

weixin_33737134的博客 355

本地部署CodeGeex实现VSCode离线AI编程辅助

代码大模型(Code LLM)是面向开发者的核心AI能力,其本地化部署需兼顾轻量推理、协议兼容与数据安全。基于LSP协议的本地AI编程辅助,本质是将量化模型(如GGUF格式)通过CPU高效加载,并封装为标准语言服务器,从而在无网络环境下提供低延迟补全、hover提示等IDE功能。关键技术路径包括模型量化压缩、流式HTTP服务适配、VSCode插件深度集成,适用于制造业嵌入式开发、高校科研、金融/政务等强合规场景。本文聚焦CodeGeex-2-6B在Llama.cpp框架下的本地模式落地,覆盖从模型校验、ll

weixin_29057163的博客 293

告别配置烦恼!保姆级教程:在Windows 10/11上为QT5.14.2配置MSVC2017编译器(附VS2022组件避坑指南)

本文提供了一份详细的保姆级教程,指导如何在Windows 10/11上为QT5.14.2配置MSVC2017编译器,包括VS2022组件避坑指南。从环境准备到关键配置,再到调试工具验证和Qt Creator中的编译器设置,一步步解决常见问题,帮助开发者快速搭建稳定可靠的开发环境。

weixin_30615767的博客 501

TMC5160电机驱动芯片实战:从模式选择到参数配置全解析

本文深入解析TMC5160电机驱动芯片的实战应用,涵盖三种核心工作模式的选择策略与参数配置。详细介绍了全功能运动控制、外部脉冲驱动及独立驱动模式的应用场景与配置要点,并提供了电流控制、静音优化、SPI通信及高级功能(如StallGuard2)的调优指南,帮助开发者充分发挥其高精度、低噪音性能。

weixin_29179311的博客 322

本地运行大模型:零代码迁移OpenAI API的实践方案

大语言模型本地化部署是当前企业降本增效与数据合规的核心路径。其本质在于将云端黑盒服务转化为可控、可审计的内部组件,关键技术原理是协议桥接与接口抽象——通过兼容OpenAI RESTful API规范的中间层,实现对llama.cpp、vLLM等后端推理引擎的统一封装。该方案不仅规避了API调用费用与网络延迟,更带来SLA稳定性提升、JSON Schema强输出支持及function calling完整兼容等工程价值。适用于智能客服、私有知识库问答、自动化文档处理等需数据不出域、低延迟响应与高集成度的生产场景

weixin_33910460的博客 385

SAP 物料主数据 Forecasting 视图,别把预测只当成一个数字字段

摘要(150字): SAP S/4HANA物料主数据的Forecasting视图常被忽视,但对依赖历史消耗规律的物料至关重要。该功能基于工厂维度的历史消耗数据,结合预测参数自动计算未来需求,动态调整重订货点和安全库存。预测模板(Forecast Profile)能标准化参数设置,而消耗数据(Consumption Values)的质量直接影响预测结果。预测值作为MRP输入,需注意保存操作才能生效。自动重订货点功能通过分析消耗波动和服务水平,实现库存策略的动态优化。Individual Forecast功能则

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1432

AI模型服务延迟排查实战:四层故障定位与优化

机器学习系统延迟并非单一GPU性能问题,而是应用层、运行时层、系统层和硬件层四重嵌套的协同故障。其本质是端到端请求处理中各环节的时序错配与资源争用,如Python GIL阻塞、TensorRT动态shape适配失效、NUMA内存绑定错误及PCIe链路降频等。技术价值在于将模糊的‘P95延迟高’转化为可测量、可归因、可修复的工程问题,支撑毫秒级AI服务SLA落地。典型应用场景涵盖实时OCR、金融风控推理、边缘姿态识别等对延迟敏感的生产环境。本文聚焦真实线上故障模式,覆盖PyTorch GIL释放、Tensor

adiking520110的博客 417

Calibre 3Dstack --每日一个命令day27【overlap】(3-27)

本文介绍了Calibre3Dstack中overlap命令的使用方法。该命令用于检查两个已放置层之间的重叠量是否符合要求,支持设置检查名称、层类型、堆叠范围、检查方向等参数。关键参数包括:-constraint指定重叠约束条件,-exact控制百分比精度,-by_area切换为面积检查模式,-intersection报告相交区域。检查结果可通过RVE选项定制显示方式,适用于3D堆叠设计中的层间重叠验证场景。

u013620135的博客 112

AI大模型探索之路-实战篇4:深入DB-GPT数据应用开发框架调研

在当今的人工智能时代,大模型技术的迅猛发展为各行各业带来了前所未有的变革。这些大模型,以其强大的语言理解和生成能力,正在逐步成为智能化应用的核心。然而,如何高效地利用这些大模型,构建出满足各种需求的应用,仍然是一个具有挑战性的问题。DB-GPT,作为一个开源的AI原生数据应用开发框架,应运而生,旨在简化大模型应用的开发过程,让构建智能化应用变得触手可及。本文将深入介绍DB-GPT的核心功能、关键特性,并通过实战操作,展示如何利用DB-GPT进行数据应用开发。DB-GPT是一个开源的AI原生数据应用开发框架。

寻道AI,探索AI无限可能! 1万+
上一篇: nginx自编译重现gzip和chunked的现象
下一篇: macOS 15.4.1 Chrome不能访问本地网络
fenglllle
博客等级 码龄8年 461粉丝 242原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值