BN层相关理论

模型压缩(一)通道剪枝-BN层 通道剪枝 阅读详情

BN----Batch Normalization(批量归一化):解决在训练过程中,中间层数据分布发生改变的问题,以防止梯度消失或梯度爆炸、加快训练速度(什么叫中间层数据分布发生改变??)

1、为什么输入数据需要归一化

归一化有什么好处呢?原因在于神经网络学习过程本质就是为了学习数据分布,一旦训练数据与测试数据的分布不同,那么网络的泛化能力也大大降低;另一方面,一旦每批训练数据的分布各不相同,那么网络就要在每次迭代都去学习适应不同的分布,这样将会大大降低网络的训练速度,这也正是为什么我们需要对数据都做一个归一化预处理的原因。

深度网络的训练是一个复杂的过程,只要网络的前面几层发生微小的改变,那么后面几层就会被累积放大下去。一旦网络某一层的输入数据的分布发生改变,那么这一层网络就需要去适应学习这个新的数据分布,所以如果训练过程中,训练数据的分布一直在发生变化,那么将会影响网络的训练速度。

2、BN训练

(1)随机梯度下降法(SGD)对于训练深度网络简单高效,但是有个问题,就是需要我们人为的去选择参数,比如学习率、参数初始化、权重衰减系数、Drop out比例等。这些参数的选择对训练结果至关重要,以至于我们很多时间都浪费这些调参上面。那么使用BN之后,你可以不需要那么刻意的慢慢调整参数。

(2)神经网络一旦训练起来,那么参数就要发生更新,除了输入层的数据外(因为输入层数据,我们已经认为的为每个样本归一化),后面网络每一层的输入数据分布是一直在发生变化的,因为在训练的时候,前面层训练参数的更新将导致后面层输入数据分布的变化。以网络第二层为例:网络第二层输入,是由第一层的参数和input计算得到的,而第一层的参数在整个训练过程中一直在发生变化,因此必然会引起后面每一层输入数据分布的改变。我们把网络中间层在训练过程中,数据分布的改变称之为“Internal Covariate Shift”。文章所提出的算法,就是要解决在训练过程中,中间层数据分布发生改变的情况,于是就有了Batch Normalization的诞生。

(3)BN的本质原理:在网络的每一层输入的时候,又插入了一个归一化层,也就是先做一个归一化处理(归一化至:均值0,方差为1),然后再进入网络的下一层。不过这个归一化层,可不像我们像的那么简单,它是一个可学习、有参数(γ、β)的网络层。(它和激活层的区别是什么,为什么需要参数,并且是可学习的???)

3、BN的作用

(1)改善流经网络的梯度(有没有具体的实例让我的脑力有个回路??)

(2)允许更大的学习率,大幅提高训练速度:(为什么可以有更大的学习率)

你可以选择比较大的初始学习率,让你的训练速度飙涨。以前还需要慢慢调整学习率,甚至在网络训练到一半的时候,还需要想着学习率进一步调小的比例选择多少比较合适,现在我们可以采用初始很大的学习率,然后学习率衰减速度也很大,因为这个算法收敛很快。当然这个算法即使你选择了较小的学习率,也比以前的收敛速度快,因为它具有快速训练收敛的特性;

(3)减少对初始化的强烈依赖

(4)改善正则化策略:作为正则化的一种形式,轻微减少了对dropout的需求

你再也不用去理会过拟合中drop out、L2正则项参数的选择问题,采用BN算法后,你可以移除这两项参数,或者可以选择更小的L2正则约束参数了,因为BN具有提高网络泛化能力的特性;

(5)再也不需要使用局部响应归一化层了(局部响应归一化是Alexnet网络用到的方法,搞视觉的估计比较熟悉),因为BN本身就是一个归一化网络层;

(6)可以把训练数据彻底打乱(防止每批训练的时候,某一个样本都经常被挑选到,文献说这个可以提高1%的精度)(什么叫打乱???为什么不打乱,就会有某一个样本被经常挑选到???)

4、BN层的计算方法

(1)先求出此次批量数据x的均值

(2)求出此批量的方差

(3)接下来就是对本次批量的x做归一化:(x_{i} - 均值)/ 根号下(方差+极小值),防止分母为0

这个极小值eps是浮点类型的最小值常量。

(4)最后最重要,引入应以变量γ和β。

如果γ和β分别等于此batch的方差和均值,那么y_{i}就还原到了归一化前的x,β 和γ分别称之为 平移参数和缩放参数 。这样就保证了每一次数据经过归一化后还保留的有学习来的特征,同时又能完成归一化这个操作,加速训练。


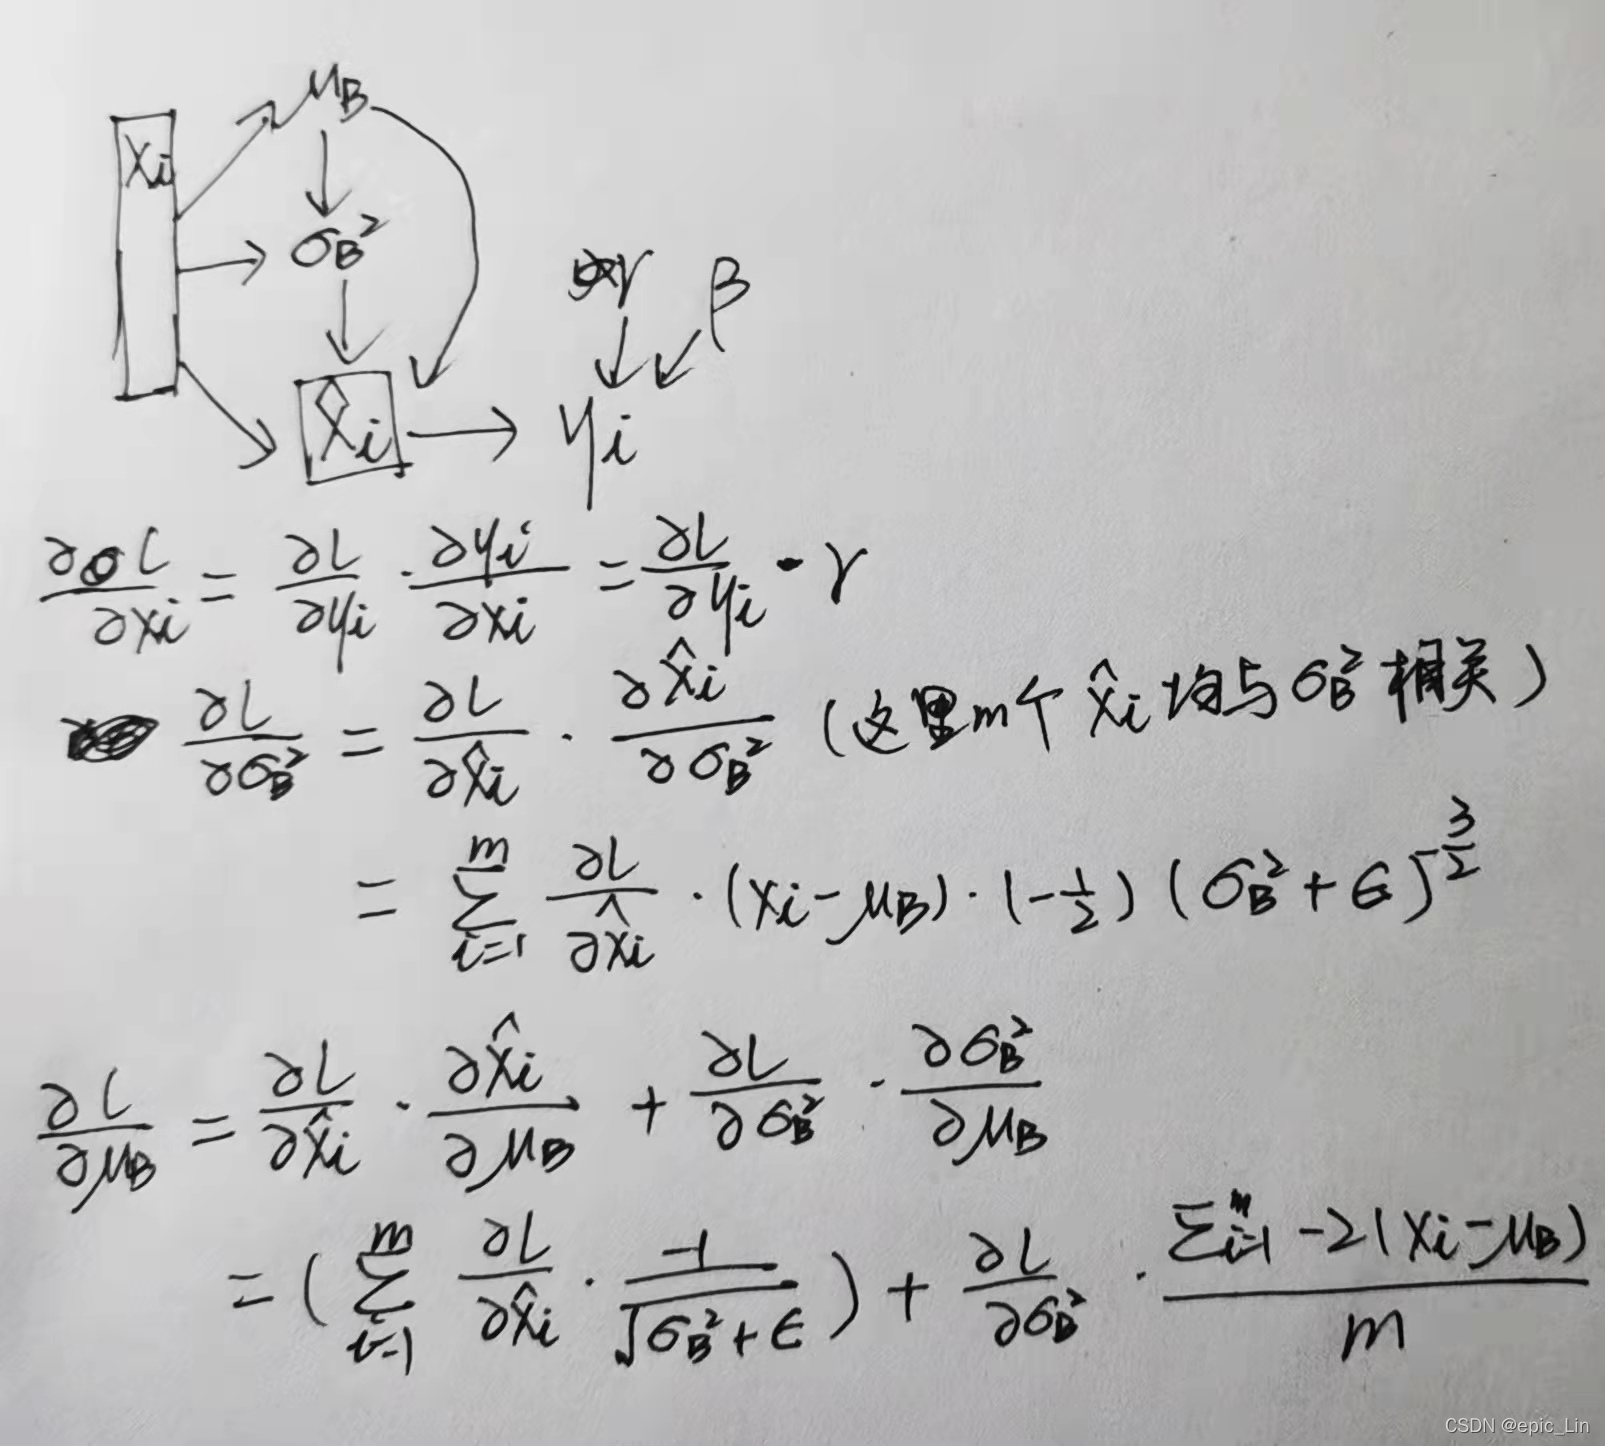
关于这里的梯度计算:

把前项传播上的每一个变量都当做输入x的中间函数,用多元微分的算法进行计算,在正向前推的时候理清楚谁推出了谁,在反向传播的时候把每一项相关的都计算入偏微分内,也就是在反向传播的时候沿着反箭头的方向寻找所有通道所求变量的通路,就可以计算出准确的导数。

5、什么是梯度爆炸

如果网络使用sigmoid激活函数,误差在向前传递的时候,经过sigmoid单元,需要乘sigmoid的梯度,而sigmoid的梯度最大是0.25,因此越向前传递,误差就越小了,这就是梯度消散。那梯度爆炸是什么呢?误差在经过全连接或者卷积层时,也要乘以权重w,如果w比较大,大过sigmoid造成的及那小,这样越往前误差就越来越大,就梯度爆炸了。 

这部分没写完,下次连同上面的公式还有一些其他原理一起理清楚了

6、 对缩放因子的理解(连同BN剪枝)

对神经网络参数更新的理解有些出入导致那时候想的时候有点转不过弯,损失函数是人为对网络学习的一种限制,每个参数包括缩放因子都有损失函数关于参数的偏导数,根据这个偏导数和学习率每次训练对所有参数进行更新。增加了缩放因子之后神经网络可以自动对batch的数据进行中心归一化和缩放偏移。而BN剪枝在损失函数中增加了缩放因子正则化项,逼着缩放因子往0的方向逼近,所以有些不重要的通道就在损失函数的压迫下缩放因子变得很小,也就是说在损失函数的山坡上,这个正则化逼着网络走了

Dropout层、BN层、Linear层 & 神经网络的基本组成 图1 卷积网络中的 layers 承接上三篇博客:卷积层(空洞卷积对比普通卷积)、激活函数层、池化层 & 感受野 目录 (1)Dropout层 (2)BN层(BatchNormal) (3)全连接层 (1)Dropout层 在深度学习中,当参数过多而训练样本又比较少时,模型容易产生过拟合现象。过拟合是很多深度学习乃至机器学习算法的通病,具体表现为在训练集上预测准确率高,而在测试集上准确率大幅下降。2012 年,Hinton等人提出了Dropout算法,可以比较有效地缓解过拟合现.. 阅读详情

相关推荐

【卷积神经网络】对BN层的解释

【卷积神经网络】对BN层的解释 前言Batch Normalization是由google提出的一种训练优化方法。参考论文:Batch Normalization Accele...

急流勇进 1万+

将YOLO算法中的BN层的缩放因子的分布图用matplotlib画出

将缩放因子的分布图画出来 本博客是基于https://github.com/tanluren/yolov3-channel-and-layer-pruning。 首先找到缩放因子所对应的变量 在所有剪枝代码里面都有,以slim_prune.py里面作为示例,bn_weights这个变量就存储了所有可供剪枝的通道对应的BN层的缩放因子 bn_weights = gather_bn_weights(model.module_list, prune_idx) 将bn_weights进行转化 bn_weights

weixin_44927463的博客 2061

【YOLO v4 相关理论】Normalization: BN、CBN、CmBN

一、Batch Normalization 论文:https://arxiv.org/pdf/1502.03167.pdf Batch Normalization是google团队在2015年论文《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》提出的。 个人认为这时一篇可以排进深度学习前十的一篇神作,目前大部分的流行算法、模型都会用到BN,它可以加快模型的收敛速度,

qq_38253797的博客 6892

pytorch bn

https://zhuanlan.zhihu.com/p/120265831 https://zhuanlan.zhihu.com/p/337732517 1.bn好处 防止过拟合:单个样本的输出依赖于整个 mini-batch,防止对某个样本过拟合; 加快收敛:梯度下降过程中,每一层的 [公式] 和 [公式] 都会不断变化,导致输出结果的分布在不断变化,后层网络就要不停地去适应这种分布变化。用 BN 后,可以使每一层输入的分布近似不变。 防止梯度弥散:forward 过程中,逐渐往非线性函数的取值区间的

qq_33228039的博客 397

BN层(Pytorch)

近期在实验的过程中,发现了一个问题。实验结果受Batch_size影响在波动。Batch_size在分别为4和8的时候,实验效果不同,当Batch_size为8的时候实验效果还要差一点.这一点我很意外,当所有超参设置都一样的时候,BN层效果与Batch_size大小的影响应该是呈现一个正相关.这里放一张Kaiming He在2018ECCV上发表的《Group Normalization》论文中的一张图。图中蓝色曲线是ResNet50在ImageNet上分类的错误率,当Batch_size越大的时候,错误率

weixin_40825364的博客 2864

BN层学习

   BN层,顾名思义嘛,就是归一化的作用,在深度学习里很常用,这里来简要梳理一下BN层的相关知识. 1 BN层引出的目的    神经网络在进行训练时,主要是用来学习数据的分布规律,如果数据的训练部分和测试部分分布不一样,那么网络的泛化能力会变得非常差.而且对于训练的数据,每批分布也是不一样的,那么网络在迭代的过程中也要学习和适应不同的分布.这会大大降低网络的训练速度.此外,数据的分布对于...

CHNguoshiwushuang的博客 2083

BN(Batch Normalization)批量归一化

BN

LIN2020LOVEDA的博客 421

微调时冻结批处理正则化层(BN)的意义在哪

冻结bn的意义

Thomas_Cai的记忆殿堂 1911

神经网络压缩 剪枝 量化 嵌入式计算优化NCNN mobilenet squeezenet shufflenet

性能提升方法 本文github链接 1. 小模型 mobilenet , 更精细模型的设计,紧致网络设计 mobilenet squeezenet shufflenet MobileNet逐通道卷积 + 普通点卷积 SqueezeNet 1∗1 和3∗3 卷积较少通道数量 ShuffleNet 分组点卷积+通道重排+逐通道卷积 2. 模型压缩:参数稀疏、剪裁、量化、分解 ...

万有文的博客 1万+

BN层学习笔记

BN层的学习笔记记录

橙的博客 1477

pytorch之添加BN

pytorch之添加BN层 批标准化 模型训练并不容易,特别是一些非常复杂的模型,并不能非常好的训练得到收敛的结果,所以对数据增加一些预处理,同时使用批标准化能够得到非常好的收敛结果,这也是卷积网络能够训练到非常深的层的一个重要原因。 数据预处理 目前数据预处理最常见的方法就是中心化和标准化,中心化相当于修正数据的中心位置,实现方法非常简单,就是在每个特征维度上减去对应的均值,最后得到 0 均值的...

朴素.无恙的博客 1万+

深度学习理论向应用的过渡课程【北京大学_TensorFlow2.0笔记】学习笔记(九)——TensorFlow描述CNN:感受野、全零填充、卷积计算层、BN、池化、舍弃

TensorFlow描述卷积神经网络基本概念——感受野、全零填充、卷积计算层、BN、池化、舍弃

m0_58586235的博客 481

卷积神经网络中的Conv层和BN层融合细节

输入数据的,BN 就是为了解决小批次输入数据的分布偏移而提出的,因此训练时需要BN层。而训练后的推理,是单样本输入,训练时 BN 的参数已经确定,这些参数相当于对前一层的特征图数据做一次线性变换,而卷积层也可以转化为对特征图的线性变换。因为将输入的样本数据或特征图,归一化后,改善了输入数据的分布,或者说。在训练时,卷积层和 BN 是两个模块,但是为什么训练时不能融合,而训练完成后,仅执行前向推理却可以融合?一张图可以解释,改善输入数据的分布,可以更容易找到模型参数w和b,从而加速模型收敛。

qunsorber的博客 3505

pytorch中的BN层简介

pytorch中的BN层简介简介pytorch里BN层的具体实现过程momentum的定义冻结BN及其统计数据 简介 BN层在训练过程中,会将一个Batch的中的数据转变成正太分布,在推理过程中使用训练过程中的参数对数据进行处理,然而网络并不知道你是在训练还是测试阶段,因此,需要手动的加上,需要在测试和训练阶段使用如下函数。 model.train() or model.eval() 在Pytorch中,BN层的类的参数有: torch.nn.BatchNorm2d(num_features, eps=1

lpj822的专栏 7164

【Telephony】APN配置及加载流程&项目实践(AOSP)

学习APN关键是学会明白apns-conf.xml文件各个参数的意思,然后熟悉TelephonyProvider是如何读取文件创建数据库的,譬如数据库表的约束、文件的读写顺序等,还有读取后的ApnSetting的二次定制以及显示(例如屏蔽xcap等)。虽然一般在项目中APN的需求很简单,就是按照客户提供的APN参数添加上配置,或者在显示屏蔽一些参数,但是项目维护的过程中APN的问题也是比较多的。

weixin_44513784的博客 5514

再生龙(clonezilla)镜像比目标盘大——基于centos8.5

再生龙恢复到小盘遇到的问题及处理,首先是修改分区大小,进入dracut模式后再尝试恢复临时系统。

u010101453的博客 3690

在caffe中,BN层怎么用?

目录 1.BN的作用 2.BN在caffe中代码 3.补充 4.参考 1.BN的作用 BN层的设定一般是按照conv→bn→scale→relu的顺序来形成一个block。 关于bn,有一个注意点,caffe实现中的use_global_stats参数在训练时设置为false,测试时设置为true。 因为在训练时bn作用的对象是一个batch_size,而不是整个训练集,如果没...

一个做图像文本的深度学习人 1499

告别手动维护!教你用SAP BAPI批量更新生产订单BOM组件(CO02工单)

本文详细介绍了如何利用SAP BAPI实现生产订单BOM组件的批量更新,解决传统手工操作(如CO02工单)效率低下的问题。通过核心函数解析和批量处理框架设计,帮助用户大幅提升工作效率,降低错误率,适用于物料主数据变更、季节性配方调整等场景。

weixin_30844577的博客 561

卷积层、BN层

文章目录1.Bn层详解2.卷积神经网络相关激活函数过拟合 1.Bn层详解 https://blog.youkuaiyun.com/qq_37100442/article/details/81776191 1)BN层在网络中的作用 BN层是一种批规范化操作,公式为减均值除标准差,然后乘γ加β。将输入分布归一化到0,1分布,使得激活函数更好的作用,因此解决了梯度消失的问题。同时由于数据被归一化,使得网络可以有更好的收敛速度。但是似乎没有证据表明它可以解决高层的网络输入分布变化剧烈的问题(Internal Covariat

weixin_43143419的博客 2393

强化学习从基础到进阶-常见问题和面试必知必答[7]:深度确定性策略梯度DDPG算法、双延迟深度确定性策略梯度TD3算法详解

强化学习从基础到进阶-常见问题和面试必知必答[7]:深度确定性策略梯度DDPG算法、双延迟深度确定性策略梯度TD3算法详解

丨汀、的博客 511

[解决] PDF转图片,中文乱码或显示方框的解决方案

在Java开发中,将PDF文件转换为图片是一项常见的需求,但过程中可能会遇到中文乱码或显示方框的问题。本文将深入探讨这一问题,并提供详细的解决方案,帮助开发者顺利地完成PDF到图片的转换。

DazedMen的博客 1925

BN 层原理解析

1 训练数据为什么要和测试数据同分布? 看看下图,如果我们的网络在左上角的数据训练的,已经找到了两者的分隔面w,如果测试数据是右下角这样子,跟训练数据完全不在同一个分布上面,你觉得泛化能力能好吗? 2 为什么白化训练数据能够加速训练进程 如下图,训练数据如果分布在右上角,我们在初始化网络参数w和b的时候,可能得到的分界面是左下角那些线,需要经过训练不断调整才能得到穿过数据点的分界面,这个...

m0_37699976的博客 1万+

数字电路与逻辑设计实验二 组合逻辑电路

1.组合逻辑电路功能测试 (1)用 2 片 74LS00 组成图 2.1 所示逻辑电路。为便于接线和检查,在图中要注明 芯片编号及各引脚对应的编号。 (2)图中 A、B、C 接逻辑开关,Y1,Y2 接发光管电平显示。 (3)按表 2.3 要求,改变 A、B、C 输入的状态,填表并写出 Y1,Y2 的逻辑表达式。 (4)将运算结果与实验结果进行比较。 2.测试用异或门(74LS86)和与非门组成的半加器的逻辑功能。 根据半加器的逻辑表达式可知,半加 器 Y 是 A、B 的异或,而进位 Z 是 A

欢迎交流学习心得 1280

神经网络BN层batch normalization参数计算

神经网络BN层batch normalization参数计算作用计算过程训练阶段预测阶段 作用 BN层一般放在线性层或卷积层后面,激活函数前面,作用如下: 1.加快网络收敛; 因为每层的数据都转换为同一的分布,这样会加快训练速度。 2.防止梯度爆炸和梯度消失; 因为BN会使非线性变换函数的输入值落入对输入比较敏感的区域。 3.防止过拟合,提升泛化能力。 因为BN求均值和方差是基于同一个batch内的样本,使网络不会朝一个方向学习。 计算过程 为什么会有放缩系数γ\gammaγ和平移系数β\betaβ? 因

bblingbbling的博客 8368

构建个体结构脑网络的另一种方法

这篇文献提出了一种构建个体结构脑网络的方法即Morphometric INverse Divergence (MIND),通过T1像数据即可对每个被试构建一个脑网络,且通过多个特征进行构建而非单一的特征。即可获得由4个特征得到的个体结构网络矩阵,可以根据自己的需求采用不同的特征组合得到网络矩阵,也可以结合T1/T2像得到髓鞘化相关的网络矩阵,后续可修改代码批量处理自己的数据。这是文献贴出来的代码。在终端直接克隆到本地。2.修改路径运行代码。

weixin_52073820的博客 823

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

上一篇: openvino环境配置(openvino2022之前的版本)
下一篇: yolov5剪枝蒸馏加速
epic_Lin
博客等级 码龄5年 338粉丝 34原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值