Learning both weights and connections for efficient neural networks

网络模型剪枝-论文阅读《Learning both Weights and Connections for Efficient Neural Networks》 这是2015年NIPS的一篇经典的剪枝文章,由韩松大神所作,由于年代比较久远,所以就大概说一下它的重点内容,以便给模型剪枝有个初始印象。 Introduction 文章首先讲了LeNet、AlexNet和VGG这些当时经典的网络的参数量的非常大,同时需要的存储空间也越来越大;然后以能量消耗的角度谈了这些模型运行具体能消耗多少能量。这就引出了本文的目标,就是对较大的网络模型进行剪枝以降低能量消耗从而能在移动端实时运行。 文章提出的剪枝策略是:①在初始模型训练完成后,②移除权重低于特定阈值的所有连接,即从稠密连 阅读详情

学习权重和链接以提高神经网络的效率

【论文】模型剪枝(Network Pruning)论文详细翻译_u013044310的博客-优快云博客

摘要

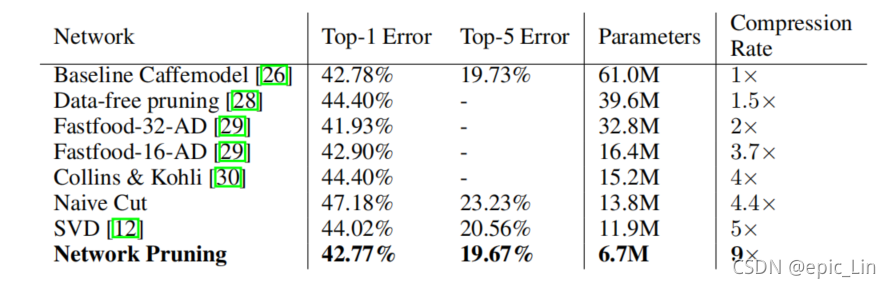
神经网络需要大量计算, 又占用大量内存, 因此难以在嵌入式系统上部署。另外, 传统网络在训练开始前就确定了体系结构;因此, 训练无法改善体系结构。为了解决这些限制,我们描述了一种减少神经网络所需的存储和计算的方法,而不影响它们的准确性,只学习重要的连接。我们的方法使用三个步骤来修建冗余连接。首先,我们训练网络来了解哪些连接时重要的。接下来,我们修建不重要的连接。最后,我们重新训练网络,以微调其余连接的权重。在 ImageNet 数据集上, 相比于AlexNet 我们的方法减少了 9x的参数(从6100万到 670万),而不会导致精度损失。在VGG16网络基础上做类似的实验发现,整个网络可以在没有丢失准确性的情况下减少13x的参数。

1简介

为了实现修建网络的目标,我们提出了一种方法,以保留原始精度的方式修建网络连接。在初始训练阶段后,我们删除所有的权重低于阈值的连接。此修建将稠密的完全连接层转换为稀疏图层。这一阶段学习网络的拓扑,即了解哪些连接是重要的,并删除不重要的连接。然后我们重新训练稀疏网络,以便其余的连接可以补偿已删除的连接。修建和再训练的阶段可以反复重复,以进一步减少网络复杂性。实际上,这个训练过程和人类大脑的发展也非常类似,神经元突触在孩子的发育的前几个月大量产生, 并在接下来的时间里逐渐修剪不常使用的连接, 逐渐发育成适合所生存世界的成年人。

2、相关工作

深度神经网络明显有非常大的冗余。这就导致了计算和内存使用的浪费。有各种各样的方法来消除冗余: Vanhoucke 等. [11] 探索了一个带有8位整数 (vs 32 位浮点) 激活的定点实现。丹顿等人 [12] 利用神经网络的线性结构, 通过寻找参数的适当的低秩逼近, 并保持在原始模型的1% 内的准确性。与类似的精度损失, 锣等人 [13] 使用矢量量化压缩深度模型, 减少存储, 但由于访问codebook而增加了一级间接的内存索引。这些逼近和量化技术与网络修剪是正交的, 它们可以一起使用来获得更好的压缩效果。(以后慢慢看一下,都没听过)

还有其他试图通过将完全连通的层替换为全局平均池来减少神经网络参数的数量。网络体系结构 [14] 和 GoogLenet [15] 通过采纳这个想法在几个指标上达到最先进的结果。但是, 这种方法使得迁移学习, 即复用从ImageNet 数据集上所学到的特征, 并仅通过微调全连接层将它们应用到新任务中变得更加困难。这个问题是由 Szegedy 和 al [15] 指出的, 并使他们产生了在网络顶部增加一个线性层, 以实现迁移学习的灵感。(这里也基本没有听过,包括迁移学习啥的,后面看)

网络修剪已被用于减少网络复杂性和减少过度拟合。修剪的早期的方法是有偏权重衰减(biased weight decay)。Optimal Brain Damage [17] 和Optimal Brain Surgeon [18] 基于损失函数的海森矩阵来修剪网络结构,减少连接的数量, 并且建议这样修剪比基于权重的修剪是更加准确。然而,计算二重导数对于今天的大规模神经网络来说是困难的。

Dropout [19] 和 DropConnect [20] 零激活和连接在网络减少过度拟合而不是提高效率。在 [21] 中的开头部分描述了类似的方法。Dropout不论是在最初的目的还是在它的训练过程中通过断开连接或激活层(稠密层仍然是稠密层, 在部署时没有参数保存)而不是修剪他们这两方面来说,都:不同于我们的方法。(大名鼎鼎的dropout,到时候去看)

HashedNets [22] 是最近的一种方法, 通过使用哈希函数将连接权重随机分组到哈希桶中来减少模型大小, 以便同一哈希桶内的所有连接共享单个参数值。这种技术可以从修剪中受益。正如在石等人 [23] 和温伯格等 [24] 中指出的, 稀疏性将最小化哈希碰撞使特征哈希更有效。HashedNets 可以与修剪一起使用, 以提供更好的参数节约。(又是没听过的)

3、除了学习权重之外还学习怎样连接
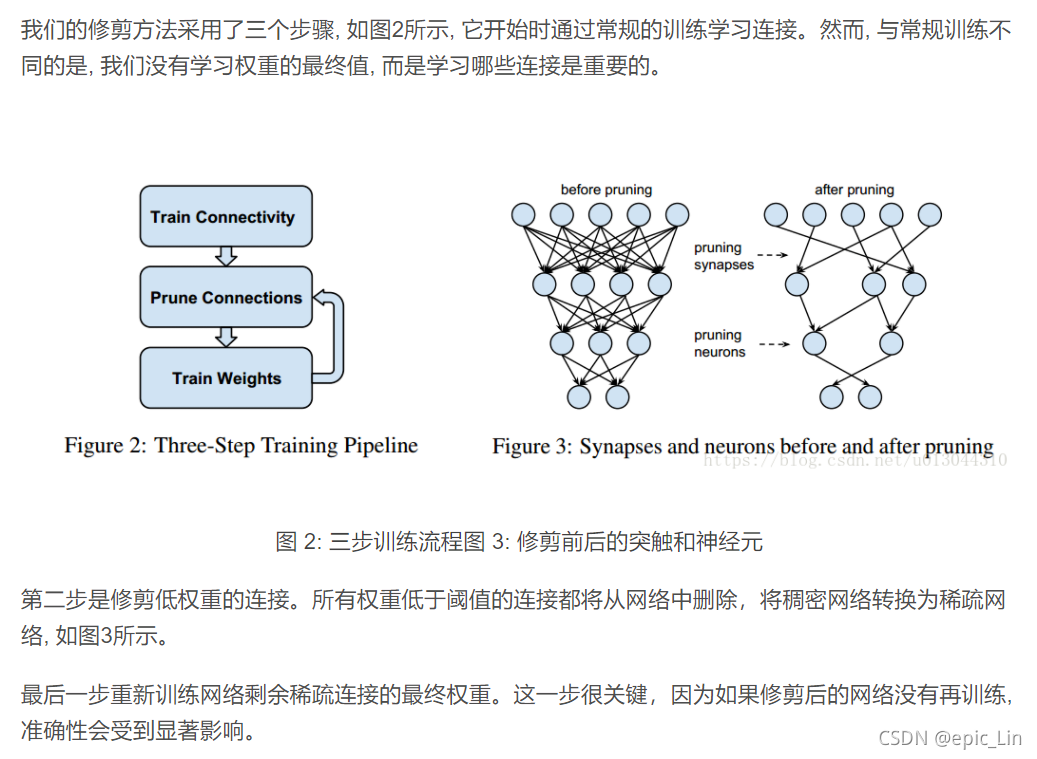
 3.1 正则化

选择正确的正则化对剪枝和再训练的性能有影响。L1正则化惩罚非零参数,导致更多的参数接近于零。这在修剪后,再训练之前具有更好的准确性。然而,其余的连接不如L2正则化好,导致再训练后的精度较低。总的来说,L2正则化给出了最好的剪枝结果。这将在实验部分进行进一步的讨论。

3.2  Dropout和Capacity Control

Dropout被广泛用于防止过拟合, 这也适用于再训练。然而, 在再训练期间, 必须调整Dropout率, 以匹配模型的变化。韩丁的Dropout [19] 可以被视为一个 “软Dropout”, 因为对于每次训练,每个参数概率都有概率被取消连接,而不是训练之前就指定了一些Dropout的参数。修剪可以被视为一个 “硬Dropout”, 其中的参数是永远被修剪,而且没有机会在重新参与训练。当参数变得稀疏时, 分类器将选择最具信息量的预测因子, 因而具有更少的预测方差, 从而减少了过度拟合。由于修剪已经降低了模型容量, 再训练的时候Dropout率应该更小。(Dropout率,这段大概理解了,但是Dropout还是要去仔细看一下)

量化, 令 C_{i}为第i层的参数个数 , C_{i_{0}}是原始网络的参数个数, C_{ir} 再训练后的网络的参数个数, N_{i} 是第i层中的神经元个数。由于Dropout对神经元起作用, 并且 Ci 与 i有一个正交关系?, 因此根据等式 1, 修剪后的Dropout率参数应遵循等式 2, 其中 Do 表示原始的Dropout率, Dr 表示在再训练后的Dropout率。
这里写图片描述

3.3 局部修剪与参数协同适应 (Local Pruning and Parameter Co-adaptation)

在再训练过程中,保留初始训练阶段幸存于修剪的权重比重新初始化修剪层的权重更好。CNNs具有脆弱的协同适应特征(co-adapted feature):梯度下降在初始训练的时候能找到优秀的解决方案,但在重新初始化一些层并且重新训练它们后不能。因此,当我们重新训练修剪后的层时,我们应该保留幸存的参数,而不是重新初始化它们。(意思应该是把之前幸存的参数作为预训练的值)

从保留的权重开始重新训练修剪后的层需要更少的计算,因为我们不需要通过整个网络反向传播。此外,随着网络的不断深入,神经网络更容易出现梯度消失的问题,这使得深度网络的剪枝误差难以恢复。(这里剪枝误差和网络深度还有梯度消失的关系不太明白)为了防止这种情况的发生,我们修复了CONV层的参数,并且在只修剪了FC层后才重新训练FC层,反之亦然。

3.4 迭代修剪

学习正确的连接是一个迭代的过程。修剪后再训练是一次迭代,经过多次这样的迭代之后,可以找到最小数的连接。在不损失精度的情况下,该方法可以将AlexNet上的剪枝率从5x提高到9x。每次迭代都是一个贪婪的搜索,因为我们可以找到更好的连接。我们也实验探索了基于参数绝对值的剪枝,但效果不好

3.5 修剪神经元

剪枝连接后,具有零输入连接或零输出连接的神经元可以安全地剪枝。这种修剪是通过去除与被修剪过的神经元之间的所有连接来进一步进行的。再训练阶段自动到达结果,死亡的神经元将没有输入和输出连接(好像是说这个神经元修剪的过程是在再训练的时候自动完成的)这是由于梯度下降和正则化造成的,具有零输入连接(或零输出连接)的神经元对最终损失没有贡献,从而导致其输出连接(或输入连接)的梯度分别为零。只有正则化项才能将权重推到零,因此,死亡的神经元将在再训练过程中被自动移除。

4 实验

剪枝阈值为一个质量参数(quality parameter)乘以一个层的权值的标准偏差(standard deviation of a layer's weights)

L1正则化在剪枝后直接比L2提供了更好的精度,因为它将更多的参数推近于零。然而,再训练后L2优于L1,因为进一步将值推向零没有任何好处。一个尝试是使用L1正则化进行剪枝,然后使用L2进行再训练,但这并没有击败在两个阶段简单地使用L2。一种模式中的参数不能很好的适应另一种模式。

最大的收益来自迭代修剪。
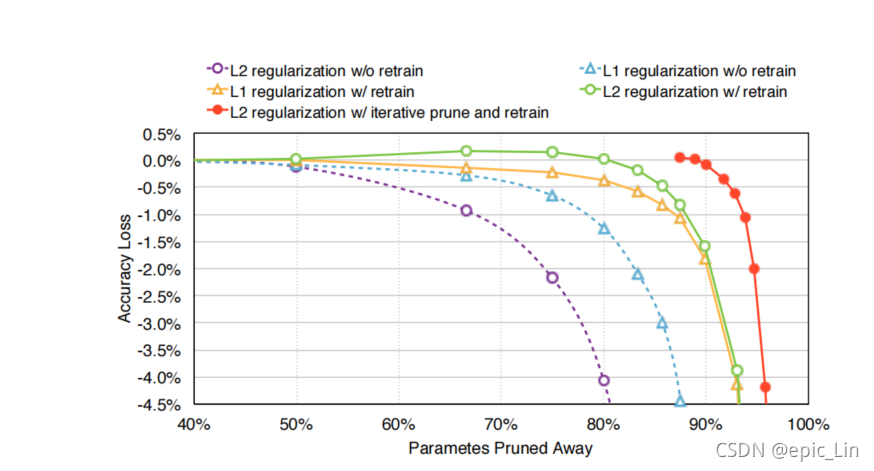
 有两个绿点的精度略高于原始模型,我们认为,这种精度的提高是由于修剪找到正确的网络容量,从而减少过拟合。

CONV层和FC层都可以被修剪,但灵敏度不同。下图显示了每一层对网络剪枝的敏感性。
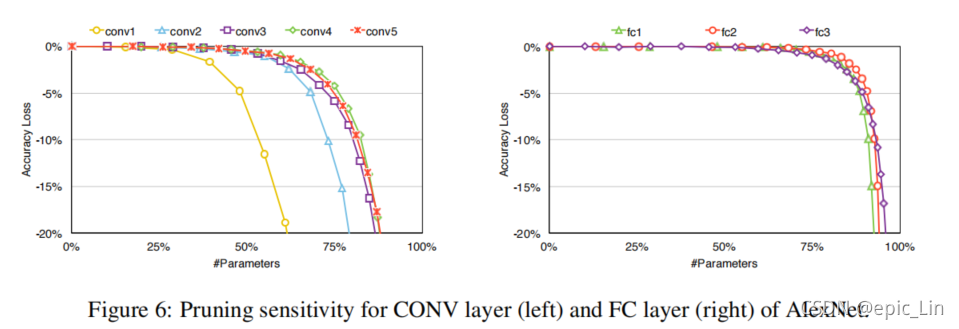
 CONV层比全连接层更敏感。第一个卷积层直接与输入图像相互作用,对修剪最为敏感。我们推测这种灵敏度是由于输入层只有3个通道,因此比其他卷积层的冗余更少。我们使用灵敏度结果来找到每个层的阈值:例如,最小的阈值被应用于最敏感的层,这就是第一个卷积层。

将修剪后的层存储为稀疏矩阵的开销仅为15.6%,存储相对索引而不是绝对索引可以将FC层索引所占用的空间减少到5位。类似的,CONV层索引只能用8位来表示。
 

修剪后,AlexNet和VGGNet的存储需求足够小,所有的权重可以存储在芯片上,而不是芯片外的DRAM,那需要更大数量级的能量来访问。 我们剪枝方法的目标是专门针对稀疏DNN(sparse DNN)的固定功能硬件,这给通用硬件的稀疏计算(sparse computation)带来了困难。

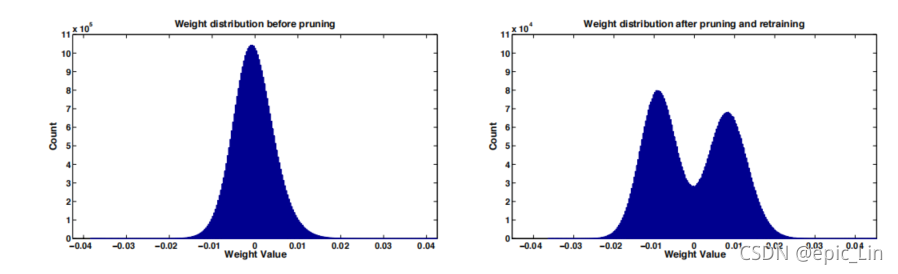
上图显示了修剪前(左)和修剪后(右)的权重分布的直方图。权重来自于AlexNet的第一层全连接层。这两个面板有不同的y轴尺度。最初的权重分布以零为中心,尾巴迅速下降。几乎所有的参数都在[−0.015,0.015]之间。修剪后,大的中心区域被删除。网络参数在再训练阶段对自己进行调整。结果表明,这些参数在[−0.025,0.025]之间形成了一个双峰分布,并在x轴上的分布更大。

6. 结论

我们提出了一种通过找到正确的连接来提高神经网络的能量和存储效率而不影响准确性的方法。

 这导致实时图像处理的内存容量和带宽需求更小,使其更容易部署在移动系统上。

fMRI脑影像特征提取——Pearson相关与低阶功能连接LOFC(dpabi+nilearn) 一个连接由节点和连接强度(边)组成。功能连接中的节点可以是单个体素,也可以是由脑图谱定义的脑区ROI。通常的做法是将脑图谱中多个或者全部ROI作为节点,或者是将脑图谱中单个ROI与全脑体素作为节点。定义连接强度(边),最常用的方式是Pearson相关,两个节点之间可能没有物理连接,但如果他们的BOLD信号同步性很强,则它们之间可能存在很强的功能上的协作,即很强的功能连接,这是一个很好的表征两个节点间关系的特征。 阅读详情

相关推荐

红外与可见光融合避坑指南:LLVIP数据集实测6大算法效果对比

本文基于专为弱光视觉设计的LLVIP数据集,对GTF、DenseFuse、FusionGAN、IFCNN等6种主流红外与可见光图像融合算法进行了深度实测与对比。通过客观指标与可视化分析,揭示了算法在极端弱光下易出现特征丢失的共性问题,并探讨了融合图像对下游目标检测任务的实际增益,为工程选型与算法调优提供了实用指南。

weixin_29092031的博客 439

模型剪枝一:Learning both Weights and Connections for Efficient Neural Networks

论文:https://arxiv.org/abs/1506.02626

cdknight_happy的专栏 1968

Word论文插入带有方括号序号的参考文献——尾注+交叉引用

文章目录1. 尾注功能2. 为参考文献的序号添加方括号3. 调整参考文献前的序号大小4. 重复引用同一参考文献5. 将交叉引用的序号改为带有方括号的上标序号格式6. 删除参考文献前的尾注横线 1. 尾注功能 首先使用尾注功能顺序插入参考文献,暂时不考虑方括号问题,具体操作如下: ① 将光标放在需要插入参考文献角标的地方 ② 在word菜单栏,“引用-脚注部分右下角箭头”(用来设置尾注格式) ③如...

Your_Raymond的博客 9万+

Learning both Weights and Connections for Efficient Neural Networks 论文pytorch复现

Learning both Weights and Connections for Efficient Neural Networks 论文pytorch复现 这是论文中主要的步骤,因此我们复现的时候也主要是利用这个思想。 代码编写需要两个主要部分,首先原来神经网络的训练,然后就是神经网络的裁剪。我这次实验主要是使用论文中说的Lenet-300-100网络来进行测试。 网络的定义以及初次训练 ##############先导入需要的包############################### impo

Wandering的博客 1164

汽车诊断服务(UDS——0x11服务解析)

ECU复位服务(0x11)详解:该服务支持硬件/钥匙开关/软件三种复位类型(0x01-0x03),复位前需发送肯定响应。请求格式为11+子功能,响应含51+子功能。典型应用需配合安全访问流程,测试时需监控CAN总线通信及DTC状态。复位后ECU将返回默认会话,期间不处理任何诊断请求。服务在编程会话且安全解锁后执行,硬复位会初始化存储数据。

从事汽车行业 979

x2-DFD:A framework for explainable and explainable deepfake detection

该文章提出了X2-DFD框架,用于可解释和可扩展的深度伪造检测。通过评估大型多模态语言模型(MLLMs)在深度伪造检测中的内在能力,发现它们在不同伪造相关特征上的有效性各异。基于此,实施了针对性的微调策略,显著提高了MLLMs的解释能力,并整合了外部深度伪造检测器(EDDs),以结合MLLMs和传统检测器的互补优势,实现更好的检测和解释。

志在山顶的人,不会贪念山腰的风景 510

Learning both Weights and Connections for Efficient Neural Networks

Learning both Weights and Connections for Efficient Neural Networks 摘要 神经网络是计算密集型和内存密集型的,这使得它们很难部署在嵌入式系统上。此外,传统的网络在训练开始前就确定了架构;因此,训练不能改善网络结构。为了解决这些限制,我们提出了一种方法,通过只学习重要的连接参数,来减少存储和计算所需的神经网络数量级,而不影响其准确性。我们的方法使用三步方法删除冗余连接。首先,我们训练网络了解哪些连接是重要的。接下来,我们修剪不重要连接。最后

Wandering的博客 2186

【MATLAB代码】UKF组合导航例程,15维状态量、3维观测量。附完整的代码,有中文注释、误差输出图像

摘要 本文提出了一种基于15维误差状态模型的UKF组合导航算法,实现了三维位置、速度和姿态的高精度估计。算法采用严格的误差状态模型,包含位置(3)、速度(3)、姿态(3)、陀螺偏差(3)和加速度计偏差(3)共15个状态量,通过3维GNSS位置观测进行校正。仿真结果表明,相比纯IMU积分,UKF算法能有效抑制误差积累,显著提高导航精度。文中提供了完整的MATLAB源代码,可直接运行并复现三维轨迹对比、位置/速度曲线及误差分析结果。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 312

韩松老师模型压缩--三步剪枝法学习笔记

Learning both Weights and Connections for Efficient Neural Networks神经网络是计算密集型和内存密集型的,因此很难在嵌入式系统上部署。此外,传统网络在训练开始前修复架构;因此,培训无法改善架构。为了解决这些局限性,我们描述了一种方法,通过只学习重要的连接,在不影响其准确性的情况下,将神经网络所需的存储和计算减少一个数量级。我们的方法使用三步方法修剪冗余连接。首先,我们训练网络以了解哪些连接是重要的。接下来,我们删减不重要的连接。最后,我们重新训

charles_zhang_的博客 1380

万字详解YOLOv8网络结构Backbone/neck/head以及Conv、Bottleneck、C2f、SPPF、Detect等模块

YOLOv8是由Ultralytics开发的最先进的目标检测模型,推升了速度、准确性和用户友好性的界限。YOLO这一缩写代表“你只看一次”(You Only Look Once),通过在一次网络传递中同时预测所有边界框,提升了算法的效率和实时处理能力。相比之下,其他一些目标检测技术需要经过多个阶段或过程来完成检测。YOLOv8在流行的YOLOv5架构上进行了扩展,在多个方面提供了改进。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 14万+

基于SAGE算法的宽带信道参数估计算法的MATLAB仿真

本文将介绍如何使用MATLAB进行SAGE算法的仿真,以便更好地理解和应用该算法。SAGE算法是一种基于最大期望(Expectation-Maximization)方法的迭代估计算法,用于估计未知的参数。在宽带信道参数估计中,SAGE算法通过迭代优化来估计信道的传输函数。总结起来,本文介绍了如何使用MATLAB进行基于SAGE算法的宽带信道参数提取算法的仿真。通过以上步骤,我们可以得到估计的信道响应,并与真实信道响应进行比较。此外,SAGE算法还可以与其他信道估计算法相结合,以提高估计的准确性和性能。

CodeRoarX的博客 1075

(精读论文)剪枝Learning both Weights and Connections for Efficient Neural Networks

神经网络是计算密集型和内存密集型的,这使得它们很难部署在嵌入式系统上。此外,传统的网络在培训开始前就已经确定了架构;因此,培训不能改善体系结构。为了解决这些限制,我们描述了一种方法,通过只学习重要的连接,在不影响神经网络准确性的情况下,将神经网络所需的存储和计算量减少一个数量级。我们的方法使用三步法去除冗余连接。首先,我们训练这个网络,让它知道哪些连接是重要的。接下来,我们删除不重要的连接。最后,我们重新训练网络来微调剩余连接的权值。

RuanJianNB的博客 357

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

论文品读:Learning both Weights and Connections for Efficient Neural Networks

https://arxiv.org/abs/1506.02626v3 这是一篇关于模型压缩的15年文章,到目前为止(18年11月)有450的被引 文章介绍了一种参数剪枝(weights pruning)方法,应该算是最基础的一种方法了,直接按照参数是否大于某个阈值来判断哪些参数是重要的,哪些参数是不重要。文章主要目的是想要压缩模型大小后将模型运行在能耗更小的内部SRAM里,在速度提升上文章没有...

hsqyc的博客 5055

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

论文 - Learning both Weights and Connections for Efficient Neural Networks

Han Song的Deep Compression是模型压缩方面很重要的论文。在Deep Compression中,作者提出了三个步骤来进行模型压缩:剪枝,量化和霍夫曼编码。其中,剪枝对应的方法就是基于本文要总结的这篇论文:Learning both Weights and Connections for Efficient Neural Networks。在这篇论文中,作者介绍了如何在不...

行云 934

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

论文复现:Learning both Weights and Connections for Efficient Neural Networks

论文复现:Learning both Weights and Connections for Efficient Neural Networks

qq_28094537的博客 1085

《Learning both Weights and Connections for Efficient Neural Networks》论文笔记

1. 论文思想 深度神经网络在计算与存储上都是密集的,这就妨碍了其在嵌入式设备上的运用。为了解决该问题,便需要对模型进行剪枝。在本文中按照网络量级的排序,使得通过只学习重要的网络连接在不影响精度的情况下减少存储与计算量。论文中的方法分为三步:首先,使用常规方法训练模型;使用剪枝策略进行模型修剪;在修剪模型的基础上进行finetune。经过试验证明改文章提出的方法使得AlexNet的大小减小了9倍...

m_buddy的博客 550

论文笔记_Learning both Weights and Connections for Efficient Neural Networks

这篇论文是韩松大佬的文章,开始膜拜吧! 文章目录摘要1.介绍2.相关工作3.Learning Connections in Addition to Weights3.1正则化3.2 调整Dropout ratio3.3局部剪枝和参数共适应3.4迭代剪枝3.5修剪神经元4.实验结果 摘要   神经网络既是计算密集型的,也是存储密集型的,这两个特点导致其无法在嵌入式设备上部署使用。另外,卷积神经网络在...

maqian5的博客 808

【Learning both Weights and Connections for Efficient Neural Networks】论文笔记

追随Song Han大神的第一篇网络压缩论文(NIPS’15),论文链接:https://arxiv.org/abs/1506.02626 网络权重参数修剪的基础篇。 效果: 作者用了4个网络实验 Lenet-300-100, pruning reduces the number of weights by 12× Lenet-5, pruning reduces the number of we...

我是一只比菜鸟还菜的菜鸟! 3859

Learning both Weights and Connections for Efficient Neural Networks 论文进一步的实验与思考

Learning both Weights and Connections for Efficient Neural Networks 论文进一步的实验与思考 上一篇文章我实验了net-300-100网络去识别手写数字体,通过剪枝发现,每一次的激活神经元个数没有明显的变化,而且每次都要激活50%左右,同时浅层的权重可以被大量的剪枝掉,最后只剩下300多个,下面我们就做一个实验,把第一层的个数增加到600个神经元,看看相应的实验结果 net-600-100 实验 下面就是基于以上的代码,使用手写数字体的数据集

Wandering的博客 484

《Learning both Weights and Connections for Efficient Neural Networks》阅读笔记

参考链接:https://xmfbit.github.io/2018/03/14/paper-network-prune-hansong/ 主要思想: 作者的方法分为三个步骤: Train Connectivity: 按照正常方法训练初始模型。作者认为该模型中权重的大小表征了其重要程度 Prune Connection: 将初始模型中那些低于某个阈值的的权重参数置成0(即所谓剪枝) Re-Tra...

tsq292978891的博客 681

深度网络推理加速(Learning both Weights and Connections for Efficient Neural Networks)

摘要 针对卷积神经网络的结构在训练之前就已经被固定下来,因而训练过程无法优化网络结构,本文提出了一种三步法在保留网络能力的前提下进行剪枝。首先,让网络在训练中学习到哪些连接是重要的;其次,对不重要的连接进行剪枝;最后,在剪枝后的网路欧上进行微调。用该方法对ImageNet数据的AlexNet和VGG-16网络进行优化,分别将模型减小了十倍左右,而没有损失精度。 下图是在45nm工艺的CMOS芯

ss_thbcr的博客 801

剪枝后 模型加速_论文分享|从零入门剪枝(一)

首发于公众号 TowardsDeeplearning 来自专辑 《从零入门剪枝系列》今天分享的论文是:Learning both Weights and Connections for Efficient Neural Networks。这篇论文是 Han Song 在模型压缩方面很重要的论文。论文介绍了通过 magnitude 来学习重要连接,方法主要包括三个部分:1.训练一个网络,学习哪个连...

weixin_39614561的博客 459

神经网络压缩(3):Learning both Weights and Connections for Efficient Neural Network

Learning both Weights and Connections for Efficient Neural NetworksAbstract 目的:减少存储量和计算量,使网络更适合在移动设备上运行 方法:简单地说是只学习重要的连接,修剪冗余的连接减少模型参数

cookie_234的博客 5515

Learning both Weights and Connections for Efficient Neural Network -- 论文笔记

这是2015年斯坦福和英伟达的一篇论文。1.简介:通过修剪训练后网络中的不重要连接(connections),来减少网络所需要的参数,减少内存和cpu的消耗,使网络更加适应在移动设备上运行。2.idea思想:1)首先训练整个网络,判断哪些是重要连接。2)修剪不重要的连接。3)重新训练修剪后的网络,微调保留下来的参数。3.达到的效果:1)在ImageNet上,减少了AlexNet 9倍的参数,从61

meanme的专栏 6822
上一篇: Entropy-based Pruning
下一篇: Learning Efficient Convolutional Networks through Network Slimming【译】
epic_Lin
博客等级 码龄5年 338粉丝 34原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值