


前言
亚马逊选品是跨境电商中技术含量最高的环节之一,但大多数开发者和技术团队在面对选品数据需求时,要么被订阅工具的功能边界所限制,要么低估了自建爬虫的维护成本。本文将从技术角度系统拆解亚马逊选品所需的数据架构,以及如何通过 Pangolinfo API 构建一套高效、可扩展的选品数据采集体系。
一、亚马逊选品的数据需求模型
1.1 五大数据层
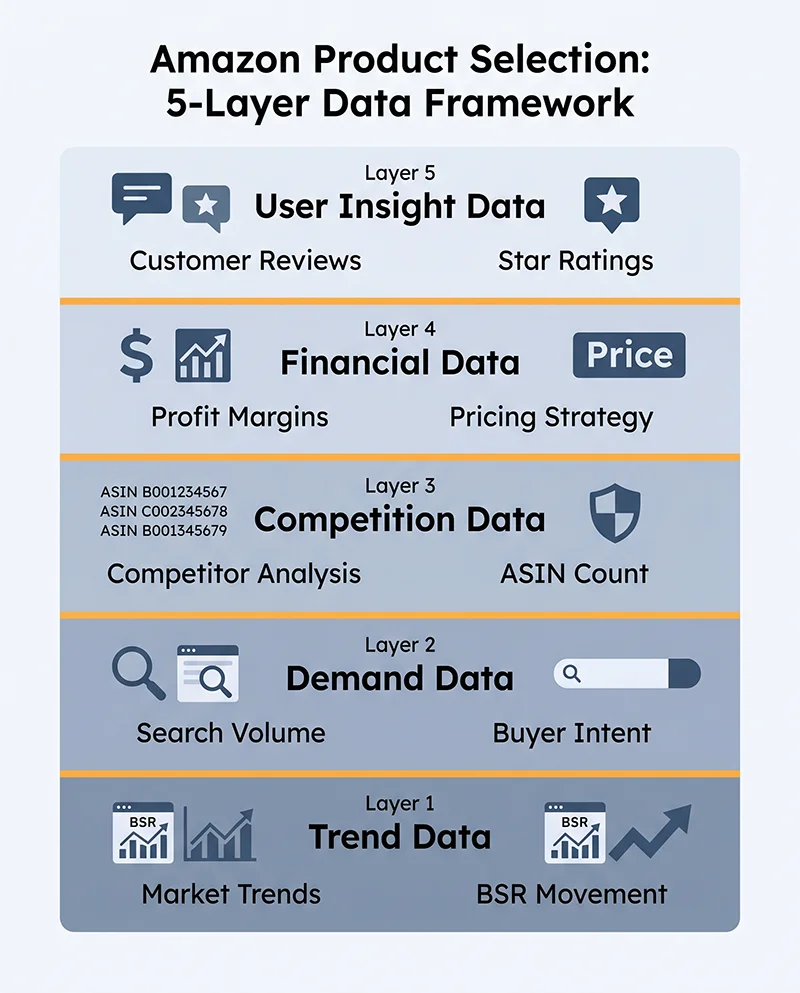
高质量亚马逊选品涉及五个核心数据层,每层的技术实现和采集频率要求各不相同:
| 数据层 | 核心字段 | 采集频率 | 技术难点 |
|---|---|---|---|
| 趋势层 | BSR 排名、Movers & Shakers 变化率 | 小时级 / 每日 | 高频采集下的 IP 池管理 |
| 需求层 | 搜索量趋势、价位分布、销量估算 | 每周 | ABA 数据的替代采集方案 |
| 竞争层 | ASIN 多维度数据、广告位分布 | 每日 | 广告位 JS 渲染采集 |
| 财务层 | 历史价格、FBA 费率、Coupon 活动 | 每日 | 历史数据时序存储 |
| 用户洞察层 | 评论全文、Q&A、Customer Says | 每周 / 月 | Customer Says 字段采集 |
1.2 数据质量分级
不同类型数据的准确性上限不同,这决定了它们在决策模型中的使用方式:
# 数据质量分级参考
DATA_QUALITY = {
    "price": {
        "accuracy": "HIGH",  # 直接从页面读取,几乎无误差
        "use_for": "financial_modeling"
    },
    "review_count": {
        "accuracy": "HIGH",
        "use_for": "competitive_velocity"
    },
    "bsr_rank": {
        "accuracy": "MEDIUM",  # 时间点准确,但波动性高
        "use_for": "trend_tracking"
    },
    "monthly_sales_estimate": {
        "accuracy": "LOW",  # 30-50% 误差率,模型推算
        "use_for": "directional_comparison_only"
    }
}
二、技术选型分析:三种数据获取路径的对比
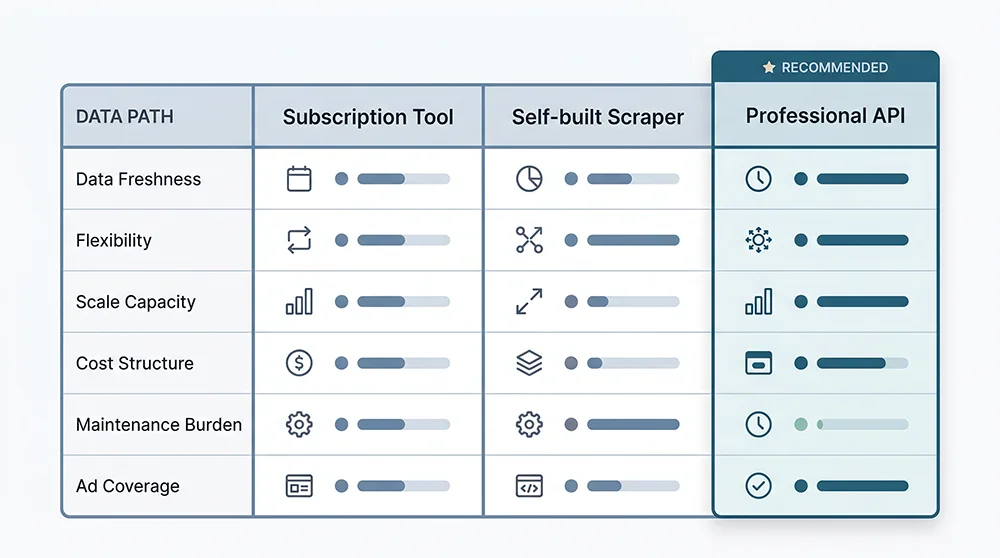
2.1 订阅工具 SDK
优点:开箱即用,文档完善
局限:数据有延迟(批量更新机制),字段固定无法定制,并发受限
2.2 自建爬虫
技术挑战列表:
- 亚马逊 TLS 指纹检测(需要真实浏览器环境或 TLS 模拟)
- 页面动态渲染(SP 广告位需要完整 JavaScript 执行)
- IP 封禁(单 IP 请求超过阈值后会遭遇 CAPTCHA 或封禁)
- 解析模板维护(亚马逊页面结构频繁更新)
- 规模化成本(代理 IP 成本 + 工程师维护成本远超预算)
2.3 专业数据 API(推荐架构)
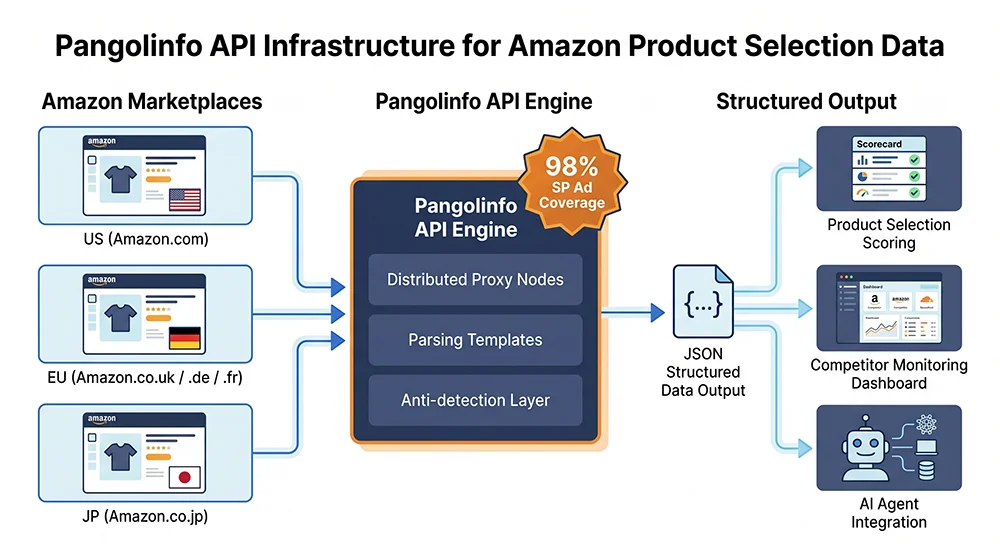
选品数据需求
     │
     ▼
Pangolinfo Scrape API ─── 实时数据采集引擎
     │                    ├─ 分布式代理 IP 池
     │                    ├─ 反反爬虫处理层
     │                    └─ 成熟解析模板库
     │
     ▼
结构化 JSON 响应
     │
     ├─ 存入时序数据库(历史趋势分析)
     ├─ 触发实时告警(价格异常、BSR 突变)
     └─ 输入分析模型(选品评分、竞品画像)
三、Pangolinfo API 核心接口实战
3.1 安装与认证
# 通过 HTTP 直接调用,无需 SDK 依赖
export PANGOLINFO_API_KEY="your_api_key_here"
3.2 采集 ASIN 产品详情
import requests
import json

class PangolinfASINScraper:
    """
    核心 ASIN 数据采集器
    支持:价格、评论、广告位、Customer Says、变体数据
    """

    def __init__(self, api_key: str):
        self.api_key = api_key
        self.base_url = "https://api.pangolinfo.com/v1"
        self.headers = {
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json"
        }

    def get_asin_detail(self, asin: str, marketplace: str = "amazon.com") -> dict:
        """
        采集 ASIN 完整产品详情

        Args:
            asin: 目标 ASIN,例如 "B08N5WRWNW"
            marketplace: 目标站点,例如 "amazon.com", "amazon.de", "amazon.co.jp"

        Returns:
            结构化 JSON 产品数据,包含价格、评论、BSR、变体信息
        """
        url = f"{self.base_url}/amazon/product"
        payload = {
            "asin": asin,
            "marketplace": marketplace,
            "fields": [
                "title", "price", "list_price", "coupon",
                "rating", "review_count", "bsr_rank",
                "category_path", "main_image", "images",
                "bullet_points", "description", "aplus_content",
                "variants", "seller_info", "fulfillment_type",
                "customer_says"  # Pangolinfo 独有:AI 评论摘要字段
            ]
        }

        response = requests.post(url, headers=self.headers, json=payload)
        response.raise_for_status()
        return response.json()

    def get_search_results_with_ads(
        self,
        keyword: str,
        marketplace: str = "amazon.com",
        zip_code: str = None  # 指定邮区采集
    ) -> dict:
        """
        采集关键词搜索页,包含 SP 广告位(98% 完整率)

        Args:
            keyword: 搜索关键词
            marketplace: 目标站点
            zip_code: 指定邮区(用于价格/配送差异分析)

        Returns:
            搜索结果数据,包含自然排名 + 广告位分布
        """
        url = f"{self.base_url}/amazon/search"
        payload = {
            "keyword": keyword,
            "marketplace": marketplace,
            "include_ads": True,  # 开启广告位采集
            "ad_types": ["sp_top", "sp_other", "sponsored_brand"],
        }

        if zip_code:
            payload["zip_code"] = zip_code

        response = requests.post(url, headers=self.headers, json=payload)
        response.raise_for_status()
        return response.json()

    def get_bsr_list(
        self,
        category_url: str,
        list_type: str = "best_sellers",  # "best_sellers" | "new_releases" | "movers_shakers"
        marketplace: str = "amazon.com"
    ) -> dict:
        """
        采集 BSR 榜单(支持 Best Sellers、New Releases、Movers & Shakers)

        Args:
            category_url: 品类榜单 URL
            list_type: 榜单类型
            marketplace: 目标站点

        Returns:
            完整榜单数据,包含所有 ASIN 和排名信息
        """
        url = f"{self.base_url}/amazon/bestsellers"
        payload = {
            "category_url": category_url,
            "list_type": list_type,
            "marketplace": marketplace,
            "max_items": 100  # 最大采集数量
        }

        response = requests.post(url, headers=self.headers, json=payload)
        response.raise_for_status()
        return response.json()


# 基础使用示例
scraper = PangolinfASINScraper(api_key="your_api_key")

# 1. 采集竞品 ASIN 详情
product_data = scraper.get_asin_detail("B08N5WRWNW", "amazon.com")
print(f"产品标题: {product_data['title']}")
print(f"当前价格: ${product_data['price']}")
print(f"BSR 排名: #{product_data['bsr_rank']['rank']} in {product_data['bsr_rank']['category']}")
print(f"Customer Says: {product_data.get('customer_says', 'N/A')}")

# 2. 采集关键词广告位分布
search_data = scraper.get_search_results_with_ads("wireless earbuds", "amazon.com")
ads = search_data.get("sponsored_results", [])
print(f"首位广告: {ads[0]['asin'] if ads else 'None'}")
print(f"广告总数: {len(ads)}")

# 3. 采集品类榜单
bsr_data = scraper.get_bsr_list(
    category_url="https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/",
    list_type="movers_shakers"
)
print(f"榜单产品数: {len(bsr_data['items'])}")
3.3 大批量异步采集(用于品类全量扫描)
import asyncio
import aiohttp
from typing import List

async def batch_collect_asins(
    asin_list: List[str],
    api_key: str,
    marketplace: str = "amazon.com",
    concurrency: int = 10
) -> List[dict]:
    """
    异步批量采集 ASIN 数据
    适用场景:全品类竞品监控、BSR 全量 ASIN 详情采集

    Args:
        asin_list: ASIN 列表
        api_key: Pangolinfo API Key
        concurrency: 并发数(建议 10-20)

    Returns:
        所有 ASIN 的结构化数据列表
    """
    semaphore = asyncio.Semaphore(concurrency)
    results = []

    async def fetch_asin(session: aiohttp.ClientSession, asin: str) -> dict:
        async with semaphore:
            url = "https://api.pangolinfo.com/v1/amazon/product"
            payload = {
                "asin": asin,
                "marketplace": marketplace,
                "fields": ["title", "price", "rating", "review_count", "bsr_rank"]
            }
            headers = {
                "Authorization": f"Bearer {api_key}",
                "Content-Type": "application/json"
            }

            async with session.post(url, headers=headers, json=payload) as resp:
                if resp.status == 200:
                    data = await resp.json()
                    data["_asin"] = asin
                    return data
                else:
                    print(f"Failed to fetch {asin}: HTTP {resp.status}")
                    return {"_asin": asin, "error": f"HTTP {resp.status}"}

    async with aiohttp.ClientSession() as session:
        tasks = [fetch_asin(session, asin) for asin in asin_list]
        results = await asyncio.gather(*tasks)

    return results


# 使用示例:每日全量竞品监控
async def daily_competitor_monitor():
    competitor_asins = [
        "B08N5WRWNW", "B09G9FPHY6", "B08C4KWM9T",
        # ... 可扩展到数千个 ASIN
    ]

    data = await batch_collect_asins(
        asin_list=competitor_asins,
        api_key="your_api_key",
        concurrency=20
    )

    # 存入数据库(建议带时间戳,支持历史趋势查询)
    for item in data:
        if "error" not in item:
            save_to_database(
                asin=item["_asin"],
                price=item.get("price"),
                rating=item.get("rating"),
                review_count=item.get("review_count"),
                bsr_rank=item.get("bsr_rank", {}).get("rank"),
                timestamp=datetime.now()
            )

    print(f"监控完成:{len([d for d in data if 'error' not in d])}/{len(data)} 成功")


# 运行
asyncio.run(daily_competitor_monitor())
3.4 评论数据采集与 NLP 分析流水线
import requests
from collections import Counter
import re

def collect_and_analyze_reviews(
    asin: str,
    api_key: str,
    max_reviews: int = 200,
    star_filter: int = None  # 1-5,None 表示全部
) -> dict:
    """
    采集竞品评论并提取高频痛点词

    Returns:
        {
            "total_collected": int,
            "negative_keywords": [("keyword", count), ...],
            "positive_keywords": [("keyword", count), ...],
            "use_case_mentions": [str, ...]
        }
    """
    # 通过 Pangolinfo Reviews Scraper API 采集评论
    url = "https://api.pangolinfo.com/v1/amazon/reviews"
    payload = {
        "asin": asin,
        "max_reviews": max_reviews,
        "star_rating": star_filter,  # 可指定只采集差评
        "include_body": True  # 采集完整评论文本
    }

    response = requests.post(
        url,
        headers={"Authorization": f"Bearer {api_key}"},
        json=payload
    )

    reviews = response.json().get("reviews", [])

    # 简单 NLP:提取高频名词短语(实际生产中可接入 spaCy 或 LLM)
    negative_reviews = [r for r in reviews if r.get("rating", 5) <= 2]
    positive_reviews = [r for r in reviews if r.get("rating", 1) >= 4]

    def extract_keywords(review_list: list) -> list:
        all_text = " ".join([r.get("body", "") for r in review_list]).lower()
        # 简化版关键词提取,实际应使用更成熟的 NLP 方案
        words = re.findall(r'\b[a-z]{4,}\b', all_text)
        stop_words = {"this", "that", "with", "have", "would", "could", "when", "they", "very"}
        filtered = [w for w in words if w not in stop_words]
        return Counter(filtered).most_common(20)

    return {
        "total_collected": len(reviews),
        "negative_keywords": extract_keywords(negative_reviews),
        "positive_keywords": extract_keywords(positive_reviews),
    }


# 使用示例
analysis = collect_and_analyze_reviews(
    asin="B08N5WRWNW",
    api_key="your_api_key",
    star_filter=2  # 只分析1-2星差评
)

print("差评高频词(产品痛点信号):")
for keyword, count in analysis["negative_keywords"][:10]:
    print(f"  '{keyword}': {count} 次")
四、数据存储与历史趋势架构建议
4.1 推荐数据库方案
-- 竞品 ASIN 历史数据表(PostgreSQL 示例)
CREATE TABLE asin_snapshots (
    id SERIAL PRIMARY KEY,
    asin VARCHAR(12) NOT NULL,
    marketplace VARCHAR(20) NOT NULL DEFAULT 'amazon.com',
    captured_at TIMESTAMP NOT NULL DEFAULT NOW(),

    -- 核心数据字段
    price DECIMAL(10,2),
    list_price DECIMAL(10,2),
    coupon_discount DECIMAL(5,2),
    rating DECIMAL(3,2),
    review_count INTEGER,
    bsr_rank INTEGER,
    bsr_category VARCHAR(200),

    -- 索引
    INDEX idx_asin_time (asin, captured_at DESC),
    INDEX idx_captured_at (captured_at)
);

-- 查询7日价格趋势
SELECT
    DATE(captured_at) as date,
    AVG(price) as avg_price,
    MIN(price) as min_price,
    MAX(price) as max_price
FROM asin_snapshots
WHERE asin = 'B08N5WRWNW'
  AND captured_at >= NOW() - INTERVAL '7 days'
GROUP BY DATE(captured_at)
ORDER BY date;
五、常见问题与解决方案
Q: 采集被亚马逊封禁怎么办?
A: 使用 Pangolinfo API 时,该问题由 API 服务商处理,不需要用户自行管理代理 IP 池。这是选择专业 API 服务的核心价值之一。
Q: Customer Says 字段有时为空怎么处理?
A: Customer Says 并非所有 ASIN 都有,亚马逊对部分品类的部分产品才会生成 AI 摘要。采集时做好 None 兜底处理即可。
Q: 如何判断采集到的广告位数据是否完整?
A: 参考 Pangolinfo 的广告位采集完整率指标(SP 广告位98%),对比同一关键词在不同时间段的广告位分布,异常偏低时可触发重采集。
Q: 多站点采集时如何统一化处理数据?
A: 建议在数据库层面以 (asin, marketplace) 作为联合主键,在分析层面按 marketplace 分组处理,不要混淆不同站点的价格和排名数据。
总结
构建专业的亚马逊选品数据体系,本质上是构建一套持续运行的市场感知基础设施。
核心技术选型建议:
- 数据采集:Pangolinfo Scrape API+ Reviews Scraper API
- 评论分析:spaCy / OpenAI API 做 NLP 处理
- 数据存储:PostgreSQL(历史时序)+ Redis(实时缓存)
- 自动化调度:Airflow / Celery Beat
如有技术问题欢迎评论区交流。
 405


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


