


最近我在公司负责的业务已经正式投入上线了,既然是线上环境,那么就需要保证其可用性。
我负责的业务其中就包括一个 Web Service,我需要保证 Service 的每个接口都是可用的,如果某个时间流量大了或者服务器挂掉了,那需要第一时间通知到我。
这时候可能我有这些需求:
1.定时测试和监控服务器每个接口是否是可用的,包括返回的数据、状态码是不是正确的。2.我可以随时查看到每个接口的响应时间、可用率等信息,最好是有可视化的图表呈现,一目了然。3.如果接口的错误率超过某一阈值一段时间,及时通知我,包括电话、短信或邮件。4.需要主动去监测接口的可用性,注意这里是主动监测而不是被动监测,不是等用户用的时候报错才提醒我。比如在没有用户用的时候,我也能及时知道每个接口的可用性。
其实,国内的一些服务商已经提供了这些功能,即主动型服务监控,比如「监控宝」,但我并不想用这些服务,一是需要额外花钱,二是数据上并不安全,三是我需要把我的服务集成到公司内部的监控体系下。
有了这些需求,我就结合公司内部现有的一些基础设施先确定一个技术选型,然后实施就好了。
目前公司内部使用的一套监控体系是基于 Kubernetes + Prometheus + Grafana + Alert Manager 的,那么基于我的需求来分析下我怎样利用这一套体系来搭建我想要的监控设施。
解决方案分析:
1.首先关于第四个需求比较特殊,现有的监控体系其实已经可以做到服务的被动监测,比如某个 Service 的 API 被调用了,那么相应的调用数据都会被汇总到 Prometheus 上面,Prometheus 里面会计算接口调用的可用率,如果一段时间内如果错误率超过一定阈值,那就报警,追错误的时候去查下 log 就好了。但其实这个不能做到主动监测,比如在凌晨三四点,当没有用户使用的时候,如果这时候服务器出现问题了,我也需要第一时间能知道,所以我需要有一个定时的主动监测程序来实时监测我的所有接口是否是可用的。要做到主动监控,那我一定需要一个接口监测程序定时运行并校验每个接口的结果,这里我选用的就是开源的 JMeter,它大多数情况下是被用来做压测的,但绝对能满足接口调用和检测的需求,只要我定时跑 JMeter 来检测就好了。2.关于第一个需求,我需要监测我的每个接口都是可用的,包括返回的数据也需要是想要的结果。这时候我们可能想到直接跑一些 test case 之类的,但这些其实大多数都是在部署或运行时校验的,如果我要实时跑或者 test case 有 update 了,也不太方便。另外为了写接口测试的时候,如果没有现成的工具,我们可能得写一堆代码,每个接口都写一个,包括 GET 请求的 URL 参数、POST 请求的 Body 信息等等,然后校验接口的返回结果是不是对的,也太麻烦了。所以我们需要找到一个可用的工具来帮助我们快速地完成这些功能。所以,我选择的 JMeter 也提供了可视化界面,我只需要配置一些接口和参数即可,另外它还带有定时器、断言、动态参数、多线程等功能,这样我们也可以做到并发测试、随机等待、动态构造请求参数、返回结果判断等功能了。3.其次再说第二个和第三个需求,其实用现有的 Prometheus + Grafana 就能解决了,这里最关键的则是我的接口监控结果能发给 Prometheus 才行。既然我选用了 JMeter,那么我怎样把 JMeter 的数据发送给 Prometheus 呢?这里需要借助于 JMeter 的一个插件 jmeter-prometheus-plugin,https://github.com/johrstrom/jmeter-prometheus-plugin,利用它就能将 JMeter 变成一个 Data Exporter,Prometheus 来抓取就好了。
所以,综上所述,我利用的一套服务监控体系就是 JMeter + Kubernetes + Prometheus + Grafana + Alert Manager,那么就开干吧。
这里先放一张图,看下最终的监控 Grafana 面板吧:

监控面板
这里一些接口的名称和 URL 我就打码了,这里我可以在 Grafana 中每时每刻都看到每个接口的可用率、响应(包括平均、最快、最慢)时间、状态码等信息,这些信息就是 JMeter 定时检测得到的结果,监控数据转到 Prometheus 里面然后经过 Grafana 可视化出来,并能通过一些指标来实现报警机制。
感兴趣的话,可以继续往下看哈。
为了达成这些功能,我需要解决如下问题:
•如何使用 JMeter 来测试每个接口的使用情况。•JMeter 如何和 Prometheus 对接起来,即如何集成 jmeter-prometheus-plugin 到 JMeter。•JMeter 怎样去部署,部署到哪里。•可视化数据怎样来呈现。•错误状态怎样来快速查看。•出错通知如何实现,比如打电话、发邮件等等。
下面我们就来一个个总结说一下。
由于内容比较多,整个流程我实践下来然后测试通总共花了两天左右的时间,在这里就不完全展开说了,只提关键点了。
JMeter 测试
第一步那就是用 JMeter 来完成接口的测试了,接口的调用形式肯定都有相应的规范的,比如 GET 请求设置啥参数,POST 请求发送什么数据,我们利用 JMeter 都能方便地配置。
JMeter 是有 GUI 的,我们在编写的时候在 GUI 里面设置就好了,界面样例如下所示:
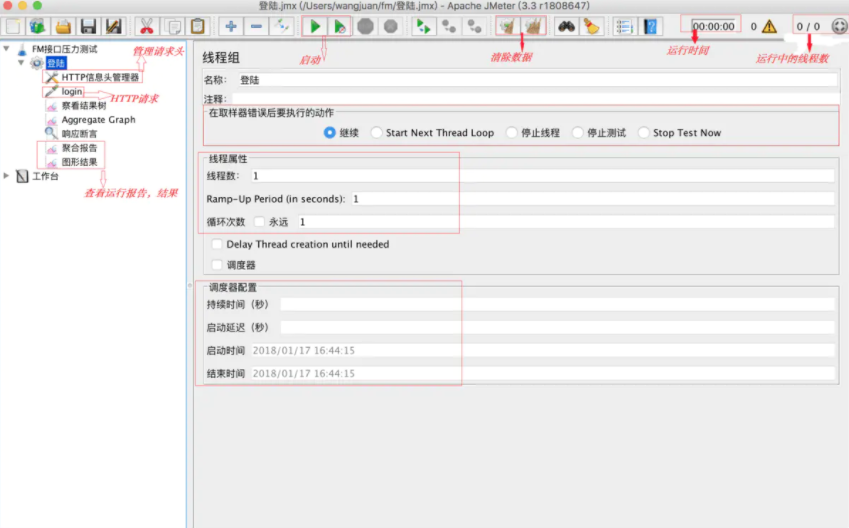
JMeter界面(图源:https://www.jianshu.com/p/0349441da3c4)
这里提示几点可能用到的东西:
•动态参数,JMeter 里面是支持动态参数设置的,比如循环测试 id 从 1 到 100,或者动态 POST 的数据替换,都是可以做到的,这个可以满足你花样测试接口的需求。•定时器,JMeter 里面有很多 Timer,可以设置各种各样的延时操作,比如每 3 分钟测一次,随机等待多少秒测一次都行。•断言,测试了接口之后,我们不仅要知道是否是可用的,同时也要判断其结果是不是正确的,如果返回状态码是正确的但是结果不对,那也白搭,所以可以使用断言来检查返回结果。
关于 JMeter 的功能这里就不再展开讲了,反正几乎你想实现的任何测试功能都可以实现,具体的用法可以参考 JMeter 的官方文档:https://jmeter.apache.org/usermanual/get-started.html。
嗯,写好了之后,可以用 JMeter 在本地进行测试,测试好了时候,可以把 JMeter 的这个 Test Plan 存成一个 jmx 文件,留作后面备用。
对接 Prometheus
接下来就是如何把数据对接到 Prometheus 里面了。
默认情况下,JMeter 是能导出数据到诸如 InfluxDB 这样的数据库的,借助于它自带的 Listener 即可实现。它并不带导出到 Prometheus 的功能。
这里我们就需要借助于 jmeter-prometheus-plugin 这个插件了,其 GitHub 地址是 https://github.com/johrstrom/jmeter-prometheus-plugin,具体的用法可以参考其官方说明。
这里提示几点:
•jmeter-prometheus-plugin 安装的时候把 jar 文件放到 JMeter 目录下就好了,jar 文件可以直接看这里下载:https://github.com/johrstrom/jmeter-prometheus-plugin#programatically。•安装好这个插件之后,需要增加一个 Listener,然后配置各种导出字段和参数,可以参考这个 jmx 文件的配置:https://github.com/johrstrom/jmeter-prometheus-plugin/blob/master/docs/examples/simple_prometheus_example.jmx,可以把这个 jmx 打开,然后把 Listener 拷贝到你的 Test Plan 即可。•jmeter-prometheus-plugin 这个插件会把 JMeter 变成一个 Data Exporter,而不是通过 Prometheus Push Gateway 来主动推送监控信息,所以它会在本地启动一个端口,默认是 9270。
Listener 的配置示例如图所示:
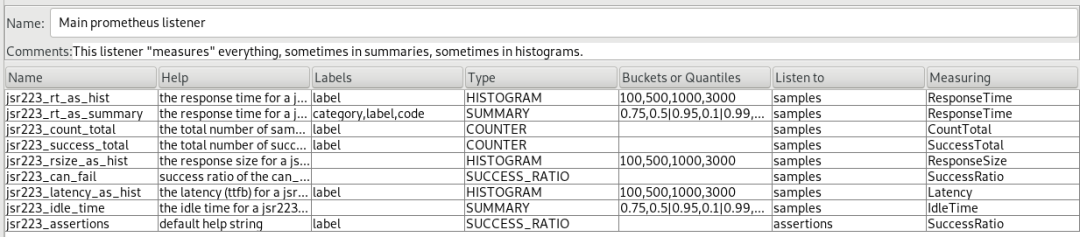
JMeter Listener
这里字段名如 jsr223_rt_as_summary 可以自行修改,比如这里我就统一修改为了 jmeter_test_xxx 这样的字段。
配置完成之后,运行 JMeter 之后,我们就能在 http://localhost:9270 上看到 Exporter 的信息,如图所示:
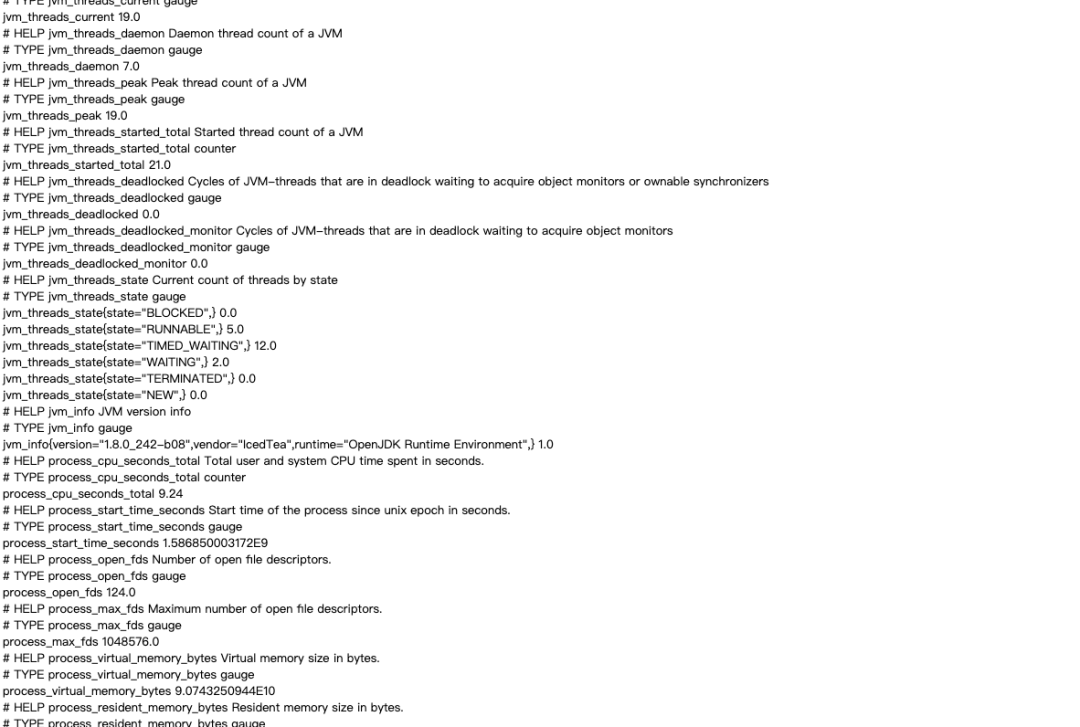
Exporter
这里面就包含了 JMeter 的一些接口测试结果,包括成功次数、失败次数、状态码等等,另外还有 JVM、处理器等各种环境信息。
部署之后把对应的 URL 交由 Prometheus 就可以把监控数据收集到 Prometheus 里面了。
部署 JMeter
完成上述两步,我们就能成功测试 Service 的每个接口并能生成测试结果的 Exporter 了。
那么 JMeter 写好了,怎么来部署呢?可以用 crontab,放某台服务器上,不过这里最理想的方式当然是部署到 Kubernetes 里面了。
这里就需要把 JMeter 打包成一个镜像了,GitHub 找来找去没找到几个合适的,另外也没有把 jmeter-prometheus-plugin 包括进去,那只有自己来了。
我基于 https://github.com/justb4/docker-jmeter 进行了二次改写,最后打包了一个镜像,已经开源了,地址为:https://github.com/Germey/JMeterMonitor,镜像名称为 germey/jmeter,这里就不再展开讲细节了,有点复杂。
运行所需要的 docker-compose 文件如下:
version: '3'
services:
  jmeter:
    restart: always
    image: 'germey/jmeter'
    volumes:
      - ./jmx:/app
    command:
      - sample.jmx
    ports:
      - "80:80"
这里我把本地的 jmx 文件夹 mount 到了 Docker 的 app 文件夹,所以这里在运行时需要在项目文件夹下新建 jmx 文件夹,用于存放 jmx 文件,把刚才写好的 jmx 文件放过来就好了。
另外 command 就是 jmx 文件的名称,这里需要修改成你的 jmx 文件。
另外部署到 Kubernetes 的话可以参考这里的 yml 文件:https://github.com/Germey/JMeterMonitor/tree/master/kubernetes。
Prometheus 收集数据
在成功部署 JMeter 之后呢,它肯定会提供一个 Web Service 来暴露 JMeter 的测试数据。
如果部署好了 Prometheus 之后,可以把它放在 Prometheus 的 scrape_configs,比如 Service 的 URL 为 jmeter-monitor.com,可以修改 prometheus.yml:
global:
  scrape_interval:     15s # By default, scrape targets every 15 seconds.

  # Attach these labels to any time series or alerts when communicating with
  # external systems (federation, remote storage, Alertmanager).
  external_labels:
    monitor: 'codelab-monitor'

# A scrape configuration containing exactly one endpoint to scrape:
# Here it's Prometheus itself.
scrape_configs:
  # The job name is added as a label `job=<job_name>` to any timeseries scraped from this config.
  - job_name: 'jmeter-monitor'

    # Override the global default and scrape targets from this job every 5 seconds.
    scrape_interval: 5s

    static_configs:
      - targets: ['jmeter-monitor.com']
其具体的配置字段可以参见:https://prometheus.io/docs/prometheus/latest/configuration/configuration/。
另外呢,这种方式其实并不怎么好,修改 Prometheus 挺麻烦的,推荐使用 Helm + Prometheus-Operator 来安装 Prometheus,然后修改 values.yml 即可修改配置文件了,比如修改 https://github.com/helm/charts/blob/master/stable/prometheus-operator/values.yaml 里面的 additionalScrapeConfigs 即可。
Grafana 可视化
Prometheus 收集完数据之后,我们可以将其可视化出来了。
比如这里有些字段,jmeter_test_can_fail_success 代表成功请求的次数,jmeter_test_can_fail_total 代表总的测试次数。
那么就可以用一个表达式来计算 Error Rate 了:
1- jmeter_test_can_fail_success{instance="$instance"} / jmeter_test_can_fail_total{instance="$instance"}效果如下:
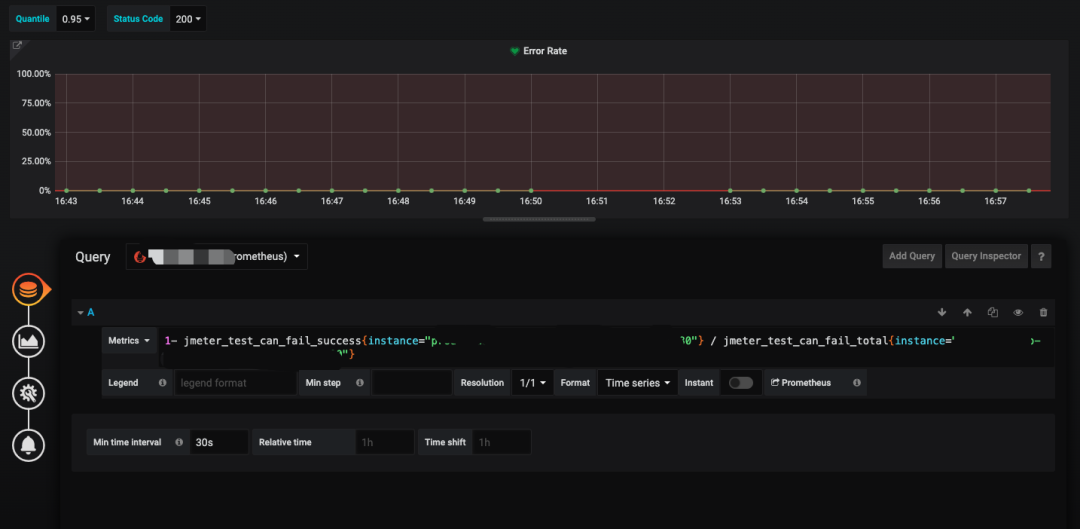
配置面板
这里就能实时可视化展示出来错误率了,更多的一些配置可以自行修改这些表达式进行定制。
最后我配置成的一些监控面板如下所示:
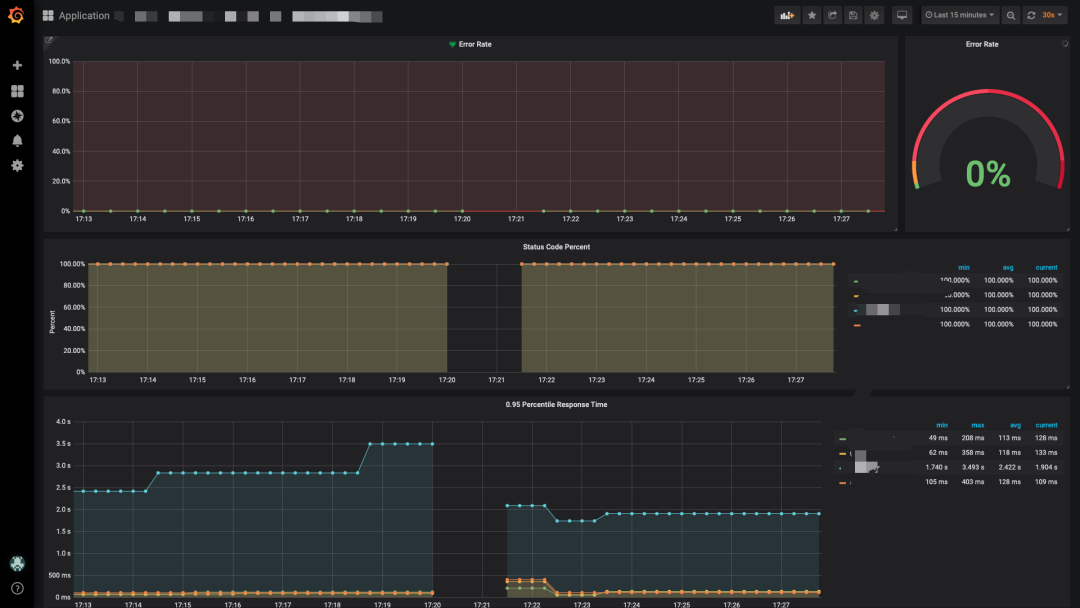
监控面板
这样我要是什么时候想看 Service 接口的情况,随时上来看就好了。
报警
对于报警来说,可以使用两种方式配置,一个是直接使用 Grafana 自带的报警机制,另外是可以通过 Alert Manager,后者功能更加强大,推荐使用后者。
对于 Alert Manager 来说,其监控的规则这里推荐使用 Prometheus-Operator 里面自带的 PrometheusRule 来实现,比如可以定义这么一个 PrometheusRule:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  labels:
    app: monitor
  name: monitor-rules
spec:
  groups:
  - name: monitor
    rules:
    - alert: ServiceErroring
      labels:
        severity: warning
      annotations:
        message: Service 连续5分钟错误率过高。
      expr: |
        avg(1- jmeter_test_can_fail_success{job="service-monitor"} / jmeter_test_can_fail_total{job="service-monitor"}) > 0
      for: 5m
这样配置好一个 PrometheusRule 之后,Prometheus 会自动应用这个 Rule 然后监控。
报警方式的话可以通过配置 Alert Manger 的 Receiver 来实现,包括打电话、邮件、短信等等,配置规则可以见:https://prometheus.io/docs/alerting/configuration/。
目前我是利用了组内已经提供的报警机制,组内已经对接好了电话、短信、邮件报警,并可以把每个人的信息进行管理和分组,然后应用到某个报警规则里面,这样一旦有问题,就可以实现报警啦。
另外对于一些规则的管理,我们可以使用一些开源的 Dashboard 来管理,如 Krama,https://github.com/prymitive/karma,利用它我们可以方便配置、禁用和筛选一些报警规则,界面如下:
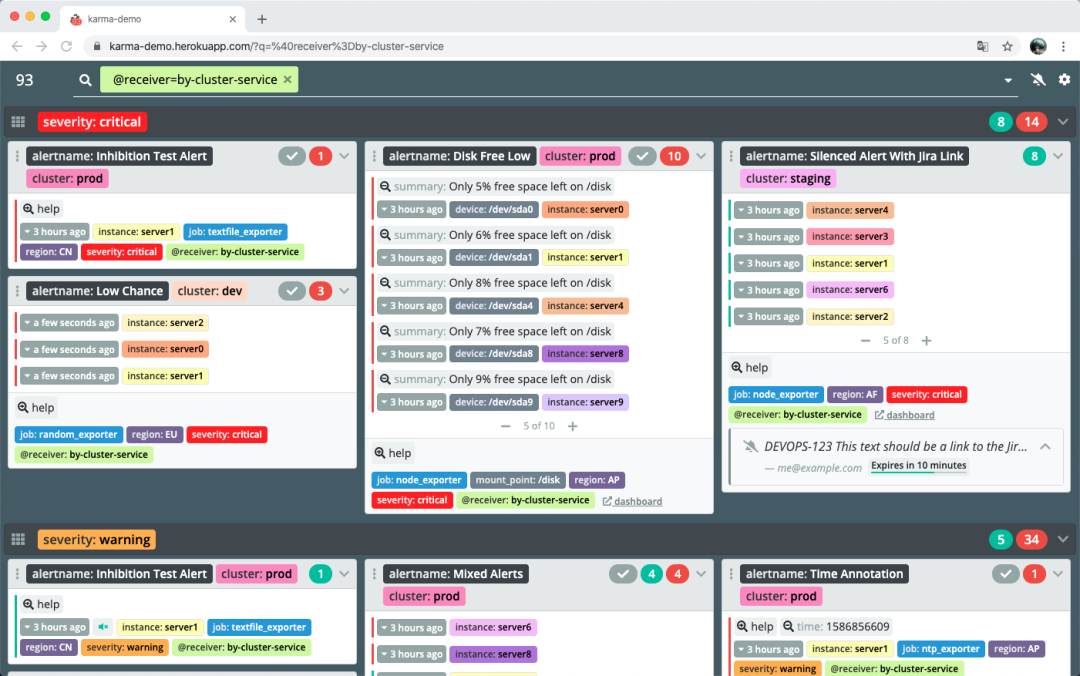
Krama
不过公司内部已经实现了一套了,对接了公司的员工账号,更加方便,所以我就没有再用这个了。
定时重启
这里另外遇到了一个问题,就是 JMeter 导出的监控数据是不断累积的,而监控的数据则是需要监控最近几分钟的数据,这样一旦发生了 Error,那么 Error Rate 由于历史数据的原因,在服务恢复之后永远不会降为 0,这就导致一些问题。另外如果 JMeter 如果一直运行,其占用的内存会越来越大。
所以一个最好的方式就是定时将 JMeter 重启,这样可以定时清空历史监控数据,保证在新的一段时间内测试获取到最近的监控数据,而不是混杂历史数据。
这里重启就可以利用 Kubernetes 的 Cronjob,比如我们可以每隔 10 分钟让 JMeter 重启一次,类似配置如下:
apiVersion: batch/v1beta1
kind: CronJob
metadata:
  name: jmeter-monitor
spec:
  successfulJobsHistoryLimit: 0
  failedJobsHistoryLimit: 0
  concurrencyPolicy: Replace
  schedule: "*/10 * * * *"
  jobTemplate:
    spec:
      template:
        metadata:
          labels:
            service: jmeter-monitor
        spec:
          containers:
            - args:
                - jmeter-monitor.jmx
              image: germey/jmeter:1
              name: jmeter-monitor
              volumeMounts:
                - mountPath: /app
                  name: jmeter-storage
              ports:
                - containerPort: 80
              imagePullPolicy: IfNotPresent
              resources:
                requests:
                  memory: "4Gi"
                  cpu: "250m"
                limits:
                  memory: "4Gi"
                  cpu: "250m"
          restartPolicy: OnFailure
          volumes:
            - name: jmeter-storage
              persistentVolumeClaim:
                claimName: jmeter
这里有几个地方值得注意:
•一个是 concurrencyPolicy,这里配置为 Replace,意思是重启后新建的 Pod 会替换原来的 Pod,保证 JMeter 的 Pod 只有一个。•另外一个是 imagePullPolicy 配置为 IfNotPresent,这样可以每次重启的时候不用重新拉镜像。
这样的话,就能避免发生错误的时候 Error Rate 无法降为 0 的状态了。
好了,到此为止呢,我们就介绍完了使用 JMeter + Kubernetes + Prometheus + Grafana + Alert Manager 进行监控的整体思路了,希望对大家有帮助。
另外由于内容比较多,这里很多地方没有展开讲解,比如 JMeter 的配置、Grafana 的配置、Prometheus-Operator 的配置、Alert Manager 的配置等等,不知道大家感不感兴趣,如果感兴趣的话,后面可以继续深入写一个小系列来讲解哈。
作者:华为云享专家 崔庆才静觅


 478


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


