大模型上下文窗口:Token 预算、性能瓶颈与 RAG 的关系

大模型上下文窗口真相:200K够用,关键在工程优化 大模型的上下文窗口是衡量长文本处理能力的基础技术指标,其原理受限于注意力机制复杂度、KV Cache显存开销与推理延迟的非线性增长。当前主流商用模型如Claude 3.5 Sonnet、GPT-4 Turbo实际稳定支持200K以内token,所谓‘100万上下文’尚属实验性能力,工程落地中面临性能断崖、成本激增与API拒绝等现实瓶颈。技术价值不在于盲目堆叠长度,而在于通过语义切片、RAG增强、上下文压缩等工程手段提升信息密度与任务完成率。典型应用场景包括法律合同比对、多轮客服状态追踪、代码库跨文件分析等— 阅读详情

上下文窗口是什么

大模型每次生成回答时,只能处理有限数量的 Token。这个范围就是上下文窗口。它通常要同时容纳系统指令、用户问题、对话历史、RAG 证据、工具定义、工具结果以及模型输出。

不同 API 对输入上限、最大输出和内部推理 Token 的计算方式可能不同,使用时应查看对应模型的官方说明,不能只记住一个“总长度”数字。
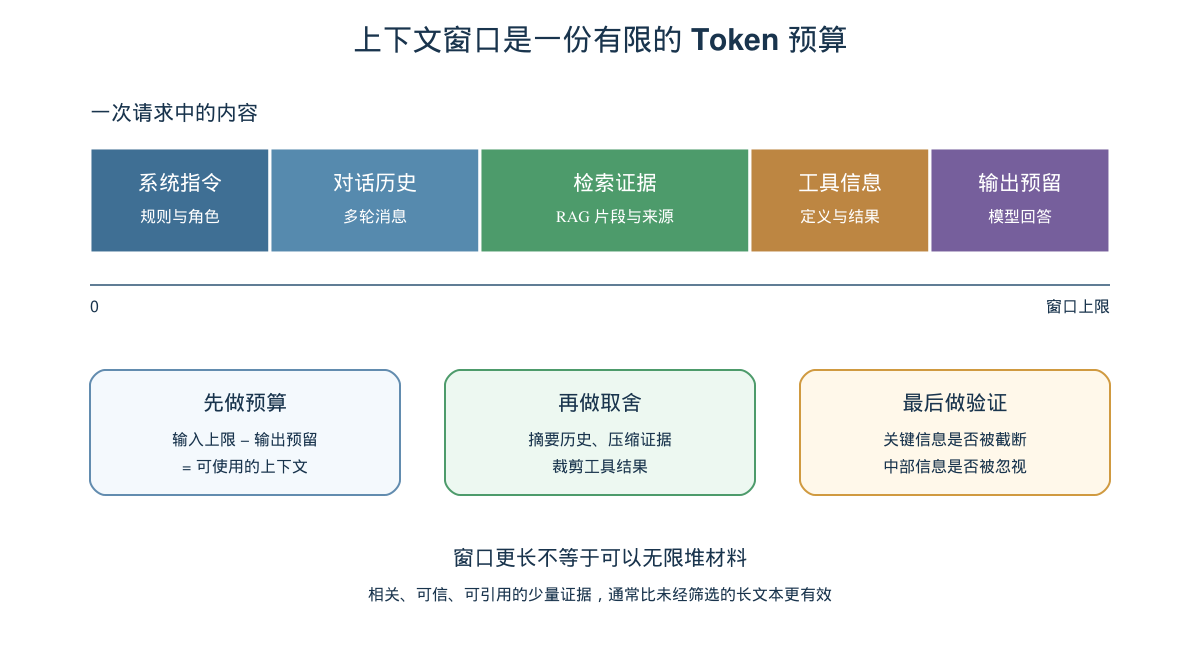
在这里插入图片描述

Token 不是字符。一个英文单词可能由一个或多个 Token 构成,中文字符、标点、代码和空格也会按分词器规则组合。最可靠的做法是使用模型对应的 tokenizer 实际计算。

大模型并不会自动记住上一轮

多数聊天 API 的模型调用是无状态的。界面看起来像连续对话,是因为应用在每次请求时重新发送必要的历史消息:

{
  "messages": [
    {"role": "system", "content": "你是一名技术助手"},
    {"role": "user", "content": "我使用的是 Linux"},
    {"role": "assistant", "content": "好的。"},
    {"role": "user", "content": "怎样查看端口占用?"}
  ]
}

历史越长,占用的窗口越多,调用成本和首字延迟也可能上升。应用需要自己决定保留哪些原文、哪些消息可以总结、哪些已经与当前问题无关。

窗口里到底放了什么

一个带工具和 RAG 的智能体,请求预算可能由以下部分组成:

系统指令              1,200 tokens
工具定义                900 tokens
近期对话              3,000 tokens
检索证据              6,000 tokens
当前问题                200 tokens
输出预留              2,500 tokens
--------------------------------
合计                 13,800 tokens

这只是预算示例,不代表某个具体模型限制。工程上应先为输出预留空间,再计算输入还能使用多少:

usable_input = context_limit - reserved_output - safety_margin

if token_count(prompt_parts) > usable_input:
    prompt_parts = compress_to_budget(prompt_parts, usable_input)

若把窗口全部塞满输入,即使请求没有立刻报错,也可能没有足够空间生成完整回答。

为什么窗口不能无限增大

标准全注意力机制需要让序列中的 Token 相互计算注意力,计算量常被概括为随序列长度呈平方增长。现代模型会使用高效注意力、稀疏结构、缓存和工程优化,实际表现不完全等同于简单公式,但长输入依然需要更多计算与显存。

自回归生成时还会维护 KV Cache。它通常随序列长度、网络层数和注意力头配置增长。上下文越长,缓存越大,单请求占用资源越多,可并发的请求数量也会下降。

因此,模型标称“支持很长窗口”不等于每次都应该填满。无关内容会增加成本,还可能稀释真正重要的证据。

超出窗口会发生什么

行为取决于 API 和应用实现。有些接口直接返回长度错误;有些聊天框架会自动删除较早消息;有些系统会总结历史或截断单条内容。

自动截断如果不可见,会带来隐蔽错误:用户早先给出的关键约束被删掉,模型却继续给出看似连贯的答案。应用应显式记录裁剪策略,并尽量保留系统规则、当前问题和高优先级事实。

即使没有超限,长上下文也不保证模型能同等利用每一部分。研究和实践中常见“Lost in the Middle”现象:关键信息放在很长上下文中部时,模型可能不如处理开头或结尾的信息稳定。解决办法不是简单复制关键内容,而是减少噪声、重排证据并做好评估。

五种上下文管理方法

1. 滑动窗口

只保留最近若干轮对话,适合即时聊天。缺点是早期约束可能被遗忘,因此要把长期有效信息单独保存。

recent_messages = messages[-10:]

2. 对话摘要

将较早对话压缩为结构化摘要,而不是保留每句话:

{
  "environment": "Ubuntu 24.04",
  "goal": "部署 Python Web 服务",
  "constraints": ["不能使用容器", "端口必须为 8080"],
  "resolved": ["已安装 Python 3.12"]
}

摘要也可能遗漏信息,最好保留原始历史的可追溯存储,并在关键决策前重新读取相关消息。

3. 按需检索历史

把长期对话、用户偏好或项目记录放入外部存储,只在与当前问题相关时检索。这与 RAG 的思路相同:不把全部记忆一直带在窗口里。

4. 控制工具定义与结果

智能体若一次暴露几十个工具,其 JSON Schema 就会占用大量 Token。可以先按任务路由,只提供当前需要的工具;工具返回的大表格和日志则先筛选、聚合或分页。

5. 为 RAG 证据设预算

检索不是越多越好。先召回较多候选,再通过重排、去重和压缩,留下能覆盖问题的少量证据:

candidates = retrieve(question, top_k=30)
ranked = rerank(question, candidates)
evidence = pack_by_token_budget(ranked, budget=5000)

若问题包含多个子任务,可以按子问题分配预算,避免一个主题占满全部空间。

长上下文会取代 RAG 吗

不会。长上下文和 RAG 解决的不是同一个问题。

长上下文提高了单次请求能阅读的材料量,适合一次性分析一份长报告、代码仓库中的若干文件或完整会议记录。RAG 则从更大的数据集合中筛选当前需要的证据,还能处理更新、权限、引用和多租户隔离。

假设知识库有一万份文档,即使模型能容纳其中几份,也没有必要把一万份全部传入。RAG 先做搜索与过滤,再利用长上下文同时阅读更多高质量候选,两者是互补关系。

海量知识库
   ↓ RAG:找出相关且有权限的资料
少量候选文档
   ↓ 长上下文:联合阅读、比较和归纳
最终回答

怎样设计一份可执行的预算

先确定模型限制和预期输出,再按优先级分配输入空间:

budget = {
    "system": 1200,
    "tools": 800,
    "history": 2500,
    "evidence": 6000,
    "question": 500,
    "output": 3000,
    "margin": 1000,
}

数字应来自实际 tokenizer 和请求分布。监控中至少记录输入 Token、输出 Token、被裁剪内容、证据数量、延迟和错误率。之后才能判断,应该增加窗口、优化检索,还是精简提示词。

小结

上下文窗口是大模型每次调用的工作区,也是必须主动管理的资源。它容纳的不只有用户文字,还包括系统指令、历史、RAG 证据、工具信息和输出预留。

可靠的做法是先做预算,再按重要性压缩和检索,最后验证关键约束有没有在长输入中丢失。更长的窗口能处理更多材料,但不能替代信息筛选;RAG 负责找到值得阅读的内容,长上下文负责把这些内容一起读好。

AI Agent上下文预算设计:从成本控制到高效记忆管理的核心策略 在大语言模型应用中,上下文窗口是模型处理信息的核心工作区,其长度直接决定了单次交互能容纳的信息量。其基本原理在于,模型通过注意力机制对窗口内的所有token进行计算和关联,以生成连贯的响应。合理管理上下文窗口的技术价值巨大,它不仅能有效控制API调用成本,更是提升Agent响应速度、保证回答准确性的关键。在实际的工程实践中,面对复杂任务和多轮对话,开发者常需应对信息过载、关键指令遗忘等挑战。通过引入动态优先级评分、摘要压缩及分层记忆系统等策略,可以显著优化有限上下文窗口内信息的“效用密度”。本文聚焦于上下文 阅读详情

相关推荐

上下文窗口悖论:为什么长上下文不等于高性能

上下文窗口是大语言模型处理信息长度的核心能力指标,其本质受Decoder-Only架构、RoPE位置编码、GQA注意力机制及二次方计算复杂度等底层原理制约。盲目扩大窗口不仅无法提升效果,反而引发显存溢出、延迟飙升、事实性下降和‘丢失在中间’等工程问题。技术价值在于实现成本、延迟、准确率与硬件资源的动态平衡;典型应用场景包括法律合同分析、技术文档问答与多源RAG系统。本文聚焦Llama 3.1 8B等主流模型在8192 tokens甜点位的实证规律,揭示上下文窗口作为关键工程决策变量的本质。

weixin_30265103的博客 446

Linux 性能预算有限:先定位瓶颈,再决定优化方向

本文的场景、图表和数值用于说明分析方法,不代表特定线上系统的事实或性能承诺。复现时请记录版本、硬件与资源配额、输入和并发模型、预热与统计窗口,以及失败路径。本文以可复现的示例场景梳理这一问题:先说明约束和排查路径,再给出可调整的实现。文中的故障经过、数字和结果需要在相同条件下复核,不能直接外推到其他服务。

iymei4986533030的博客 4043

端侧大模型本地部署实战:从量化到百万Token上下文的全链路解析

在AI技术快速演进的当下,大模型推理不再局限于云端。随着统一内存架构、模型量化技术与推理框架的成熟,本地部署大模型已成为数据隐私保护和成本控制的关键路径。Token作为模型处理文本的基本单位,其上下文窗口的扩展能力直接影响复杂任务的处理深度,而KV Cache等底层机制更是决定了长文本场景下的性能表现。通过合理选择硬件配置与量化模型,开发者可以在个人设备上运行7B至32B参数规模的开源模型,实现文档分析、代码审查等生产力级应用。掌握Ollama等工具链,理解上下文长度与显存容量的平衡,能够帮助工程团队构建兼

weixin_33946605的博客 444

大模型开发 - 20 Chat Memory:多层次记忆架构_突破大模型对话中的 Token 上限瓶颈

摘要 本文探讨了在智能对话系统中实现多层次记忆架构的技术方案。针对大语言模型(LLM)的Token限制问题,提出仿照人类记忆机制设计三层结构:近期记忆(10轮对话,直接输入LLM)、中期记忆(向量化存储5条相关历史,通过RAG动态检索)、长期记忆(结构化存储用户偏好等关键信息)。文章详细介绍了各层实现策略,包括使用ChatMemory管理近期窗口、异步向量化存储中期记忆、以及通过批处理或实时触发固化长期记忆的技术实现,为构建更智能的对话系统提供了可行性方案。

小工匠 2164

context-mode详解:从编程上下文到大模型窗口管理

软件开发中,上下文管理是核心难点,无论是Bug排查、接口性能还是AI应用效果,常与上下文处理相关。context-mode作为一种环境信息集中管理的思想,贯穿编程语言的资源管理、设计模式的跨层传递以及大模型应用的上下文窗口优化。其原理类似员工工牌,将请求生命周期内的状态绑定并传递,保证处理单元自适应环境变化。在Python中,with语句与contextvars提供生命周期与并发隔离;在架构中,Context模式减少参数传递;在AI应用中,通过截断、RAG检索、摘要压缩等策略管理有限Token。理解cont

weixin_32576389的博客 208

LangChain中token管理:大模型应用的资源精算核心

语言模型本质上是基于token序列进行计算的统计系统,token是其输入输出的基本计量单位,直接影响上下文长度、推理成本与响应质量。理解token的生成原理(如BPE分词)、精确计算方法(tiktoken与get_num_tokens_from_messages差异)及模型上下文窗口的真实可用空间,是构建稳定RAG、智能对话等应用的前提。在工程实践中,token约束驱动着模型选型(如gpt-3.5-turbo vs Mixtral的中文token效率)、链路设计(PromptTemplate变量膨胀、Out

weixin_29056701的博客 254

大模型百万Token上下文窗口的技术突破与应用

大模型上下文窗口的扩展是当前AI领域的重要技术突破,其核心在于新型注意力机制的创新。通过混合注意力机制和动态分块压缩技术,模型能够有效处理百万级Token的长文档,显著提升信息保持能力和跨文档关联推理能力。这一技术进步为知识密集型任务如技术文档分析、财务报告处理等场景带来革命性变化。检索增强生成(RAG)架构与大模型长上下文能力的结合,形成了更高效的混合解决方案,在实时数据处理、成本控制等方面展现出独特优势。随着选择性注意力、记忆压缩等前沿技术的发展,大模型处理复杂知识的能力将持续增强,为企业和开发者提供更

weixin_29056865的博客 204

生成式AI实操地基:Token、上下文窗口与推理链路解析

生成式AI不是黑箱模型的堆砌,而是由Token、上下文窗口、Decoder-only架构、推理流水线和量化微调等基础构建块组成的可工程化系统。理解Token如何切分中英文、上下文窗口为何是注意力预算而非显存容量、推理为何分为Prefill/Decode两阶段,是实现低延迟、高可控AI服务的前提。这些概念直接决定Prompt有效性、长文本稳定性与本地部署可行性,广泛应用于智能客服、合同分析、工业图纸生成等真实场景。本文聚焦可触摸的实操逻辑,带你从服务器日志、终端命令和监控曲线中建立扎实的生成式AI工程直觉。

weixin_32678995的博客 337

大模型记忆系统构建指南:从上下文工程到RAG与本地部署

记忆是智能系统持续服务的基础,而大模型本身是无状态的,每次请求独立计算,导致无法天然记住用户偏好。上下文窗口只是临时工作台,KV Cache解决性能而非持久化。要构建真正的长期记忆,需要结合RAG、上下文工程、微调及记忆框架等方案。本文从记忆缺失根源讲起,对比主流技术路线,并给出一个最小可运行的对话记忆系统实现,涵盖向量存储、检索、提示词组装和本地部署实践,帮助开发者在实际场景中落地大模型记忆功能。

weixin_30735745的博客 407

GPT-5.6超长上下文技术解析:20亿token在科研场景的实用价值

在自然语言处理领域,上下文窗口是衡量大语言模型处理长文本能力的关键指标,它决定了模型单次推理能够参考的文本范围。其技术原理基于Transformer架构的自注意力机制,通过计算token之间的关联权重来实现上下文理解。超长上下文的技术价值在于能够保持文档的完整性和连贯性,避免传统分块处理导致的信息割裂问题,特别适合需要全局视角的分析任务。在实际应用场景中,这种能力可以显著提升文献综述、代码库分析、法律文档审查等长文档处理任务的效率。然而,实现真正的超长上下文面临计算复杂度平方级增长和注意力机制内存瓶颈等核心

weixin_33884611的博客 526

RAG上下文充分性:从检索到生成的工程化落地关键

RAG(检索增强生成)的核心挑战不在于大模型能力,而在于检索返回的上下文能否支撑准确生成——即‘上下文充分性’。其原理涉及query意图结构化、语义完整chunk切分与证据链验证三重机制,技术价值在于显著降低幻觉率、提升业务问答准确率与合规性保障。典型应用场景包括企业知识库问答、智能客服、金融/法务政策解读等对答案可验证性要求高的领域。本文聚焦RAG优化中的信息密度、query-context对齐等关键实践要素,提供可直接落地的chunk策略与重排序瓶颈突破方案。

weixin_34007906的博客 384

大模型实战指南:Token、上下文与计费原理详解与成本优化策略

在自然语言处理领域,大模型的核心运作机制建立在Token和上下文等基础概念之上。Token作为模型处理文本的基本语义单元,其切分方式和数量直接影响模型的理解与生成过程,是计费与性能评估的关键依据。上下文长度则决定了模型的“工作记忆”范围,是实现长文档理解与多轮对话连贯性的技术基础。理解这些原理对于构建高效、低成本的大模型应用具有重要价值,尤其在检索增强生成(RAG)等架构中,通过精炼输入和分层处理策略管理上下文,能有效平衡效果与资源消耗。在实际工程实践中,结合模型选型与提示词工程,开发者可以系统性地优化To

weixin_34195546的博客 537

Zemax非序列模式微透镜阵列仿真:从建模到优化完整指南

光线追迹是光学系统仿真的核心技术,其原理基于几何光学与物理光学的光线传播模型,通过精确计算光线在光学元件中的折射、反射与散射路径,实现对系统性能的预测与评估。在微透镜阵列等复杂多通道光学系统中,传统序列模式因光线路径受限而难以准确模拟串扰与杂散光,非序列光线追迹技术则凭借其灵活的空间传播机制成为关键手段。该技术广泛应用于激光整形、光束匀化、3D传感及光场成像等领域,能够有效支持阵列结构设计与优化。Zemax非序列模式为微透镜阵列仿真提供了完整的建模、优化与公差分析流程,是光学工程师进行复杂系统设计的核心工具

weixin_29967003的博客 320

AI上下文管理实战:从token预算到状态机的系统工程

大语言模型的上下文能力并非天然可靠,其本质是受限于上下文窗口与token预算的短期工作记忆。理解这一原理,是构建稳定对话系统的基础:模型每次推理均无持久记忆,必须依赖外部系统协同实现长期信息维护。技术价值体现在显著提升回答一致性、降低幻觉率与响应延迟;典型应用场景包括金融客服、医疗问诊、电商私域等需多轮状态跟踪的交互系统。本文聚焦上下文管理的核心落地要素——滚动缓存、状态机设计、语义摘要与外部知识注入,直击工程师在LangChain/Dify项目中遭遇的‘AI健忘’痛点。

weixin_26950847的博客 118

触摸屏蓝牙控制

使用杰理芯片通过蓝牙实现触摸屏功能,需要结合触摸屏数据采集、蓝牙数据传输以及移动端应用的实现。

m0_46145044的博客 1109

AI量化交易工作台Vibe-Trading:用自然语言驱动策略回测与多智能体研究

量化交易通过数学模型和计算机程序执行投资决策,其核心在于将市场规律转化为可验证的策略。传统量化开发涉及数据获取、策略编写、回测验证等复杂工程,对非编程背景的从业者构成较高门槛。随着大语言模型技术的发展,自然语言交互正成为降低技术使用难度的关键。Vibe-Trading项目正是这一趋势的实践,它将金融工程任务封装为可调用的工具与技能,允许用户通过自然语言指令直接驱动策略回测、因子研究和投资组合分析。其技术价值在于构建了一个模块化的AI Agent框架,通过ReAct推理框架协调多个专项技能,并创新性地引入多智

weixin_28695161的博客 1565

RAG的“死“与“生“:长上下文时代为何仍需RAG增强技术?

摘要: 在长上下文(1M token)成为标配的AI新时代,关于"RAG已死"的讨论愈演愈烈。然而,RAG仍具有四大不可替代价值:成本优化(50倍价差)、可寻址语料规模(理论上无限)、知识时效性(实时更新)和幻觉控制。RAG正从"精确检索+拼接"的1.0时代,进化为"宽松检索+模型导航"的2.0时代,其核心转变为混合架构下的智能体化多轮检索与跨文档推理。未来,自适应RAG、上下文记忆和RAG-in-the-loop等技术将进一步推动其演化。RAG不会消亡,而是会以更灵活的方式与长上下文技术共存,共同构建更强

2301_80078096的博客 533

ICC II 时钟树综合(CTS)前奏:从约束定义到NDR规则的全方位设置指南

本文详细介绍了ICC II中时钟树综合(CTS)的前期准备工作,包括约束定义、NDR规则设置和时钟平衡点控制等关键步骤。通过实际案例和代码示例,指导工程师如何优化时钟偏斜、插入延迟和信号质量,确保芯片设计的时序收敛和性能稳定。特别强调了非默认布线规则(NDR)在时钟网络设计中的重要性。

weixin_42530458的博客 212

Meta的REFRAG框架如何解决RAG系统性能瓶颈?提升30.85倍的首token生成加速!

Meta的REFRAG框架解决了RAG系统性能瓶颈问题。研究发现RAG系统中99%的跨段落注意力计算是浪费的,且首个token生成延迟随上下文窗口呈二次方增长。REFRAG通过将上下文划分为块,生成压缩嵌入,并使用强化学习选择性展开重要块,实现了30.85倍的首token生成加速,同时保持模型准确性。实验显示,该框架在多个基准测试中性能提升明显,特别适合多轮对话和长文档处理场景。

2401_85343303的博客 619

[ensp报错:USG6000V错误代码45解决方案]

[ensp报错:USG6000V:错误代码45解决] [ensp报错:USG6000V:错误代码45解决] 第一种处理方式: ensp的45错误帮助文档里的解决方法:(这里就不说了,上华为爸爸的图) ensp的45错误:如果你的45错误不是描述的那个,可能是ensp与virtualbox不兼容了。 错误描述:具体表现为在virtualbox里没有vfw_usg的条目,虚拟介质管理器里也没有相应的条目: 就是vfw_usg_vdi这个 这种情况下你把ensp卸载重装多少次都没用,原因在两个软件的兼容

weixin_45456536的博客 3万+

Windows 10/11一键搞定HDF5文件查看:HDFView 3.4.1免配置安装指南(附中文路径避坑技巧)

本文详细介绍了HDFView 3.4.1在Windows 10/11上的免配置安装方法及中文路径优化技巧。作为HDF5文件查看的专业工具,HDFView 3.4.1简化了安装流程,提升了科研数据处理效率,特别适合遥感、气象等领域的研究人员使用。

qsc9012345的博客 1143

RAG项目实战:多轮对话记忆设计全解析(5种核心策略+实践指南)

摘要:RAG项目开发中,多轮对话的记忆能力直接影响用户体验。本文解析了5种实用记忆策略:1)完整历史(简单但不可持续);2)滑动窗口(平衡性能与连贯性);3)Token截断(精确控制消耗);4)摘要压缩(保留关键信息);5)混合策略(推荐方案)。同时强调了Token预算分配原则(对话历史占20-30%,检索上下文40-50%)和存储选型建议(开发用内存,生产用Redis)。开发者可根据场景从简单策略入手,逐步优化至混合策略,实现既连贯又高效的对话体验。

2401_82753448的博客 589

基于情感分析+聚类分析+LDA主题分析对服装产品类的消费者评论分析

本研究旨在通过对服装产品类的消费者评论进行综合分析,为企业提供更全面、更深入的市场洞察和决策支持。同时,本研究的方法和结果也可以为其他领域的消费者评论分析提供借鉴和参考。

m0_64336780的博客 2万+

GPT-5.6 Sol 1M上下文:突破大模型长文本处理瓶颈的工程实践

在自然语言处理领域,上下文长度是衡量大语言模型处理信息能力的关键指标,它定义了模型单次推理所能考虑的文本范围。其技术原理基于Transformer架构的注意力机制,但传统方案受限于计算复杂度与内存开销。提升上下文长度的技术价值在于,它直接扩展了模型解决复杂问题的“工作记忆区”,使其能够连贯处理超长文档、维持深度多轮对话以及理解复杂代码库等场景。这为构建更智能、更通用的AI应用提供了基础。检索增强生成(RAG)作为一种关键技术,通过与向量数据库结合,能在海量信息中精准定位相关内容,有效补充或优化长上下文的使用

weixin_34314962的博客 408

Ansys Lumerical双层扭曲液晶偏振光栅仿真:宽角度衍射效率优化

Ansys Lumerical双层扭曲液晶偏振光栅仿真研究 摘要 本文采用Ansys Lumerical软件平台,对双层扭曲液晶偏振光栅的宽角度衍射特性进行系统仿真研究。针对6μm周期的液晶光栅结构,以1050nm、1064nm和1550nm三个近红外波段为研究对象,在±40°入射角范围内优化平均衍射效率。研究基于液晶材料的双折射特性(Δn=0.135),通过构建两层扭曲方向相反的液晶层结构,扫描0-90°单层扭曲角度和不同厚度参数,利用RCWA求解器进行严格耦合波分析~~~~~~~

huanghm88的专栏 164

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

多轮对话上下文管理实战:从预算分配到记忆策略的完整优化指南

多轮对话系统是大模型应用落地的高频场景,但许多团队在跑通单轮问答后,都会遇到模型“失忆”、前后矛盾等上下文处理难题。大模型本身无状态,每次请求都依赖应用层重新组织历史信息,因此上下文管理成为决定Chatbot体验的关键。本文从上下文预算分配出发,讲解如何计算token开销、设置超限降级策略,并深入对比滑动窗口、摘要压缩、语义召回三种记忆方案,同时介绍vLLM前缀缓存优化、流式输出与异常恢复等工程实践,最后给出基于多轮评测集的回归验证方法。无论你正在构建智能客服、对话机器人还是Agent,这套方法论都能帮助你

weixin_34117211的博客 311

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: 向量数据库入门:记录结构、索引、检索与选型
下一篇: Linux进程概念入门:程序、PCB与fork
jinyishu_
博客等级 码龄1年 53粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值