Cassandra NoSQL数据模型设计指南

java:Cassandra入门与实战——上 一、数据存储方式和NoSQL 1.1 数据存储方式 互联网时代各种数据存储方式层出不穷,有传统的关系性数据库如:MySQL、Oracle等,;有全文检索框架如:ElasticSearch、Solr;有NoSQL如:Cassandra、Redis 这些存储方式的特点: 关系型数据库:支持事务,二级索引,SQL语句,支持主从架。 全文检索:分布式,p2p架构,不支持事务,采用倒排索引提供全文检索。 NoSQL:一般基于内存,支持分布式,面向列,不支持SQL。 1.2 NoSQL概述 NoSQL,泛 阅读详情

原文:Cassandra NoSQL Data Model Design
翻译:雁惊寒

摘要:本文通过一个简单的实例详细介绍了Cassandra数据建模的五个步骤。以下是译文。

我们最近在Instaclustr发表了一篇有关在Cassandra中经常出现的数据建模错误的文章。这篇文章非常受欢迎,并促使我思考如何设计出高质量的Cassandra数据模型,以避免在设计的过程中掉入陷阱。

在互联网上,你可以找到很多有关适配数据模型设计规则和设计模式的优秀文章,例如:Apache Cassandra数据建模指南和数据建模优秀实践 。

然而,我们并没有一个详细的操作步骤来指导你对数据进行分析,并适配相应的规则和模式。但这份白皮书正尝试着填补这方面的空白。

第一阶段:了解数据

这个阶段有两个步骤,这两个步骤都是为了更好地理解你正在建模的数据和所需的访问模式。

定义数据域

第一步是深入理解数据域。作为一个非常熟悉关系数据建模的人,我倾向于通过绘制ER图来理解这些实体、主键和互相之间的关系。但是,如果你熟悉另一种标记法,你也可以用一下试试。你需要在逻辑层面理解以下关键点:

  • 数据模型中的实体(或对象)是什么?
  • 实体的主要关键属性是什么?
  • 实体之间有哪些关系(即从一个到另一个的引用)?
  • 关系的相对基数是多少(例如,假设存在一对多的关系,那么平均是1对10,还是1对10000)?

定义所需的访问模式

下一步,弄清楚你自己需要如何访问数据:

  • 列出需要访问数据的路径,例如:
    • 以客户ID为索引,在某个日期范围内搜索交易记录,然后从搜索结果中搜索特定交易的详细信息。按某个特定的服务器和度量标准搜索,检索x度量值,按年龄升序排列。
    • 按某个特定的服务器和度量检索,从特定时间点开始检索x度量值。
    • 对于给定的传感器,检索给定日期的多个度量的所有读数。
    • 对于给定的传感器,检索当前值。
  • 请记住,对记录的任何更新操作都是一个访问路径,都需要仔细考虑。
  • 从性能的角度来确定哪些访问最关键。是否有一些访问需要尽可能快的速度,而其他一些访问则需要花一定的时间进行多次读取或在一定范围内进行检索?
  • 请记住,在这个阶段,你需要非常全面地了解如何访问数据,在Cassandra的性能、可靠性和可伸缩性之间做出权衡。

第二阶段:了解实体

这个阶段有两个具体的步骤,旨在了解与数据相关的主要和次要实体。

确定主要访问实体

现在,我们开始从分析数据域和应用需求转为开始设计数据模型了。在进入这个阶段之前,你需要把上面两个步骤的工作做得扎实一点。

这一阶段主要的想法是根据你所使用的访问模式将数据去规范化到尽可能少的表中。对于每一次按键进行的查询,需要有一张表来满足查询需求。我创造了一个术语“主要访问实体”来描述用于查询的实体(例如,按客户ID进行的查找将使用客户表作为主要访问实体,按服务器和度量名称的查找将使用服务器-度量实体作为主要访问实体)。

主要访问实体定义了去规范化结果表的分区级别(即表会为每个主要访问实体的实例提供一个分区)。

你可以选择使用二级索引来满足一些访问模式,而不是使用不同的主要访问实体来实现数据复制。请记住,包含在辅助索引中的列应比被索引的表的基数更低,并且你要对索引值的更新频率了如指掌。

对于上面举的访问模式的例子,我们将定义以下主要访问实体:

  • 客户和交易(从客户实体获取交易清单,然后从交易实体查找交易详情)
  • 服务器-度量
  • 传感器
  • 传感器

分配次要实体

下一步是寻找一个地方用来存储那些没有被选为主要访问实体的实体数据(这些实体被称为次要实体)。你可以这样做:

  • 通过从一对多关系的父级次要实体获取数据并在主要访问实体级别存储它的多个副本(例如,将客户的电话号码存储在客户的订单记录中)。
  • 通过从一对多关系的子次要实体获取数据并通过使用聚集键或通过使用多值类型(列表和映射)将其存储在主要访问实体级别上(例如,将记录项列表添加到交易表中)。

对于一些次要实体,只有一个相关的主要访问实体,所以不需要选择在哪个方向推入数据。对于其他实体,你需要选择将数据推入哪些主要访问实体。

为了获得最佳的读取性能,需要将数据副本推送到用作次要实体中数据访问路径的每个主要访问实体中。

然而,维护多个副本数据会影响到数据插入和更新的性能,并会增加应用程序的复杂性。因此,需要根据应用程序指定的性能要求在读取性能与数据维护成本之间做出权衡。

在这个阶段要做出的另一个决定是要选择使用聚集键还是多值类型来进行数据推升。一般来说:

  • 在只有一个子次要实体向上推升的情况下使用聚集键,特别是在子次要实体本身有子节点上卷的情况下。
  • 在有多个子实体推升到主要实体的时候使用多值类型

请注意,这些规则可能比较简单,但它们可以引申出对这方面更深入的思考。

第三阶段:审核与调优

最后一个阶段则是在必要的情况下对数据模型进行审核、测试,以及调优。

审核分区和聚集键

在这个阶段中,你需要将所有需要存储的数据分配到一个或多个表中,并且这些表需要支持所需的访问模式。下一步是检查生成的数据模型是否有效地使用了Cassandra,如果没有,则进行调优。在这个阶段,需要检查和调整的内容包括:

  • 分区键是否有足够的基数?如果没有,则可能需要将列从聚集键变为分区键(例如,将主键(client_id,timestamp)更改为主键((client_id,timestamp)))或引入将多个聚集键分组为分区的新列(例如,将主键(client_id,timestamp)更改为主键((client_id,day),timestamp))。

  • 分区键中的值是否会经常更新?对主键的更新将导致记录的删除和重新插入。例如,在一个维护了所有客户的状态的表中,可能有主键(状态,客户ID)。但是,这将导致每当客户状态发生变化时都需要删除并重新插入记录。在这种情况下,最好选择集合或列表数据类型,而不是将客户ID作为聚集键。

  • 每个分区中的记录数是否有限制?特别大的分区和或者分布非常不均匀的分区可能会出现问题。例如,假设有一张client_updates表,其主键为(client_id,update_timestamp),则客户记录的更新次数可能并没有限制,因为可能有少量的客户已经有10年未更新,而大多数客户只有一两天而已。

测试和调优

最后一步,也可能是最重要的,即对数据模型进行测试,并根据需要进行调优。请记住,像分区或记录数增长过快的问题只有在实际负载下使用几天(或更长时间)之后才能发现。因此,测试的时候需要尽可能地接近真实负载,并密切监视各种警告信息(nodetool cfstats和cfhistograms命令对此非常有用)。

在这个阶段,你也可以考虑调整一些影响数据物理存储的设置。例如:

  • 改变压缩策略;
  • 如果只使用TTL来删除数据的话,则可以降低gc_grace_seconds,或者
  • 设置缓存选项。

一个完整的例子

为了说明这一点,下文将介绍一个示例,该示例构建了一个数据库,用于存储和检索来自多个服务器的日志消息。请注意,与大多数实际的案例相比,这个例子非常简单。

步骤1:定义数据域
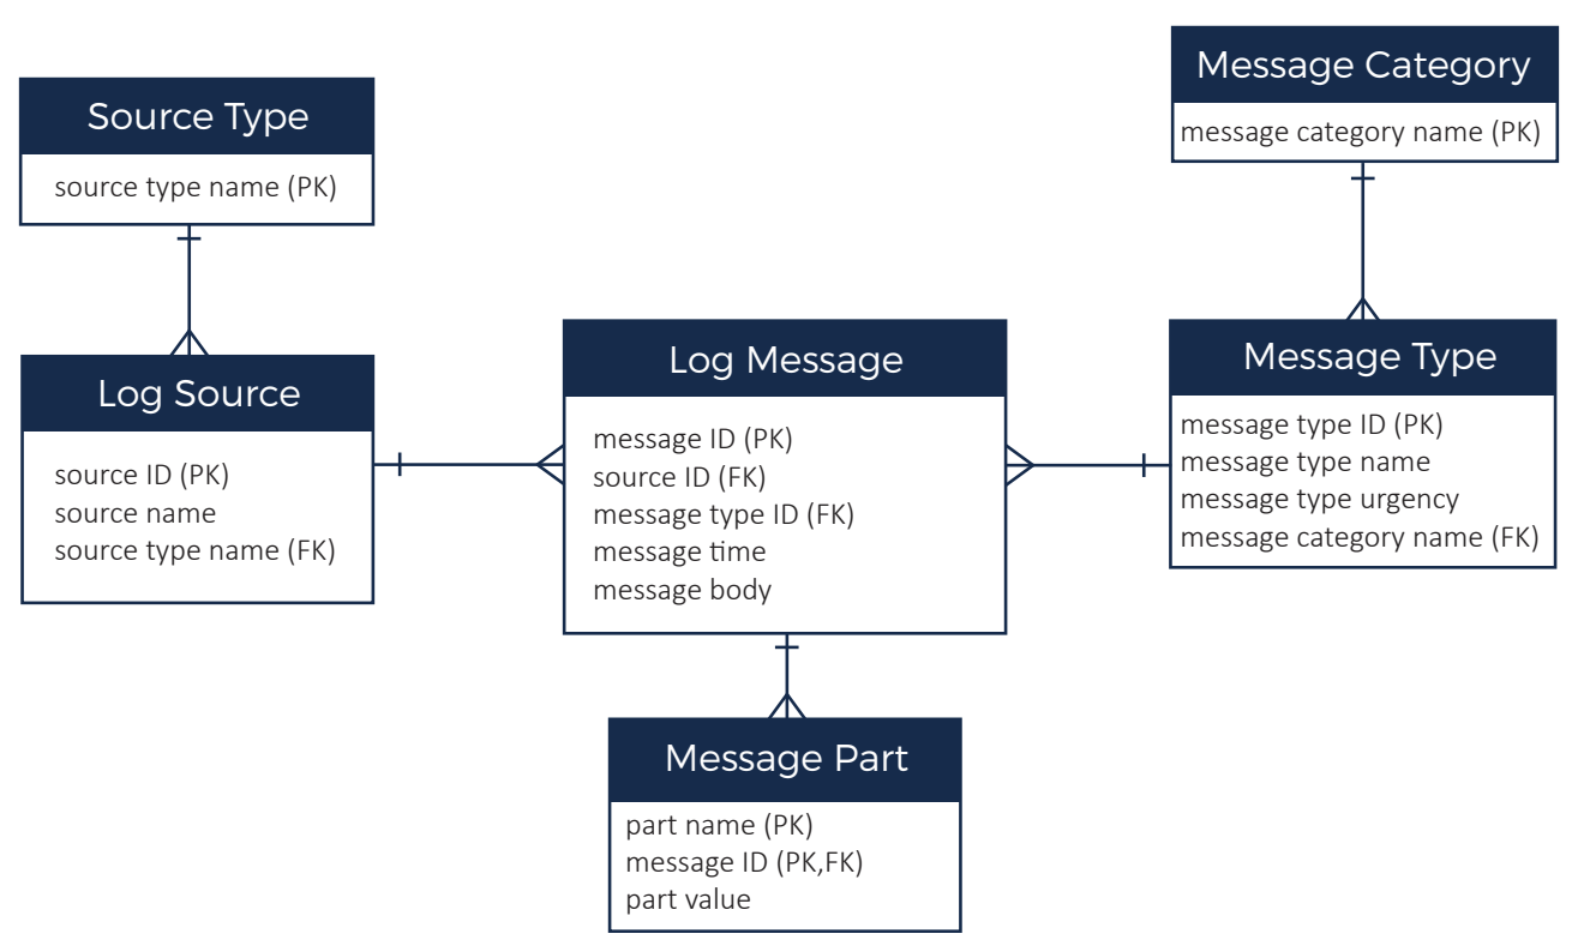

Defining the data model domain Instaclustr Data Model design

上面的ER图描述了本示例的数据域,包括:

  • 有很多(百万数量级)的日志消息,有时间戳和主体。尽管消息ID在ER图中显示为主键,但消息时间加消息类型是备用主键。
  • 每个日志消息都有一个消息类型,多个类型被进一步分组为一个消息类别(例如,消息类型可能是“内存不足错误”,类别可能是“错误”)。有几百个消息类型和大约20个类别。
  • 每个日志消息来自一个消息源。消息源是生成消息的服务器。我们的系统中有1000台服务器。每个消息源都有一个源类型对其进行分类(如红帽服务器、Ubuntu服务器、Windows服务器、路由器等)。有大约20个源类型。每个源每天有大约10000条消息。
  • 消息体可以被解析并存储为多个消息体(一般来说是键值对)。每条消息通常不超过20个消息体。

步骤2:定义所需的访问模式

我们需要能够:

  • 检索给定源的最近10条消息的所有可用信息(并且能够从中及时回溯)。
  • 检索给定源类型的最近10条消息的所有可用信息。

步骤3:确定主要访问实体

这里有两个主要访问实体:源和源类型。源类型的基数(约为20)使其非常适合成为二级索引,所以我们将使用源作为主要访问实体,并添加源类型为二级索引。

步骤4:分配次要实体

在这个例子中,这个步骤相对简单,因为所有数据都需要滚入到日志源主要访问实体中。所以我们需要:

  • 下推源类型名称
  • 下推消息类别和消息类型以记录消息
  • 上推日志消息,使其作为新实体的聚集键
  • 作为map类型上推消息体。

最终这将是一个带有源ID分区键和(消息时间,消息类型)聚集键的单个表。

步骤5:审核分区和聚集键

根据检查清单检查这些分区和聚集键:

  • 分区键是否有足够的基数?是的,有1000个源。
  • 分区键中的值是否会经常更新?不,所有的数据都是一次写入的。
  • 每个分区中的记录数是否有限制?不,消息数可能会随着时间的推移而无限地增长。

所以,我们需要解决无限分区大小的问题。在时间序列数据中,解决这个问题的典型模式是将一组时间段引入到聚集键中。在这种情况下,每天10000条消息是一个比较合理的数字,可以包含在一个分区中,因此我们将使用“天”作为分区键的一部分。

最后,Cassandra结果表是这样的:

CREATE TABLE example.log_messages (
message_id uuid,
source_name text,
source_type text,
message_type text,
message_urgency int,
message_category text,
message_time timestamp,
message_time_day text,
message_body text,
message_parts map<text, frozen>
PRIMARY KEY ((source_name, message_time_day,message_time, message_type)
) WITH CLUSTERING ORDER BY (message_time DESC);

CREATE INDEX log_messages_sourcetype_idx ON example.log_messages (source_type);

HBase vs Cassandra:两大NoSQL巨头的对决 HBase是一个分布式的、面向列的开源数据库,基于Google的Bigtable论文设计而成。它运行在Hadoop分布式文件系统(HDFS)之上,具有高扩展性、高效的随机读写性能以及分布式架构等优点。•高扩展性:支持水平扩展,可以轻松添加更多节点。•高效读写:专为大规模数据集设计,能够快速进行随机读写操作。•依赖Hadoop:需要Hadoop生态系统中的其他组件(如HDFS、ZooKeeper)来支持其功能。Cassandra是另一个流行的分布式NoSQL数据库,由Facebook开发并开源。 阅读详情

相关推荐

5大主流NoSQL数据库对比:MongoDB、Redis、Cassandra等选型指南

本文聚焦于5大主流NoSQL数据库(MongoDB、Redis、Cassandra等)的对比,旨在为开发者和企业提供详细的选型指南。通过对这些数据库的概念基础、理论框架、架构设计、实现机制、实际应用等方面进行深入分析,揭示它们各自的特点和适用场景。同时,探讨高级考量因素如扩展性、安全性、伦理维度等,以及跨领域应用和研究前沿,帮助读者在不同的业务需求下做出更合适的数据库选择。扩展性:能够轻松应对大规模数据存储和高并发访问的需求,支持水平扩展。灵活性。

架构师的AI之路,分享AI应用开发架构的学习与实践。 1122

开发者拥抱NoSQL的5个阶段

相信很多开发者都有个疑问,如果以一种简单、灵活的方法来存储程序数据,应该选择NoSQL还是SQL呢?NoSQL数据库提供了非常完美的体验:一个安装包,启动数据库,使用JSON API进行数据读写操作。此外,NoSQL支持快速迭代。SQL方案需要更多的预先投资:配置服务器,插入数据,设定数据表,以对象关系映射系统来进行数据获取。两者对比权衡,创业公司更青睐NoSQL。那么要拥抱NoSQL,需要经历哪...

Joy0921的博客 297

NoSQL数据库实战:从MongoDB到Cassandra的应用与优化

NoSQL数据库是一类与传统关系型数据库不同的数据库系统,它不使用传统的SQL作为查询语言,也不强制要求数据以表格的形式存储。灵活的架构:没有固定的表结构,支持多种数据模型(文档、键值对、列族、图等)。高可扩展性:通过水平扩展(sharding)和分布式架构,支持处理大规模数据。高性能:优化了对大数据、高并发的读写操作,适合处理动态和半结构化数据。MongoDB是一款基于文档的NoSQL数据库,它使用类似JSON的BSON(Binary JSON)格式来存储数据。灵活的模式。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1247

数据模型设计

数据模型设计数据模型设计一、确保所有表都有主键总结二、避免存储冗余数据总结三、第3条:消除重复数据组总结四、每列只存储一个属性总结五、理解为什么存储计算列通常有害无益总结六、定义外键以确保引用完整性总结七、确保表间关系的合理性总结八、当第三范式不够时,采用更多范式总结九、非规范化数据仓库总结 数据模型设计 如果你面对的是一个糟糕的数据模型设计,想写出高效的SQL语句是不太可能的。当数据模型规范化没有使用正确的关联关系定义时,你会发现使用SQL语句从这些数据中获取有用的信息即使有可能也会是相当困难的。 本章介

爱是与世界平行 5307

Cassandra数据库入门指南:从零开始学习NoSQL

在互联网应用的数据量呈指数级增长的今天,传统关系型数据库(如MySQL)在高并发写入、海量数据存储和水平扩展上逐渐力不从心。Cassandra作为Apache基金会顶级项目,凭借“高可用、可线性扩展、灵活数据模型”三大核心优势,成为社交平台、电商、物联网等场景的首选NoSQL数据库。本文将从“为什么选择Cassandra”出发,通过生活化比喻、代码示例和场景分析,带您从零掌握Cassandra的核心概念、技术原理与实战技能,助您快速入门分布式数据库的世界。

AI天才研究院 1391

NoSQL数据库选型指南:MongoDB vs Cassandra vs HBase

在当今的大数据时代,传统的关系型数据库已经难以满足一些复杂的业务需求,比如海量数据的存储、高并发的读写等。NoSQL数据库应运而生,为解决这些问题提供了新的思路。本文的目的就是详细介绍MongoDB、Cassandra和HBase这三种NoSQL数据库,对比它们的优缺点,明确它们各自适用的场景,以便开发者和企业能够根据自身的业务需求做出正确的数据库选型。本文首先会介绍一些与NoSQL数据库相关的术语和概念,为后续的内容打下基础。

AIGC应用创新大全的博客 1188

数据模型设计:实用指南和最佳实践

1.背景介绍 数据模型设计是在计算机科学和软件工程领域中的一个重要概念,它涉及到如何有效地表示和组织数据,以便于存储、检索、查询和分析。数据模型设计是构建高效、可扩展和易于维护的数据库系统和应用程序的关键一环。 在过去的几十年里,数据模型设计的方法和技术发展了很多,从简单的文件系统到复杂的关系数据库、对象关系模型、图形数据库和分布式数据库等。随着大数据时代的到来,数据模型设计的复杂性和挑战也不...

AI天才研究院 3407

Fluent 2.5D动网格重构实战:涡旋压缩机复杂运动模拟指南

本文详细解析了Fluent 2.5D动网格重构技术在涡旋压缩机复杂运动模拟中的应用。通过对比传统方法,2.5D重构显著提升了计算效率和稳定性,特别适用于柱体类几何的网格处理。文章提供了从基础配置到参数优化的实战指南,包括关键设置步骤、常见问题排查及性能优化策略,帮助工程师有效解决动网格重构中的负体积和网格畸变问题。

weixin_28455801的博客 548

数据模型⽆法复⽤,归根结底还是设计问题

点击上方蓝色字体,选择“设为星标”回复”资源“获取更多资源大数据技术与架构点击右侧关注,大数据开发领域最强公众号!暴走大数据点击右侧关注,暴走大数据!如果把指标⽐喻成⼀棵树上的果实,那模...

微信搜:import_bigdata,大数据领域硬核原创作者 665

告别手动抓信号!Synopsys AXI VIP的Port Monitor实战:5分钟搞定与Scoreboard的TLM连接

本文详细介绍了Synopsys AXI VIP的Port Monitor功能,帮助验证工程师快速实现与Scoreboard的TLM连接,5分钟内完成自动数据收集。通过实战指南和常见问题排查,提升验证效率,告别手动抓信号的繁琐流程。

weixin_30565327的博客 298

从零构建FOC:手把手教你实现无刷电机磁场定向控制

本文是一份详尽的FOC(磁场定向控制)实战教程,指导开发者从零开始构建无刷电机驱动系统。文章深入解析了FOC的核心算法,包括坐标变换(Clarke/Park)、SVPWM调制和双环PI控制,并对比了有感与无感方案的实现差异。通过分步调试指南,帮助读者亲手实现稳定、高效的无刷电机控制,彻底掌握其底层原理。

h3i4j的博客 514

5000字,详解数据模型设计方法!

ARCoder体验群,体验AR来源:知了小巷、网易有数全文共计4989字,预计阅读时间8分钟如果把指标⽐喻成⼀棵树上的果实,那模型就是这棵⼤树的躯⼲,想让果实结得好,必须让树⼲变得粗壮。真实场景举例:⼤多数公司的分析师会结合业务做⼀些数据分析(需要⽤到⼤量的数据),通过报表的⽅式服务于业务部⻔的运营。但是在数据中台构建之前,分析师经常发现⾃⼰没有可以复⽤的数据,不得不使⽤原始数据进⾏清洗、加⼯、计...

大数据星球-浪尖 1051

2026年AI编程工作流实战:Claude Code与Open Code深度对比

AI编程已从代码生成工具升级为IDE级智能工作流核心能力。其本质是将大语言模型深度嵌入开发环境,通过语义理解、上下文感知与行动闭环重构传统编码范式。Claude Code以企业级知识图谱和双轨Code Review为代表,强调合规性、可审计与深度集成;Open Code则依托Skill可组合性、本地优先模型与ocp协议,实现开源驱动的灵活扩展。二者共同推动IDE从‘编辑器’进化为‘数字搭档’——能理解RFC文档、记住PR评论、自动补全带重试的fetch逻辑,并在Promise链发呆时一键重构为async/a

weixin_33739523的博客 458

Cassandra数据模型

提起NoSQL这个话题,仿佛不应该是DBA要关注的事,而是架构师应该关心的。但是作为一名DBA,在使用传统的关系型思想建模时,应该有必要了解NoSQL的建模方法。各种NoSQL数据库有很多,我最关注的还是BigTable类型,因为它是一个高可用可扩展的分布式计算平台,用来处理海量的结构化数据,而数据库同样也是处理结构化数据,所以除了没有SQL,在数据模型方面有相似之处。Cass

半道出家的和尚 2491

最适合入门的100个深度学习项目

本专栏整理了《PyTorch深度学习项目实战100例》,内包含了各种不同的深度学习项目,包含项目原理以及源码,每一个项目实例都附带有完整的代码+数据集。

优快云 精品推荐 12万+

12、多端神经形态晶体管:原理、应用与算法探索

本文综述了多端神经形态晶体管的原理、应用与算法探索。从神经元MOS晶体管的发展到基于电解质栅极晶体管(EGT)的新型器件设计,系统阐述了其在低电压、多功能逻辑运算和突触行为模拟方面的优势。重点介绍了其在化学生物传感器(如多巴胺和pH检测)中的高灵敏度应用,以及在树突整合、时空总和、动态逻辑和神经元算术等树突算法中的实现。文章还总结了该类器件在神经形态计算、智能传感等领域的广阔前景,并分析了当前面临的材料工艺、理论建模与系统集成挑战,展望了未来发展方向。

delta的博客 143

【HBase分布式数据库】NoSQL与数据模型

任务目的了解什么是NoSQL,以及NoSQL类型的数据库有哪些了解HBase的数据模型任务清单任务1:NoSQL简介任务2:数据模型任务步骤任务1:NoSQL简介NoSQL(NoSQL = Not Only SQL),意为"不仅仅是SQL",即非关系型数据库。NoSQL 是一项全新的数据库革命性运动,早期就有人提出,发展至2009年趋势越发高涨。NoSQL的拥护者们提倡运用非关系型的数据存储,相对于铺天盖地的关系型数据库运用,这一概念无疑是一种全新的思维的注入。

1100

机器人中的数值优化(一)—— 数学优化、凸集合与凸函数

本系列文章主要是我在学习《数值优化》过程中的一些笔记和相关思考,主要的学习资料是深蓝学院的课程《机器人中的数值优化》和高立编著的《数值最优化方法》等,本系列文章篇数较多,不定期更新,上半部分介绍无约束优化,下半部分介绍带约束的优化,中间会穿插一些路径规划方面的应用实例。

慕羽★的博客 2521

【Cassandra从入门到放弃系列 三】Cassandra的数据模型设计

前两篇分别介绍了为什么要使用NoSql数据库及为什么选用Cassandra作为业务数据库以及其基于列的存储模式对于处理海量数据聚合计算的优势,本篇详细说明下Cassandra的数据模型是如何设计的? 数据模型设计 数据模型中有如下几个概念:Column,Super Column,Column Family以及Keyspace。 列Column 在Cassandra中,列是基本单元,可以想象为关系型数据库中的列。 普通列Column Column是Cassandra所支持的最基础的数据模型。该模型中可以包含一

MaoLin Tian's Blog 2317

SAP ABAP 缓冲同步揭秘——从 DDLOG 表到 RSDBBUF3 的完整实践指南

DDLOG 看似一张不起眼的系统表,却承担着 SAP 多实例环境下的数据一致性重任。通过掌握其字段意义、解析方法及周边监控工具,你可以在性能与一致性之间找到最佳平衡;通过精细化的参数管理与主动刷新策略,更能在关键业务场景中确保“数据永远是最新的”。愿本文能成为你日常排障与架构决策的参考手册。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 311

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

[转]Cassandra数据模型

 最近在研究cassandra,看到了这篇文章,收集来。转自:http://www.hellodba.net/2010/02/cassandra.html 提起NoSQL这个话题,仿佛不应该是DBA要关注的事,而是架构师应该关心的。但是作为一名DBA,在使用传统的关系型思想建模时,应该有必要了解NoSQL的建模方法。各种NoSQL数据库有很多,我最关注的还是BigTable类型,因

cnhome的专栏 729

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

cassandra的数据模型

我们来深入了解一下cassandra的数据模型。cassandra是一种NoSQL数据库,NoSQL并不是指没有SQL语句,而是指No Relational。cassandra的数据模型结合了Dynamo的key/value和BigTable   的面向列的特点,主要被设计为存储大规模的分布式数据。 一、cassandra数据模型的特点         1.它基于key-value

Just Do IT ! 1826

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Apache Cassandra vs Redis:NoSQL数据库终极对比指南

在当今数据驱动的时代,选择合适的NoSQL数据库对于项目成功至关重要。Apache Cassandra和Redis作为两款备受欢迎的NoSQL数据库,各自拥有独特的优势和适用场景。本文将从架构设计、性能表现、数据模型和典型应用场景等方面,为你提供一份全面且实用的对比指南,助你在实际项目中做出明智选择。 ## 一、核心架构:分布式 vs 内存优先 ### Apache Cassandra的分布式

gitblog_01110的博客 643

Apache Cassandra:分布式NoSQL数据库

Cassandra使用宽列存储模型(Wide Column Store),其数据模型包括Keyspace(类似于关系型数据库的database)、Column Family(类似于表的Table)、Row和Column。本文将详细介绍Cassandra的原理、基础使用、高级功能,并通过示例展示其强大的功能,同时列出Cassandra的主要优点,并提供官网链接。Cassandra支持多数据中心复制,可以在不同地理位置的数据中心之间同步数据,提高数据的可用性和容错性。

Aaron_945的博客 2283

Cassandra:分布式 NoSQL 数据库的典范

高可用性:通过多副本机制,确保数据的高可用性。线性扩展:支持动态扩展节点,满足业务需求。无单点故障:采用去中心化架构,避免单点故障。灵活的数据模型:支持灵活的数据模型,适应多种业务场景。Cassandra 是分布式 NoSQL 数据库的典范,通过其高可用性、线性扩展和灵活的数据模型,为大规模数据存储和实时分析提供了强大的支持。通过深入了解其核心概念、架构设计、使用场景和性能优化,开发团队可以充分发挥 Cassandra 的优势,构建高效、可靠的分布式数据库系统。

u011403205的博客 965
上一篇: Pandas初学者代码优化指南
下一篇: 揭秘京东文件系统JFS的前世今生,支持双11每秒约10万个对象同时读写
csdn研发技术
博客等级 码龄9年 1381粉丝 90原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值