Reinforcement Learning for Relation Classification from Noisy Data

AI落地实战论文地图:50篇工业级关键技术路标 人工智能工程化落地的核心挑战,从来不是理论前沿性,而是技术方案与真实场景的精准匹配。从数据弱监督标注、模型轻量化部署,到多模态工业对齐与持续迭代中的灾难性遗忘,AI项目生命周期各阶段都存在高频、可复现的技术断点。本文聚焦‘问题驱动’范式,以《Snorkel》《TinyBERT》《CLIP》等50篇高复现度、强实操性的工业验证论文为锚点,系统梳理从纸面算法到产线代码的关键转化链路。内容覆盖弱监督学习、知识蒸馏、跨模态对齐、模型压缩、数据漂移应对等核心技术价值,并深度适配制造业、医疗、金融等垂直领域的真实约束条 阅读详情

主要贡献

  1. 提出一个新的关系分类模型,它有实体选择器与关系分类器构成。它能够在句子级别提取关系。
  2. 将实体选择问题转换成强化学习问题,这使得不需要实体选择的标签,而只需要关系分类器的弱监督的回馈就能进行实体选择。

摘要

现在的关系分类方法都是依赖拍距离监督假设(distance supervision assume)的,它假设一系列提到一对实体的句子,都是在描述这对实体的一种关系。类似于这种思想的方法,其实都是一组句子层面的分类,无法学习出关系与句子之间的映射,并且这种方法对噪声很敏感。

在这篇论文中,作者提出了一种新的模型,它能够在句子层面进行关系分类,并且对噪声的容忍度很强。这个模型主要分为两个模块:实体选择器和关系分类器。实体选择器通过强化学习选出高质量的句子,然后喂给关系分类器;

关系分类器能够进行句子级别的关系预测,并给实体选择器提供反馈。这两个模块会联合训练,从而不断优化整个模型。

实验结果显示,这个模型能够减少噪声的影响,在句子层面获得更好的分类结果。

引言

为了解决噪声标签的问题,之前的研究都是采用多实体学习的方式来考虑实体的噪声。在这种方式中,训练以及测试都是在一组句子级别的,噪声会比较大。因此,之前的研究都有以下两种缺陷:
1. 无法在句子级别进行预测。
2. 对一组句子中的噪声非常敏感。

在这篇文章中,为了解决上述两种缺陷,作者提出了一种新的关系分类模型。通过实体选择器,从一组句子中选出高质量的句子,然后通过句子级别的关系分类器来选择关系。

为了解决第二种缺陷,如果一整个包的句子标签都是错误的,那么句子选择器将会过滤掉整个包。

在这里,一个主要的问题是如何联合训练上述两个模块,特别是当实体选择器一开始不知道哪些句子的标签是不正确的。

尽管我们无法用监督的方式来进行实体选择,但是我们可以从整体上来度量选出的句子。实体选择的过程有一下两个属性:
1. 试错搜索(trial-and-error-search)。实体选择器试图找出一些句子,这些句子在关系选择的时候会获得reward。
2. 只有当完成实体选择之后,关系分类器才会把反馈给实体选择器,也就是delayed。

相关论文

神经网络被广泛用于关系分类,其中包括CNN(1,2),RNN,LSTM(1,2)。Wang提出用两层Attention从异构环境中为关系分类辨别模式。

一般来说,训练神经网络需要大量的标签数据,而标签数据又非常稀缺。为了解决这个问题,Mintz提出远程监督,但是这个方法还是无法解决噪声数据干扰问题。Lin 2016,Ji 2017,Tianyu Liu and Sui 2017等人提出了多实体下的句子级别的Attention机制,它能够降低错误句子的权重。但是这些方法只能在一组句子级别找关系,无法在句子级别找关系。Narasimhan, Yala, and Barzilay 2016提出使用强化学习来改善信息提取。

问题定义


  1. 实体选择问题

将<句子,关系标签>对表示为 X={(x1,r1),(x2,r2),⋯,(xn,rn)} X = { ( x 1 , r 1 ) , ( x 2 , r 2 ) , ⋯ , ( x n , r n ) } ,其中 xi x i 是与一句话有关的两个实体 (hi,ti) ( h i , t i ) , ri r i 是远程监督生成的关系。目的是找出关系正确的句子。

  • 关系分类问题
    给出一句句子 xi x i 以及这句句子提到的一对实体 (hi,ti) ( h i , t i ) ,目标是预测 ri r i 。概率公式为 PΦ(ri|xi,hi,ti) P Φ ( r i | x i , h i , t i ) 。

  • 在实体选择阶段,每个句子 xi x i 会绑定一个 action ai a i ,来表示 xi x i 是否被选作训练实体。状态 si s i 用当前句子 xi x i 来表示。实体选择器根据随机策略对给定当前状态的动作进行采样。关系分类器采用一个卷集架构来得出一对实体的语义关系。下图体现了这个框架的架构图。
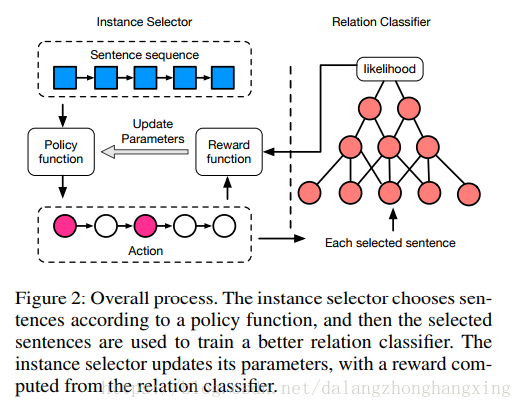
    这里写图片描述

实体选择器(Instance Selector)

对于实体选择器而言,它的主要任务是根据Policy函数,来决定在某种State(包含当前句子,已选出的句子集合,实体对)下,应该采取哪种Action(选或不选)。然后接收从关系分类器传来反馈。

如果我们按照前面说的,当选出了所有的高质量句子之后,再接收关系分类器给出的延迟奖励,然后更新Policy函数的参数,这种方式是低效的。

为了获得更多的反馈,使得训练过程更加有效,作者将训练集分词N组 B={B1,B2,⋯,BN} B = { B 1 , B 2 , ⋯ , B N } ,每一组完成句子选择之后,就会获得Reward。每一组的实体对都是不同的,但是它们的关系标签都是相同的, Bk={xk1,xk2,⋯,xk|Bk|} B k = { x 1 k , x 2 k , ⋯ , x | B k | k } 都具有相同的标签 rk r k 。当训练集中的句子都训练完成之后,会将每一组中选出的句子合并,统一进行关系分类。

状态(State)

状态 si s i 主要包含当前句子,已经选出的句子以及实体对。作者使用一个连续函数 F(si) F ( s i ) 来表示状态,它将输出一个Vector。
1. 当前句子的Vector表示是从用于关系分类的CNN的非线性层中获得。
2. 已选出句子集合的Vector表示是每句句子Vector的平均值。
3. 一对实体的Vector表示是从预训练的knowledge graph embedding中获得。

动作(Action)

动作 ai a i 的的取值是{0,1},表示是否选取一句句子。 ai a i 根据Policy函数 πθ(si,ai) π θ ( s i , a i ) 获得,其中 θ θ 是需要学习的参数。

πθ(si,ai)=Pθ(ai|si)=aiσ(W∗F(si)+b)+(1−ai)(1−σ(W∗F(si)+b)) π θ ( s i , a i ) = P θ ( a i | s i ) = a i σ ( W ∗ F ( s i ) + b ) + ( 1 − a i ) ( 1 − σ ( W ∗ F ( s i ) + b ) )

其中 F(si) F ( s i ) 就是状态特征Vector, θ={W,b} θ = { W , b } 。

奖励\回馈(Reward)

Reward的作用的反映选出句子的有用程度。作者假设这个模型完成所有的选择之后,会有一个最奖励,因此只需要在最终状态 s|B|+1 s | B | + 1 接收一个delayed reward,其他状态的奖励都是0。因此Reward函数定义如下:

r(si|B)={01|Bˆ|∑xj∈Bˆlogp(r|xj)i<|B|+1i=|B|+1 r ( s i | B ) = { 0 i < | B | + 1 1 | B ^ | ∑ x j ∈ B ^ l o g p ( r | x j ) i = | B | + 1

其中 Bˆ B ^ 是选出的句子集合, r r 是当前句子组的关系标签,p(r|xj)是关系分类器,它由CNN模型构成。对于 Bˆ B ^ 是空集的情况,其奖励为训练集中所有句子得分的平均值,这能是实体选择器更有效地消除噪声影响。

注意,关系分类器 p(r|x) p ( r | x ) 是作用在每句句子上的,而Reward是在一组句子的基础上计算的,因此Reward能够全面评估Policy函数选出的句子的有用性。它通过弱监督的方式来最大化选出句子的平均似然估计,从而使得实体选择器的目标函数与关系分类器一致。

优化

对于每组句子 B B ,目标是最大化Reward,目标函数如下:

J(θ)=Vθ(s0,B)=Es0,a0,s1,a1,⋯,si,ai,⋯[∑i=0|B|+1r(si|B)]

其中 ai∼πθ(si,ai) a i ∼ π θ ( s i , a i ) , si+1∼P(si+1|si,ai) s i + 1 ∼ P ( s i + 1 | s i , a i ) 。转移方程 P(si+1|si,ai) P ( s i + 1 | s i , a i ) 等于 πθ(si+1,ai+1) π θ ( s i + 1 , a i + 1 ) ,因为 si+1 s i + 1 的值可以被 si s i 与 ai a i 确定。

那么梯度按照如下方式计算:
1. 对于每组句子,根据Policy函数计算每个句子的state以及action,得到 {s1,a1,s2,a2,⋯,s|B|,a|B|,s|B+1|} { s 1 , a 1 , s 2 , a 2 , ⋯ , s | B | , a | B | , s | B + 1 | } 。
2. 将选出的句子喂给关系分类器,根据结果得到reward r(s|B|+1|B) r ( s | B | + 1 | B ) 。
3. 按照 θ←θ+α∑|B|i=1vi▽θlogπθ(si,ai) θ ← θ + α ∑ i = 1 | B | v i ▽ θ l o g π θ ( s i , a i ) 的规则去更新 θ θ 。

关系分类器(Relation Classifier)

在关系分类器中,使用CNN来预测关系,它由一个输入层,一个卷积层,一个max poolling层,一个非线性层组成。

输入层

对于每个句子 x x ,我们将它表示成一系列向量(w1,w2,⋯,wm)。每个向量由两部分组成:word embedding和pisition embedding。word embedding用word2Vec实现,维度为 dw d w 。position embedding是按照当前单词到开头和结束的相对位置来计算的,维度为 dp d p 。然后将word embedding和pisition embedding进行组合,得到新的向量 wi w i ,维度为 dw+2∗dp d w + 2 ∗ d p 。

CNN

为了得到更高级、更抽象的句子表示,作者使用了CNN来得到新的特征L:

L=CNN(x) L = C N N ( x )

其中 x x 就是输入层的输入,L是一个 ds d s 维的矩阵,作者取230。因此卷积的参数 Wf∈Rds∗3d,bf∈Rds W f ∈ R d s ∗ 3 d , b f ∈ R d s 。

然后关系预测的概率为 p(r|x;Φ)=softmax(Wr∗tanh(L)+br) p ( r | x ; Φ ) = s o f t m a x ( W r ∗ t a n h ( L ) + b r ) ,其中 Wr∈Rds∗nr,br∈Rnr W r ∈ R d s ∗ n r , b r ∈ R n r , nr n r 是关系总数。

损失函数(Loss Function)

给出选出的句子集合 {Xˆ} { X ^ } ,我们使用交叉熵作为损失函数。

J(Φ)=−1|Xˆ|∑i=1|Xˆ|logp(ri|xi;Φ) J ( Φ ) = − 1 | X ^ | ∑ i = 1 | X ^ | l o g p ( r i | x i ; Φ )

Xilinx Vitis 2020.1头文件路径配置避坑指南:解决#include找不到文件的常见问题 本文针对Xilinx Vitis 2020.1开发环境中常见的#include头文件找不到问题,提供了系统的避坑指南。文章深入解析了Vitis的头文件搜索机制,对比了通过工程属性GUI、修改编译命令及使用环境变量三种配置方法的优劣与隐藏陷阱,并给出了高级场景的排查流程与工程结构最佳实践,帮助开发者高效解决路径配置难题。 阅读详情

相关推荐

【隐私计算】从本地加法到在线乘法:Beaver Triple如何重塑算术秘密分享的运算效率

本文深入探讨了Beaver Triple在算术秘密分享中的关键作用,显著提升了隐私计算中的乘法运算效率。通过对比加法与乘法的实现差异,详细解析了Beaver Triple的预处理机制和在线计算优化,展示了其在减少通信量和计算时间方面的革命性突破。

weixin_29227585的博客 436

论文解读:Reinforcement Learning for Relation Classification from Noisy Data

论文解读:Reinforcement Learning for Relation Classification from Noisy Data   本文是一篇以强化学习来解决远程监督关系抽取中噪声的问题。强化学习作为一个比较新的机器学习,能够很好的处理一些半监督类问题,强化学习是一种从经验中学习的方法,通过定义策略、状态、动作以及收益来训练智能体与环境的交互,在游戏博弈等场景中很受欢迎。本文则将其...

夏栀的博客 2734

奇迹MU单机版开服全流程:从零搭建到分辨率调整(附GM工具使用技巧)

本文详细介绍了奇迹MU单机版从零搭建到分辨率调整的完整流程,包括环境配置、服务端启动、GM工具使用技巧等关键步骤。特别针对现代高分辨率显示器提供了优化方案,帮助玩家轻松搭建个性化游戏环境,重温经典MMORPG的独特魅力。

b3n4m5q6w7的博客 680

关系抽取之——强化学习

Reinforcement Learning for Relation Classification from Noisy Data 摘要:目前存在的关系抽取方法大多是依赖于远程监督假设的,即所有包含两个相同实体的句子都只表达一种关系。但是这些方法都是在包级别上做关系抽取,不能明确的映射出单句和关系之间的联系,并且由远程监督产生的错误标签还在影响着模型的精度。该文在含有噪声的数据集上提出了一...

m0_38031488的博客 2421

STM32 超声波模块输入捕获测距(标准库)

通道2设置为下降沿触发,触发瞬间会将CNT的记录到CCR2中,由于上升沿触发时已经将CNT置零所以此时的CNT的值就是高电平的持续时间。通道1设置为上升沿触发,触发的瞬间会将CNT的值记录到CCR1里面,同时设置通道1触发带有从模式,并把从模式设置为置零CNT。超声波传感器模块上面通常有两个超声波元器件,一个用于发射,一个用于接收。电路板上有四个引脚:VCC、GND、Trig(触发)、Echo(回应)。输入捕获原理可以看看这位大佬,感觉写的很清楚,工作电压与电流:5V,15mA。感测角度:不小于15度。

qq_62425900的博客 2082

(八)基于MuJoCo的LeRobot SO100仿真操控实战指南(操作优化)

本文详细介绍了如何在MuJoCo仿真环境中搭建并优化LeRobot SO100机械臂的操控。通过两种核心模式(纯键盘仿真与实机镜像同步)的实战演示,重点讲解了关键的参数标定方法,以实现虚拟模型与真实硬件的精准同步。文章还提供了性能优化技巧,旨在帮助开发者构建高效、安全的机器人算法开发与测试流程。

weixin_29083649的博客 319

论文浅尝 | Reinforcement Learning for Relation Classification

论文链接:http://aihuang.org/p/papers/AAAI2018Denoising.pdf来源:AAAI 2018 MotivationDistant Supervision 是一种常用的生成关系分类训练样本的方法,它通过将知识库与非结构化文本对齐来自动构建大量训练样本,减少模型对人工标注数据的依赖。但是这样标注出的数据会有很多噪音,例如,如果Obama和United State

开放知识图谱 2402

Python爬虫逆向案例:某云片滑块验证码分析-滑动验证码

今天我们看个滑块。

2201_76125393的博客 1034

Reinforcement Learning for Relation Classification from Noisy Data阅读笔记

Reinforcement Learning for Relation Classification from Noisy Data阅读笔记

feitianlzk的博客 2384

华为OD新系统机试真题 - 获取大写字母瓷砖拼出独特图案数量

华为OD机试新系统真题【获取大写字母瓷砖拼出独特图案数量】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD新系统四月二十九号机试真题【获取大写字母瓷砖拼出独特图案数量】

qq_45776114的博客 1219

【网络与爬虫 49】突破WAF防线:Web应用防火墙绕过实战攻略

本文深入探讨Web应用防火墙(WAF)的工作原理与绕过技术,从基础的编码变换到高级的协议层攻击,通过实战案例和代码演示,帮助安全研究者和渗透测试人员理解现代WAF防护机制并掌握合规的绕过方法。内容涵盖SQL注入、XSS、文件上传等攻击向量的WAF绕过技术,适合网络安全从业者和爬虫开发者学习参考。

熵数实验室 1848

[ACL2015] A Dependency-Based Neural Network for Relation Classification

paper的主旨是探讨依存信息的组合:即两个实体间的最短依存树和以及附着在最短依存树上词的子树两部分信息如何糅合在一起 这种想法的来源是:最短依存树的词的向量包含了词的基本信息, 子树提供了该词在句子中作用的词义信息 RNN: 擅长处理层级结构,在本文中用于处理subtree信息 CNN: 适合flat structure, 用于处理最短依存树上的词和依存关系RNN处理后的subtree信息用

Deep Learning and NLP Farm 1459

[SoC]SoC验证中bootcode与firmware相关验证经验总结

本文总结了SoC验证中bootcode和firmware的验证经验。重点介绍了两种数据加载方法:1)使用Verilog系统函数$readmemh/$readmemb直接写入ROM/ARAM,需注意文件路径、格式和斜杠方向;2)通过Memory Hierarchy在initial块中操作,需要添加适当延时并注意路径拼接。文章还提供了在testcase phase中先读取数据到HASH再写入SRAM的示例,并强调加载后需使能edc_bypass以避免ECC错误。验证过程中需特别注意文件位置、格式要求及路径处理等

元直的博客 2498

论文引介 | Information Extraction with Reinforcement Learning

文章原名:Improving Information Extraction by Acquiring External Evidence with Reinforcement Learning   作者:Karthik Narasimhan, Adam Yala, Regina Barzilay   单位:Computer Science and Artificial Intellig

433

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Reinforcement Learning Note: Concept and MDP

Reinforcement Learning Concept reward Sequential decision making RL Agent categorizing RL agent MDP Markov Process Markov Reward Process Markov Decision Process Extension of MDP POMDPs转载请注明出处: http://b

I AM BACK 852

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

Learning Reinforcement Learning (with Code, Exercises and Solutions)

Why Study Reinforcement Learning Reinforcement Learning is one of the fields I’m most excited about. Over the past few years amazing results like learning to play Atari Games from raw pixelsand M

omnispace的博客 1100

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

reinforcement learning

http://blog.youkuaiyun.com/dark_scope/article/details/8252969 开山之作 Reinforcement Learning: An Introduction 强化学习系列 深度强化学习:基于像素的乒乓游戏 A Painless Q-learning Tutorial (一个 Q-learning 算法的简明教程)

Marshall的专栏 1071

[ACL2016]Relation Classification via Multi-Level Attention CNNs

同上一篇,都是用attention做关系抽取 非常好的阅读笔记 https://zhuanlan.zhihu.com/p/22867750 http://blog.youkuaiyun.com/xg123321123/article/details/53163257

Deep Learning and NLP Farm 1459

本周不容错过的的9篇NLP论文 | PaperDaily #21

在碎片化阅读充斥眼球的时代,越来越少的人会去关注每篇论文背后的探索和思考。 在这个栏目里,你会快速 get 每篇精选论文的亮点和痛点,时刻紧跟 AI 前沿成果。 点击本文底部的「阅读原文」即刻加入社区,查看更多最新论文推荐。 这是 PaperDaily 的第 21 篇文章 Learning Structured Representation for Text Cla

Paper weekly 2864

Relation Classification via Convolutional Deep Neural Network 论文笔记

Relation Classification via Convolutional Deep Neural Network   用于关系分类的最先进的方法越来越依赖于特征提取的质量。而特征工作又经常的被当做是现有NLP工具或系统的一部分来解决,导致现有的NLP工具的错误在特征提取任务中被不断的传播并且放大。应用深度学习来进行特征提取进变得十分可行了。Word Representation Lexi...

m0_38031488的博客 3584

nlp论文学习(关系抽取)——Relation Classification via Convolutional Deep Neural Network(2014)

等待更新

w1114812321的博客 2364

【机器学习】噪声数据的理解

【机器学习】噪声数据的理解

wzk4869的博客 7679

【机器学习|学习笔记】噪声数据(Noisy Data)一直是影响模型泛化性能的重要因素,该如何处理噪声数据?

【机器学习|学习笔记】噪声数据(Noisy Data)一直是影响模型泛化性能的重要因素,该如何处理噪声数据?

2401_89898861的博客 1333

论文阅读笔记(五十二):Outline Objects using Deep Reinforcement Learning

Abstract. Image segmentation needs both local boundary position information and global object context information. The performance of the recent state-of-the-art method, fully convolutional networks, ...

sunshine_010的博客 993

【论文阅读笔记】Relation Classification via Convolutional Deep Neural Network

       本文发表在Proceedings of COLING 2014,这篇文章发表较早,值得借鉴的是局部特征和全局特征拼接进行分类处理的思路,其实在后续几NLP、CV领域的很多论文都有这种思路的体现,但是是否有比简单拼接局部和全局特征更好的特征融合方式值得探索。       本文主要内容如下:        用于关系分类的最先进的方法主要基于统计机器学习,并且它们的性能很大程度上取决于...

寸先生的AI道路 948
上一篇: Classifying Relations via Long Short Term Memory Networks along Shortest Dependency Path
下一篇: Distant Supervision——远程监督
大浪中航行
博客等级 码龄12年 46粉丝 70原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值