2025新风向聚类+Transformer创新结合!发A会根本不用愁!

【论文阅读笔记】——注意力综述阅读笔记 注意力阅读综述 阅读详情
AI摘要

本文介绍了聚类算法与Transformer架构结合的最新研究进展,包括聚类注意力机制、视觉变换器中的Patch-to-Cluster注意力、聚类掩码变换器以及标记聚类变换器等。这些方法通过降低计算复杂度、提升性能和增强模型可解释性,为数据挖掘、人工智能和计算机视觉等领域带来了创新。文中还提供了相关论文和开源代码资源。

“聚类+Transformer”是一种结合聚类算法和Transformer架构的创新方法,近年来在多个领域取得了显著的研究进展和应用成果。

我还整理出了相关的论文+开源代码,以下是精选部分论文

更多论文料可以关注:AI科技探寻,发送:111  领取更多[论文+开源码】   
论文1

标题:

Fast Transformers with Clustered Attention

具有聚类注意力的快速变换器

方法:

  • 聚类注意力(Clustered Attention):提出了一种新的注意力机制,通过将查询(queries)分组到聚类中,并仅计算聚类中心的注意力,而不是为每个查询单独计算注意力。

  • 局部敏感哈希(LSH)和K-Means:使用局部敏感哈希和K-Means进行快速聚类,以减少计算复杂度。

创新点:

  • 线性复杂度:通过聚类查询,将注意力计算的复杂度从O(N²)降低到O(NC),其中C是聚类数量(C≪N),显著提高了处理长序列的效率。

  • 性能提升:在自动语音识别任务中,与标准Transformer相比,聚类注意力在相同的计算预算下表现更好,例如在Wall Street Journal数据集上,改进的聚类注意力(i-clustered)在验证集上的电话错误率(PER)比全注意力模型低约1.5%。

  • 预训练模型的高效近似:能够以极低的性能损失近似预训练的BERT模型,仅使用25个聚类即可在GLUE和SQuAD基准测试中达到与全注意力模型相当的性能。

  • 可扩展性:该方法不仅适用于训练新的模型,还可以加速预训练模型的推理,无需额外训练。
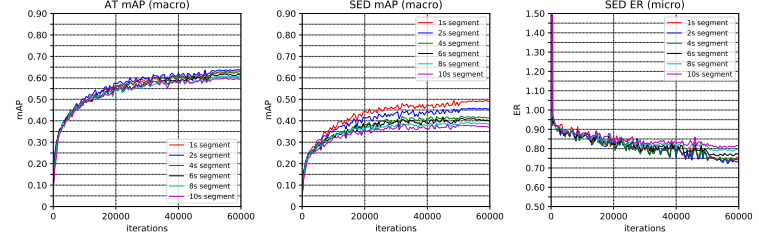
image.png

论文2

标题:

PaCa-ViT: Learning Patch-to-Cluster Attention in Vision Transformers

PaCa-ViT:学习视觉变换器中的Patch-to-Cluster注意力

方法:

  • Patch-to-Cluster注意力(PaCa):提出了一种新的注意力机制,将图像块(patches)映射到聚类(clusters)上,将键(keys)和值(values)直接基于聚类计算,而不是基于块的嵌入。

  • 端到端学习聚类:通过轻量级聚类模块学习聚类分配,将输入序列聚类为少量的“视觉令牌”(visual tokens),并用于计算注意力。

创新点:

  • 线性复杂度:将注意力计算的复杂度从O(N²)降低到O(NM),其中M是聚类数量(M≪N),显著提高了计算效率。在MIT-ADE20k语义分割任务中,与PVT模型相比,PaCa-ViT的计算复杂度显著降低。

  • 性能提升:在ImageNet-1k图像分类任务中,PaCa-ViT(Tiny、Small和Base)的Top-1准确率分别比PVTv2模型提高了2.2%、0.98%和0.76%。在MS-COCO目标检测任务中,PaCa-ViT(Small)的平均精度(AP)比PVTv2-B2模型提高了0.6%。

  • 可解释性:通过可视化聚类热图,直接解释模型的行为,为理解视觉变换器提供了新的视角。

  • 轻量级分割头:提出了一个轻量级的语义分割头网络,显著降低了模型复杂度,同时在MIT-ADE20k数据集上取得了更好的性能。
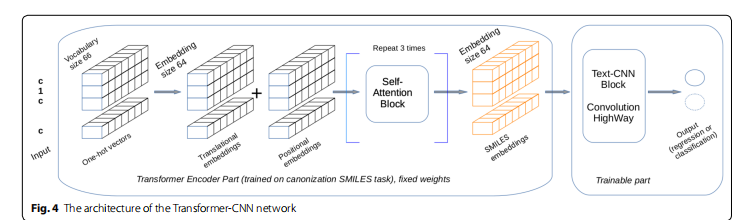
image.png

论文3

标题:

CMT-DeepLab: Clustering Mask Transformers for Panoptic Segmentation

CMT-DeepLab:聚类掩码变换器用于泛视觉分割
方法:
  • 聚类掩码变换器(CMT):提出了一种基于聚类的变换器架构,将目标查询视为聚类中心,用于分割任务中的像素聚类。

  • 交替聚类过程:通过交替的方式,首先根据特征亲和力将像素分配到聚类中,然后更新聚类中心和像素特征。

创新点:

  • 密集注意力图:通过将目标查询视为聚类中心并引入聚类更新步骤,生成更密集的注意力图,显著提升了分割任务的效果(在COCO数据集上PQ提升了4.4%,达到55.7%)。

  • 位置敏感聚类:通过动态位置编码和坐标卷积,将位置信息融入聚类过程,提升了模型对目标位置的感知能力(PQ提升了0.7%)。

  • 频繁像素更新:通过在每个变换器解码器中更新像素特征,增强了像素与聚类中心之间的交互(PQ提升了1.3%)。

  • 改进的解码器设计:通过增加更多的自注意力和交叉注意力模块,进一步提升了模型性能(PQ提升了0.9%)。
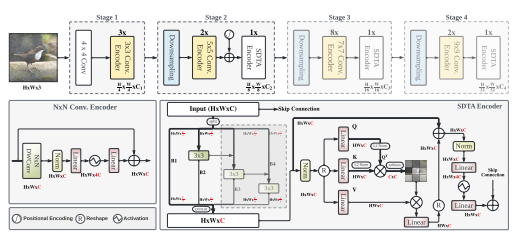
image.png

论文4

标题:

Not All Tokens Are Equal: Human-centric Visual Analysis via Token Clustering Transformer

并非所有标记都平等:通过标记聚类变换器进行以人为中心的视觉分析

方法:

  • 标记聚类变换器(TCFormer):提出了一种新的视觉变换器架构,通过逐步聚类的方式动态生成标记,标记可以来自不同位置,并具有灵活的形状和大小。

  • 聚类标记合并(CTM)模块:通过基于密度峰值聚类算法对标记进行聚类,并通过加权平均合并同一聚类中的标记。

创新点:

  • 动态标记生成:TCFormer能够根据图像内容动态调整标记的形状和大小,更好地聚焦于重要区域(如人体部位),在全身体姿态估计任务中,手部关键点的AP提升了6.2%)。

  • 多阶段特征聚合:通过MTA头聚合多阶段的标记特征,有效保留了图像细节,提升了模型在细节捕捉任务中的性能(在3D人体网格重建任务中,MPJPE降低了1.4%)。

  • 聚类标记合并:通过聚类算法合并标记,减少了标记数量,同时保留了关键信息,提升了计算效率(在WFLW数据集上,NME降低了0.32%)。

  • 任务适应性:TCFormer能够根据任务需求调整标记分布,例如在人脸对齐任务中,为面部边缘区域分配更细的标记,提升了任务性能(在WFLW数据集上,NME达到了4.28%)。
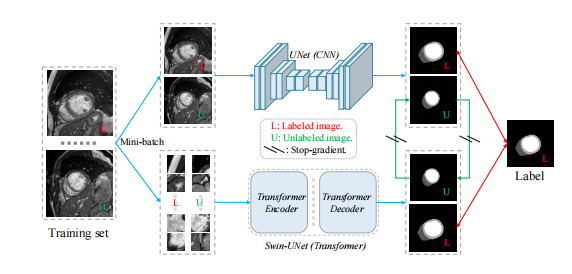
image.png

 更多论文料可以关注:AI科技探寻,发送:111  领取更多[论文+开源码】   

给Transformer做‘减法’:拆解CVPR2025论文CATANet,看它如何用聚类砍掉90%计算量 本文深入解析了CVPR2025论文CATANet的创新设计,该模型通过聚类技术显著降低Transformer在计算机视觉任务中的计算量。CATANet采用内容感知token聚合(CATA)机制,结合组内自注意力和组间交叉注意力,在超分任务中减少90%计算量的同时保持性能。这一突破为高分辨率图像处理提供了高效解决方案,并适用于目标检测、语义分割等多种视觉任务。 阅读详情

相关推荐

ICRA-2025 | 机器人导航新突破!CTSAC:融合Transformer与课程学习的自适应探索算法

ICRA-2025最新研究提出CTSAC算法,为机器人导航带来新突破。该算法创新性地融合Transformer架构与SAC强化学习框架,赋予机器人长期记忆与上下文理解能力,并结合“定期复习”式课程学习策略,有效解决了传统方法在复杂环境中易陷入局部循环、缺乏长期规划视野的痛点。实验表明,CTSAC在仿真与真实场景中均展现出更高的成功率和探索效率。

weixin_29065959的博客 529

【注意力机制】一系列关于attention的高效改进大集合

编辑:NewBeeNLP前几天逛github刷到一个『awesome-fast-attention』大列表,整理了一系列关于attention的高效改进文章,包括论文、引用量、源码实现、...

zenRRan的博客 1万+

Vision Transformer介绍

Vision Transformer (ViT) 是计算机视觉领域的革命性架构,由Google Research在2020年提出。它将自然语言处理中的Transformer架构直接应用于图像识别任务,摒弃了传统卷积操作。ViT将图像划分为固定大小的图像块(patches),转换为向量序列进行处理,通过多头自注意力机制实现全局信息交互。相比CNN,ViT具有全局上下文建模能力,但对数据量和计算资源要求更高。近年来出现了多种ViT变体,如结合CNN的混合架构、优化计算效率的窗口注意力机制等。ViT已在图像分类、

higerwy的博客 1090

NeurIPS24 Oral!聚类+transformer全新里程碑!

性能提升:在自动语音识别任务上,聚类注意力模型在给定计算预算下优于标准 Transformer 模型,例如在 Wall Street Journal 数据集上,i-clustered 模型在 4 层时的 PER 为 5.14%,而标准 Transformer 在 6 层时的 PER 为 5.56%。增强特征表示和模型性能:聚类算法能够将数据分组,找出数据中的结构,而Transformer模型具有强大的特征提取能力,二者结合可以进一步提升模型对数据特征的捕捉和表示能力,从而提高模型在各种任务中的性能。

Aimoxin111的博客 1067

YOLO十年演进:从CNN到Transformer再到MoE,我看懂了2026年目标检测的落地风向标

技术永远是为业务服务的,能解决真实问题的技术,才是有价值的。YOLO的十年演进,从CNN到Transformer再到MoE,从来都不是学术上的炫技,而是一步一步解决工业落地的痛点:从让实时检测成为可能,到解决复杂场景的漏检误检,再到打破精度和算力的死局,每一步都踩在了工业落地的真实需求上。很多新入行的朋友,总喜欢追新,今天换Transformer,明天堆MoE,觉得模型越新、参数越大,就越厉害。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 748

CVPR 2025 | TAB:Token聚合块,仅训练阶段更新聚类中心,推理速度翻倍!

本文提出了一种轻量级图像超分辨率网络CATANet,通过内容感知的token聚合机制(CATA)实现高效长程依赖建模。核心创新点是Token-Aggregation Block(TAB),其采用共享全局token中心、仅在训练阶段更新的策略,结合组内自注意力和组间交叉注意力,在消除推理开销的同时提升重建精度。实验表明,该方法在轻量级模型(477K参数)上相比SPIN等基线提升0.33dB PSNR,推理速度提升近2倍,验证了内容感知分组对超分辨率任务的有效性。

EverestRs的博客 440

ECCV 2022|经典算法老当益壮,谷歌提出基于k-means聚类的视觉Transformer

将像素特征与具体query目标的交互注意力建模重新定义为一个聚类过程

TechBeat人工智能社区博客 1192

项目介绍 MATLAB实现基于WOA-Kmeans-Transformer-BiLSTM鲸鱼优化算法(WOA)结合K均值聚类(Kmeans)和Transformer-BiLSTM组合模型进行多特征分类

摘要:本文提出了一种基于WOA-Kmeans-Transformer-BiLSTM的混合模型,用于解决多特征分类预测问题。该模型结合了鲸鱼优化算法(WOA)的全局搜索能力、K均值聚类的特征优化能力,以及Transformer-BiLSTM的深度序列建模优势。通过WOA自动优化关键超参数,K均值聚类重构特征空间,Transformer捕获全局依赖,BiLSTM建模局部时序模式,实现了对复杂多源数据的高效分类。MATLAB实现方案包含完整的数据预处理、模型构建和训练流程,在R2025b环境下验证了模型的有效性。

优质创作者: 人工智能技术领域 对于有一定基础的 MATLAB和Python带具体需求都可以详谈 MATLAB和Python可以提供代码调试服务加油 谢谢 你的鼓励是我前行的动力 谢谢支持 加油 谢谢 729

TCFormer:通过标记聚类Transformer实现视觉识别

摘要Transformer在计算机视觉领域得到了广泛应用,并取得了显著成功。大多数最先进的方法将图像分割成规则网格,并用视觉标记表示每个网格区域。然而,固定的标记分布忽略了不同图像区域的语义含义,导致性能次优。为了解决这个问题,我们提出了标记聚类Transformer(TCFormer),它基于语义含义生成动态视觉标记。我们的动态标记具有两个关键特性:(1)使用相同的视觉标记表示具有相似语义含义的图像区域,即使这些区域不相邻;(2)专注于具有有价值细节的区域,并使用精细的标记来表示它们。

AI浩 1962

Token Statistics Transformer:线性注意力革命,重新定义Transformer效率天花板

TOKEN STATISTICS TRANSFORMER: LINEAR-TIME ATTENTION VIA VARIATIONAL RATE REDUCTION” 由Ziyang Wu等人撰写。文章提出一种新型Transformer注意力算子,通过对最大编码率降低(MCR2)目标的变分形式进行展开优化得到,其计算复杂度与令牌数量呈线性关系,在保证性能的同时显著提高计算效率。也因此 ToST 也作为 Spotlight 论文,入选了 ICLR 2025 大会。下面是对本篇论文的重点总结。

以为在机器学习领域与人工智能领域深耕多年的老牛 3523

STM32F103+AX58100 EtherCAT从站SPI移植实战:CubeMX配置避坑指南

本文详细介绍了STM32F103与AX58100 EtherCAT从站控制器的SPI接口移植实战,重点解析CubeMX配置中的关键参数与常见陷阱。内容涵盖硬件连接规范、SPI模式设置、中断优先级规划及协议栈对接技巧,帮助开发者高效实现工业自动化领域的实时通信方案。特别强调CPOL/CPHA配置与AX58100的匹配要求,避免数据错位问题。

weixin_29230865的博客 331

RL+Transformer杀疯了!新架构刷爆SOTA,CTSAC高效涨点狂揽 ICRA 2025!

扩散模型在“无痛涨点”方面取得新突破,重构效率提升3倍,抗微调水印能力显著增强。强化学习(RL)与Transformer架构的融合成为人工智能领域的前沿研究方向,结合了RL的动态决策能力和Transformer的全局依赖捕捉优势,为复杂任务下的智能体行为优化提供了新范式。这一技术被视为通往通用人工智能(AGI)的重要路径,尤其在自动驾驶、医疗诊断、金融策略等领域展现出巨大应用潜力。本文精选了8篇“RL+Transformer”方向的最新研究成果,涵盖顶级会议论文及开源代码资源,供研究者参考学习。

2501_91057708的博客 1178

Spring AI + RAG 构建电商智能客服:从 PDF 文档解析到精准问答的全链路实战

核心框架:向量数据库:- PostgreSQL + pgvector (生产推荐)- Redis Stack (轻量级方案)- ChromaDB (快速原型)文档解析:- Apache PDFBox: PDF 文本提取- Spring AI Document Readers: 结构化解析大模型:- 阿里云百炼 (DashScope)- 本地部署:Qwen/ChatGLM/*** 电商领域实体*/@Data@Builder@ToString/*** 商品类型。

一起修行,不孤单。这里有编程语言、开发工具、学习方法论和踩坑笔记。用简单的话说复杂的事,陪你从小白到进阶。周更干货,欢迎一起成长! 381

2025年GCN创新点!

长程依赖建模:引入 Transformer 的自注意力模块,计算全图节点间的注意力权重 —— 无论节点距离远近,通过注意力分数捕捉关键长程关联(如学术引用图中跨领域论文的间接关联),再将注意力特征与 GCN 局部特征拼接融合,形成 “局部 - 长程” 一体化的节点表示。适用于大规模复杂图的分析任务(如社交网络社区检测、电商用户行为预测),典型数据集包括 Reddit(大规模社交网络对话图,节点数量超百万,需全局结构建模)、Amazon(商品关联图,包含多类商品局部关联,需细粒度特征捕捉)。

2501_93677353的博客 677

Palantir Vertex:数字孪生模拟与决策系统深度指南

Palantir Vertex是Foundry系统中的核心数字孪生模块,本质上是一个决策模拟器而非简单的数据可视化工具。它基于本体层构建,通过对象关系网络模拟现实世界实体,填补数据模型与业务决策间的鸿沟。核心功能包括:创建隔离的沙盒场景进行假设测试、修改参数模拟不同干预方案、对比虚实数据发现异常,并最终将最优决策回传至业务系统。典型应用场景涵盖供应链韧性评估、资产维护优化和应急方案制定等,帮助用户在复杂环境中做出更优决策。

轩哥的个人研究和成长记录 892

安卓光速虚拟机ADB调试实战:从密钥配置到设备连接

本文详细介绍了在安卓光速虚拟机中进行ADB调试的完整实战流程。核心在于通过密钥配置解决设备未授权问题,并启用网络调试与端口映射,最终实现电脑与虚拟机的稳定连接。文章提供了从原理理解、脚本修改到实战命令和疑难排查的全方位指南,帮助开发者和爱好者高效利用光速虚拟机作为移动测试沙盒。

CAT789的专栏 561

如何用Transformer Networks精准预测轨迹?2025年最完整的AI预测工具指南

在人工智能与深度学习飞速发展的今天,准确预测行人、车辆等移动目标的未来轨迹成为自动驾驶、智能监控等领域的核心挑战。**Trajectory-Transformer**项目正是为解决这一难题而生——它基于Transformer架构,通过创新的"个体学习+量化优化"双策略,让复杂场景下的轨迹预测精度提升30%以上!无论你是AI研究者还是开发者,这个开源工具都能帮你轻松实现从历史轨迹到未来路径的精准推演...

gitblog_00545的博客 490

新手避坑指南:从GEO数据库下载单细胞测序数据的5个关键步骤(附实操截图)

本文为单细胞测序数据下载新手提供5个关键避坑步骤,涵盖数据搜索准备、样本量评估、文件选择决策、元数据诊断及高效下载技术。通过实操截图和代码示例,帮助研究者快速锁定GEO数据库中的优质单细胞测序数据,避免常见错误。

weixin_30296405的博客 672

像素革命六年后:ImageGPT如何定义2025视觉AI的底层逻辑

当GPT的自回归思维遇上图像生成,OpenAI的ImageGPT用"像素序列预测"开创视觉新范式,其技术遗产正深刻影响2025年多模态大模型的进化路径。 ## 行业现状:视觉AI的双轨竞速赛 2025年的图像生成领域呈现分裂格局:Runway Gen-4以99%的角色一致性成为专业创作标杆,FLUX.1 Kontext则用$0.02/次的成本重构市场规则(据Replicate平台数据)。在这场技...

gitblog_00226的博客 687

使用node-red网关读取modbus设备点表,并上传到市政低碳平台来统计数据

最近做了一个物联网项目,具体是这样的,利用node-red网关盒子,来采集Modbus设备的点表,然后将数据转换,封装,最终上传到市政的低碳平台。上一步封装了点表的数据,调用低碳平台还需要账号密码,建筑id,这些都是固定信息,所以我们单独提出来。上一步获取到了原始的点表数据,下一步就是将这些点表数据与在低碳平台创建的采集的对应起来,并且设置好分类。读取modbus的节点,会有两个输出,我是使用的第一个输出。msg.meters 是一个数组,里面的每一个元素都是一个点表,比如厨房用水,园区照明,

知无涯 948

使用R语言读取和处理CSV数据集

查看数据集的结构str(data)# 查看数据集的摘要统计信息str()函数将显示数据集的结构信息,包括变量名称、类型和前几行的值。summary()函数将提供数据集的摘要统计信息,如均值、中位数、最小值、最大值等。

CyberGenius的博客 3856

二次分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-GRU多元时序预测

二次分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-GRU多元时序预测

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 1171

【即插即用模块】注意力篇 | TGRS 2025 | ASD:自适应频域解耦,动态拆分高低频+空间注意力,频域空间特征双增强!

摘要: FDMF-Net提出了一种频域解耦多模态融合网络,核心组件为振幅谱解耦模块(ASD)。ASD通过自适应频域拆分和频域-空域协同增强,有效分离模态不变与模态特定特征。该模块利用MLP学习动态阈值调整高低频比例,并通过空间注意力分别强化频域特征,在遥感语义分割任务中实现了细节与结构的协同增强。实验表明,ASD模块能减少模态内冗余,提升特征判别性,为多模态数据融合提供了新思路。代码已开源,适用于需要强化细节与结构的视觉任务。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 310

双分解分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-BiLSTM多元时序预测

双分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-BiLSTM多元时序预测

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 926

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-LSTM多元时序预测

分解+优化+预测!CEEMDAN-Kmeans-VMD-DOA-Transformer-LSTM多元时序预测

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 1482

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: 特征融合狂发顶会,再出神作
下一篇: 小样本学习多次登上Nature!这么好的创新点还不赶快来看看吗?
AI科技探寻
博客等级 码龄8年 421粉丝 44原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值