HBaes 部署

Kylin的安装部署以及遇到的一些问题的解决(1) Kylin安装 依赖环境 软件 版本 Apache hbase-1.1.1-bin.tar.gz 1.1.1 spark-2.2.0-bin-2.6.0-cdh5.14.0.tgz 2.2.0-bin-cdh5.14.0 apache-kylin-2.6.3-bin-hbase1x.tar.gz 2.6.3 注意: • kylin-2.6.3-bin-hbase1x所依赖的hbase为1.1.1版本 • 要求hbase的hbase.zookeeper.quorum值必须只能是host1,host2,…。 阅读详情

HBaes介绍

HBase简介

HBase是一个分布式的、面向列的开源数据库,它是一个适合于非结构化数据存储的数据库。另一个不同的是HBase基于列的而不是基于行的模式。
大:上亿行、百万列
面向列:面向列(簇)的存储和权限控制,列(簇)独立检索
稀疏:对于为空(null)的列,并不占用存储空间,因此,表的设计的非常的稀疏

HBase的角色

HMaster

功能:
(1) 监控RegionServer
(2) 处理RegionServer故障转移
(3) 处理元数据的变更
(4) 处理region的分配或移除
(5) 在空闲时间进行数据的负载均衡
(6) 通过Zookeeper发布自己的位置给客户端

HRegionServer

功能:
(1) 负责存储HBase的实际数据
(2) 处理分配给它的Region
(3) 刷新缓存到HDFS
(4) 维护HLog
(5) 执行压缩
(6) 负责处理Region分片

组件:
Write-Ahead logs
HBase的修改记录,当对HBase读写数据的时候,数据不是直接写进磁盘,它会在内存中保留一段时间(时间以及数据量阈值
可以设定)。但把数据保存在内存中可能有更高的概率引起数据丢失,为了解决这个问题,数据会先写在一个叫做Write-Ahead logfile的文件中,然后再写入内存中。所以在系统出现故障的时候,数据可以通过这个日志文件重建

HFile
这是在磁盘上保存原始数据的实际的物理文件,是实际的存储文件。

Store
HFile存储在Store中,一个Store对应HBase表中的一个列簇。

MemStore
顾名思义,就是内存存储,位于内存中,用来保存当前的数据操作,所以当数据保存在WAL中之后,RegsionServer会在内存中存储键值对。

Region
Hbase表的分片,HBase表会根据RowKey值被切分成不同的region存储在RegionServer中,在一个RegionServer中可以有多个不同的region。

HBase的架构

一个RegionServer可以包含多个HRegion,每个RegionServer维护一个HLog,和多个HFiles以及其对应的MemStore。RegionServer运行于DataNode上,数量可以与DatNode数量一致,请参考如下架构图:
在这里插入图片描述

HBase数据模型

在这里插入图片描述
确定一个单元格的位置(cell),需要如下四个
rowkey + Colume Family + Colume + timestamp(版本version),数据有版本的概念,即一个单元格可能有多个值,但是只有最新得一个对外显示。

  • HBase中有两张特殊的Table,-ROOT-和.META.
  • .META.:记录了用户表的Region信息,.META.可以有多个region
  • -ROOT-:记录了.META.表的Region信息,-ROOT-只有一个region
  • Zookeeper中记录了-ROOT-表的location
  • Client访问用户数据之前需要首先访问zookeeper,然后访问-ROOT-表,接着访问.META.表,最后才能找到用户数据的位置去访问,中间需要多次网络操作,不过client端会做cache缓存,注意:在0.96版本后,Hbase移除了-ROOT-表
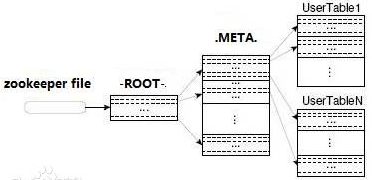
    在这里插入图片描述
    Row Key: 行键,Table的主键,Table中的记录默认按照Row Key升序排序

Timestamp:时间戳,每次数据操作对应的时间戳,可以看作是数据的version number

Column Family:

列簇,Table在水平方向有一个或者多个Column Family组成,一个Column Family中可以由任意多个Column组成,即Column Family支持动态扩展,无需预先定义Column的数量以及类型,所有Column均以二进制格式存储,用户需要自行进行类型转换。

Table & Region:

当Table随着记录数不断增加而变大后,会逐渐分裂成多份splits,成为regions,一个region由[startkey,endkey) 表示,不同的region会被Master分配给相应的RegionServer进行管理:.

HMaster
HMaster没有单点问题,HBase中可以启动多个HMaster,通过Zookeeper的Master Election机制保证总有一个Master运行,HMaster在功能上主要负责Table和Region的管理工作:

  1. 管理用户对Table的增、删、改、查操作
  2. 管理HRegionServer的负载均衡,调整Region分布
  3. 在Region Split后,负责新Region的分配
  4. 在HRegionServer停机后,负责失效HRegionServer 上的Regions迁移

HRegionServer
HRegionServer内部管理了一系列HRegion对象,每个HRegion对应了Table中的一个Region,HRegion中由多个HStore组成。每个HStore对应了Table中的一个Column Family的存储,可以看出每个Column Family其实就是一个集中的存储单元,因此最好将具备共同IO特性的column放在一个Column Family中,这样最高效。

MemStore & StoreFiles

HStore存储是HBase存储的核心了,其中由两部分组成,一部分是MemStore,一部分是StoreFiles。MemStore是Sorted Memory Buffer,用户写入的数据首先会放入MemStore,当MemStore满了以后会Flush成一个StoreFile(底层实现是HFile),当StoreFile文件数量增长到一定阈值,会触发Compact合并操作,将多个StoreFiles合并成一个StoreFile,合并过程中会进行版本合并和数据删除,因此可以看出HBase其实只有增加数据,所有的更新和删除操作都是在后续的compact过程中进行的,这使得用户的写操作只要进入内存中就可以立即返回,保证了HBase I/O的高性能。当StoreFiles Compact后,会逐步形成越来越大的StoreFile,当单个StoreFile大小超过一定阈值后,会触发Split操作,同时把当前Region Split成2个Region,父Region会下线,新Split出的2个孩子Region会被HMaster分配到相应的HRegionServer上,使得原先1个Region的压力得以分流到2个Region上。

HLog

每个HRegionServer中都有一个HLog对象,HLog是一个实现Write Ahead Log的类,在每次用户操作写入MemStore的同时,也会写一份数据到HLog文件中,HLog文件定期会滚动出新的,并删除旧的文件(已持久化到StoreFile中的数据)。当HRegionServer意外终止后,HMaster会通过Zookeeper感知到,HMaster首先会处理遗留的 HLog文件,将其中不同Region的Log数据进行拆分,分别放到相应region的目录下,然后再将失效的region重新分配,领取 到这些region的HRegionServer在Load Region的过程中,会发现有历史HLog需要处理,因此会Replay HLog中的数据到MemStore中,然后flush到StoreFiles,完成数据恢复。

文件类型

HBase中的所有数据文件都存储在Hadoop HDFS文件系统上,主要包括上述提出的两种文件类型:

  1. HFile, HBase中KeyValue数据的存储格式,HFile是Hadoop的二进制格式文件,实际上StoreFile就是对HFile做了轻量级包装,即StoreFile底层就是HFile

2.HLog File,HBase中WAL(Write Ahead Log) 的存储格式,物理上是Hadoop的Sequence File

Zookeeper中hbase的节点的存储信息:
rs:regionserver节点信息
table-lock:hbase的除meta以外的所有表
Table:hbase的所有的表


HBase部署与使用

部署

Zookeeper正常部署

首先保证Zookeeper集群的正常部署,并启动之:
opt/module/zookeeper-3.4.5/bin/zkServer.sh start

Hadoop正常部署

Hadoop集群的正常部署并启动:
/opt/module/hadoop-2.8.4/sbin/start-dfs.sh
/opt/module/hadoop-2.8.4/sbin/start-yarn.sh

HBase的解压

解压HBase到指定目录:
tar -zxf /opt/software/hbase-1.3.1-bin.tar.gz -C /opt/module/

HBase的配置文件

需要修改HBase对应的配置文件。

hbase-env.sh修改内容:

export JAVA_HOME=/opt/module/jdk1.8.0_121
export HBASE_MANAGES_ZK=false
尖叫提示
:如果使用的是JDK8以上版本,注释掉hbase-env.sh的45-47行,不然会报警告

在这里插入图片描述

<property>  
		<name>hbase.rootdir</name>  
		<value>hdfs://bigdata111:9000/hbase</value>  
	</property>


	<property>
		<name>hbase.cluster.distributed</name>
		<value>true</value>
	</property>


	<property>
		<name>hbase.master.port</name>
		<value>16000</value>
	</property>


	<property>  
		<name>hbase.zookeeper.quorum</name>
		<value>bigdata111:2181,bigdata112:2181,bigdata113:2181</value>
	</property>


	<property>  
		<name>hbase.zookeeper.property.dataDir</name>
	 <value>/opt/module/zookeeper-3.4.10/zkData</value>
	</property>

<property>
<name>hbase.master.maxclockskew</name>
<value>180000</value>
</property>

regionservers:

bigdata111
bigdata112
bigdata113

配置环境变量

vi /etc/profile
export HBASE_HOME=/opt/module/hbase-1.3.1
export PATH=HBASEHOME/bin:HBASE_HOME/bin:HBASEH​OME/bin:PATH
source /etc/profile

HBase远程scp到其他集群

scp -r /opt/module/hbase-1.3.1/ root@bigdata112:/opt/module/
scp -r /opt/module/hbase-1.3.1/ root@bigdata113:/opt/module/

HBase服务的启动

启动方式1:
bin/hbase-daemon.sh start master
bin/hbase-daemon.sh start regionserver

尖叫提示:如果集群之间的节点时间不同步,会导致regionserver无法启动,抛出ClockOutOfSyncException异常。

启动方式2:
bin/start-hbase.sh
对应的停止服务:
bin/stop-hbase.sh

查看Hbse页面

启动成功后,可以通过“host:port”的方式来访问HBase管理页面,例如:

http://bigdata111:16010

使用QGIS提取天地图遥感影像中的建筑物轮廓,及AI方案 用QGIS的插件提取遥感影像中的建筑轮廓,并提供了几个AI提取建筑轮廓的方案。 阅读详情

相关推荐

Redis架构演进:从主从、哨兵到集群,如何支撑亿级流量的秒杀场景?

本文深入探讨了分布式缓存Redis的三种核心高可用模式:主从复制、哨兵模式与集群模式。以高并发的电商秒杀业务为切入点,我们分析了每种模式的优缺点和适用场景,并最终选择Redis集群模式作为最佳解决方案。文章提供了基于Spring Boot和Spring Data Redis的完整实现代码,详细展示了如何配置和使用Redis集群来应对高并发、高可用的挑战,旨在帮助开发者在实际项目中做出正确的技术选型和架构设计。

lingRJ777的博客 724

用java 项目链接hbaes 容易出现的错误!

2014-10-21 16:08:37,580 WARN  [main] util.NativeCodeLoader (NativeCodeLoader.java:(62)) - Unable to load native-hadoop library for your platform... using builtin-java classes where applicable 2014-10

smileyboy2009的专栏 899

芯片设计中的STA实战:如何避免时序违例(含常见问题解析)

本文深入探讨了芯片设计中静态时序分析(STA)的实战应用,重点解析了如何避免时序违例。文章从STA的核心逻辑与约束制定出发,强调了将时序意识植入RTL编码与综合阶段的重要性,并详细介绍了后端物理实现中的时序收敛策略。同时,针对跨时钟域路径误报、多工艺角违例等常见问题提供了深度解析与调试技巧,旨在帮助IC设计工程师系统性地掌握时序分析与优化方法。

open4的博客 513

hbaes基础/集群搭建

1.5 存储的数据都是字节数组。 1.6 表中的数据是按照行键的顺序物理存储的。 2.HBase的物理模型 2.1 HBase是适合海量数据(如20PB)的秒级简单查询的数据库。 2.2 HBase表中的记录,按照行键进行拆分, 拆分成一个个的region。     许多个region存储在region server(单独的物理机器)中的。     这样,对表的操作转化为对多台re

zw421152835的专栏 771

Genesis物理引擎实战指南:轻量级确定性刚体仿真核心

刚体物理仿真作为机器人控制、嵌入式运动学验证和确定性游戏开发的基础技术,其核心在于数值稳定性、跨平台可复现性与约束求解精度。本文围绕线性互补问题(LCP)求解、半隐式欧拉积分和零依赖C++实现三大关键技术展开,解析如何在无GUI、低算力环境下构建可单步调试、帧级可控的确定性仿真系统。重点覆盖碰撞检测数学建模、关节局部坐标系绑定、质量-惯性张量一致性校验等工程落地关键点,适用于STM32、树莓派及教育实验场景。内容深度结合Genesis Physics Engine的源码实践,直击‘穿模’‘NaN’‘关节发软

ciya3282的博客 1592

从 0 到 1 构建 Graph RAG 系统:本地图谱 + 通义千问落地实践

本文介绍了一个基于知识图谱的检索增强生成系统(Graph RAG),该系统结合领域知识图谱、语义检索和大模型问答,旨在提供结构化、精准的技术问答服务。文章详细说明了项目背景、目标、核心技术架构以及实现方法,包括本地图谱构建、Neo4j数据库接入、语义检索和大模型集成等关键环节。该系统支持混合检索、多轮问答和知识图谱关联理解,能够有效减少大模型幻觉,提升问答的准确性和可解释性。文中还展示了核心代码结构和流程图,呈现了从文档加载到图谱构建再到问答生成的完整流程。该系统适用于需要处理复杂领域知识的研发和数据分析场

m0_58378112的博客 1401

Hive与HBase之间的区别和联系

首先要知道Hive和HBase两者的区别,我们必须要知道两者的作用和在大数据中扮演的角色 概念 Hive 1.Hive是hadoop数据仓库管理工具,严格来说,不是数据库,本身是不存储数据和处理数据的,其依赖于HDFS存储数据,依赖于MapReducer进行数据处理。 2.Hive的优点是学习成本低,可以通过类SQL语句(HSQL)快速实现简单的MR任务,不必开发专门的MR程序。 3.由于Hive是依赖于MapReducer处理数据的,因此有很高的延迟性,不适用于实时数据处理(数据查询,数据插

阿伟的博客 3万+

放弃FFT全频计算!在STM32F407上用DFT单点计算提速50%的优化技巧

本文详细介绍了在STM32F407上通过DFT单点计算实现比FFT快50%的优化技巧,特别适用于生物阻抗分析、振动监测等只需关注单一频点的嵌入式场景。通过预计算相位角、查表法和混合精度计算等策略,显著提升计算效率和内存利用率,同时保持高精度。

weixin_28738397的博客 194

大数据技术之Hbase

一、HBaes介绍 1.1、HBase简介 HBase是一个分布式的、面向列的开源数据库,它是一个适合于非结构化数据存储的数据库。另一个不同的是HBase基于列的而不是基于行的模式。 大:上亿行、百万列 面向列:面向列(族)的存储和权限控制,列(簇)独立检索 稀疏:对于为空(null)的列,并不占用存储空间,因此,表的设计的非常的稀疏 1.2、HBase的角色 1.2.1、HMast...

zhanglei_16的博客 576

【人工智能】Warp 终端完整汉化方案(2026最新)

截至2026年5月,,仅完成了中文、日文、韩文等东亚语言的字符渲染支持,设置面板中无官方语言切换选项,相关中文UI功能需求仍在官方GitHub开源仓库的需求迭代队列中。

奶爸的编程之路,也就一周冷个三天 3111

基于 Qt 的轻量化工业组态软件设计与实现

本文设计并实现了一种基于Qt框架的轻量化工业组态软件,解决了传统组态软件体积庞大、部署复杂等问题。该软件采用模块化架构,集成可视化图形编辑、设备数据采集、脚本扩展等核心功能,具有跨平台运行、资源占用低、启动速度快等特点。通过关键技术优化,实现了高效稳定的数据采集、脚本控制和网络通信,可广泛应用于工业机器人HMI、小型PLC监控等轻量化场景。测试结果表明,该软件体积约30MB,运行内存占用60-80MB,启动时间1.2秒,满足工业轻量化监控需求。未来可扩展更多工业组件和协议支持,进一步提升应用价值。

谢谢大家的关注和点赞!这里只有纯纯的知识干货,没有一句废话。希望能实实在在帮到大家~要是觉得有用,别忘了给我点支持哟,你 140

HBase架构和部署(超级详细)

在Memstore超过一定的阈值的时候,就要新开一个进程将Memstore flush到storefile中,新的Memstore继续写入接受到的数据,当storefile越来越多时,就会降低读的性能,为了提高读的性能,可以对这些storefile进行compact操作,形多个storefile合并成一个大的storefile,那么compact就需要对HBase的数据进行多次的重新读写,这将产生大量的IO操作,所以Compact操作就是以IO操作来换取后面读的性能。

互联网知识分享 2464

【第一章】核心思维:那个在此刻“消失”的 CPU

摘要:RTOS本质是"有状态的抢占"而非"多任务",单核MCU通过时间片分时复用实现任务切换。裸机编程的线性思维在RTOS中不再适用,开发者需接受代码随时被打断的现实。RTOS通过保存/恢复CPU寄存器组(上下文)实现任务切换,每个任务拥有独立栈空间。非原子操作(如全局变量自增)会导致竞态条件,必须使用临界区或互斥锁保护。RTOS编程需要建立并发思维,关注代码原子性、可重入性和栈空间分配。

一路往蓝-Anbo 的博客 105

重温HBaes部署与java客户端访问

好久没搭起来测测了,今天顺手搭起来用用。结果遇到了很多问题,下面一一说明 一、部署 简单起见,我使用了stand-alone模式。直接下载解压即可,注意的是需要改动hbase-site.xml: hbase.rootdir file:///root/zhangtieying/hbase

Michael的专栏 1036

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

CentOS HBASE的安装部署

1.软件包的上传解压解压命令:tar -zxvf hbase-1.2.0-cdh5.14.0.tar.gz -C /export/install/2.修改配置文件第一个配置文件:vim conf/hbase-env.sh将第27行的java_home改成自己的将第128行的配置的true改为false 这步是为了让HBASE使用自己的Zookeeper,而不是用自带的第二个配置文件:vim co...

大萝卜博客 1053

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

部署hdfs

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34407348的博客 138

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Hbase的部署安装和使用API

此文章为原创,转载请注明出处 完全分布式搭建Hbaes 首先你要zookeeper,hdfs都搭建完毕 上传安装包 解压 tar -zxvf hbase-0.98.12.1-hadoop2-bin.tar.gz 修改hbase-env.sh中配置JAVA_HOME cd cd hbase-0.98.12.1-hadoop2/conf/ vim hbase-env.sh ...

weixin_43681796的博客 1217

hbase0.98分布式部署

两个master,两个regionserver hbaes-env.sh: # The directory where pid files are stored. /tmp by default. export HBASE_PID_DIR=/home/master/platform/hbase-0.98.1-cdh5.1.0/pids # Seconds to sleep

linux_ja的专栏 780

HBase的安装和使用

文章目录HBaes介绍1.1、HBase的起源1.2、HBase的角色1.2.1、HMaster1.2.2、RegionServer1.3、HBase的架构HBase部署与使用2.1、部署2.1.1、Zookeeper正常部署2.1.2、Hadoop正常部署2.1.3、HBase的解压2.1.4、HBase的配置文件2.1.5、HBase需要依赖的Jar包2.1.6、HBase软连接Hadoop配...

fanday的博客 739

HBase

大数据技术之HBase 一、HBaes介绍 1.1、HBase简介 HBase是一个分布式的、面向列的开源数据库,它是一个适合于非结构化数据存储的数据库。另一个不同的是HBase基于列的而不是基于行的模式。 大:上亿行、百万列 面向列:面向列(族)的存储和权限控制,列(簇)独立检索 稀疏:对于为空(null)的列,并不占用存储空间,因此,表的设计的非常的稀疏 1.2...

weixin_30448603的博客 172

hbase初识---安装单机版hbase-1.3.1

我认为学习一个项目,不一定要搭建一个集群呀,先能用起来,熟悉基本操作,熟悉API,熟悉他的高级特性,就行了。当然了,数据平台工程师,也就是运维,那搭建各种高可用,高性能的集群就不一样了。我们初次使用,先搭一个单机版玩玩。如果你在公司里不是运维,那么搭建一个单机版,基本能够满足学习目标。达到认识或者熟悉hbase的目的。首先是一些准备环境: 因为hbase是java写的,那么需要依赖jdk,那么jd

zhangshk_的博客 1490

Week10 day1 2

一、HBaes介绍 1、HBase的起源HBase的原型是Google的BigTable论文,受到了该论文思想的启发,目前作为Hadoop的子项目来开发维护,用于支持结构化的数据存储。官方网站:http://hbase.apache.org– 2006年Google发表BigTable白皮书-- 2006年开始开发HBase-- 2008年北京成功开奥运会,程序员默默地将HBase弄成了Hadoop的子项目-- 2010年HBase成为Apache顶级项目-- 现在很多公司二次开发出了很多发行版本,也开始使

qq_49621116的博客 233

大数据技术期末复习

大数据技术期末复习-简要版,包括Hadoop、HBase等

闪光桐人的博客 1128

时序列数据库 OpenTSDB (学习整理)

下载官网:http://opentsdb.net/ 官网用户指南:http://opentsdb.net/docs/build/html/index.html 学习时遇到的问题: 1、opentsdb总是被打挂? 我所遇到的问题原因和解决办法:      打到opentsdb中的数据量很大,队列满了还在往里面打,就挂了。 优化:在opentsdb和数据之间加了一层qbus,用来作为缓冲...

哆啦A梦~~ 2739

项目配置工具哪些可以容器化,哪些不需要容器化

jenkins:最好在宿主机安装,出问题容器解决,编译也比较快。【宿主机安装】 gitlab:【容器安装】 mysql:【容器安装】 redis:【容器安装】 Elasticsearch:【容器安装】 Harbor:【容器安装】 项目模块单元:【容器安装】 使用k8s统一进行容器编排。 ...

dkgee 431

opentsdb遇到的坑和优化建议

opentsdb是基于hbase的时间序列数据库,数据库能力依赖于hbase集群,是一个比较重型的监控解决方案。网上介绍比较多,但大多只是粗浅的介绍,在实际使用了一段时间后也遇到了一些坑和一些使用方法,跟大家分享下。   1.opentsdb能做什么    一个完善的监控系统应该大致包括收集,存储,展示,报警这四大块。    opentsdb主要功能还是一个时间数据库,存储收集到的监控数据,

wyfk2013的博客 8632
上一篇: Azkaban 案例
下一篇: HBase 表操作 读写流程
晟翊zzZ
博客等级 码龄7年 4粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

