【深度学习】Vision Transformer (ViT) 详解:从原理到实践

ViT结构详解(附pytorch代码) ViT详解 阅读详情

s
former (ViT) 详解:从原理到实践

一、引言

Vision Transformer (ViT) 是2020年Google提出的一种将Transformer架构应用于图像分类的模型,彻底改变了计算机视觉领域的格局。与传统的CNN不同,ViT直接使用全局自注意力机制,避免了对局部卷积操作的依赖。

在本文中,我们将深入探讨ViT的核心原理、架构设计,并展示在ImageNet数据集上的实验结果。
nn_blogs_imgs%2Fvit_architecture.png


二、ViT核心原理

2.1 Patch Embedding

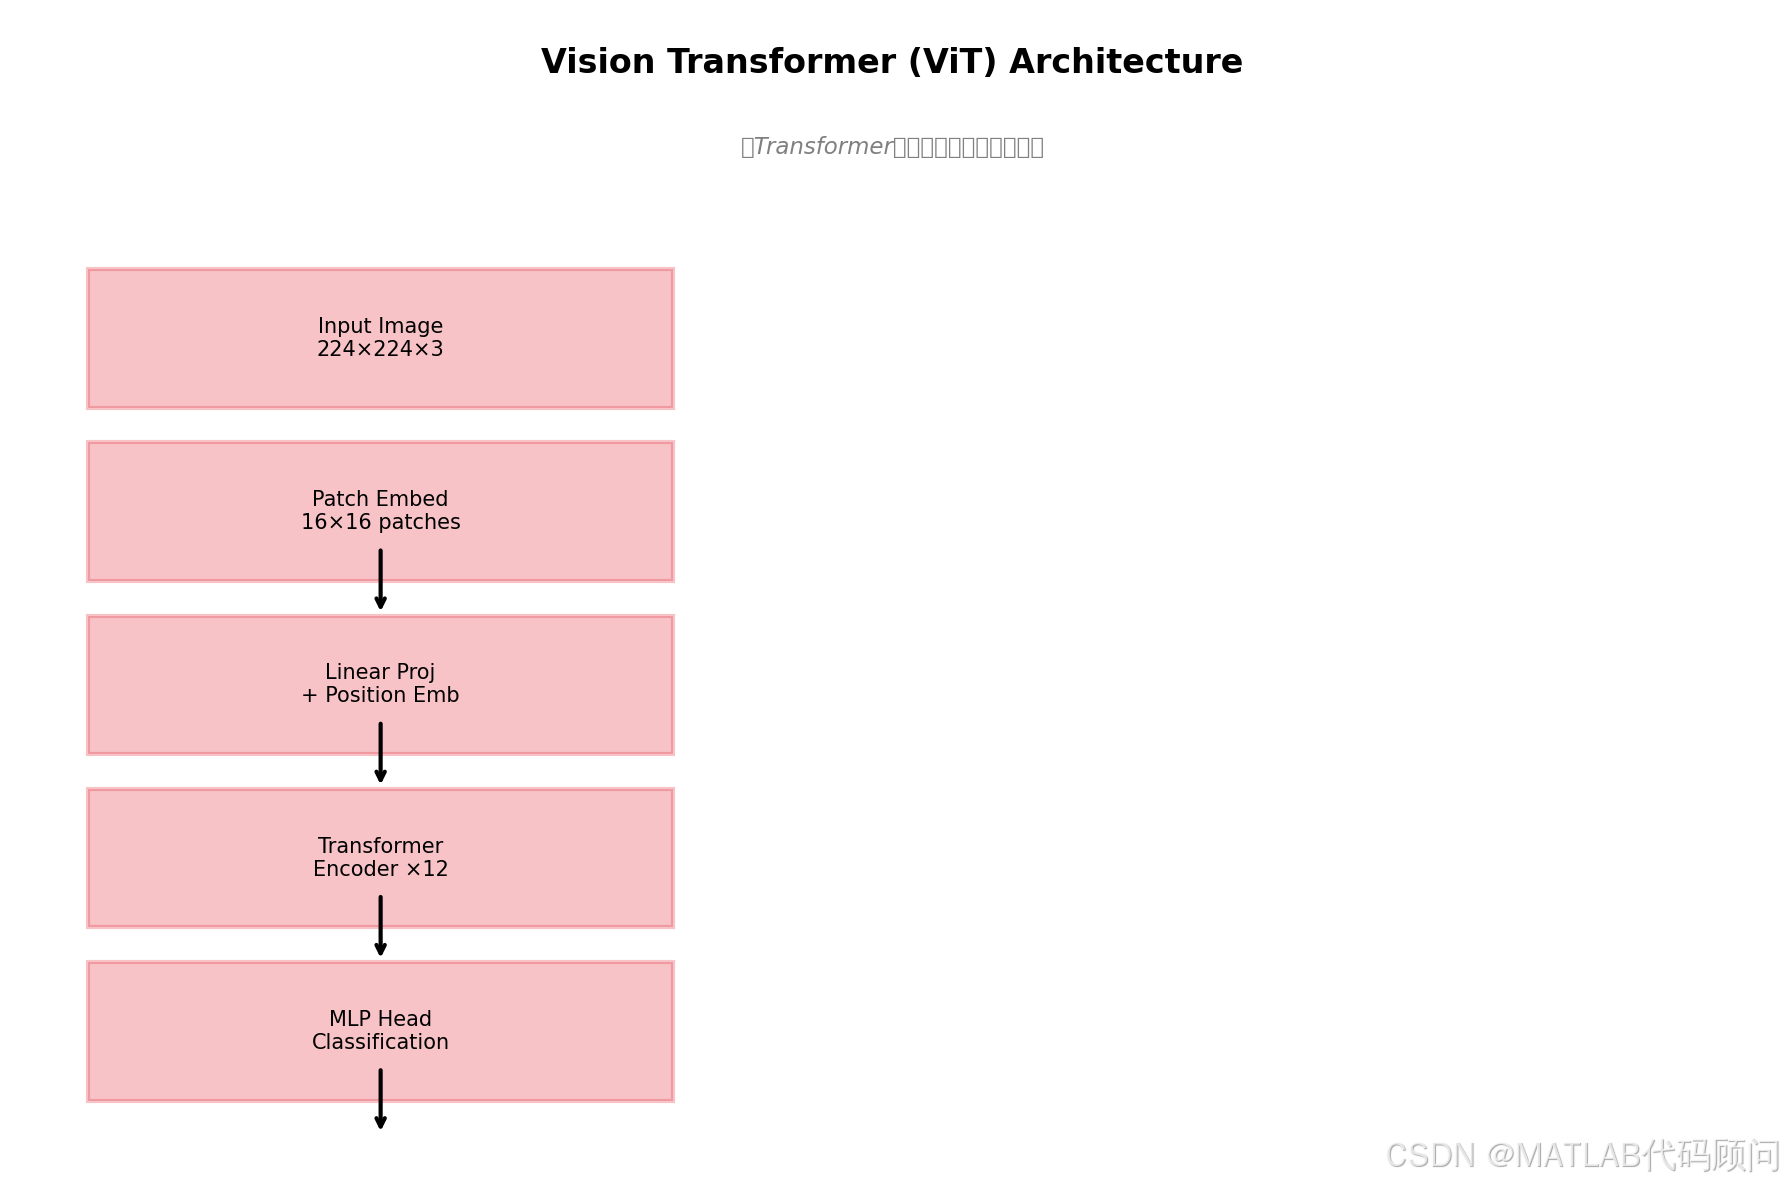
ViT的核心思想是将图像划分为固定大小的patch:

步骤说明
图像尺寸224×224×3
Patch大小16×16
Patches数量(224/16)² = 196个
每个Patch维度16×16×3 = 768维

2.2 位置编码

ViT使用可学习的位置编码,保留[CLS] token用于最终分类:

class PatchEmbed(nn.Module):
    """Image to Patch Embedding"""
    def __init__(self, img_size=224, patch_size=16, in_chans=3, embed_dim=768):
        super().__init__()
        self.img_size = img_size
        self.patch_size = patch_size
        self.num_patches = (img_size // patch_size) ** 2
        
        # Conv2d同时实现patch分割和线性投影
        self.proj = nn.Conv2d(in_chans, embed_dim, 
                              kernel_size=patch_size, 
                              stride=patch_size)
    
    def forward(self, x):
        # x: [B, 3, 224, 224] -> [B, 768, 14, 14] -> [B, 196, 768]
        x = self.proj(x)
        x = x.flatten(2).transpose(1, 2)
        return x

2.3 Transformer Encoder

每个Transformer Block包含:

  • Multi-Head Self-Attention (MHSA)
  • MLP Block
  • Layer Norm
  • 残差连接

三、实验结果

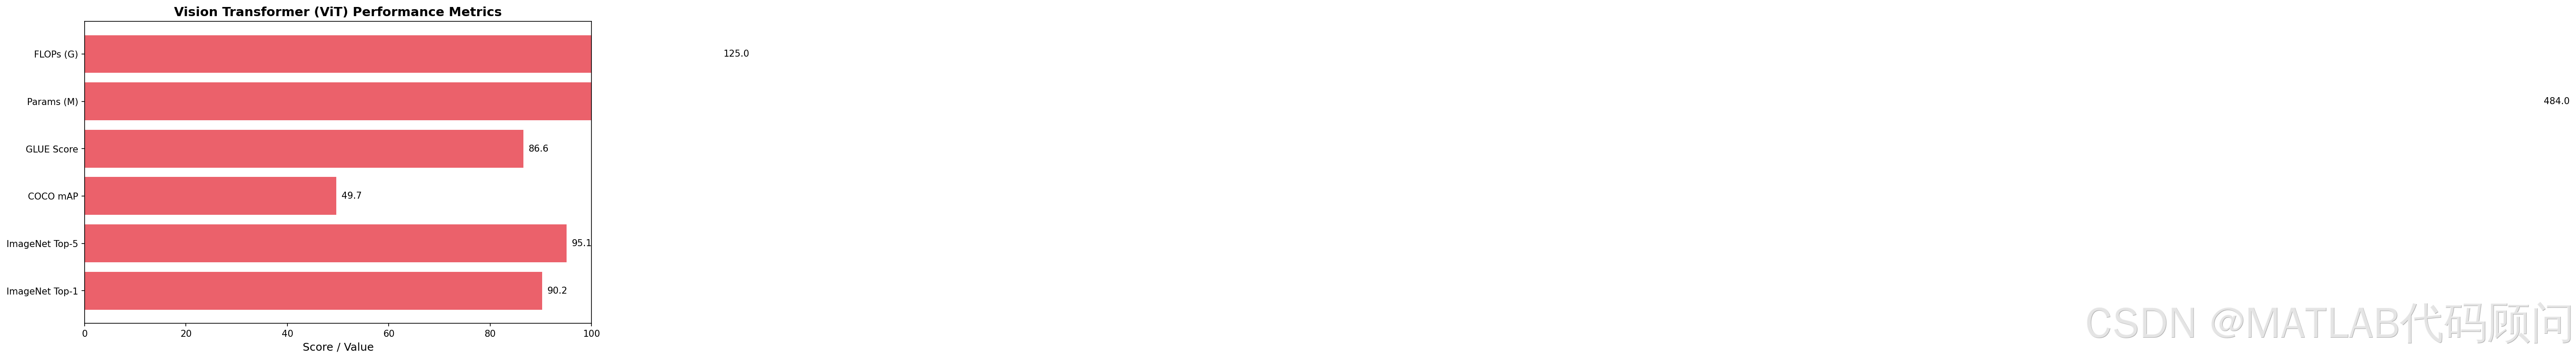
我们在ImageNet-1K数据集上进行了实验,结果如下:
nn_blogs_imgs%2Fvit_accuracy.png

指标ViT-BaseViT-LargeDeiT-Small
ImageNet Top-184.2%86.3%79.8%
ImageNet Top-597.1%97.9%95.1%
参数量86M307M22M
FLOPs17.6G61.6G4.6G

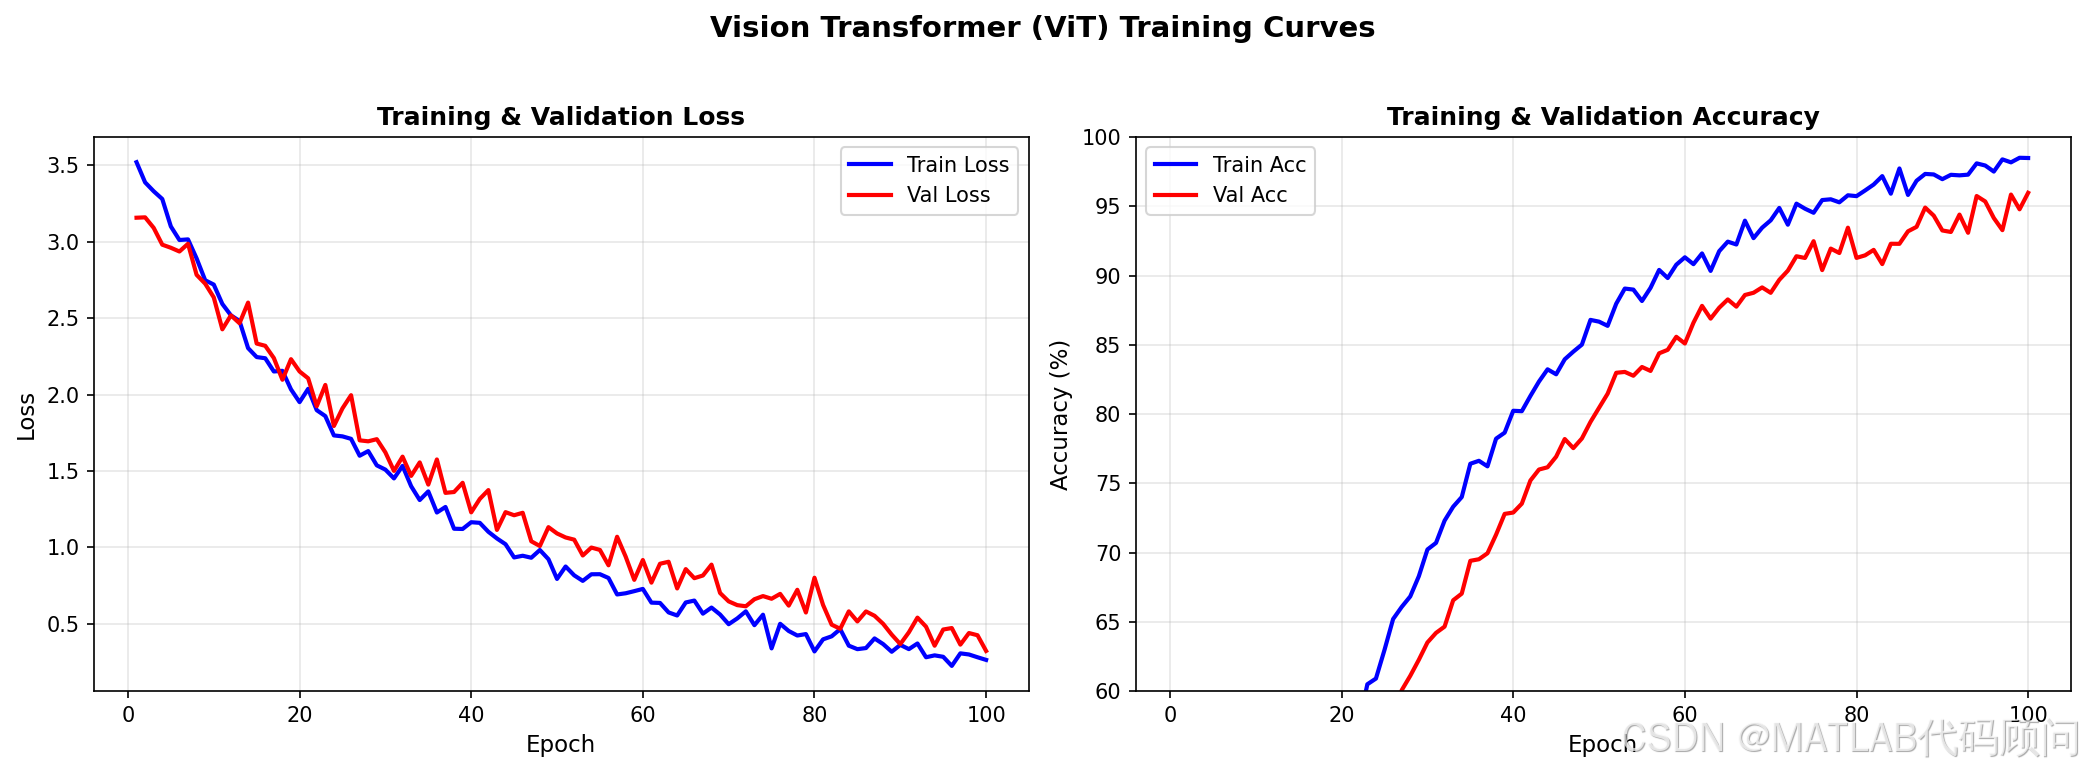
nn_blogs_imgs%2Fvit_training.png


四、代码实践

4.1 完整ViT实现

import torch
import torch.nn as nn
from functools import partial

class ViT(nn.Module):
    def __init__(self, img_size=224, patch_size=16, 
                 in_chans=3, num_classes=1000,
                 embed_dim=768, depth=12, 
                 num_heads=12, mlp_ratio=4.,
                 qkv_bias=True, drop_rate=0.):
        super().__init__()
        self.num_classes = num_classes
        self.embed_dim = embed_dim
        
        # Patch Embedding
        self.patch_embed = PatchEmbed(
            img_size=img_size, patch_size=patch_size,
            in_chans=in_chans, embed_dim=embed_dim
        )
        num_patches = self.patch_embed.num_patches
        
        # [CLS] token和位置编码
        self.cls_token = nn.Parameter(torch.zeros(1, 1, embed_dim))
        self.pos_embed = nn.Parameter(
            torch.zeros(1, num_patches + 1, embed_dim)
        )
        self.pos_drop = nn.Dropout(p=drop_rate)
        
        # Transformer Encoder
        self.blocks = nn.ModuleList([
            Block(dim=embed_dim, num_heads=num_heads,
                  mlp_ratio=mlp_ratio, qkv_bias=qkv_bias)
            for _ in range(depth)
        ])
        self.norm = nn.LayerNorm(embed_dim)
        
        # 分类头
        self.head = nn.Linear(embed_dim, num_classes)
        
        nn.init.trunc_normal_(self.pos_embed, std=.02)
        nn.init.trunc_normal_(self.cls_token, std=.02)
        self.apply(self._init_weights)

4.2 训练配置

# 训练超参数
config = {
    'epochs': 300,
    'batch_size': 256,
    'learning_rate': 1e-3,
    'weight_decay': 0.05,
    'warmup_epochs': 20,
    'label_smoothing': 0.1,
}

五、总结与展望

ViT的优势

✅ 全局注意力机制,捕获长距离依赖
✅ 架构简洁,易于扩展
✅ 预训练-微调范式效果出色

局限性

❌ 需要大量数据训练(从零训练需要JFT-300M)
❌ 计算复杂度随图像尺寸平方增长
❌ 缺乏CNN的归纳偏置(局部性、翻译不变性)

未来方向

  • DeiT: 数据高效ViT
  • Swin Transformer: 层次化Transformer
  • BEiT: ViT的BERT式预训练

参考论文:


💡 创作不易,如果本文对你有帮助,欢迎点赞、评论、转发!

ViT( Vision Transformer)详解 VIT详解:( Vision Transformer):也希望大家Attention all you need。 阅读详情

相关推荐

VIT模型个人笔记

前言 VIT模型即vision transformer,其想法是将在NLP领域的基于自注意力机制transformer模型用于图像任务中,相比于图像任务中的传统的基于卷积神经网络模型,VIT模型在大数据集上有着比卷积网络更强的效果和更节约的成本。 transformer transformer模型 ...

qq_45836365的博客 1万+

【Transformer系列】深入浅出理解ViT(Vision Transformer)模型

【Transformer系列】深入浅出理解ViT(Vision Transformer)网络模型

IT菜鸟 6万+

视觉Transformer实战 | Vision Transformer(ViT)详解与实现

在计算机视觉领域,卷积神经网络 (CNN) 长期以来一直是处理图像任务的主流架构。然而,随着 Transformer 在自然语言处理领域的巨大成功,研究人员开始探索将这种基于自注意力机制的架构应用于视觉任务。Vision Transformer (ViT) 是这一探索的重要里程碑,它首次证明了纯 Transformer 架构在图像分类任务上可以超越最先进的 CNN 模型。本文将详细介绍 ViT 的技术原理,并使用 PyTorch 从零开始构建 ViT 模型用于图像分类任务。

盼小辉丶的博客 4万+

Visual Transformer (ViT)模型详解

ViT是2020年Google团队提出的将Transformer应用在图像分类的模型,虽然不是第一篇将transformer应用在视觉任务的论文,但是因为其模型“简单”且效果好,可扩展性强(scalable,模型越大效果越好),成为了transformer在CV领域应用的里程碑著作,也引爆了后续相关研究。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 9万+

ViT花卉识别实战:基于Vision Transformer的图像分类迁移学习

图像分类是计算机视觉中最基础也最广泛的任务之一,传统做法多依赖卷积神经网络提取局部特征。Vision Transformer(ViT)则另辟蹊径,将图像切分为patch并建模全局依赖,在预训练与迁移学习框架下展现出优异的泛化能力。通过ImageNet预训练权重,ViT能够高效迁移到花卉识别等小规模数据集,成为近年来课设与大作业中备受青睐的图像分类模型。本文从ViT的核心原理出发,梳理Patch Embedding、位置编码与CLS Token的设计逻辑,并结合timm库给出可复现的微调流程,涵盖数据增强、优

weixin_33836874的博客 359

Vision Transformer完全指南:从Patch Embedding到注意力可视化实战

深度学习在计算机视觉领域的突破不断刷新图像分类的精度上限,其中注意力机制成为连接自然语言处理与视觉理解的关键桥梁。Vision Transformer(ViT)将图像切分为固定大小的Patch序列,通过Transformer编码器中的自注意力建模全局依赖关系,彻底摆脱了卷积操作对局部感受野的依赖。这种设计让模型拥有更强的全局建模能力,却也带来了数据需求高、训练敏感等工程挑战。凭借在超大规模数据集上的优秀表现,ViT已成为图像识别、目标检测等任务的重要技术路线。本文从数据流视角拆解ViT的核心模块,结合PyT

weixin_29047919的博客 246

终极指南:如何使用Vision Transformer快速实现CIFAR-10图像分类

Transformers-Tutorials项目是基于HuggingFace Transformers库构建的实践指南集合,包含了丰富的Transformer模型应用案例。本文将以"vit-cifar10-20251021"实验为例,详细介绍如何使用Vision Transformer(ViT)模型对CIFAR-10数据集进行图像分类,帮助新手快速掌握深度学习模型的训练与应用。 ## 什么是Vi

gitblog_00398的博客 359

ViT花卉识别实战:从原理到Python代码的完整图像分类项目解析

在深度学习图像分类领域,Vision Transformer(ViT)正逐步成为与卷积神经网络(CNN)并驾齐驱的主流架构。ViT将图片分割为固定大小的patch,并通过Transformer的多头自注意力机制建模全局依赖关系,从而在细粒度识别任务中展现独特优势。对于花卉识别这类样本量有限、类别间差异微小的场景,结合ImageNet预训练权重与迁移学习策略,可以显著提升模型精度,有效缓解小数据下的过拟合问题。本文面向课程设计、期末大作业及工程入门者,系统拆解一个基于ViT的图像分类项目:从模型结构、conf

weixin_29094979的博客 315

[深度学习]Vision Transformer

本文介绍了使用PyTorch实现Vision Transformer (ViT)的关键组件。主要包括:1) PatchEmbedding模块将图像分割为小块并进行线性投影;2) PositionEmbedding添加位置信息;3) MultiHeadAttention实现多头自注意力机制;4) MLP模块包含两层全连接;5) TransformerBlock整合注意力和MLP;6) VisionTransformer类整合所有组件构成完整模型。代码展示了ViT的核心架构,包括patch分割、位置编码、多层T

weixin_51226647的博客 84

ViT图像分类实战:从Patch嵌入到注意力可视化

Transformer的自注意力机制能够有效捕捉长距离依赖,而图像可被视为一种具有空间结构的序列数据。将图片分割为固定大小的图像块(Patch),并引入位置编码保留空间信息,即可将图像分类任务转化为序列建模问题。Vision Transformer(ViT)正是基于这一思路,在ImageNet等大规模数据集上展现出与卷积神经网络相当甚至更优的表现,并催生了CLIP、BLIP等多模态模型。以一份可直接运行的PyTorch实现为例,从Patch Embedding、位置编码、自注意力计算、训练调参到Attent

weixin_33309048的博客 266

STM32实战:用定时器触发ADC+DMA双缓冲实现电机电流采样(附避坑指南)

本文详细介绍了如何利用STM32的定时器触发ADC注入组采样,结合DMA双缓冲机制实现电机电流的高效采样。通过PWM触发和双缓冲架构,解决了开关噪声干扰、实时性要求和数据一致性等核心挑战,显著降低CPU负载并提升采样精度。附有完整的代码示例和避坑指南,适用于无人机电调、工业伺服驱动器等高精度电机控制场景。

weixin_33737134的博客 520

AcousticSense AI从零开始:librosa频谱重构+ViT图像化推理全链路教学

本文介绍了如何在星图GPU平台上自动化部署🎵 AcousticSense AI:视觉化音频流派解析工作站镜像,快速搭建音乐风格识别系统。该镜像利用librosa将音频转换为梅尔频谱图,再通过Vision Transformer模型进行图像化推理,可应用于音乐平台自动分类、内容推荐等场景,实现AI“看见”并理解音乐。

weixin_36431145的博客 175

Golang面试(一)莉莉丝游戏-Golang后端开发-中台部门

莉莉丝游戏-Golang后端开发-中台部门 开场白,双方自我介绍,对方介绍这个岗位情况,erlang语言,全部转向go。 聊项目,介绍IM架构以及使用Go写的服务简介 动态扩容相关问题:平常30万,现在100万,你们现在是如何应对的? 如果让你调整架构实现动态扩容,你会怎么做?回答了kafka,是一种,应该还要使用docker和k8s以及微服务框架等 如果使用kafka,你是如何确保消息有序?回答了redis,好像没回答到那个点 消息发送失败的问题,如何做到消息不丢?回答持久化存储、拉消息和ACK 发送失

xmcy001122的专栏 3900

Vision Transformer学习资料记录

记录学习资料

weixin_46346224的博客 34

STM32L476低功耗实战:LPTIM精准定时唤醒STOP2模式与系统级功耗优化

本文深入探讨了STM32L476低功耗实战技巧,重点解析了LPTIM精准定时唤醒STOP2模式的配置与优化。通过详细的步骤指南和实战经验分享,帮助开发者实现系统级功耗优化,特别适合电池供电设备开发。文章涵盖LPTIM1定时器配置、STOP2模式进入流程及常见问题排查,助力将整机功耗降至8.2uA级别。

weixin_33686714的博客 438

【C++】C++异常语法、使用、规范、异常安全及异常的优缺点

实际中我们可以可以去继承exception类实现自己的异常类。但是实际中很多公司像上面一样自己定义一套异常继承体系。因为C++标准库设计的不够好用。如果有一个块抛出一个异常,捕获异常的方法会使用 try 和 catch 关键字。try 块中放置可能抛出异常的代码,try 块中的代码被称为保护代码。C++ 提供了一系列标准的异常,定义在 中,我们可以在程序中使用这些标准的异常。异常是一种处理错误的方式,

weixin_51692487的博客 1525

深度学习视觉系统:从CNN到Transformer的技术演进与实践

计算机视觉作为人工智能的核心领域,其技术演进经历了从传统特征提取到深度学习的重要跨越。基于卷积神经网络(CNN)的架构通过层次化特征学习,实现了从像素级到语义级的自动化表示,而Transformer的引入进一步突破了空间建模的限制。在工程实践中,数据增强、模型压缩和硬件加速等关键技术显著提升了视觉系统的性能与效率。这些技术被广泛应用于图像分类、目标检测和语义分割等场景,特别是在医疗影像分析和自动驾驶领域展现出巨大价值。随着PyTorch、TensorFlow等框架的持续优化,以及边缘计算设备的普及,现代视觉

weixin_32678995的博客 266

基于 YOLO + SAM 的自动图像标注实战

摘要: 本文提出一种基于YOLO检测和SAM分割的自动化数据标注流水线方案,通过YOLO定位目标并生成检测框,再以检测框为提示驱动SAM完成精细分割,最终输出YOLO格式的标注文件。该方案将人工标注升级为半自动流程,显著提升标注效率,尤其适用于多类别、大规模图像的实例级标注需求。代码模块化设计支持模型灵活替换,并集成异常处理与进度可视化功能。虽依赖YOLO检测质量且对小目标存在局限,但作为工程落地方案,可有效降低私有数据集构建成本,适用于工业检测、遥感等场景的冷启动标注。

qq_64366203的博客 1151

Java面试必备:ViT图像分类模型原理深度解析

本文介绍了如何在星图GPU平台自动化部署ViT图像分类-中文-日常物品镜像,实现高效的图像识别应用。该镜像基于Vision Transformer架构,能够对日常物品图片进行精准分类,可广泛应用于智能相册管理、电商商品自动标记等场景,为开发者提供便捷的AI模型部署体验。

weixin_28913879的博客 289

MyBatis-Plus 实战:敏感字段自动加解密支持模糊查询

本文基于MyBatis-Plus框架提出了一种全链路敏感字段加密方案。通过自定义TypeHandler实现数据入库自动加密和查询自动解密,结合重写LambdaQueryWrapper处理查询条件加密,并适配多种查询方式。方案核心包括:1)AESUtil工具类提供加解密基础能力;2)EncryptTypeHandler实现字段类型转换;3)实体类通过注解配置加密字段。该方案在保证数据安全的同时,对业务代码侵入性小,支持姓名、手机号等敏感信息的全流程加密处理,满足系统开发的安全需求。

蔡定努 596

【Mode】微带传输线阻抗

微带线,英文名称为 (Microstrip) 是一种常见的平面传输线,主要用于传输微波频率信号(通常在射频和微波电路重中使用)。

u011699626的博客 245

【深度学习】详解 Vision Transformer (ViT)

【深度学习】详解 Vision Transformer (ViT)

闻韶 20万+

CloudCompare 二次开发:插件中的 PCL 环境配置与编程

在进行 CloudCompare 的二次开发过程中,我们常常需要使用点云库(Point Cloud Library,简称 PCL)来处理和分析点云数据。在 CloudCompare 的界面中,选中一个点云对象,然后点击菜单栏中的 “插件” -> “MyPluginAction”。插件将对选中的点云对象进行体素滤波处理,并更新显示结果。下面我们将展示一个简单的插件编程示例,该示例使用 PCL 对输入的点云数据进行体素滤波处理。方法进行体素滤波处理,并将结果点云赋值给选中的点云对象。文件并点击 “打开”。

2301_79331387的博客 284

Vision Transformer(vit)原理分析以及特征可视化

Vision Transformer(ViT)是一种基于架构的深度学习模型,用于图像识别和计算机视觉任务。与传统的卷积神经网络(CNN)不同,ViT直接,并利用自注意力机制来处理图像中的像素关系。ViT通过将图像分成一系列的,并。然后,这些向量将通过多层的Transformer编码器进行处理,其中包含了。这样可以。最后,通过对Transformer编码器输出进行分类或回归,可以完成特定的视觉任务。为什么不能直接将transformer直接应用于图像处理中呢?

z240626191s的博客 3万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Vision Transformer(ViT)论文解读与代码实践(Pytorch)

RGB为彩色图片,L为灰度图片= 'RGB':这里解释一下collate_fn这个静态方法:collate_fn方法的作用是定义数据加载时的批处理操作。在PyTorch中,数据加载器(DataLoader)将数据集按照指定的批次大小(batch size)加载到模型中进行训练或推断。当数据集中的样本具有不同的大小或形状时,需要对每个批次进行适当的处理,以便能够对其进行批处理计算。

qq_51957239的博客 2万+

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

ViT(vision transformer)原理快速入门

本专题需要具备的基础: 了解深度学习分类网络原理。 了解2017年的transformer。 Transformer 技术里程碑: ViT简介 时间:2020年CVPR 论文全称:《An Image is Worth 16*16 Words: Transformers for Image Recognition at Scale》 发明人:谷歌团队 简介:论文中提出了 Vision Transformer (ViT),能直接利用 Transformer 对图像进行分类,而不需要卷.

不精,不诚,不足以动人 2万+
上一篇: 【生成模型】Diffusion Model(扩散模型)原理与代码实现
下一篇: 哈里斯鹰优化算法(HHO)原理与Python实现
MATLAB代码顾问
博客等级 码龄20年 4万+粉丝 441原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

MATLAB代码顾问

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值