


文章目录
- 表的创建
- 表的插入
- 表的查找
- 全列查询
- 指定列查询
- 查询字段为表达式
- 按照条件进行筛选、排序、输出
- 如何将select之后输出的结果按照升序或者降序排列?
- 当limit 条件语句和 order by 条件语句同时存在时,谁先执行,谁后执行?
- where语句外定义变量问题
- 我想筛选出所有数学及格/不及格的同学的信息,我该怎么做?
- 我想筛选出所有数学成绩是78分的同学的信息,我该怎么做?
- 我想知道孙权同学数学成绩是多少分,我该怎么做?
- 我想筛选出某一列信息为空的记录,我该怎么做?
- 我想筛选出所有语文成绩不是70分的同学的信息,我该怎么做?
- 我想筛选出所有英语成绩在60分到80分之间的同学的信息,我该怎么做?
- 我想筛选出所有英语成绩等于79或90或79或89或99的同学信息,我该怎么做?
- 我想筛选出所有姓孙的同学信息,我该怎么做?
- 我想筛选出所有不姓孙的同学信息,我该怎么做?
- 我想筛选出所有姓孙的或者总成绩大于200、语文成绩小于数学成绩、英语成绩大于80 的同学信息,我该怎么做?
- 我想筛选出语文成绩高于英语成绩的同学的信息,我该怎么做?
- 我想让将所有同学的信息按照数学成绩降序输出,如果有一些同学的数学成绩相同,则按照英语升序的方式决定这些同学信息的输出顺序,如果这些同学英语成绩也相同,那就按照语文成绩升序的方式决定这些同学信息的输出顺序。我该怎么做?
- 我想按照总成绩从高到低的顺序依次输出所有同学的信息,我该怎么做?
- 我想查询所有姓孙或曹的同学的数学成绩,并将结果按数学成绩由高到低显示 ,我该怎么做?
- 现在我想输出所有记录的前五列属性信息,我该怎么做?
- 我想输出数据库中的第3到第5行信息,我该怎么做?
- 表的修改
- 表的删除
- 插入查询结果
- 聚合函数
- group by
本节目的就是要学会数据库的基本操作
表的创建
如何创建一张表呢?基础的语法格式如下
create table + 表名 + ( 属性1 + 属性1类型 , 属性2 + 属性2类型... );
举例如下:(这是最基本的语法,不再多说了)
CREATE TABLE users (
    id INT PRIMARY KEY AUTO_INCREMENT,  -- 主键,自增
    username VARCHAR(50) NOT NULL UNIQUE,  -- 用户名,不为空且唯一
    password VARCHAR(100) NOT NULL,  -- 密码,不为空
    email VARCHAR(100) UNIQUE,  -- 邮箱,唯一
    age TINYINT,  -- 年龄
    gender ENUM('male', 'female', 'other'),  -- 性别,只能是指定值
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,  -- 创建时间,默认当前时间
    status TINYINT DEFAULT 1  -- 状态,默认1(启用)
);
表的插入
表的插入操作主要是通过INSERT INTO 语句实现的,下面我们来具体介绍
如何向一张表中插入一条数据?
在 MySQL 中,向表中插入一条数据可以使用 INSERT INTO 语句,基本语法如下:
-- 完整写法(指定列名和对应值)
INSERT INTO 表名 (列1, 列2, 列3, ...) VALUES (值1, 值2, 值3, ...);

-- 简化写法(按表中所有列的顺序插入值,需包含所有列)
INSERT INTO 表名 VALUES (值1, 值2, 值3, ...);
注意:
- 如果我此次插入的记录带有这个表的所有属性信息,那么就可以不用指明属性。如果我有一些属性是缺省不传的(比如有默认值的属性或者是自增主键),那我们插入的时候就需要在表的后边儿指明要插入的属性有哪些
- 时间类型和字符串类型的数据在插入时最外面要加上引号
如何一次性向一张表中插入多条数据?
依然是使用 INSERT INTO 语句,只需在 VALUES 后包含多个值列表即可,语法如下:
INSERT INTO 表名 (列1, 列2, 列3, ...)
VALUES
    (值1, 值2, 值3, ...),
    (值1, 值2, 值3, ...),
    (值1, 值2, 值3, ...);
举例如下
insert into students (sn, name, qq)
values (1003,'铁扇.公主', '5555@qq.com'),
	   (1004, '二郎神', '666@qq.com');
如何向表中覆盖写入一个表项?
我现在想向表中插入一个数据,需求是如果没有发生冲突(主键 或者 唯一键 对应的值已经存在 )则直接插入,如果发生了冲突则覆盖插入。请问我应该如何实现?
1.使用关键字 duplicate,进行同步更新操作
在 MySQL 中,可以使用INSERT ... ON DUPLICATE KEY UPDATE语句来实现这个需求。当插入的数据与表中已存在的主键或唯一键发生冲突时,会执行更新操作(覆盖已有数据);如果没有冲突,则直接插入新数据。
INSERT INTO 表名 (列1, 列2, ...)
VALUES (值1, 值2, ...)
ON DUPLICATE KEY UPDATE
    列1 = VALUES(列1),
    列2 = VALUES(列2),
    ...;
比如下面这个例子,执行这条命令时,由于表中id=100的记录已经存在,但是该条记录的sn不是10010,name不是唐大师,因此会对该条记录进行覆盖插入,将sn 改成10010, name 改成 ‘唐大师’
INSERT INTO students (id, sn, name) VALUES (100, 10010, '唐大师')
ON DUPLICATE KEY UPDATE sn = 10010, name = '唐大师';
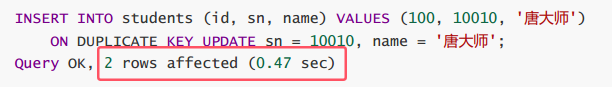
上图中画圈的语句是什么意思?
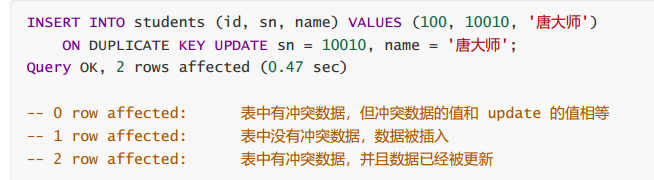
2.使用关键字 replace,进行替换插入操作
在 MySQL 中,除了 INSERT … ON DUPLICATE KEY UPDATE 外,还可以使用 REPLACE 语句实现替换插入操作。当插入的数据与表中已存在的主键或唯一键发生冲突时,REPLACE 会先删除冲突的旧记录,再插入新记录;如果没有冲突,则直接插入新数据。
replace的语法规则如下
-- 完整写法(指定列名)
REPLACE INTO 表名 (列1, 列2, ...)
VALUES (值1, 值2, ...);

-- 简化写法(按表中所有列的顺序插入值)
REPLACE INTO 表名
VALUES (值1, 值2, ...);
replace into students (id, sn, name ,qq)
values (104, 1006, '二郎真君', '6666@qq.com');`
如何通过 MySQL 函数获取上一条 SQL 语句影响的数据行数 ?
在 MySQL 中,可以使用 ROW_COUNT() 函数获取上一条 SQL 语句(如 INSERT、UPDATE、DELETE 等)影响的行数
使用格式:SELECT ROW_COUNT() AS affected_rows;或者直接show ROW_COUNT()
表的查找
表的查找主要是通过select进行的,这也是数据库中最常用的操作,下面我们就来好好认识一下。
全列查询
什么叫做全列查询?
全列查询是指在数据库查询数据时,获取表中所有列的值的操作。通过全列查询能快速获取表内全部信息,便于数据分析、数据迁移备份等工作
如何进行全列查询?
语法格式:SELECT * FROM 表名;
功能是对这张表进行全列查询,打印出表中的全部信息。
其中SELECT是指定要检索列的关键字,星号(*)代表选择所有列,FROM用于指定要查询的表名。
例如,有一个名为students的学生表,想要查询该表所有列的数据,语句如下:
SELECT * FROM students;
指定列查询
什么叫做指定列查询?
指定列查询是指在数据库查询数据时,只获取表中所有记录的某些指定列(属性)的数据
如何进行指定列查询?
SELECT + 属性名+ from + 表名
查询字段为表达式
什么叫查询字段为表达式?
在数据库查询操作中,查询字段为表达式指的是在查询语句(如 SQL 语句)的 SELECT 子句中,不只是指定单纯的列名来获取数据,而是使用由一个或多个字段、常量、运算符等组成的表达式进行数据的计算、转换或处理后再获取结果。
举个例子
mysql> select name, english, english+10 as new_english from exam_result;
在上面这段sql语句中,english+10 as new_english是啥意思呢?
意思就是将english列中的值整体加10,然后形成一个新的列,名字叫做new_english
这就是查询字段为表达式的一个例子,到这里大家可能还不是很理解,下面我们就通过更多的查询例子来理解这句话
我想输出下表中所有同学的总成绩,我应该怎么做?
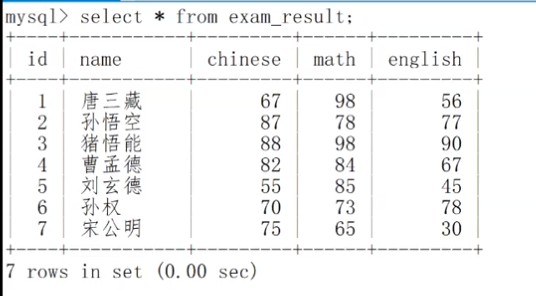
同学的总成绩应该是拿语文成绩加数学成绩加英语成绩计算得到的。因此我们在这个例子中查询的字段就是一个表达式: chinese+math+english。相应的查询语句就应该这样写:
select name, chinese+math+english from exam_result
我想检索出班级中总成绩前三名,我应该怎么做?
查询语句:select name, chinese+math+english 总分 from exam_result order by 总分 desc limit 3;
select name, chinese+math+english 总分 from exam_result这条语句的含义是从名为exam_result的表中,查询name(姓名)这一列,同时通过表达式chinese+math+english计算出每个学生的总分,并将这个计算结果列命名为 “总分”。order by 总分 desc表示按照 “总分” 这一列的值从高到低进行排序limit 3则表示只返回排序后的前 3 条记录。
查询结果:
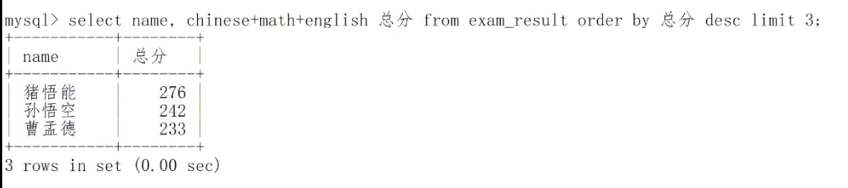
展示了 3 条记录,分别是 “猪悟能”,总分为 276;“孙悟空”,总分为 242;“曹孟德”,总分为 233。
执行反馈:3 rows in set (0.00 sec)表示查询操作返回了 3 条记录,执行耗时 0 秒。
我想筛选出班级中总成绩倒数前三名,我应该怎么做?
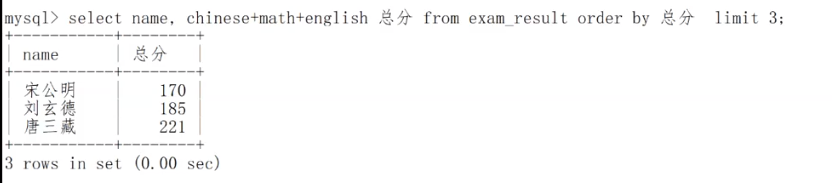
查询语句:select name, chinese+math+english 总分 from exam_result order by 总分 limit 3;
和上一个操作的区别在于,我没有加desc,表示按照 “总分” 这一列的值从低到高进行排序
我想输出表中所有不同的数学成绩,我应该怎么做?
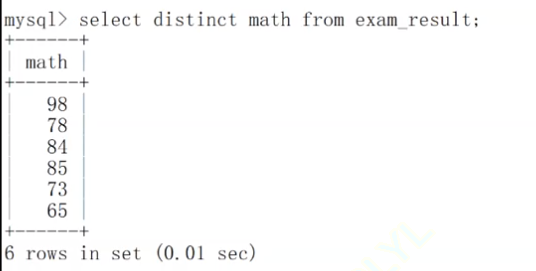
查询语句:select distinct math from exam_result;
这条 SQL 语句的作用是从名为exam_result的表中,查询math(数学成绩)这一列,并使用distinct关键字去除结果中的重复值。
我想去除表中的重复行/重复记录,我应该怎么做?
查询语句:select distinct name, math from exam_result;
该 SQL 语句从名为exam_result的表中查询name(姓名)和math(数学成绩)这两列的数据,distinct关键字用于去除查询结果中完全重复的行。比如若有多条记录的姓名和数学成绩都完全一样,只会保留一条。
按照条件进行筛选、排序、输出
语句格式:select + ... from ... + 关键字where/order by/limit + 条件
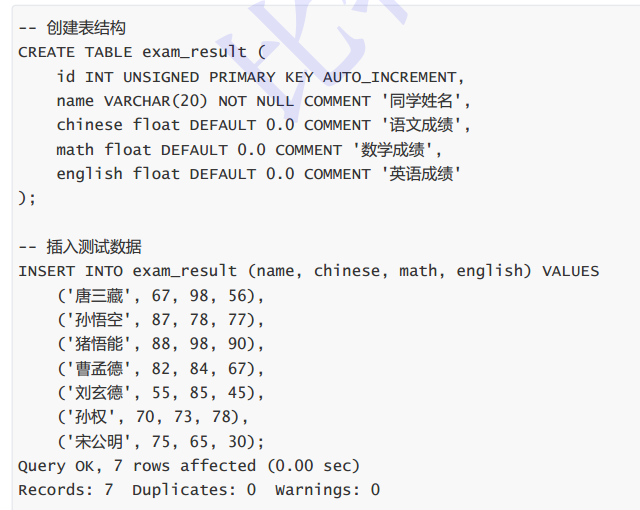
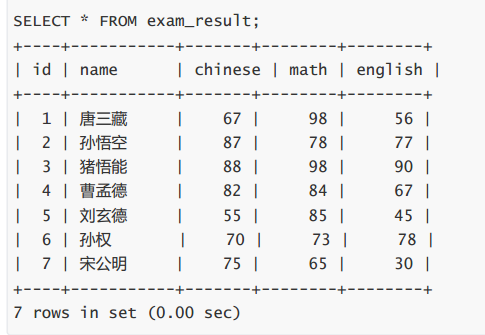
首先我们建立一个表
然后我们先来看几个原则性的问题
如何将select之后输出的结果按照升序或者降序排列?
在select语句的最后用order by + 排序属性 + asc/desc
asc和desc是啥意思?
asc/desc(升序/降序)(从低到高/从高到低)
“升序” 常见英文表达是ascending order,可简写为asc ;“降序” 常见英文表达是descending order,可简写为desc 。
当limit 条件语句和 order by 条件语句同时存在时,谁先执行,谁后执行?
答案是order by先,limit后
实验测试时,如果你的指令中limit语句写在order by 语句的前面,程序会报错,这条指令无法正常执行,如果你limit语句写在order by 语句的后面,则指令可以正常执行
where语句外定义变量问题
下图sql语句为什么会报错?应该怎么解决?
select name, english+math+chinese total from exam_result where total < 200;
ERROR 1054 (42S22): Unknown column 'total' in 'where clause'
首先先看这个问题,select name from exam_result where math>90;mysql程序是如何处理这条指令的?先处理where判断语句还是先select?
答案是先where,后select
- 遍历表结构,将表中的数据,按照where 字句(如果有的话),先筛选记录
- select需要显示的列,将筛选出的记录,按照要求显示即可
再回答最初的问题,where语句里面的total 是在select语句里面定义的,但程序运行时,先解释的是后面的where语句,此时total 还没有定义,所以他这时候报错说不认识,此时我们的解决方案就是:将where语句中的total改成english+math+chinese,这样就解决了
我想筛选出所有数学及格/不及格的同学的信息,我该怎么做?
查询语句:select name, math from exam_result where math>=60;
该语句的意思是从名为exam_result的表中,选取name(姓名)和math(数学成绩)这两列的数据。where math>=60是筛选条件,只返回数学成绩大于或等于 60 分的记录。
如果你想筛选出所有数学不及格的同学信息,只需要把条件改成math <60,即select name, math from exam_result where math<60;
我想筛选出所有数学成绩是78分的同学的信息,我该怎么做?
select name, math from exam_result where math=78;
我想知道孙权同学数学成绩是多少分,我该怎么做?
select name, math from exam_result where name='孙权';
我想筛选出某一列信息为空的记录,我该怎么做?
对应的判断方法一共三种,“<=>”、“IS”、“IS NOT”(用来筛选非空记录),使用方法如下
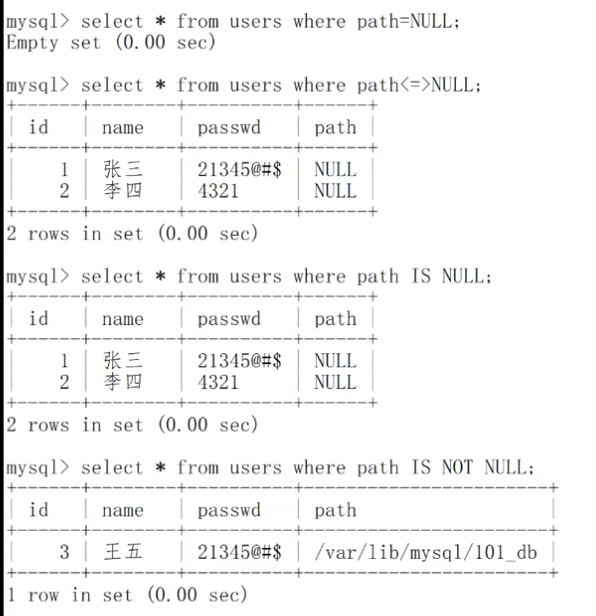
我可以用=号去比较吗?即条件语句写 where path = null?
不行!=只能用于比较两个不为空的数据,并不能比较空数据。因此数据库研发人员就专门找了一个符号“<=>”,用来判断一个数据是否为空
引入“<=>”之后,我们就可以用判断语句 where math <=> NULL来判断一个同学的数学成绩是否为空
我想筛选出所有语文成绩不是70分的同学的信息,我该怎么做?
可以用"!=“或者”<>"来判断,这俩符号都表示不等于,放在语句中就是
select name, chinese from exam_result where chinese != 70;
select name, chinese from exam_result where chinese <> 70;
我想筛选出所有英语成绩在60分到80分之间的同学的信息,我该怎么做?
一共两种条件语句
一种是where english >= 60 and english <= 80;
另一种是where english between 60 and 80;
select name, english from exam_result where english>=60 and english <=80;
select name, english from exam_result where english between 60 and 80;
我想筛选出所有英语成绩等于79或90或79或89或99的同学信息,我该怎么做?
方法1:连续几个判等语句求或运算
where english = 78 or english = 90 or english = 79 or english = 89 or english = 99
方法2:用关键词in
- 将问题转化成:我想筛选出所有英语成绩在集合{78,90,79.89,99}内的同学的信息,我该怎么做
- 用条件语句
where english in (78,90,79.89,99)
我想筛选出所有姓孙的同学信息,我该怎么做?
将问题转化成:我想筛选出姓名中含有关键词“孙”的同学信息
对于关键词搜索这个问题,MYSQL提供的解决方案是采用关键字like,实现模糊匹配,对应的条件语句为where name like '孙%'
其中LIKE 是 SQL 里用于模糊匹配的操作符,它能依据指定的模式筛选数据。
'孙%' 属于匹配模式,其中:
- 孙 是明确的匹配内容,也就是要查找以 “孙” 开头的内容。
- % 是通配符,代表任意数量(包含零个)的任意字符。
我想筛选出所有不姓孙的同学信息,我该怎么做?
条件语句为where name not like '孙%'
我想筛选出所有姓孙的或者总成绩大于200、语文成绩小于数学成绩、英语成绩大于80 的同学信息,我该怎么做?
用关键词or表示或(取并集),用关键词and表示与(取交集)
筛选姓孙的人:where name like '孙%'
筛选总成绩大于200、语文成绩小于数学成绩、英语成绩大于80的人:
where chinese<math and english>80 and chinese+math+english>200
条件语句: where (name like '孙%') or (chinese<math and english>80 and chinese+math+english>200)
我想筛选出语文成绩高于英语成绩的同学的信息,我该怎么做?
条件语句为:where chinese > english
我想让将所有同学的信息按照数学成绩降序输出,如果有一些同学的数学成绩相同,则按照英语升序的方式决定这些同学信息的输出顺序,如果这些同学英语成绩也相同,那就按照语文成绩升序的方式决定这些同学信息的输出顺序。我该怎么做?
这个其实就是一个最左匹配原则问题,优先级高的往左边写就行
SELECT * FROM exam_result ORDER BY math DESC, english ASC, chinese ASC;
我想按照总成绩从高到低的顺序依次输出所有同学的信息,我该怎么做?
select name, english+chinese+math total from exam_result order by total desc;
我有个问题,前面不是刚讲过,where语句的执行在select之前,此时别名total还没有定义,所以系统不认得,会报错。那同理你上面这样写,系统不会报错吗?
别名能否在子句使用,取决于别名被设置的位置,以及子句的执行顺序!
本题答案是不会,因为在这次语句的执行过程中,order by total desc语句的执行在select之后。为啥呢?因为order by 干的事情叫做排序,在结果没筛出来之前,对于那些对不满足筛选条件的数据,需要进行排序吗??所以order by一般是在比较靠后的位置执行的!
为了提高效率,mysql实际上是先把我要的数据先筛出来,再进行排序,也就是先执行select语句筛选,再执行order by语句排序
我想查询所有姓孙或曹的同学的数学成绩,并将结果按数学成绩由高到低显示 ,我该怎么做?
select name, math from exam_result where (name like '孙%') or (name like '曹%') order by math desc;
现在我想输出所有记录的前五列属性信息,我该怎么做?
select * from exam_result limit 5;
我想输出数据库中的第3到第5行信息,我该怎么做?
select * from exam_result limit 3,2;
或者select * from exam_result limit 3 offset 2;
请问limit后面的第一个数字代表啥意思?第二个数字呢?
第一个数字3代表从第三行开始,第二个数字2代表一共输出两行
表的修改
表的修改操作主要就是通过update语句来实现,update语句的格式为:
update + 表名 + set 属性1=value1, 属性2=value2,... where + 筛选条件
我现在想把孙悟空同学的数学成绩改成80分,我该怎么做?
这个其实我们也可以通过关键字duplicate或者replace覆盖写入一条表项来实现,但是这俩都没有update语句方便
update exam_result set math=80 where name='孙悟空';
我现在想把曹孟德同学的数学成绩改成60分,语文成绩改成70分,我该怎么做?
update exam_result set math=60,chinese=70 where name='曹孟德';
我想把总成绩排名倒数前三的同学的总成绩加30分,我该怎么做?
- 首先我们要查找出总成绩排名倒数前三的同学
order by english+math+chinese asc表示按照english(英语成绩)、math(数学成绩)和chinese(语文成绩)之和对全部同学进行升序排序
limit 3则限定只对排序后的前 3 条记录进行上述更新操作 - 然后我们再update语句将这些人的成绩加30分
update exam_result set math=math+30表示从exam_result表中,将math(数学成绩)这一列的值进行更新,更新规则是在原有的数学成绩基础上加上 30。
整个语句如下
update exam_result set math=math+30 order by english+math+chinese asc limit 3;
请问在上述指令中,update语句先执行,还是limit语句先执行?
limit语句先执行,update语句最后执行
加分之后,原来排名倒数前三的同学现在可能就不是倒数前三了,那现在我还想看原来那三名同学的全部信息,就不能用select * from … order by english+math+chinese asc limit 3来看了,那请问我该怎么做呢?
用in 语句或者and语句根据原来那仨同学的名字挨个查找
我现在想把所有同学的语文成绩更新为原来的两倍,我该怎么做?
update exam_result set chinese=chinese*2;
表的删除
我现在想把整个表里的数据都删了,我该怎么做?
delete from + 表名;
我现在想删除孙悟空同学的成绩,我该怎么做?
delete from exam_result where name='孙悟空';
delete from和truncate都可以清空表中的数据,这俩谁清的更快?
TRUNCATE 通常比 DELETE FROM更快,主要原因如下:
-
操作原理不同:
DELETE FROM是逐行删除表中的数据,会记录每条数据的删除操作到事务日志中,支持事务回滚。TRUNCATE是直接清空表数据(保留表结构),它通过重建表的方式实现(类似于删除表后重新创建),不会记录每行的删除日志,操作更高效。
-
性能差异:
- 对于大表,
TRUNCATE的速度优势非常明显,因为它不需要逐行处理数据和记录详细日志。 DELETE FROM由于要处理每行数据并写日志,删除大量数据时速度较慢。
- 对于大表,
-
其他区别:
TRUNCATE会重置自增主键(AUTO_INCREMENT)的计数器,而DELETE FROM不会。TRUNCATE不能带WHERE条件,只能清空整个表;DELETE FROM可以通过WHERE条件删除部分数据。TRUNCATE操作不能回滚(在事务中也可能无法回滚,取决于存储引擎),而DELETE FROM支持事务回滚。
总结:如果需要清空整个表且不需要回滚,TRUNCATE 是更快的选择;如果需要删除部分数据或需要事务安全,只能使用 DELETE FROM。
truncate的使用
truncate table + 表名;
比如要清空名为 students 的表,语句就是truncate table students; 另外,truncate + 表名;这种写法在一些数据库中也能生效。
truncate的特点
- 只能支持整表清空,不能仅删除某一部分
- 不支持回滚
- 会重置自增主键(AUTO_INCREMENT)的计数器
假如我现在创建了一张表,里面主键id设置了自动增加(auto_increment),插入了5个数据之后,我分别用delete 和truncate把这张表全删了,然后重新开始插入数据。请问此时插入数据时。新记录的 ID 是从6开始还是从0开始?
delete从6开始,truncate从0开始,因为TRUNCATE 会重置自增主键(AUTO_INCREMENT)的计数器,而 DELETE FROM 不会。
插入查询结果
什么叫做插入查询结果?
原本我select查询出来的结果,是要打印到显示屏上的,现在我让它输出重定向到另一个表中,这就是插入查询结果
插入查询结果的语法是?
insert into + 新表名 + select xxx from 老表名
实例:我现在想删除表中的的重复记录,保证重复的数据只能有一份留下来,我们可以采用下面的做法
-
创建一张空表 no_duplicate_table,结构和 duplicate_table 一样
CREATE TABLE no_duplicate_table LIKE duplicate_table; -
将 duplicate_table 的去重数据插入到 no_duplicate_table
INSERT INTO no_duplicate_table SELECT DISTINCT * FROM duplicate_table; -
通过重命名表,实现原子的去重操作
RENAME TABLE duplicate_table TO old_duplicate_table, no_duplicate_table TO duplicate_table;
(什么叫做原子的去重操作?)
就是说这个去重操作具有原子性
聚合函数
什么是聚合函数?聚合函数怎么用?
在 MySQL 中,聚合函数用于对一组数据进行计算并返回单一结果,通常常用于统计分析场景。常用的聚合函数如下:
-
COUNT()
统计记录行数或非 NULL 值的数量。-- 统计表中所有记录(包括 NULL) SELECT COUNT(*) FROM users; -- 统计某列非 NULL 的记录数 SELECT COUNT(email) FROM users; -- 统计某列不重复的非 NULL 值数量 SELECT COUNT(DISTINCT username) FROM users; -
SUM()
计算数值列的总和(忽略 NULL 值)。-- 计算所有用户年龄的总和 SELECT SUM(age) FROM users; -
AVG()
计算数值列的平均值(忽略 NULL 值)。-- 计算用户的平均年龄 SELECT AVG(age) FROM users; -
MAX()
获取某列的最大值(适用于数值、字符串、日期等类型)。-- 获取最大年龄 SELECT MAX(age) FROM users; -- 获取最新的创建时间 SELECT MAX(created_at) FROM users; -
MIN()
获取某列的最小值(适用类型同 MAX())。-- 获取最小年龄 SELECT MIN(age) FROM users;
注意事项:
- 聚合函数通常与
GROUP BY结合使用,对分组后的数据进行统计(如按性别分组统计平均年龄)。 - 聚合函数会自动忽略 NULL 值,除非使用
COUNT(*)(统计所有行,包括含 NULL 的行)。 - 不能在
WHERE子句中直接使用聚合函数,需用HAVING子句对聚合结果进行筛选(HAVING需与GROUP BY配合)。
示例(结合 GROUP BY 和 HAVING):
-- 按性别分组,统计每组人数,并筛选人数大于 10 的分组
SELECT gender, COUNT(*) AS total
FROM users
GROUP BY gender
HAVING total > 10;
了解了常见的聚合函数,下面我们再来练习一下他们的常见使用
如何查看一张表中有多少条记录?
select count(*) from + 表名
或者我们也可以用
select count(1) from + 表名
注意:在 MySQL 中,COUNT(1)的工作原理是:对查询结果集中的每一行,都返回一个固定值 1(不依赖任何实际列),然后统计这些 1 的总数量,最终结果就是符合条件的记录总条数。count(1)和 count(*)含义完全相同,没有区别。
我想知道我们班数学成绩在100分以上的同学有多少个,我该怎么做?(我不想知道是哪些人,我只想知道有多少个)
select count(*) from exam_result where math >=100
如果你还想知道是哪些人,你就可以用select * from exam_result where math >=100
我想知道我们班这次考试有数学成绩(数学成绩那一栏不为空)的同学的数量,我该怎么做?
select COUNT(math) from exam_result;
我想知道我们班这次考试数学成绩一共有多少个(多个重复的数学成绩算一个),我该怎么做?
select COUNT(distinct math) from exam_result;
那我要是还想知道这些数学成绩分别是哪些呢?
select distinct math from exam_result;
我想知道我们班这次考试所有人的数学成绩加一起等于多少,我该怎么做?
select SUM(math) from exam_result;
我想知道我们班这次考试所有数学及格的人的数学成绩加一起等于多少,我该怎么做?
select SUM(math) from exam_result where math >=60;
我想知道我们班这次数学考试的平均分,我该怎么做?
可以用sum(math)/count(*)来算,也可以直接用求平均值的聚类函数avg(math)来算
我想知道我们班这次考试谁英语考的最高,我该怎么做?
可以用select * from exam_result order by englsih desc limit 1
也可以直接调聚合函数max
select max(english) from exam_result
group by
group by是用来干啥的?
GROUP BY 是 MySQL 中用于对查询结果进行分组的关键字,其核心作用是将表中数据按照指定的列或表达式进行分组,使相同值的记录被归为一组,以便对每个分组进行聚合分析(如统计、求和、平均值等)。
举个简单的例子,你校长拿到的是全校的学生成绩,但是要分别计算出每个班的平均分,那这个时候应该怎么办呢?这时候就可以使用 GROUP BY语句
SELECT
  class,  -- 分组字段
  COUNT(*) AS student_count,  -- 统计每个班级的人数
  AVG(score) AS avg_score  -- 计算每个班级的平均成绩
FROM student
GROUP BY class;  -- 按班级分组
关键字having和where的区别
在 MySQL 中,WHERE 和 HAVING 都用于筛选数据,但having常常与group by搭配使用,为什么呢?下面我们就来谈谈WHERE 和 HAVING 的区别
1. 执行时机不同(where语句的执行非常靠前,而having语句的执行则比较靠后)
-
WHERE:在数据分组之前执行,用于筛选原始数据中符合条件的行。
它作用于表中的每一行记录,过滤后的数据才会进入GROUP BY分组流程。 -
HAVING:在数据分组之后执行,用于筛选分组后的结果(即对GROUP BY处理后的各组进行过滤)。
它作用于分组后的每个组,只保留符合条件的组。
2. 适用条件不同(having的执行时机靠后,所以可以用select语句中定义的字段,而where不行)
-
WHERE:- 只能使用表中的原始字段作为筛选条件(不能直接使用聚合函数,因为此时还未分组,聚合结果不存在)。
- 不能使用
GROUP BY中定义的别名或聚合函数的结果。
-
HAVING:- 通常使用聚合函数或
GROUP BY中的分组字段作为筛选条件(因为它处理的是分组后的结果)。 - 可以使用
SELECT中定义的聚合函数别名(因为having语句的执行在select语句之后)
- 通常使用聚合函数或
3. 使用场景不同(where用于分组前过滤,having用于分组后过滤)
-
WHERE:用于在分组前过滤不需要的记录,减少参与分组的数据量。
例如:筛选某个时间段内的订单、过滤年龄大于 18 岁的用户等。 -
HAVING:用于在分组后过滤不符合条件的组,通常结合聚合结果使用。
例如:筛选平均成绩大于 80 分的班级、订单总金额超过 1000 元的用户等。
示例对比
假设有一张 student 表(包含 class 班级、name 姓名、score 成绩字段),需求:统计每个班级中,成绩及格(>60)的学生人数,且只保留人数超过 20 人的班级。
SELECT
  class,
  COUNT(*) AS pass_count  -- 统计每个班级的及格人数
FROM student
WHERE score > 60  -- 1. 先筛选出成绩及格的学生(分组前过滤)
GROUP BY class    -- 2. 按班级分组
HAVING pass_count > 20;  -- 3. 再筛选出及格人数超20的班级(分组后过滤)
WHERE score > 60:先排除不及格的学生,只保留及格的记录。HAVING pass_count > 20:对分组后的每个班级,只保留及格人数超过 20 人的组。
总结
| 区别 | WHERE | HAVING |
|---|---|---|
| 执行时机 | 分组前 | 分组后 |
| 作用对象 | 原始行记录 | 分组后的组 |
| 支持的条件 | 只能用原始字段 | 可以用聚合函数或分组字段 |
| 配合的关键字 | 可独立使用,或在 GROUP BY 前使用 | 必须与 GROUP BY 配合使用 |
简单说:WHERE 管“行”,HAVING 管“组”;WHERE 先筛数据,HAVING 后筛分组。
group by怎么用?
select ... from ... group by + 前面出现过的非聚合列;
group by语句的优先级如何?
group by语句的执行在一切聚合函数之前,即永远是先分组,再对组内数据做统计处理
group by的优先级比having高,比select高,但是依然没有where高
我现在有一个sql类型的数据库文件,我想向mysql中导入这个数据库,导进来之后我还想看看里面有哪些表,表里有哪些数据,我该怎么做?
-
导入这个数据库
source + 该数据库文件;(尽量带上完整路径) -
查看数据库中有哪些表
SHOW TABLES; -
查看各种表结构
desc + 表名; -
查看各个表的内容
select * from +表名;
下面是我们导入的一个公司数据库,后面的问题都是基于这张表问的
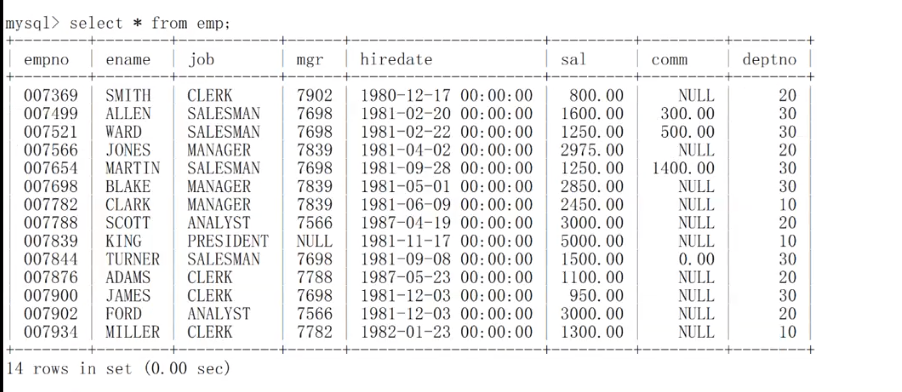
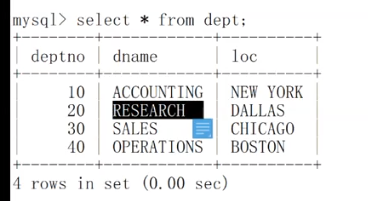
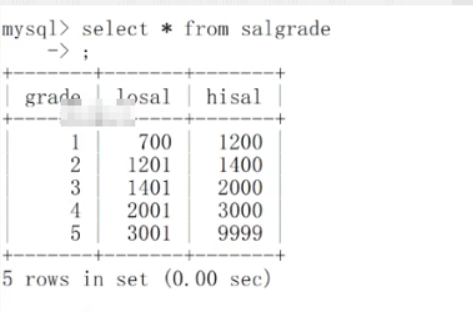
请问如何输出每个部门的平均工资和最高工资?
(1)显示最高工资:select deptno , max(sal) from emp group by deptno;
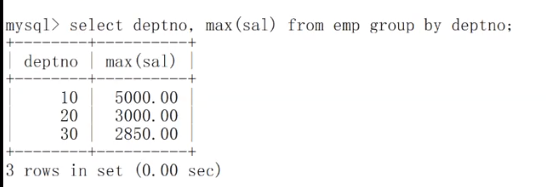
这条指令中各种语句的执行顺序是什么?
先执行select语句进行筛选,筛选之后执行group by分组语句,最后才执行avg()和max()这种聚合函数
select后面紧跟的那个deptno作用是啥?
让输出结果时把deptno这一栏也顺带输出一下
(2)显示平均工资:select deptno, avg(sal) from emp group by deptno;
为什么select deptno, job, avg(sal), max(sal) from emp group by deptno, job;中GROUP BY 后面带deptno,不带job会报错?
这是因为在标准 SQL 语法规则中,GROUP BY子句要遵循 “出现在SELECT列表里的非聚合列,通常需要包含在GROUP BY子句中” 的原则
在查询语句select deptno, job, avg(sal), max(sal) from emp group by deptno, job;中,avg(sal)和max(sal)是聚合函数计算结果,而deptno(部门编号)和job(职位)是非聚合列。当GROUP BY后面只带deptno,不带job时,数据库无法明确对于不同job的数据该如何归组处理,也就无法确定每个组对应的job值,导致出现错误 。简单来说,就是查询结果中要展示job列,但分组时却没按job来分,数据库不知道该取组内哪个job值放到结果里,所以报错。
请问如何输出所有平均工资低于2000的部门以及该部门的平均工资?
select deptno, avg(sal) as 平均工资 from emp group by deptno having 平均工资>2000;
select deptno, avg(sal) as 平均工资:从emp表中选取deptno(部门编号)列,同时使用avg(sal)计算sal(工资)列的平均值,并将其别名为 “平均工资”。from emp:指定数据来源表为emp表。group by deptno:按照deptno对数据进行分组,这样avg(sal)会计算每个部门的平均工资。having 平均工资>2000:having子句用于对分组后的结果进行筛选,这里筛选出平均工资大于 2000 的分组。
提问:上面这条指令中,各语句的执行顺序是什么?having语句的执行顺序排在第几位?
这条 SQL 语句的执行顺序如下
-
FROM emp
首先确定数据来源表为emp,加载表中的所有原始数据。 -
GROUP BY deptno
根据deptno(部门编号)对emp表的数据进行分组,将相同部门编号的记录归为一组。 -
执行聚合函数
avg(sal)
对每个分组计算平均工资(avg(sal)),这是SELECT子句中聚合操作的核心计算过程。 -
SELECT deptno, avg(sal) as 平均工资
从分组后的结果中选择需要返回的字段:分组字段deptno和聚合计算结果avg(sal)(并命名为别名平均工资)。 -
HAVING 平均工资 > 2000
最后根据HAVING条件筛选分组结果,只保留平均工资大于 2000 的分组。
总结执行顺序:
FROM → GROUP BY → 计算聚合函数 → SELECT(确定返回字段及别名) → HAVING
因此,HAVING 语句在整个查询过程中是最后执行的
这个having是干啥的?为什么上面的条件判断语句不用where呢?(前面说过一次,这里碰到了再说一次)
where和having的区别是什么?
where 和 having 起效果的时间是不一样的!!
where语句从原始表中筛选的时候起效果
having语句其效果的时机就比较晚,它要等到把数据全部取出来,然后分组完成,甚至聚合统计之后,再对中间数据做筛选
在本例select deptno, avg(sal) as 平均工资 from emp group by deptno having 平均工资>2000;中,where语句执行次序在select语句之前,having语句执行次序在select语句之后
既然这俩语句功能相似,但执行次序不同,能不能在一条指令中同时使用where和having语句呢? 当然可以
总结来说就是,where语句执行顺序比较早,having比较晚,本题中适合晚一些判断,于是用having
 463


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


