


😎 知识点概览
为了方便后续回顾该项目时能够清晰的知道本章节讲了哪些内容,并且能够从该章节的笔记中得到一些帮助,所以在完成本章节的学习后在此对本章节所涉及到的知识点进行总结概述。
本章节为【学成在线】项目的 day11 的内容
- 基于
Java客户端实现 DSL 搜索 - 搭建
ElasticSearch集群环境 - 使用
Logstash自动创建ElasticSearch的索引、数据文档 - 基于
ElasticSearch开发搜索服务接口
目录
内容会比较多,小伙伴们可以根据目录进行按需查阅。
一、搜索管理
0x01 准备环境
1、创建映射
创建 xc_course 索引库,方式如下
post:http://localhost:9200/xc_course/doc/_mapping
{
    "properties": {
        "description": {
            "type": "text",
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_smart"
        },
        "name": {
            "type": "text",
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_smart"
        },
        "pic": {
            "type": "text",
            "index": false
        },
        "price": {
            "type": "float"
        },
        "studymodel": {
            "type": "keyword"
        },
        "timestamp": {
            "type": "date",
            "format": "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd||epoch_millis"
        }
    }
}
2、插入原始数据
向 xc_course/doc 中插入以下三个文档数据:
PUT:http://localhost:9200/xc_course/doc/1
{
    "name": "Bootstrap开发",
    "description": "Bootstrap是由Twitter推出的一个前台页面开发框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、JS程序代码,可以帮助开发者(尤其是不擅长页面开发的程序人员)轻松的实现一个不受浏览器限制的精美界面效果。",
    "studymodel": "201002",
    "price":38.6,
    "timestamp":"2018-04-25 19:11:35",
 "pic":"group1/M00/00/00/wKhlQFs6RCeAY0pHAAJx5ZjNDEM428.jpg"
}
PUT:http://localhost:9200/xc_course/doc/2
{
	"name": "java编程基础",
"description": "java语言是世界第一编程语言,在软件开发领域使用人数最多。",
"studymodel": "201001",
"price":68.6,
"timestamp":"2018-03-25 19:11:35",
"pic":"group1/M00/00/00/wKhlQFs6RCeAY0pHAAJx5ZjNDEM428.jpg"
}
PUT:http://localhost:9200/xc_course/doc/3
{
    "name": "spring开发基础",
    "description": "spring 在java领域非常流行,java程序员都在用。",
    "studymodel": "201001",
    "price":88.6,
    "timestamp":"2018-02-24 19:11:35",
  "pic":"group1/M00/00/00/wKhlQFs6RCeAY0pHAAJx5ZjNDEM428.jpg"
}
3、简单的搜索一下
简单搜索就是通过 url 进行查询,以 get 方式请求 ES。
格式:GET …/_search?q=…
q:搜索字符串。
例子:?q=name:spring
搜索name中包括spring的文档。
0x02 DSL 搜索
DSL(Domain Specific Language) 是 ES 提出的基于 json 的搜索方式,在搜索时传入特定的 json 格式的数据来完成不同的搜索需求。
DSL 比 URI (在url传递搜索参数) 搜索方式功能强大,在项目中建议使用 DSL 方式来完成搜索。
1、查询所有文档
查询所有索引库的文档。
发送:post http://localhost:9200/_search
查询指定索引库 指定类型 下的文档。(通过使用此方法)
发送:post http://localhost:9200/xc_course/doc/_search
{
    "query": {
    	"match_all": {}
    },
    "_source" : ["name","studymodel"]
}
_source:
source源过虑设置,指定结果中所包括的字段有哪些。
搜索结果:
{
    "took": 9,
    "timed_out": false,
    "_shards": {
        "total": 1,
        "successful": 1,
        "skipped": 0,
        "failed": 0
    },
    "hits": {
        "total": 3,
        "max_score": 1.0,
        "hits": [
            {
                "_index": "xc_course",
                "_type": "doc",
                "_id": "1",
                "_score": 1.0,
                "_source": {
                    "studymodel": "201002",
                    "name": "Bootstrap开发"
                }
            },
            {
                "_index": "xc_course",
                "_type": "doc",
                "_id": "2",
                "_score": 1.0,
                "_source": {
                    "studymodel": "201001",
                    "name": "java编程基础"
                }
            },
            {
                "_index": "xc_course",
                "_type": "doc",
                "_id": "3",
                "_score": 1.0,
                "_source": {
                    "studymodel": "201001",
                    "name": "spring开发基础"
                }
            }
        ]
    }
}
结果说明:
| 字段名称 | 描述 |
|---|---|
| took | 本次操作花费的时间,单位为毫秒。 |
| timed_out | 请求是否超时 |
| _shards | 说明本次操作共搜索了哪些分片 |
| hits | 搜索命中的记录 |
| hits.total | 符合条件的文档总数 hits.hits :匹配度较高的前N个文档 |
| hits.max_score | 文档匹配得分,这里为最高分 |
| _score | 每个文档都有一个匹配度得分,按照降序排列。 |
| _source | 显示了文档的原始内容。 |
使用JAVA 客户端实现:
-
创建搜索请求对象
-
指定类型(部分版本不需要指定类型,这里以
6.2.1为例) -
构建搜索源对象
-
配置搜索方式,设置需要过滤字段
-
向搜索请求中设置搜索源
-
执行搜索,向ES发起
http请求 -
搜索结果
asd as -
匹配到的总记录数
-
得到匹配度高的文档
-
遍历结果,获取
SearchHit对象中的属性,输出或者存档。
具体代码如下:
@SpringBootTest
@RunWith(SpringRunner.class)
public class TestSearch {
    @Autowired
    RestHighLevelClient client;

    //搜索type下的全部记录
    @Test
    public void testSearchAll() throws IOException {
        //获取搜索请求对象,并且设置类型
        SearchRequest searchRequest = new SearchRequest("xc_course");
        searchRequest.types("doc");
        SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();

        //设置搜索方式
        searchSourceBuilder.query(QueryBuilders.matchAllQuery());

        //配置source源字段过虑,1显示的,2排除的
        searchSourceBuilder.fetchSource(new String[]{"name","studymodel"}, new String[]{});

        //将搜索源配置到搜索请求中,执行搜索,获取搜索响应结果
        searchRequest.source(searchSourceBuilder);
        SearchResponse searchResponse = client.search(searchRequest);

        //获取所有搜索结果、总匹配数量
        SearchHits hits = searchResponse.getHits();
        long totalHits = hits.getTotalHits();

        //筛选出匹配度高的文档记录
        SearchHit[] searchHits = hits.getHits();

        //遍历结果
        for (SearchHit hit : searchHits) {
            String index = hit.getIndex();
            String type = hit.getType();
            String id = hit.getId();
            float score = hit.getScore();
            String sourceAsString = hit.getSourceAsString();
            Map<String, Object> sourceAsMap = hit.getSourceAsMap();
            String name = (String) sourceAsMap.get("name");
            String studymodel = (String) sourceAsMap.get("studymodel");
            String description = (String) sourceAsMap.get("description");
            System.out.println(name);
            System.out.println(studymodel);
            System.out.println(description);
        }
    }
}
2、分页查询
ES 支持分页查询,传入两个参数:from 和 size。
-
form:表示起始文档的下标,从0开始。
-
size:查询的文档数量。
发送:post http://localhost:9200/xc_course/doc/_search
{
    "from" : 0,
    "size" : 1,
    "query": {
    	"match_all": {}
    },
    "_source" : ["name","studymodel"]
}
使用JAVA 客户端实现:
 //分页查询
@Test
public void testSearchPage() throws IOException {
    //获取搜索请求对象,并且设置类型
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();

    //设置搜索方式
    searchSourceBuilder.query(QueryBuilders.matchAllQuery());

    //ES这里是按起始坐标来实现分页查询,所以我们要指定一个页码
    int pageNum = 1;
    int size = 2;
    //通过页码和查询数量得出起始位置
    int fromNum = (pageNum - 1) * size;
    //分页查询,设置起始下标,从0开始
    searchSourceBuilder.from(0);
    //每页显示个数
    searchSourceBuilder.size(size);
    //配置source源字段过虑,1显示的,2排除的
    searchSourceBuilder.fetchSource(new String[]{"name","studymodel"}, new String[]{});

    //将搜索源配置到搜索请求中,执行搜索,获取搜索响应结果
    searchRequest.source(searchSourceBuilder);
    SearchResponse searchResponse = restHighLevelClient.search(searchRequest);

    //获取所有搜索结果、总匹配数量
    SearchHits hits = searchResponse.getHits();
    long totalHits = hits.getTotalHits();

    //筛选出匹配度高的文档记录
    SearchHit[] searchHits = hits.getHits();

    //遍历结果
    for(SearchHit hit : searchHits){
        System.out.println(hit.toString());
    }
}
3、Term Query
Term Query 为精确查询,在搜索时会整体匹配关键字,不再将关键字分词。
发送:post http://localhost:9200/xc_course/doc/_search
{
    "query": {
        "term" : {
            "name": "spring"
        }
    },
    "_source" : ["name","studymodel"]
}
上边的搜索会查询 name 包括 spring 这个词的文档。
JAVA客户端实现:
/**
     * Term Query 精确查询
     */
@Test
public void TestSearchTermQuery() throws IOException {
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //设置查询类型为termQuery,精确匹配name中包含spring的文档
    searchSourceBuilder.query(QueryBuilders.termQuery("name","spring"));//source源字段过虑

    //不指定过滤条件则默认显示查询到的文档的所有字段
    searchSourceBuilder.fetchSource(new String[]{}, new String[]{});

    //设置搜索源并获取搜索结果
    searchRequest.source(searchSourceBuilder);
    SearchResponse searchResponse = restHighLevelClient.search(searchRequest);

    //获取搜索结果
    //  .getHits() 取本次所有匹配结果
    //  .getHits().getHits() 筛选出匹配度高的文档记录
    SearchHits hits = searchResponse.getHits();
    long totalHits = hits.getTotalHits();
    //筛选匹配度最高的结果
    SearchHit[] searchHits = hits.getHits();

    System.out.println("结果数量为: " + totalHits);
    //输出搜索结果
    for(SearchHit hit : searchHits){
        System.out.println(hit.getSourceAsMap());
    }
}
4、根据id精确匹配
ES提供根据多个id值匹配的方法:
post: http://127.0.0.1:9200/xc_course/doc/_search
{
    "query": {
        "ids" : {
            "type" : "doc",
            "values" : ["3", "4", "100"]
        }
    }
}
JAVA客户端实现:
String[] split = new String[]{"1","2"};
List<String> idList = Arrays.asList(split);
searchSourceBuilder.query(QueryBuilders.termsQuery("_id", idList));
5、match query (匹配单个字段)
(1) 基本使用
match query 即全文检索,它的搜索方式是先将搜索字符串分词,再使用各各词条从索引中搜索。
match query 与 Term query 区别是 match query 在搜索前先将搜索关键字分词,再拿各各词语去索引中搜索。
需求:检索 name 字段中包含 spring开发 的文档,并且结果只显示该文档的 name 字段
发送:post http://localhost:9200/xc_course/doc/_search
{
    "query": {
        "match": {
            "name": {
                "query": "spring开发",
                "operator": "or"
            }
        }
    },
	"_source" : ["name"]
}
-
query:搜索的关键字,对于英文关键字如果有多个单词则中间要用半角逗号分隔,而对于中文关键字中间可以用逗号分隔也可以不用。
-
operator:
or表示 只要有一个词在文档中出现则就符合条件,and表示每个词都在文档中出现则才符合条件
operator:or 表示 只要有一个词在文档中出现则就符合条件, and 表示每个词都在文档中出现则才符合条件
搜索结果:
"hits": [
    {
        "_index": "xc_course",
        "_type": "doc",
        "_id": "3",
        "_score": 1.3802519,
        "_source": {
            "name": "spring开发基础"
        }
    },
    {
        "_index": "xc_course",
        "_type": "doc",
        "_id": "1",
        "_score": 0.52354836,
        "_source": {
            "name": "Bootstrap开发"
        }
    }
]
上边的搜索的执行过程是:
1、将 spring开发 分词,分为 spring、开发 两个词
2、再使用 spring 和开发两个词去匹配索引中搜索。
3、由于设置了 operator 为 or,只要有一个词匹配成功则就返回该文档。
我们将 operator 设置为 and 再次进行搜索
"hits": [
    {
        "_index": "xc_course",
        "_type": "doc",
        "_id": "3",
        "_score": 1.3802519,
        "_source": {
            "name": "spring开发基础"
        }
    }
]
从结果中我们可以看到,使用 and 进行搜索后,ES会匹配指定的字段包含 spring、开发 两个词的结果。
JAVA客户端实现:
/**
     * 根据关键字搜索
     * @throws IOException
     */
@Test
public void testMatchQuery() throws IOException {
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //source源字段过虑
    searchSourceBuilder.fetchSource(new String[]{"name"}, new String[]{});
    //设置过滤器,匹配关键字
    searchSourceBuilder.query(QueryBuilders.matchQuery("description", "spring开发").operator(Operator.OR));
    searchRequest.source(searchSourceBuilder);

    //执行搜索请求
    SearchResponse searchResponse = client.search(searchRequest);
    SearchHits hits = searchResponse.getHits();
    SearchHit[] searchHits = hits.getHits();

    //输出搜索结果
    for(SearchHit hit : searchHits){
        System.out.println(hit.getSourceAsMap());
    }
}
(2) minimum_should_match
上边使用的 operator = or 表示只要有一个词匹配上就得分,如果实现三个词至少有两个词匹配如何实现?使用 minimum_should_match 可以指定文档匹配词的占比:
比如搜索语句如下:
{
    "query": {
        "match": {
            "description": {
                "query": "spring开发框架",
                "minimum_should_match": "80%"
            }
        }
    }
}
spring开发框架 会被分为三个词:spring、开发、框架
设置 minimum_should_match:80% 表示,三个词在文档的匹配占比为 80%,即 3*0.8=2.4,向上取整得2,表示至少有 两个词 在文档中要匹配成功。
对应的 RestClient 如下:
//匹配关键字
MatchQueryBuilder matchQueryBuilder = QueryBuilders.matchQuery("description", "前台页面开发框架 架构").minimumShouldMatch("80%");//设置匹配占比
searchSourceBuilder.query(matchQueryBuilder);
6、multi query (匹配多个字段)
上边学习的 termQuery 和 matchQuery 一次只能匹配一个 Field,本节学习 multiQuery,一次可以匹配多个字段。
(1) 基本使用
单项匹配是在一个 field 中去匹配,多项匹配是拿关键字去多个 Field 中匹配,例子如下:
发送:post http://localhost:9200/xc_course/doc/_search
拿关键字 spring css去匹配 name 和 description 字段。
{
    "query": {
        "multi_match": {
            "query": "spring css",
            "minimum_should_match": "50%",
            "fields": [
                "name",
                "description"
            ]
        }
    }
}
(2) 提升 boost (权重)
匹配多个字段时可以提升字段的 boost(权重)来提高得分
例子:提升 boost之前,执行下边的查询:
{
    "query": {
        "multi_match": {
            "query": "spring框架",
            "minimum_should_match": "50%",
            "fields": [
                "name",
                "description"
            ]
        }
    }
}
通过查询发现 Bootstrap 排在前边。
提升 boost,通常关键字匹配上 name 的权重要比匹配上 description 的权重高,这里可以对name 的权重提升。
{
    "query": {
        "multi_match": {
            "query": "spring框架",
            "minimum_should_match": "50%",
            "fields": [
                "name^10",
                "description"
            ]
        }
    }
}
name^10 表示权重提升 10 倍,执行上边的查询,发现 name 中包括 spring 关键字的文档排在前边。
JAVA 客户端:
MultiMatchQueryBuilder multiMatchQueryBuilder = QueryBuilders.multiMatchQuery("spring框架","name", "description")
.minimumShouldMatch("50%");
multiMatchQueryBuilder.field("name",10);//提升boost
7、布尔查询
布尔查询对应于 Lucene 的 BooleanQuery 查询,实现将多个查询组合起来。
三个参数:
must:文档必须匹配 must 所包括的查询条件,相当于 AND
should:文档应该匹配 should 所包括的查询条件其中的一个或多个,相当于 OR
must_not:文档不能匹配 must_not 所包括的该查询条件,相当于 NOT
分别使用 must、should、must_not 测试下边的查询:
发送:POST http://localhost:9200/xc_course/doc/_search
{
    "_source": [
        "name",
        "studymodel",
        "description"
    ],
    "from": 0,
    "size": 1,
    "query": {
        "bool": {
            "must": [
                {
                    "multi_match": {
                        "query": "spring框架",
                        "minimum_should_match": "50%",
                        "fields": [
                            "name^10",
                            "description"
                        ]
                    }
                },
                {
                    "term": {
                        "studymodel": "201001"
                    }
                }
            ]
        }
    }
}
must:表示必须,多个查询条件必须都满足。(通常使用must)
should:表示或者,多个查询条件只要有一个满足即可。
must_not:表示非。
JAVA客户端实现:
//BoolQuery,将搜索关键字分词,拿分词去索引库搜索
@Test
public void testBoolQuery() throws IOException {
    //创建搜索请求对象
    SearchRequest searchRequest= new SearchRequest("xc_course");
    searchRequest.types("doc");
    //创建搜索源配置对象
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    searchSourceBuilder.fetchSource(new String[]{"name","pic","studymodel"},new String[]{});
    //multiQuery
    String keyword = "spring开发框架";
    MultiMatchQueryBuilder multiMatchQueryBuilder = QueryBuilders.multiMatchQuery("spring框架",
    "name", "description")
    .minimumShouldMatch("50%");
    multiMatchQueryBuilder.field("name",10);
    //TermQuery
    TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("studymodel", "201001");
    //布尔查询
    BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
    boolQueryBuilder.must(multiMatchQueryBuilder);
    boolQueryBuilder.must(termQueryBuilder);
    //设置布尔查询对象
    searchSourceBuilder.query(boolQueryBuilder);
    searchRequest.source(searchSourceBuilder);//设置搜索源配置
    SearchResponse searchResponse = client.search(searchRequest);
    SearchHits hits = searchResponse.getHits();
    SearchHit[] searchHits = hits.getHits();
    for(SearchHit hit:searchHits){
        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        System.out.println(sourceAsMap);
    }
}
8、过滤器
过虑是针对 搜索的结果 进行过虑,过虑器主要判断的是文档是否匹配,不去 计算和判断文档的匹配度得分,所以过虑器的 性能 比查询要高,且方便缓存,推荐尽量使用过虑器去实现查询或者 过虑器 和 查询 共同使用。
过虑器在布尔查询中使用,下边是在搜索结果的基础上进行过滤
发送:POST http://localhost:9200/xc_course/doc/_search
{
    "_source": [
        "name",
        "studymodel",
        "description",
        "price"
    ],
    "query": {
        "bool": {
            "must": [
                {
                    "multi_match": {
                        "query": "spring框架",
                        "minimum_should_match": "50%",
                        "fields": [
                            "name^10",
                            "description"
                        ]
                    }
                }
            ],
            "filter": [
                {
                    "term": {
                        "studymodel": "201001"
                    }
                },
                {
                    "range": {
                        "price": {
                            "gte": 60,
                            "lte": 100
                        }
                    }
                }
            ]
        }
    }
}
range:范围过虑,保留大于等于 60 并且小于等于 100 的记录。
term:项匹配过虑,保留 studymodel 等于 201001 的记录。
注意:range 和 term 一次只能对一个 Field 设置范围过虑。
JAVA 客户端实现:
//布尔查询使用过虑器
@Test
public void testFilter() throws IOException {
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //source源字段过虑
    searchSourceBuilder.fetchSource(new String[]{"name","studymodel","price","description"},
    new String[]{});
    searchRequest.source(searchSourceBuilder);
    //匹配关键字
    MultiMatchQueryBuilder multiMatchQueryBuilder = QueryBuilders.multiMatchQuery("spring框
    架", "name", "description");
    //设置匹配占比
    multiMatchQueryBuilder.minimumShouldMatch("50%");
    //提升另个字段的Boost值
    multiMatchQueryBuilder.field("name",10);
    searchSourceBuilder.query(multiMatchQueryBuilder);
    //布尔查询
    BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
    boolQueryBuilder.must(searchSourceBuilder.query());
    //过虑条件
    boolQueryBuilder.filter(QueryBuilders.termQuery("studymodel", "201001"));
    boolQueryBuilder.filter(QueryBuilders.rangeQuery("price").gte(60).lte(100));
    //执行搜索
	SearchResponse searchResponse = client.search(searchRequest);
    SearchHits hits = searchResponse.getHits();
    SearchHit[] searchHits = hits.getHits();
    for(SearchHit hit:searchHits){
        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        System.out.println(sourceAsMap);
    }
}
9、排序
可以在字段上添加一个或多个排序,支持在 keyword、date、float 等类型上添加,text 类型的字段上不允许添加排序。
需求:过虑 0--10 元价格范围的文档,并且对结果进行排序,先按 studymodel 降序,再按价格升序
发送 POST http://localhost:9200/xc_course/doc/_search
{
    "_source": [
        "name",
        "studymodel",
        "description",
        "price"
    ],
    "query": {
        "bool": {
            "filter": [
                {
                    "range": {
                        "price": {
                            "gte": 0,
                            "lte": 100
                        }
                    }
                }
            ]
        }
    },
    "sort": [
        {
            "studymodel": "desc"
        },
        {
            "price": "asc"
        }
    ]
}
dest 表示降序,从大到小,asc 表示升序,从小到大
JAVA客户端实现
@Test
public void testSort() throws IOException {
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //source源字段过虑
    searchSourceBuilder.fetchSource(new String[]{"name","studymodel","price","description"},
    new String[]{});
    searchRequest.source(searchSourceBuilder);
    //布尔查询
    BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
    //过虑
  boolQueryBuilder.filter(QueryBuilders.rangeQuery("price").gte(0).lte(100));
    //排序
    searchSourceBuilder.sort(new FieldSortBuilder("studymodel").order(SortOrder.DESC));
    searchSourceBuilder.sort(new FieldSortBuilder("price").order(SortOrder.ASC));
    SearchResponse searchResponse = client.search(searchRequest);
    SearchHits hits = searchResponse.getHits();
    SearchHit[] searchHits = hits.getHits();
    for(SearchHit hit:searchHits){
        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        System.out.println(sourceAsMap);
    }
}
10、高亮显示
JAVA客户端实现
@Test
public void testHighlight() throws IOException {
    SearchRequest searchRequest = new SearchRequest("xc_course");
    searchRequest.types("doc");
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //source源字段过虑
    searchSourceBuilder.fetchSource(new String[]{"name","studymodel","price","description"},
    new String[]{});
    searchRequest.source(searchSourceBuilder);
    //匹配关键字
    MultiMatchQueryBuilder multiMatchQueryBuilder = QueryBuilders.multiMatchQuery("开发",
    "name", "description");
    searchSourceBuilder.query(multiMatchQueryBuilder);
    //布尔查询
    BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
    boolQueryBuilder.must(searchSourceBuilder.query());
    //过虑
    boolQueryBuilder.filter(QueryBuilders.rangeQuery("price").gte(0).lte(100));
    //排序
    searchSourceBuilder.sort(new FieldSortBuilder("studymodel").order(SortOrder.DESC));
    searchSourceBuilder.sort(new FieldSortBuilder("price").order(SortOrder.ASC));
    //高亮设置
    HighlightBuilder highlightBuilder = new HighlightBuilder();
    highlightBuilder.preTags("<tag>");//设置前缀
    highlightBuilder.postTags("</tag>");//设置后缀
    // 设置高亮字段
    highlightBuilder.fields().add(new HighlightBuilder.Field("name"));
    // highlightBuilder.fields().add(new HighlightBuilder.Field("description"));
    searchSourceBuilder.highlighter(highlightBuilder);
    SearchResponse searchResponse = client.search(searchRequest);
    SearchHits hits = searchResponse.getHits();
    SearchHit[] searchHits = hits.getHits();
    for (SearchHit hit : searchHits) {
        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        //名称
        String name = (String) sourceAsMap.get("name");
        //取出高亮字段内容
        Map<String, HighlightField> highlightFields = hit.getHighlightFields();
        if(highlightFields!=null){
            HighlightField nameField = highlightFields.get("name");
            if(nameField!=null){
                Text[] fragments = nameField.getFragments();
                StringBuffer stringBuffer = new StringBuffer();
                for (Text str : fragments) {
                    stringBuffer.append(str.string());
                }
                name = stringBuffer.toString();
            }
        }
        //取出所有结果
        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        System.out.println(sourceAsMap);
    }
}
二、集群管理
ES 通常以集群方式工作,这样做不仅能够提高 ES 的搜索能力还可以处理大数据搜索的能力,同时也增加了系统的容错能力及高可用,ES 可以实现 PB 级数据的搜索。
0x01 集群结构
下图是 ES 集群结构的示意图:
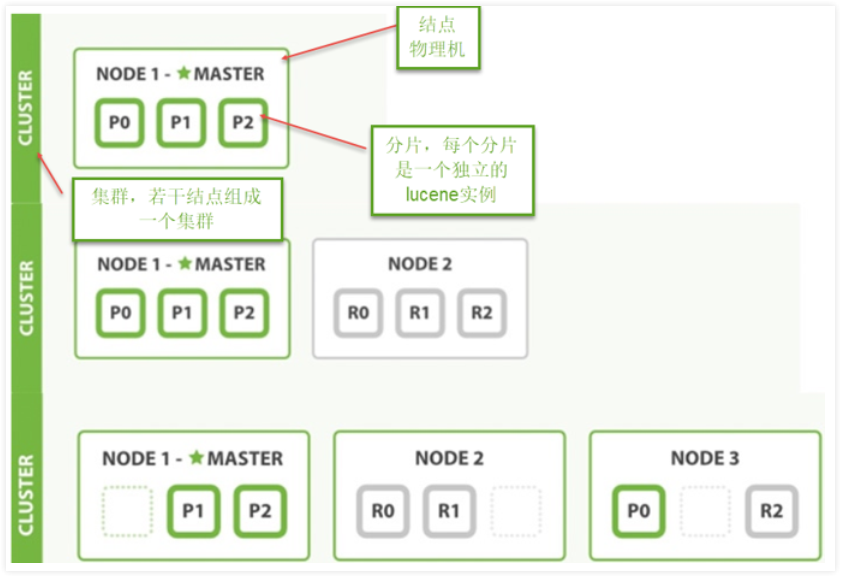
从上图总结以下概念:
1、结点
ES 集群由多个服务器组成,每个服务器即为一个 Node 结点(如果该服务器只部署了一个 ES 进程)。
2、分片
当我们的文档量很大时,由于内存和硬盘的限制,同时也为了提高 ES 的处理能力、容错能力及高可用能力,我们将索引分成若干分片,每个分片可以放在不同的服务器,这样就实现了多个服务器共同对外提供索引及搜索服务。
一个搜索请求过来,会分别从各各分片去查询,最后将查询到的数据合并返回给用户。
3、副本
为了提高 ES 的高可用同时也为了提高搜索的吞吐量,我们将分片复制一份或多份存储在其它的服务器,这样即使当前的服务器挂掉了,拥有副本的服务器照常可以提供服务。
4、主结点
一个集群中会有一个或多个主结点,主结点的作用是集群管理,比如增加节点,移除节点等,主结点挂掉后ES会重新选一个主结点。
5、结点转发
每个结点都知道其它结点的信息,我们可以对任意一个结点发起请求,接收请求的结点会转发给其它结点查询数据
0x02 搭建集群
1、节点的三个角色
下边的例子实现创建一个 2结点的集群,并且索引的分片我们设置 2片,每片一个副本。
主结点:master 节点主要用于集群的管理及索引,比如新增结点、分片分配、索引的新增和删除等。
数据结点:data 节点上保存了数据分片,它负责索引和搜索操作。 客户端结点:client 节点仅作为请求客户端存在,client 的作用也作为负载均衡器,client 节点不存数据,只是将请求均衡转发到其它结点。
通过下边两项参数来配置结点的功能:
node.master: #是否允许为主结点
node.data: #允许存储数据作为数据结点
node.ingest: #是否允许成为协调节点,
四种组合方式:
master=true, data=true:即是主结点又是数据结点
master=false, data=true:仅是数据结点
master=true, data=false:仅是主结点,不存储数据
master=false, data=false:即不是主结点也不是数据结点,此时可设置ingest为true表示它是一个客户端
2、创建节点
(1) 配置节点1
结点1 对外服务的 http 端口是 9200,集群管理端口是 9300
配置 elasticsearch.yml
结点名:xc_node_1
elasticsearch.yml 内容如下
cluster.name: xuecheng
node.name: xc_node_1
# 主机绑定IP、端口等信息
network.host: 0.0.0.0
http.port: 9200
transport.tcp.port: 9300
node.master: true
node.data: true
# 配置master节点列表
discovery.zen.ping.unicast.hosts: ["0.0.0.0:9300", "0.0.0.0:9301"]
# 最小的主节点数量
discovery.zen.minimum_master_nodes: 1
node.ingest: true
bootstrap.memory_lock: false
node.max_local_storage_nodes: 1

# 数据与日志目录
path.data: D:\soft\elasticsearch\elasticsearch-6.8.8_1\data
path.logs: D:\soft\elasticsearch\elasticsearch-6.8.8_1\logs

# 跨域配置
http.cors.enabled: true
http.cors.allow-origin: /.*/
启动节点1
(2) 配置节点2
我们测试环境就在同一台机器上部署两个节点,所以需要将 ES 的安装包再解压一份,并复制节点1的ik插件和一些日志配置文件到 节点2 的目录下
结点 2对外服务的 http 端口是 9201,集群管理端口是9302
结点名:xc_node_2
elasticsearch.yml 内容如下 :
cluster.name: xuecheng
node.name: xc_node_2
# 主机绑定IP、端口等信息
network.host: 0.0.0.0
http.port: 9201
transport.tcp.port: 9301
node.master: true
node.data: true
# 配置master节点列表
discovery.zen.ping.unicast.hosts: ["0.0.0.0:9300", "0.0.0.0:9301"]
# 最小的主节点数量
discovery.zen.minimum_master_nodes: 1
node.ingest: true
bootstrap.memory_lock: false
node.max_local_storage_nodes: 1

# 数据与日志目录
path.data: D:\soft\elasticsearch\elasticsearch-6.8.8_1\data
path.logs: D:\soft\elasticsearch\elasticsearch-6.8.8_2\logs

# 跨域配置
http.cors.enabled: true
http.cors.allow-origin: /.*/
启动结点2
3、创建索引库
1)使用head连上其中一个结点
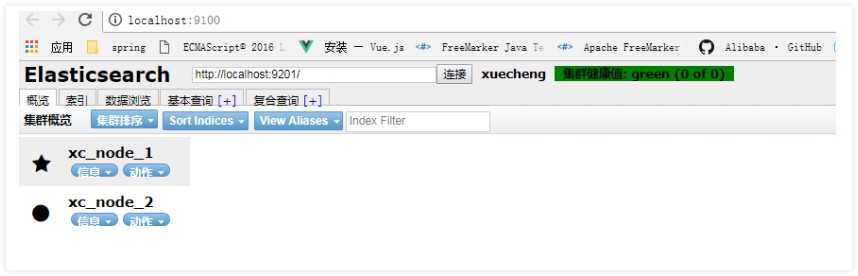
上图表示两个结点已经创建成功。
2)下边创建索引库,共 2 个分片,每个分片一个副本。
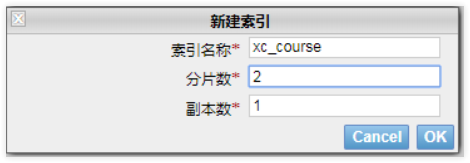
创建成功,刷新 head
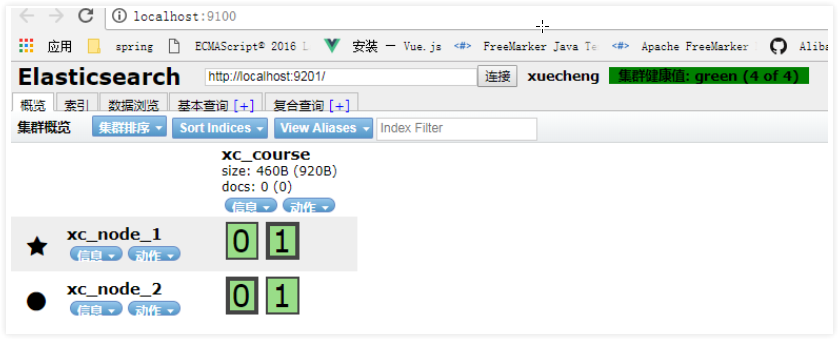
上图可以看到共有4个分片,其中两个分片是副本。
4、集群的健康状态
通过访问 GET /_cluster/health 来查看 Elasticsearch 的集群健康情况。
用三种颜色来展示健康状态: green 、 yellow 或者 red 。
-
green:所有的主分片和副本分片都正常运行。
-
yellow:所有的主分片都正常运行,但有些副本分片运行不正常。
-
ed:存在主分片运行不正常。
GET 请求:http://localhost:9200/_cluster/health
响应结果:
{
    "cluster_name": "xuecheng",
    "status": "green",
    "timed_out": false,
    "number_of_nodes": 2,
    "number_of_data_nodes": 2,
    "active_primary_shards": 0,
    "active_shards": 0,
    "relocating_shards": 0,
    "initializing_shards": 0,
    "unassigned_shards": 0,
    "delayed_unassigned_shards": 0,
    "number_of_pending_tasks": 0,
    "number_of_in_flight_fetch": 0,
    "task_max_waiting_in_queue_millis": 0,
    "active_shards_percent_as_number": 100.0
}
0x03 测试
1)创建映射并写入文档
连接 其中任意一台结点,创建映射写入文档。
POST http://localhost:9200/xc_course/doc/3
{
	"name": "spring开发基础",
    "description": "spring 在java领域非常流行,java软件开发人员都在用。",
    "studymodel": "201001",
    "price":66.6
}
响应结果:
{
    "_index": "xc_course",
    "_type": "doc",
    "_id": "3",
    "_version": 1,
    "result": "created",
    "_shards": {
        "total": 2,
        "successful": 1,
        "failed": 0
    },
    "_seq_no": 0,
    "_primary_term": 1
}
从上边的提示可看出,两个分片都保存成功。
2)搜索
向其它一个结点发起搜索请求,查询全部数据。
3)关闭一个结点
ES会重新选中一个主结点(前提在配置结点时允许它可以为主结点)
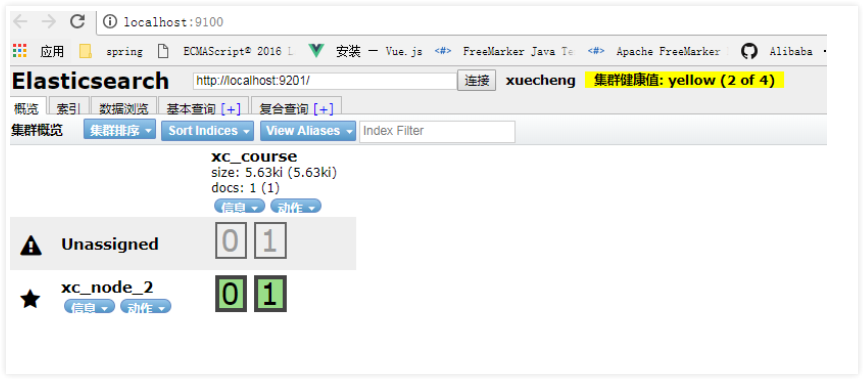
此时向活的结点发起搜索请求,仍然正常。
4)添加一个结点
添加结点 3,端口设置为:
http 端口是:9202
集群管理端口是 9302
结点名:xc_node_3
此结点的配置:
node.master: false
node.data: true
启动结点3,刷新 head,下图显示 ES 将分片分在了 3 个结点
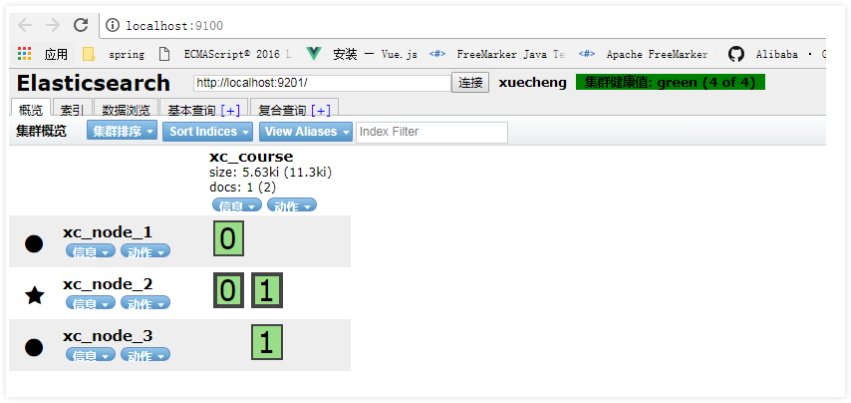
向结点3发起搜索请求:
GET: http://127.0.0.1:9202/xc_course/doc/_search
全部数据可被正常搜索到。
三、搜索服务开发
0x01 课程搜索服务需求分析
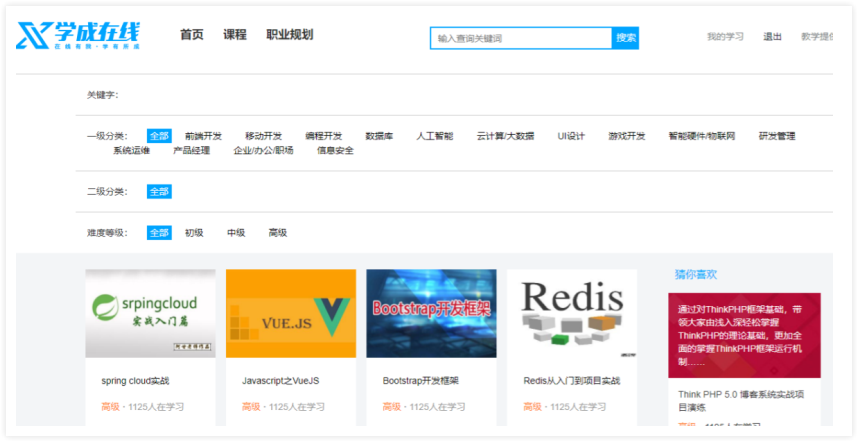
1、需求分析
-
根据分类搜索课程信息。
-
根据关键字搜索课程信息,搜索方式为全文检索,关键字需要匹配课程的名称、 课程内容。
-
根据难度等级搜索课程。
-
搜索结点分页显示。
2、搜索流程
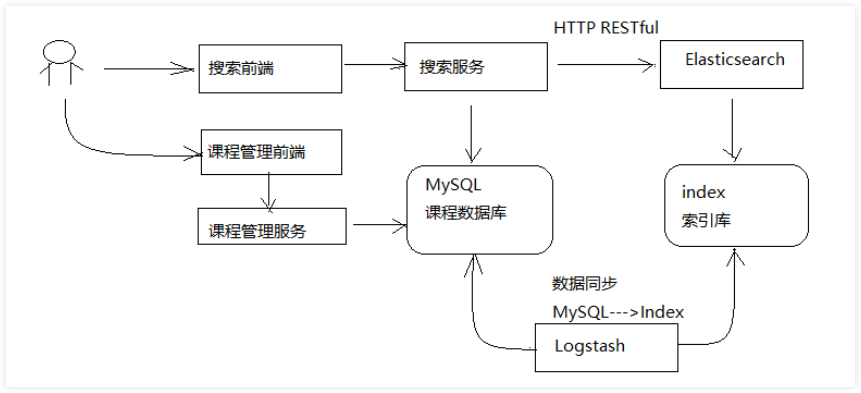
1、课程管理服务将数据写到 MySQL 数据库
2、使用 Logstash 将 MySQL 数据库中的数据写到 ES 的索引库。
3、用户在前端搜索课程信息,请求到搜索服务。
4、搜索服务请求 ES 搜索课程信息。
0x02 课程索引
1、技术方案
如何维护课程索引信息?
1、当课程向 MySQL 添加后同时将课程信息添加到索引库。采用 Logstach 实现,Logstach会从 MySQL 中 将数据采集到 ES 索引库。
2、当课程在 MySQL 更新信息后同时更新该课程在索引库的信息。
采用 Logstach 实现。
3、当课程在 MySQL 删除后同时将该课程从索引库删除。
手工写程序实现,在删除课程后将索引库中该课程信息删除。
2、准备课程索引信息
课程发布成功在 MySQL 数据库存储课程发布信息,此信息作为课程索引信息。
创建课程发布表
课程信息分布在 course_base、course_pic 等不同的表中。
课程发布成功为了方便进行索引将这几张表的数据合并在一张表中,作为课程发布信息。
创建 course_pub 表
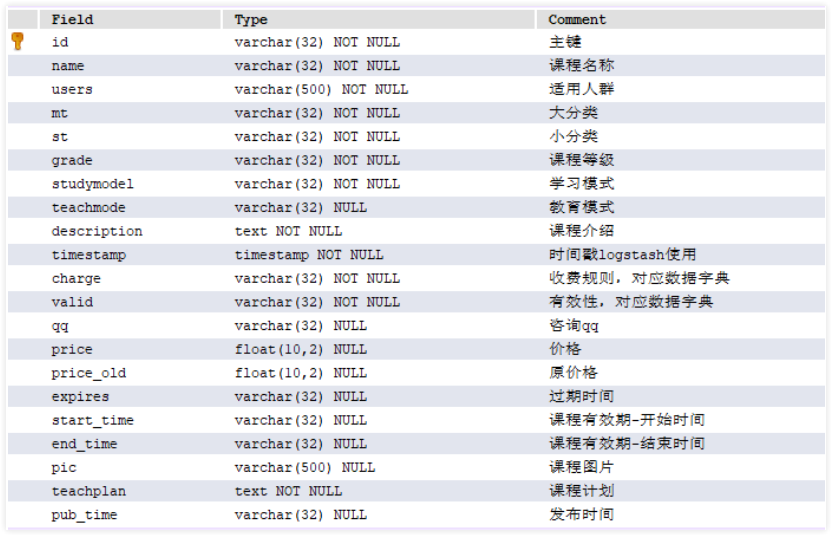
创建表模型
@Data
@ToString
@Entity
@Table(name="course_pub")
@GenericGenerator(name = "jpa-assigned", strategy = "assigned")
public class CoursePub implements Serializable {
    private static final long serialVersionUID = -916357110051689487L;
    @Id
    @GeneratedValue(generator = "jpa-assigned")
    @Column(length = 32)
    private String id;
    private String name;
    private String users;
    private String mt;
    private String st;
    private String grade;
    private String studymodel;
    private String teachmode;
    private String description;
    private String pic;//图片
    private Date timestamp;//时间戳
    private String charge;+
    private String valid;
    private String qq;
    private Float price;
    private Float price_old;
    private String expires;
    private String teachplan;//课程计划
    @Column(name="pub_time")
    private String pubTime;//课程发布时间
}
添加课程索引
我们需要在课程发成功后执行添加课程索引的操作
1)创建 course_pub 表的 dao
public interface CoursePubRepository extends JpaRepository<CoursePub, String> {}
- 修改课程发布
我们先将添加索引拆分为两个方法:createCoursePub、saveCoursePub
//保存CoursePub
private CoursePub saveCoursePub(String id, CoursePub coursePub){
    if(StringUtils.isNotEmpty(id)){
    ExceptionCast.cast(CourseCode.COURSE_PUBLISH_COURSEIDISNULL);
    }
    CoursePub coursePubNew = null;
    Optional<CoursePub> coursePubOptional = coursePubRepository.findById(id);
    if(coursePubOptional.isPresent()){
    	coursePubNew = coursePubOptional.get();
    }
    if(coursePubNew == null){
    	coursePubNew = new CoursePub();
    }
    BeanUtils.copyProperties(coursePub,coursePubNew);
    //设置主键
    coursePubNew.setId(id);
    //更新时间戳为最新时间
    coursePub.setTimestamp(new Date());
    //发布时间
    SimpleDateFormat simpleDateFormat = new SimpleDateFormat("YYYY-MM-dd HH:mm:ss");
    String date = simpleDateFormat.format(new Date());
    coursePub.setPubTime(date);
    coursePubRepository.save(coursePub);
    return coursePub;
}

//创建coursePub对象
private CoursePub createCoursePub(String id){
    CoursePub coursePub = new CoursePub();
    coursePub.setId(id);
    //基础信息
    Optional<CourseBase> courseBaseOptional = courseBaseRepository.findById(id);
    if(courseBaseOptional == null){
        CourseBase courseBase = courseBaseOptional.get();
        BeanUtils.copyProperties(courseBase, coursePub);
    }
    //查询课程图片
    Optional<CoursePic> picOptional = coursePicRepository.findById(id);
    if(picOptional.isPresent()){
        CoursePic coursePic = picOptional.get();
        BeanUtils.copyProperties(coursePic, coursePub);
    }
    //课程营销信息
    Optional<CourseMarket> marketOptional = courseMarketRepository.findById(id);
    if(marketOptional.isPresent()){
        CourseMarket courseMarket = marketOptional.get();
        BeanUtils.copyProperties(courseMarket, coursePub);
    }
    //课程计划
    TeachplanNode teachplanNode = teachplanMapper.selectList(id);
    //将课程计划转成json
    String teachplanString = JSON.toJSONString(teachplanNode);
    coursePub.setTeachplan(teachplanString);
    return coursePub;
}
3)修改课程方法,调用 createCoursePub 和 saveCoursePub 方法
//课程发布
@Transactional
public CoursePublishResult publish(String courseId){
    ....
    //创建课程索引
    //创建课程索引信息
    CoursePub coursePub = createCoursePub(courseId);
    //向数据库保存课程索引信息
    CoursePub newCoursePub = saveCoursePub(courseId, coursePub);
    if(newCoursePub==null){
    //创建课程索引信息失败
ExceptionCast.cast(CourseCode.COURSE_PUBLISH_CREATE_INDEX_ERROR);
    }
    ....
}
3、搭建ES环境
创建索引库 , 创建 xc_course 索引库,1分片,0个副本。
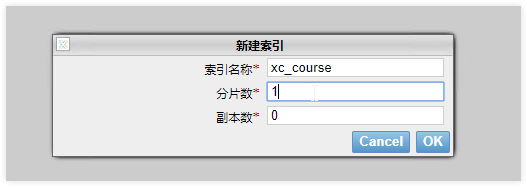
创建映射
POST: http://localhost:9200/xc_course/doc/_mapping
{
    "properties": {
        "description": {
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_smart",
            "type": "text"
        },
        "grade": {
            "type": "keyword"
        },
        "id": {
            "type": "keyword"
        },
        "mt": {
            "type": "keyword"
        },
        "name": {
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_smart",
            "type": "text"
        },
        "users": {
            "index": false,
            "type": "text"
        },
        "charge": {
            "type": "keyword"
        },
        "valid": {
            "type": "keyword"
        },
        "pic": {
            "index": false,
            "type": "keyword"
        },
        "qq": {
            "index": false,
            "type": "keyword"
        },
        "price": {
            "type": "float"
        },
        "price_old": {
            "type": "float"
        },
        "st": {
            "type": "keyword"
        },
        "status": {
            "type": "keyword"
        },
        "studymodel": {
            "type": "keyword"
        },
        "teachmode": {
            "type": "keyword"
        },
        "teachplan": {
            "analyzer": "ik_max_word",
            "search_analyzer": "ik_smart",
            "type": "text"
        },
        "expires": {
            "type": "date",
            "format": "yyyy-MM-dd HH:mm:ss"
        },
        "pub_time": {
            "type": "date",
            "format": "yyyy-MM-dd HH:mm:ss"
        },
        "start_time": {
            "type": "date",
            "format": "yyyy-MM-dd HH:mm:ss"
        },
        "end_time": {
            "type": "date",
            "format": "yyyy-MM-dd HH:mm:ss"
        }
    }
}
4、Logstash创建索引
Logstash是ES下的一款开源软件,它能够同时 从多个来源采集数据、转换数据,然后将数据发送 Eleasticsearch 中创建索引。
本项目使用 Logstash 将 MySQL 中的数据采用到ES索引中。
下载 Logstash
下载的 Logstash 要和ES的版本保持一致,下载地址 https://www.elastic.co/cn/downloads/logstash
下载完成后解压即可
安装 Logstash
ogstash-input-jdbc 是ruby开发的,先下载 ruby 并安装
下载地址: https://rubyinstaller.org/downloads/
安装完成查看是否安装成功 ruby -v
6.x 版本本身不带 logstash-input-jdbc 插件,需要手动安装 ,在bin目录下执行以下命令
.\logstash-plugin.bat install logstash-input-jdbc
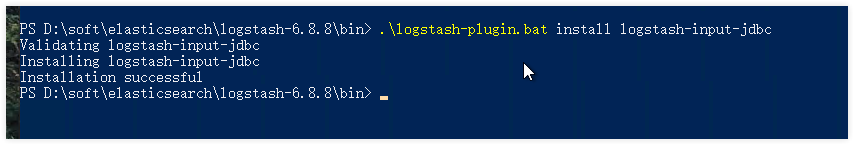
安装成功后我们可以在 logstash 根目录下的 vendor\bundle\jruby\2.5.0\gems 目录查看对应的插件版本
创建模板文件
Logstash 的工作是从 MySQL 中读取数据,向ES中创建索引,这里需要提前创建 mapping 的模板文件以便 logstash 使用。
在 logstach 的 config 目录创建 xc_course_template.json,内容如下:
{
   "mappings" : {
      "doc" : {
         "properties" : {
            "charge" : {
               "type" : "keyword"
            },
            "description" : {
               "analyzer" : "ik_max_word",
               "search_analyzer" : "ik_smart",
               "type" : "text"
            },
            "end_time" : {
               "format" : "yyyy-MM-dd HH:mm:ss",
               "type" : "date"
            },
            "expires" : {
               "format" : "yyyy-MM-dd HH:mm:ss",
               "type" : "date"
            },
            "grade" : {
               "type" : "keyword"
            },
            "id" : {
               "type" : "keyword"
            },
            "mt" : {
               "type" : "keyword"
            },
            "name" : {
               "analyzer" : "ik_max_word",
               "search_analyzer" : "ik_smart",
               "type" : "text"
            },
            "pic" : {
               "index" : false,
               "type" : "keyword"
            },
            "price" : {
               "type" : "float"
            },
            "price_old" : {
               "type" : "float"
            },
            "pub_time" : {
               "format" : "yyyy-MM-dd HH:mm:ss",
               "type" : "date"
            },
            "qq" : {
               "index" : false,
               "type" : "keyword"
            },
            "st" : {
               "type" : "keyword"
            },
            "start_time" : {
               "format" : "yyyy-MM-dd HH:mm:ss",
               "type" : "date"
            },
            "status" : {
               "type" : "keyword"
            },
            "studymodel" : {
               "type" : "keyword"
            },
            "teachmode" : {
               "type" : "keyword"
            },
            "teachplan" : {
               "analyzer" : "ik_max_word",
               "search_analyzer" : "ik_smart",
               "type" : "text"
            },
            "users" : {
               "index" : false,
               "type" : "text"
            },
            "valid" : {
               "type" : "keyword"
            }
         }
      }
   },
   "template" : "xc_course"
}
该文件对于的是ES库中的映射
配置 mysql.conf
在 logstash 的 config 目录下配置 mysql.conf文件供 logstash 使用,logstash 会根据mysql.conf 文件的配置的地址从 MySQL 中读取数据向 ES 中写入索引。
参考 https://www.elastic.co/guide/en/logstash/current/plugins-inputs-jdbc.html
配置输入数据源和输出数据源。
input {
    stdin {
    }
    jdbc {
        jdbc_connection_string => "jdbc:mysql://localhost:3306/xc_course?useUnicode=true&characterEncoding=utf-8&useSSL=true&serverTimezone=UTC"
        # 数据库信息
        jdbc_user => "root"
        jdbc_password => 123123
        # MYSQL 驱动地址,修改为maven仓库对应的位置
        jdbc_driver_library => "D:/soft/apache-maven-3.5.4/repository/mysql/mysql-connector-java/5.1.40/mysql-
        connector-java-5.1.40.jar"
        # the name of the driver class for mysql
        jdbc_driver_class => "com.mysql.jdbc.Driver"
        jdbc_paging_enabled => "true"
        jdbc_page_size => "50000"
        #要执行的sql文件
        #statement_filepath => "/conf/course.sql"
		# 这里我们采用直接sql语句的形式, 因为logstash默认采用的是UTC标准时间,我们这里需要加上8小时
        statement => "select * from course_pub where timestamp > date_add(:sql_last_value,INTERVAL 8 HOUR)"
        #定时配置
        schedule => "* * * * *"
        record_last_run => true
        last_run_metadata_path => "D:/soft/elasticsearch/logstash-6.8.8/config/logstash_metadata"
        }
    }
    output {
        elasticsearch {
        #ES的ip地址和端口
        hosts => "localhost:9200"
        #hosts => ["localhost:9200","localhost:9202","localhost:9203"]
        #ES索引库名称
        index => "xc_course"
        document_id => "%{id
        document_type => "doc"
        template =>"D:/soft/elasticsearch/logstash-6.8.8/config/xc_course_template.json"
        template_name => "xc_course"
        template_overwrite =>"true"
    }
	stdout {
    #日志输出
    	codec => json_lines
    }
}
说明:
1、ES 采用 UTC 时区问题
ES 采用 UTC 时区,比北京时间早8小时,所以 ES 读取数据时让最后更新时间加8小时
where timestamp > date_add(:sql_last_value,INTERVAL 8 HOUR)
2、logstash 每个执行完成会在 config/logstash_metadata 记录执行时间下次以此时间为基准进行增量同步数据到索引库。
测试
启动 logstash.bat
.\logstash.bat -f ..\config\mysql.conf
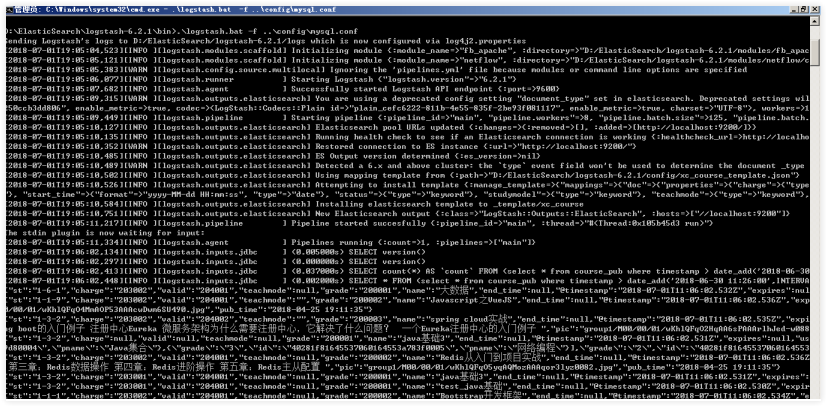
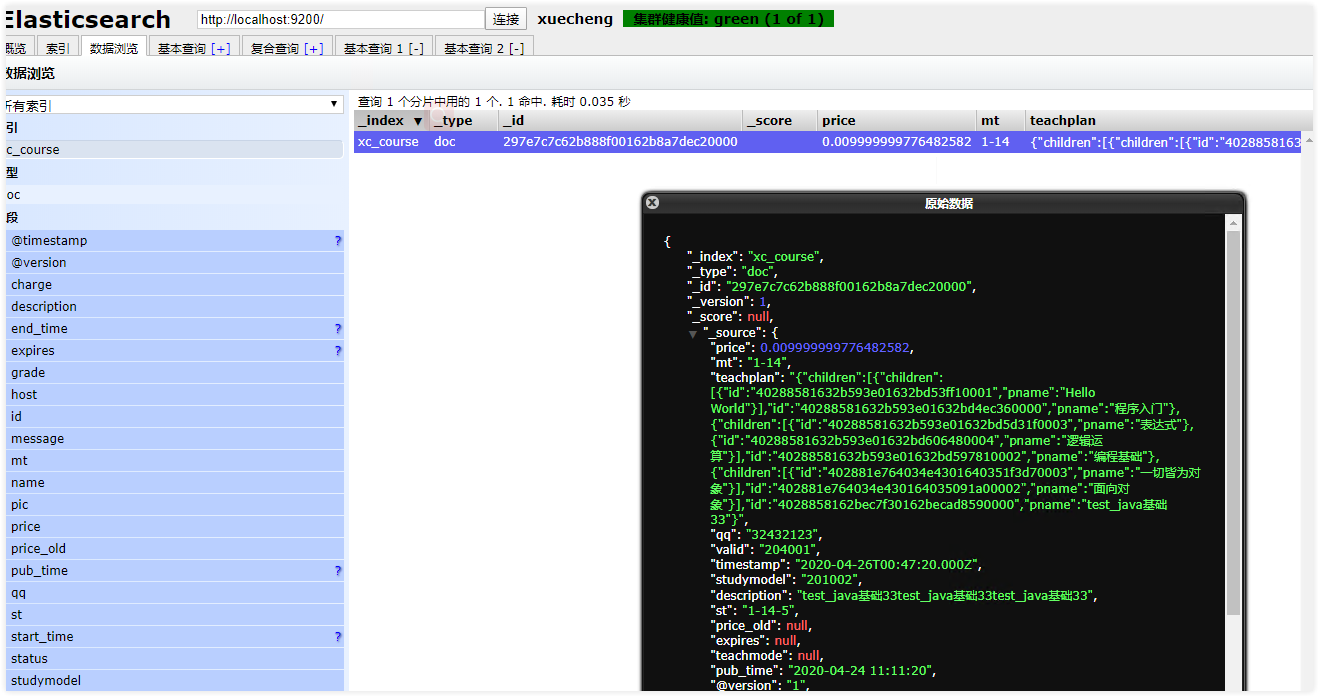
修改 course_pub 中的数据,并且修改 timestamp 为当前时间,观察 Logstash 日志是否读取到要索引的数据。
最后用 head 登录 ES 查看索引文档内容是否修改。
0x03 课程搜索实战
1、需求分析
1、根据 分类 搜索课程信息。
2、根据 关键字 搜索课程信息,搜索方式为全文检索,关键字需要匹配课程的名称、 课程内容。
3、根据 难度等级 搜索课程。
4、搜索结点分页显示。
技术分析
1、根据关键字搜索,采用 MultiMatchQuery,搜索 name、description、teachplan
2、根据分类、课程等级搜索采用过虑器实现。
3、分页查询。
4、高亮显示。
2、创建搜索服务工程
该工程环境我们在 day10 已经搭建完成,如果你未学习前面的章节,请参考 day10 六、索引管理 的内容。
3、构建API
package com.xuecheng.api.search;

import com.xuecheng.framework.domain.course.CoursePub;
import com.xuecheng.framework.domain.search.CourseSearchParam;
import com.xuecheng.framework.model.response.QueryResponseResult;
import io.swagger.annotations.Api;
import io.swagger.annotations.ApiOperation;

import java.io.IOException;

@Api(value = "课程搜索", description = "基于ES构建的课程搜索API",tags = {"课程搜索"})
public interface EsCourseConrollerApi {
    @ApiOperation("课程详细搜索")
    public QueryResponseResult<CoursePub> findList(int page, int size, CourseSearchParam courseSearchParam) throws IOException;
}
4、Service
按关键词搜索
在 appliction.yml 中配置 source_field
elasticsearch:
    hostlist: 127.0.0.1:9200 #多个结点中间用逗号分隔
    course:
    index: xc_course
    type: doc
    source_field: id,name,grade,mt,st,charge,valid,pic,qq,price,price_old,status,studymodel,teachmode,expires,pub_time,start_time,end_time
service 完整代码如下
/**
 * 课程列表搜索
 * @param page 页码
 * @param size 每页数量
 * @param courseSearchParam 搜索参数
 * @return
 * @throws IOException
 */
public QueryResponseResult<CoursePub> findList(int page, int size, CourseSearchParam courseSearchParam) throws IOException{
    //设置索引
    SearchRequest searchRequest = new SearchRequest(es_index);
    //设置类型
    searchRequest.types(es_type);
    //创建搜索源对象
    SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
    //创建布尔查询对象
    BoolQueryBuilder boolQueryBuilder = new BoolQueryBuilder();

    //源字段过滤
    String[] fieldArr = source_field.split(",");
    searchSourceBuilder.fetchSource(fieldArr,new String[]{});

    //根据关键字进行查询
    if(StringUtils.isNotEmpty(courseSearchParam.getKeyword())){
        //匹配关键词
        MultiMatchQueryBuilder multiMatchQueryBuilder = QueryBuilders.multiMatchQuery(courseSearchParam.getKeyword(), "name", "teachplan", "description");
        //设置匹配占比
        multiMatchQueryBuilder.minimumShouldMatch("70%");
        //提升字段的权重值
        multiMatchQueryBuilder.field("name",10);
        boolQueryBuilder.must(multiMatchQueryBuilder);
    }

    //根据难度进行过滤
    if(StringUtils.isNotEmpty(courseSearchParam.getMt())){
        boolQueryBuilder.filter(QueryBuilders.termQuery("mt",courseSearchParam.getMt()));
    }
    if(StringUtils.isNotEmpty(courseSearchParam.getSt())){
        boolQueryBuilder.filter(QueryBuilders.termQuery("st",courseSearchParam.getSt()));
    }
    //根据等级进行过滤
    if(StringUtils.isNotEmpty(courseSearchParam.getGrade())){
        boolQueryBuilder.filter(QueryBuilders.termQuery("grade",courseSearchParam.getGrade()));
    }

    //设置分页参数
    if(page<=0){
        page = 1;
    }
    if(size<=0){
        size = 20;
    }
    //计算搜索起始位置
    int start = (page-1) * size;
    searchSourceBuilder.from(start);
    searchSourceBuilder.size(size);

    //将布尔查询对象添加到搜索源内
    searchSourceBuilder.query(boolQueryBuilder);

    //配置高亮信息
    HighlightBuilder highlightBuilder = new HighlightBuilder();
    highlightBuilder.preTags("<font class='eslight'>");
    highlightBuilder.postTags("</font>");
    //设置高亮字段
    highlightBuilder.fields().add(new HighlightBuilder.Field("name"));
    searchSourceBuilder.highlighter(highlightBuilder);

    //请求搜索
    searchRequest.source(searchSourceBuilder);
    SearchResponse searchResponse = null;
    try{
        searchResponse = restHighLevelClient.search(searchRequest);
    }catch (Exception e){
        //搜索异常
        e.printStackTrace();
        LOGGER.error("search error ...{}",e.getMessage());
        return new QueryResponseResult<>(CommonCode.FAIL,null);
    }

    //结果收集处理
    SearchHits hits = searchResponse.getHits();
    //获取匹配度高的结果
    SearchHit[] searchHits = hits.getHits();
    //总记录数
    long totalHits = hits.getTotalHits();
    //数据列表
    ArrayList<CoursePub> list = new ArrayList<>();

    //添加数据
    for (SearchHit hit: searchHits){
        CoursePub coursePub = new CoursePub();

        Map<String, Object> sourceAsMap = hit.getSourceAsMap();
        //取出名称
        String name = (String) sourceAsMap.get("name");
        coursePub.setName(name);
        //图片
        String pic = (String) sourceAsMap.get("pic");
        coursePub.setPic(pic);
        //优惠后的价格
        Float price = null;
        try {
            if(sourceAsMap.get("price") !=null){
                price = Float.parseFloat(String.format("%.3f",sourceAsMap.get("price")));
            }
        }catch (Exception e){
            e.printStackTrace();
        }
        coursePub.setPrice(price);
        //优惠前的价格
        Float priceOld = null;
        try {
            if(sourceAsMap.get("price_old") !=null){
                priceOld = Float.parseFloat(String.format("%.3f",sourceAsMap.get("price_old")));
            }
        }catch (Exception e){
            e.printStackTrace();
        }
        coursePub.setPrice_old(priceOld);

        list.add(coursePub);
    }

    //返回响应结果
    QueryResult<CoursePub> queryResult = new QueryResult<>();
    queryResult.setList(list);
    queryResult.setTotal(totalHits);
    return new QueryResponseResult<>(CommonCode.SUCCESS,queryResult);
}
servcice 的代码中的注释已经写得很详细了,这里我就不再做过多的解释,请详细的阅读上述的代码。
5、Controller
/**
 * 课程信息搜索
 * @param page 页码
 * @param size 每页数量
 * @param courseSearchParam 搜索参数
 * @return
 * @throws IOException
 */
@Override
@GetMapping("/list/{page}/{size}")
public QueryResponseResult<CoursePub> findList(@PathVariable("page") int page,@PathVariable("size") int size, CourseSearchParam courseSearchParam) throws IOException {
    return esCourseService.findList(page,size,courseSearchParam);
}
6、测试
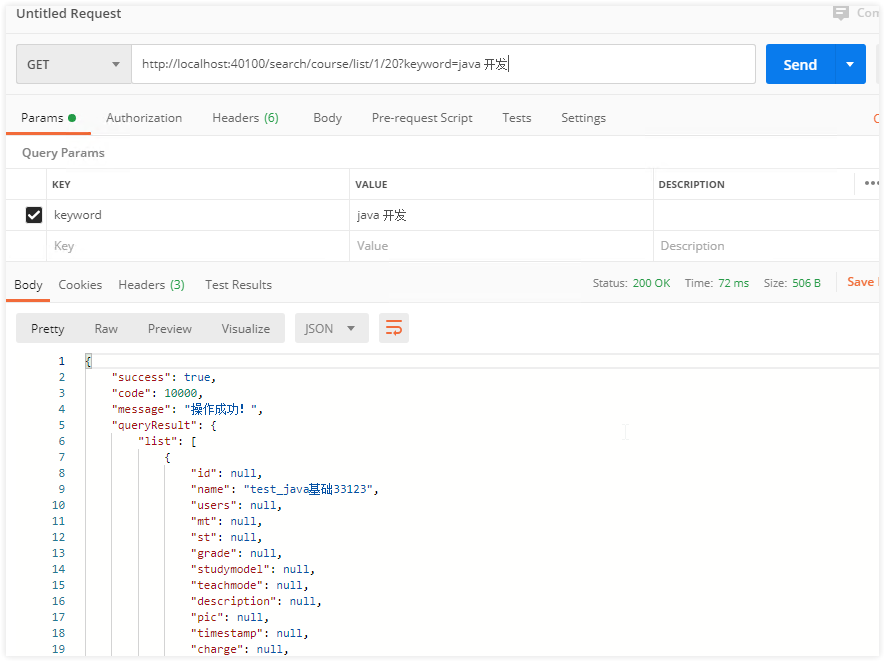
根据关键字搜索
使用 postman 测试
GET: http://localhost:40100/search/course/list/1/20?keyword=java 开发
根据价格、等级、难度进行搜索
待测试
😁 认识作者
作者:👦 LCyee ,全干型代码🐕
记录学习以及项目开发过程中的笔记与心得,记录认知迭代的过程,分享想法与观点。
优快云 博客:https://blog.youkuaiyun.com/codeyee
记录和分享一些开发过程中遇到的问题以及解决的思路。
欢迎加入微服务练习生的队伍,一起交流项目学习过程中的一些问题、分享学习心得等,不定期组织一起刷题、刷项目,共同见证成长。


 8725


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


