HBase总结(十九)数据导入方式

Hbase之 java 客户端上 table 数据的插入( put / BufferedMutation / BulkLoad )*** (7) 数据插入到 table 中的方法有 : put , put 一次,客户端就需要向 hbase 发送一次请求, 就处理一次 ,增加了 hbase 的压力 ,插入效率低 . 使用缓存( BufferedMutator ) , 批次插入 ,数据量达到一定大小后 ,向 hbase 发送一次请求 ,因为是批量插入 ,所以插入数据时请求次数减少 ,数据插入稍高 . 1 put 方法 public class PutTableData { public static void main(String[] a 阅读详情

*). Client API实现

借助HBase的Client API来导入, 是最简易学的方式.

  1. Configuration config = HBaseConfiguration.create(); 
  2. // 配置hbase.zookeeper.quorum: 后接zookeeper集群的机器列表 
  3. config.set("hbase.zookeeper.quorum", "tw-node109,tw-node110,tw-node111"); 
  4. // 配置hbase.zookeeper.property.clientPort: zookeeper集群的服务端口 
  5. config.set("hbase.zookeeper.property.clientPort", "2181"); 
  6.   
  7. HTable htable = null; 
  8. try { 
  9. // 配置hbase的具体表名 
  10. htable = new HTable(config, "hbase_table"); 
  11. // 设置rowkey的值 
  12. Put put = new Put(Bytes.toBytes("rowkey:1001")); 
  13. // 设置family:qualifier:value 
  14. put.add(Bytes.toBytes("family"), Bytes.toBytes("qualifier"), Bytes.toBytes("value")); 
  15. // 使用put类, 写入hbase对应的表中 
  16. htable.put(put); 
  17. } catch (Exception e) { 
  18. e.printStackTrace(); 
  19. } finally { 
  20. if (htable != null) { 
  21. try { 
  22. htable.close(); 
  23. } catch (IOException e) { 
  24. e.printStackTrace(); 
  25. } 
  26. } 
  27. } 

评: HBase的client api编程, 相对还是简单的. 唯一需要注意的是, 若在本地编写测试用列, 需要在本地配置hbase集群相关的域名, 使得域名和ip地址能对应上, 切记.
至于hbase client的读写优化, 我们放到下面的博文进行讲解.

*). 批量导入Bulkload
HBase的bulkload数据导入, 分两个阶段:
#). 阶段一: 借助使用HFileOutputFormat的MapReduce, 直接生成HBase的内部数据存储格式HFile. 
其原理: HFileOutputFormat借助configureIncrementalLoad函数, 基于当前table的各个region边界自动匹配MapReduce的分区类TotalOrderPartitioner, 这样生成的HFile都对应一个具体的region, 此时效率最高效.
#). 阶段二: 借助completebulkload工具, 将生成的HFile文件热载入hbase集群.

1. importtsv数据导入演示
hbase自带了importtsv工具, 其对tsv格式的数据文件提供了默认的支持.
数据文件data.tsv(以'\t'分割数据文件)

1
2
3
4
1001    lilei   17  13800001111
1002    lily    16  13800001112
1003    lucy    16  13800001113
1004    meimei  16  13800001114

上传至hdfs目录 /test/hbase/tsv/input

  1. sudo -u hdfs hdfs dfs -mkdir -p /test/hbase/tsv/input 
  2. sudo -u hdfs hdfs dfs -put data.tsv /test/hbase/tsv/input/ 

尝试构建的HBase表student

  1. hbase shell 
  2. hbase> create 'student', {NAME => 'info'} 

执行importtsv

  1. sudo -u hdfs hadoop jar /usr/lib/hbase/hbase-<version>.jar importtsv -Dimporttsv.columns=HBASE_ROW_KEY,info:name,info:age,info:phone -Dimporttsv.bulk.output=/test/hbase/tsv/output/ student /test/hbase/tsv/input  

没有指定-Dimporttsv.bulk.output, importtsv默认行为是才有client api的put来导入数据于hbase, 指定-Dimporttsv.bulk.output, 则需要下一步

  1. sudo -u hdfs hadoop jar /usr/lib/hbase/hbase-<version>.jar completebulkload /test/hbase/tsv/output/ student 

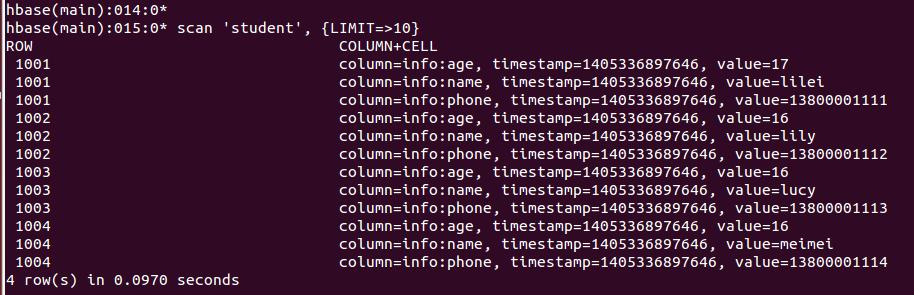
数据验证:
scan 'student', {LIMIT => 10}
2. 自定义bulkload数据导入演示
数据文件准备, 以之前data.tsv文件为准
构建HBase表student_new

  1. hbase> create 'student_new', {NAME => 'info'} 

编写MapReduce代码, 如下所示:

  1. public class MyBulkload { 
  2.   
  3.     public static class MyBulkMapper extends 
  4.             Mapper<LongWritable, Text, ImmutableBytesWritable, KeyValue> { 
  5.   
  6.         @Override 
  7.         protected void setup(Context context) throws IOException, 
  8.                 InterruptedException { 
  9.             super.setup(context); 
  10.         } 
  11.   
  12.         @Override 
  13.         protected void map(LongWritable key, Text value, Context context) 
  14.                 throws IOException, InterruptedException { 
  15.             // 数据按\t切分组织, 也可以自定义的方式来解析, 比如复杂的json/xml文本行 
  16.             String line = value.toString(); 
  17.             String[] terms = line.split("\t"); 
  18.             if ( terms.length == 4 ) { 
  19.                 byte[] rowkey = terms[0].getBytes(); 
  20.                 ImmutableBytesWritable imrowkey = new ImmutableBytesWritable(rowkey); 
  21.                 // 写入context中, rowkey => keyvalue, 列族:列名  info:name, info:age, info:phone 
  22.                 context.write(imrowkey, new KeyValue(rowkey, Bytes.toBytes("info"), Bytes.toBytes("name"), Bytes.toBytes(terms[1]))); 
  23.                 context.write(imrowkey, new KeyValue(rowkey, Bytes.toBytes("info"), Bytes.toBytes("age"), Bytes.toBytes(terms[2]))); 
  24.                 context.write(imrowkey, new KeyValue(rowkey, Bytes.toBytes("info"), Bytes.toBytes("phone"), Bytes.toBytes(terms[3]))); 
  25.             } 
  26.         } 
  27.     } 
  28.   
  29.     public static void main(String[] args) throws Exception { 
  30.   
  31.         if ( args.length != 3 ) { 
  32.             System.err.println("Usage: MyBulkload <table_name> <data_input_path> <hfile_output_path>"); 
  33.             System.exit(2); 
  34.         } 
  35.         String tableName = args[0]; 
  36.         String inputPath = args[1]; 
  37.         String outputPath= args[2]; 
  38.   
  39.         // 创建的HTable实例用于, 用于获取导入表的元信息, 包括region的key范围划分 
  40.         Configuration conf = HBaseConfiguration.create(); 
  41.         HTable table = new HTable(conf, tableName); 
  42.   
  43.         Job job = Job.getInstance(conf, "MyBulkload"); 
  44.           
  45.         job.setMapperClass(MyBulkMapper.class); 
  46.   
  47.         job.setJarByClass(MyBulkload.class); 
  48.         job.setInputFormatClass(TextInputFormat.class); 
  49.   
  50.         // 最重要的配置代码, 需要重点分析 
  51.         HFileOutputFormat.configureIncrementalLoad(job, table); 
  52.   
  53.         FileInputFormat.addInputPath(job, new Path(inputPath)); 
  54.         FileOutputFormat.setOutputPath(job, new Path(outputPath)); 
  55.   
  56.         System.exit(job.waitForCompletion(true) ? 0 : 1); 
  57.           
  58.     } 
  59.   
  60. } 

注: 借助maven的assembly插件, 生成胖jar包(就是把依赖的zookeeper和hbase jar包都打到该MapReduce包中), 否则的话, 就需要用户静态配置, 在Hadoop的class中添加zookeeper和hbase的配置文件和相关jar包.

最终的jar包为 mybulk.jar, 主类名为com.m8zmyp.mmxf.MyBulkload, 生成HFile, 增量热载入hbase

  1. sudo -u hdfs hadoop jar <xxoo>.jar <MainClass> <table_name> <data_input_path> <hfile_output_path> 
  2. hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles <hfile_output_path> <table_name> 

  1. sudo -u hdfs hadoop jar mybulk.jar com.m8zmyp.mmxf.MyBulkload student_new /test/hbase/tsv/input /test/hbase/tsv/new_output 
  2. hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /test/hbase/tsv/new_output student_new 

数据验证:

  1. scan 'student_new', {LIMIT => 10} 

*). 借助Hive Over Hbase

构建Hbase表hbase_student

  1. hbase> create 'hbase_student', 'info' 

构建hive外表hive_student, 并对应hbase_student表

  1. CREATE EXTERNAL TABLE hive_student (rowkey string, name string, age int, phone string) 
  2. STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler' 
  3. WITH SERDEPROPERTIES ("hbase.columns.mapping" = ":key,info:name,info:age,info:phone") 
  4. TBLPROPERTIES("hbase.table.name" = "hbase_student"); 

数据导入验证:
1. 创建数据外表

  1. CREATE EXTERNAL TABLE data_student (rowkey string, name string, age int, phone string) 
  2. ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'  
  3. LOCATION '/test/hbase/tsv/input/'; 

2. 数据通过hive_student导入到hbase_student表中

  1. SET hive.hbase.bulk=true; 
  2. INSERT OVERWRITE TABLE hive_student SELECT rowkey, name, age, phone FROM data_student; 


备注: 若遇到java.lang.IllegalArgumentException: Property value must not be null异常, 需要hive-0.13.0及以上版本支持
详见: https://issues.apache.org/jira/browse/HIVE-5515

原文链接:http://www.cnblogs.com/mumuxinfei/p/3823367.html

开源大数据集群部署(十九)Hbase部署 作者:櫰木。 阅读详情

相关推荐

【硬刚Hbase】Hbase基础(十九):亿级数据从 MySQL 到 Hbase 的三种同步方案与实践(三)同步利器

本文是对《【硬刚大数据之学习路线篇】从零到大数据专家的学习指南(全面升级版)》的Hbase部分补充。 4.1 简单粗暴Sqoop 首先来回顾一下Sqoop架构图: 架构图 这里大家记住一个规则:大数据需要切分!如果不切分,这个亿级数据直接导入会崩溃!!! ★ 什么是Sqoop? ” Sqoop是一个用来将Hadoop和关系型数据库中的数据相互转移的开源工具,可以将一个关系型数据库中的数据导进到Hadoop的HDFS或者HBase等。 sqoop核心参数与代码解释: sqoop import

微信搜:import_bigdata,大数据领域硬核原创作者 464

HBase的数据库数据迁移和数据导入导出

1.背景介绍 1. 背景介绍 HBase是一个分布式、可扩展、高性能的列式存储系统,基于Google的Bigtable设计。它是Hadoop生态系统的一部分,可以与HDFS、MapReduce、ZooKeeper等组件集成。HBase的主要特点是高性能、高可用性、自动分区和负载均衡等。 数据迁移和数据导入导出是HBase的重要功能之一,它可以帮助我们将数据从一个数据库迁移到另一个数据库,或者...

AI天才研究院 2008

【中文OCR】中文字符图片的分割方法

最近想做一个关于中文OCR的小系列,也是对之前做的东西的一个总结。作为这个系列的第一篇,我觉得还是有必要说一下关于中文字符图片分割的问题。因为现在开源的OCR代码比较多,相对而言对字符图片的分割的方法提的比较少,尤其是中文字符图片的分割还是有一定困难在里面的。 一、普遍使用的切割方法 现在大部分开源项目上用切割方法还是基于水平、垂直投影字符切割方法。 原理比较简单容易理解,也比较容易实现。先...

zhangzm0128 1万+

【HBase】(八)往 HBase 导入数据的几种操作

文章目录一、前言二、利用ImportTsv将csv文件导入到HBase三、利用completebulkload将数据导入到HBase四、利用Import将数据导入到HBase 一、前言 HBase作为Hadoop DataBase,除了使用put进行数据导入之外,还有以下几种导入数据的方式: (1)使用importTsv功能将csv文件导入HBase; (2)使用import功能,将数据导入HBa...

云祁QI 2356

yolov5 onnx推理时报错[ONNXRuntimeError] : 2 : INVALID_ARGUMENT : Unexpected input data type.

yolov5 onnxruntime 推理报错

zjulkw的博客 1223

通过 Android Framework 调用高通 Perf HAL 实现 CPU/GPU 动态调频策略

本文详细介绍了如何通过Android Framework调用高通Perf HAL实现CPU/GPU动态调频策略。文章涵盖HAL交互原理、环境搭建、Power HAL接口实现、PerformanceHintManager应用及温度功耗平衡处理,帮助开发者安全高效地进行性能优化,避免直接操作底层硬件的风险。

keras9composer的博客 258

向hbase导入数据的三种方式

向hbase导入数据的三种方式 1.Put对象,是去RPC请求连接数据并一条一条插入或者多条插入. 2.缓存到一定大小之后单次请求一次性插入数据(内存) 3.现在hdfs中已经存在了大量的数据,bulkload方式 text,sequence,csv文件… —>Hflie文件 <<<<<<<<<—表.region 第一种方式PUT 用ja...

weixin_45896475的博客 4071

GCdepth散点图绘制

基因组组装完成后,需要对组装结果进行评估,其中GC_depth图是一个比较重要的指标,改图的横坐标是GC含量,纵坐标是平均深度。以30k为窗口(window)无overlap计算其GC含量和平均深度。如果存在样品污染,通常能够从GC含量分析中呈现出来。下文探索了几种绘制GC_depth散点图的方法思路。

huangliangbo的专栏 8993

四十九、HBase介绍

传统的RDBMS关系型数据库(例如SQL)存储一定量数据时进行数据检索没有问题,可当数据量上升到非常巨大规模的数据(TB或PB)级别时,传统的RDBMS已无法支撑,这时候就需要一种新型的数据库系统更好更快的处理这些数据,我们可以选择HBase。 本文主要是对HBase进行的一个简单介绍,包括HBase的特点、架构以及数据结构。

象在舞的技术专栏 1743

Doris数据过期策略:自动清理历史数据

在数据的世界里,就像我们的房间会堆满各种东西一样,数据库也会积累大量的数据。随着时间的推移,很多历史数据可能不再经常被使用,但它们却占据着宝贵的存储空间。Doris是一款强大的数据库,为了让它能更高效地运行,合理地管理数据,我们就需要一种方法来自动清理那些不再需要的历史数据。本文的目的就是详细介绍Doris的数据过期策略,让大家知道如何利用这个策略来实现自动清理历史数据。范围涵盖了从基本概念到实际操作的各个方面。本文会先介绍一些和Doris数据过期策略相关的术语,让大家对一些专业词汇有个基本的了解。

软件工程实践的博客 558

【Com通信】Com模块的事件帧发送及周期报文的快慢发送机制

Com模块的事件帧发送及周期报文的快慢发送机制

qq_36056498的博客 2335

快学Big Data -- Hbase导数据的几种方式(十九)

Hbase导数据的几种方式 测试数据请到Blog中下载:http://blog.youkuaiyun.com/xfg0218/article/details/51712157     1-1)、hive-hbase-handler导数据 A)、反编译JAR包 http://www.apache.org/dyn/closer.cgi/hive/选择apache-hive-1.2.1-src.tar....

知识的力量 921

以太网GMAC-RK3568

第 2 章和第 3 章中针对 RMII/RGMII 接口芯片和 USB 以太网两种类型芯片在 SDK 上的配置做详细的描述,第 4 章介绍以太网在 Android 上的相关调用接口。第 5 章提供常见问题的排查建议由于在 RK 系列的 SoC 中内置了以太网 MAC 控制器,所以只需要搭配一颗以太网 PHY 芯片,即可实现以太网卡功能按照规范,即使是不同厂家的 PHY,仍然有一部分寄存器的定义是通用的,只要配置了这些通用的寄存器,基本上 PHY 就可以正常工作代码位置在。

qq_24093081的博客 1943

十九、HBase删除数据

从表删除特定单元格 使用 delete 命令,可以在一个表中删除特定单元格。 delete 命令的语法如下: delete ‘&lt;table name&gt;’, ‘&lt;row&gt;’, ‘&lt;column name &gt;’, ‘&lt;time stamp&gt;’ 下面是一个删除特定单元格和例子。在这里,我们删除salary hbase(main):006:0&g...

Fabio的博客 1827

固定效应模型-以stata为工具

固定效应模型(Fixed Effects Model)是一种面板数据分析方法,通过引入个体固定效应来控制个体间的异质性,并更准确地估计解释变量对因变量的影响。它在许多经济、社会科学和健康研究中被广泛应用。

侯小啾技术博客 2840

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

学习总结十九:Hbase数据库shell操作

创建表 create '表名称', '列族名称1','列族名称2','列族名称N' 添加记录       put '表名称', '行名称', '列名称:', '值' 查看记录 get '表名称', '行名称' 查看表中的记录总数 count  '表名称' 删除记录 delete  '表名' ,'行名称' , '列名称' 删除一张表 先要屏蔽该表,才能对该表进行删除,第一步 disable

colinmok的专栏 637

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【大数据面试题】(四)HBase 相关面试题总结

文章目录一、Hbase是什么?二、HBase 的特点是什么?三、HBase 和 Hive 的区别?1)两者是什么?2)两者的特点3)两者的限制4)两者的应用场景5)总结四、HBase 适用于怎样的情景?五、描述 HBase 的 rowKey 的设计原则?1) Rowkey 长度原则2)Rowkey 散列原则3)Rowkey 唯一原则六、描述HBase 中scan 和get 的功能以及实现的异同?七...

云祁QI 4211

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

十九、Hadoop学记笔记————Hbase和MapReduce

概要: hadoop和hbase导入环境变量: 要运行Hbase中自带的MapReduce程序,需要运行如下指令,可在官网中找到: 如果遇到如下问题,则说明Hadoop的MapReduce没有权限访问Hbase的jar包: 参考官网可解决: 运行后解决: 导入数据运行指令: tsv是指以制表符为分隔符的文件 先创建测试数据,创建user文件: 上...

weixin_30446613的博客 211

Hadoop学习三十九:HBase与MapReduce集成

一.概述      HBase与MapReduce集成时,有以下三种情形 HBase作为数据流向。 HBase作为数据源。 HBase作为数据源和数据流向。      阅读本文前,最好先了解http://zy19982004.iteye.com/blog/2068112       二.HBase作为数据流向       HBase作为数据流向时,如从Hdfs里向HBase...

zy19982004的专栏 314

Hbase是什么东西

Hbase是一个大数据环境下基于Hadoop数仓的非关系数据库,有别与Hive,Hive只能说是一个数仓管理工具,也有别于redis,redis是为了web端准备的一种提高效率的数据库,也可以用来做消息中间件,当然消息中间件还是kafka流行 这里是为了点明hbase也是按照表为单位存储数据的,之所以说它不是关系型数据库是因为,hbase是为了大数据设计的,它不遵行三大范式,而且是分布式的 Hbase的组成也很特别,库叫做命名空间,其实就是数据库,一个库中有n张数据表,它的每一张数据表,为了大数据节省运行内

别人笑我太疯癫,我笑他人看不穿。 1377

hadoop系列十九——sqoop知识点总结

1、概述 sqoop是apache旗下一款“Hadoop和关系数据库服务器之间传送数据”的工具。 导入数据:MySQL,Oracle导入数据到Hadoop的HDFS、HIVE、HBASE等数据存储系统。实现hadoop 存储系统和关系型数据库的数据互相迁移; 导出数据:从Hadoop的文件系统中导出数据到关系数据库mysql等。、 2、工作机制 将导入或导出命令翻译成mapreduce程序来实现。...

heartless_killer的博客 319

Hadoop学习(十九)——HBase原理及方法

笔者是一个痴迷于挖掘数据中的价值的学习人,希望在平日的工作学习中,挖掘数据的价值,找寻数据的秘密,笔者认为,数据的价值不仅仅只体现在企业中,个人也可以体会到数据的魅力,用技术力量探索行为密码,让大数据助跑每一个人,欢迎直筒们关注我的公众号,大家一起讨论数据中的那些有趣的事情。 我的公众号为:livandata 1、hbase简介 首先需要介绍一个web的架构: Lvs:linux的...

livan1234的博客 1201

hbase中列簇和列_十九、HBase表、行与列族

HBase表HBase 中表是在 schema 定义时被预先声明的。可以使用以下的命令来创建一个表,在这里必须指定表名和列族名。在 HBase shell 中创建表的语法如下所示:HBase行HBase中的行是逻辑上的行,物理上模型上行是按列族(colomn family)分别存取的。行键是未解释的字节,行是按字母顺序排序的,最低顺序首先出现在表中。空字节数组用于表示表命名空间的开始和结束。HBa...

weixin_35953155的博客 2015
上一篇: HBase总结(十八)Hbase rowkey设计一
下一篇: HBase ORM SimpleHBase设计
codepython
博客等级 码龄20年 125粉丝 6原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值