大数据计算引擎(四)—— Impala

15 数据仓库工具impala 文章目录15 数据仓库工具impalaimpala介绍impala与hive关系impala的优点impala的缺点:impala安装 15 数据仓库工具impala impala介绍 impala是cloudera提供的一款高效率的sql查询工具,提供实时的查询效果,官方测试性能比hive快10到100倍,其sql查询比sparkSQL还要更加快速,号称是当前大数据领域最快的查询sql工具, impala是参照谷歌的新三篇论文(Caffeine、Pregel、Dremel )当中的Dremel实现而来,其 阅读详情

 *重要工具Impala

介绍

Impala是Cloudera提供的⼀一款开源的针对HDFS和HBASE中的PB级别数据进⾏交互式实时查询的一个分布式,大规模并行处理(MPP)数据库引擎,它包括多个进程。最大卖点就是快。

Impala抛弃了了MapReduce 使⽤了类似于传统的MPP数据库技术,大大提⾼了查询的速度。

MPP (Massively Parallel Processing),就是⼤大规模并行处理理,在MPP集群中,每个节点资源都是独⽴享有也就是有独⽴立的磁盘和内存,每个节点通过⽹网络互相连接,彼此协同计算,作为整体提供数据服务。

简单来说,MPP是将任务并⾏的分散到多个服务器和节点上,在每个节点上计算完成后,将各自部分的 结果汇总在⼀一起得到最终的结果

对于MPP架构的软件来说聚合操作⽐比如计算某张表的总条数,则先进⾏局部聚合(每个节点并⾏计算),然后把局部汇总结果进⾏行行全局聚合(与Hadoop相似)。

Impala与Hive对⽐

Impala的技术优势

  • Impala没有采取MapReduce作为计算引擎,MR是⾮非常好的分布式并⾏行行计算框架,但MR引擎更更多的是⾯面向批处理理模式,⽽而不是面向交互式的SQL执行。与 Hive相⽐比:Impala把整个查询任务转为一棵执行计划树,而不是一连串的MR任务,在分发执行计划后,Impala使⽤拉取的方式获取上个阶段的执行结果,把结果数据、按执行树流式传递汇集,减少的了把中间结果写⼊入磁盘的步骤,再从磁盘读取数据的开销。Impala使用服务的方式避免每次执行查询都需要启动的开销,即相比Hive没了MR启动时间。
  • 使用LLVM(C++编写的编译器器)产生运行代码,针对特定查询生成特定代码。
  • 优秀的IO调度,Impala支持直接数据块读取和本地代码计算。
  • 选择适合的数据存储格式可以得到最好的性能(Impala支持多种存储格式)。
  • 尽可能使用内存,中间结果不写磁盘,及时通过网络以stream的⽅方式传递。

安装配置

Impala⻆角⾊色

  • impala-server:这个进程是Impala真正⼯工作的进程,官⽅方建议把impala-server安装在datanode节点,更靠近数据(短路路读取),进程名impalad
  • impala-statestored:健康监控⻆角⾊色,主要监控impala-server,impala-server出现异常时告知给其它impala-server;进程名叫做statestored
  • impala-catalogd :管理理和维护元数据(Hive),impala更更新操作;把impala-server更更新的元数据通知给其它impala-server,进程名catalogd

官⽅方建议statestore与catalog安装在同⼀一节点上!!

⭐⭐⭐HIVE要集群模式 开启Metastore 建议Matestore与impala-server在一个机子

linux3安装:

yum install impala -y

yum install impala-server -y

yum install impala-state-store -y

yum install impala-catalog -y

yum install impala-shell -y

linux1 linux2 安装

yum install impala-server -y

yum install impala-shell -y

linux3启动

nohup hive --service metastore &

linux1启动

nohup hive --service hiveserver2 &

短路路读取:就是Client与DataNode属于同⼀一节点,⽆无需再经过⽹网络传输数据,直接本地读取。

所有impala节点执行命令:

ln -s /opt/lxq/servers/hadoop-2.9.2/etc/hadoop/core-site.xml

/etc/impala/conf/core-site.xml

ln -s /opt/lxq/servers/hadoop-2.9.2/etc/hadoop/hdfs-site.xml

/etc/impala/conf/hdfs-site.xml

ln -s /opt/lxq/servers/hive-2.3.7/conf/hive-site.xml

/etc/impala/conf/hive-site.xml

所有节点修改:vim /etc/default/impala

<!--更更新如下内容 -->

IMPALA_CATALOG_SERVICE_HOST=linux123

IMPALA_STATE_STORE_HOST=linux123

MYSQL_CONNECTOR_JAR=/usr/share/java/mysql-connector-java.jar

所有节点创建:

# 所有节点创建节点,并建立软连接

mkdir -p /usr/share/java

ln -s /opt/lxq/servers/hive-2.3.7/lib/mysql-connector-java-5.1.46.jar

/usr/share/java/mysql-connector-java.jar

vim /etc/default/bigtop-utils

export JAVA_HOME=/opt/lxq/servers/jdk1.8.0_231

#linux123启动如下⻆角⾊色

service impala-state-store start

service impala-catalog start

service impala-server start

#其余节点启动如下⻆角⾊色

service impala-server start

ps -ef | grep impala

访问impalad的管理理界⾯面

http://linux123:25000/

访问statestored的管理理界⾯面

http://linux123:25010/

启动之后所有关于Impala的⽇日志默认都在/var/log/impala 这个路路径下,Linux123机器器上⾯面应该有三个进程,Linux121与Linux122机器器上⾯面只有⼀一个进程,如果进程个数不不对,去对应⽬目录下查看报错⽇日志.

Impala会附带安装一些其它东西,要删除

[root@linux122 conf]# which hadoop

/usr/bin/hadoop

[root@linux122 conf]# which hive

/usr/bin/hive

which命令 查找hadoop,hive等会发现,命令文件是/usr/bin/hadoop ⽽非我们自己安装的路

径,需要把这些删除掉,所有节点都要执⾏

[root@linux122 conf]# which hadoop

/usr/bin/hadoop

[root@linux122 conf]# which hive

/usr/bin/hive

rm -rf /usr/bin/hadoop

rm -rf /usr/bin/hdfs

rm -rf /usr/bin/hive

rm -rf /usr/bin/beeline

rm -rf /usr/bin/hiveserver2

#重新⽣生效环境变量量

source /etc/profile

进入impala命令: impala-shell

impala的操作流程更HIVE差不多,就不多重复写了

原理

查询原理

impalad

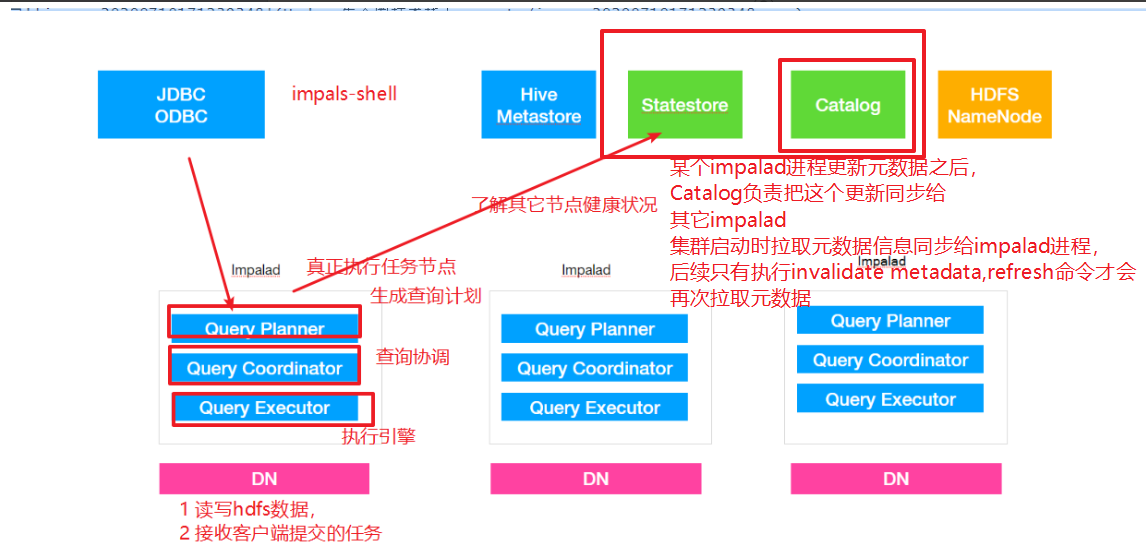
  • 作⽤用,负责读写数据⽂文件,接收来⾃自Impala-shell,JDBC,ODBC等的查询请求,与集群其它Impalad分布式并行完成查询任务,并将查询结果返回给中心协调者。
  • 角色名称为Impala Daemon,是在每个节点上运⾏行行的进程,是Impala的核⼼心组件,进程名是 Impalad;
  • 为了保证Impalad进程了了解其它Impalad的健康状况,Impalad进程会一直与statestore保持通信。
  • Impalad服务由三个模块组成:Query Planner、Query Coordinator和Query Executor,前两个 模块组成前端,负责接收SQL查询请求,解析SQL并转换成执⾏行行计划,交由后端执⾏行行,

statestored

  • statestore监控集群中Impalad的健康状况,并将集群健康信息同步给Impalad,
  • statestore进程名为statestored

catalogd

  • Impala执行的SQL语句句引发元数据发⽣生变化时,catalog服务负责把这些元数据的变化同步给其它Impalad进程(⽇日志验证,监控statestore进程⽇日志)
  • catalog服务对应进程名称是catalogd
  • 由于⼀一个集群需要⼀一个catalogd以及⼀一个statestored进程,⽽而且catalogd进程所有请求都是经过statestored进程发送,所以官⽅方建议让statestored进程与catalogd进程安排同个节点。

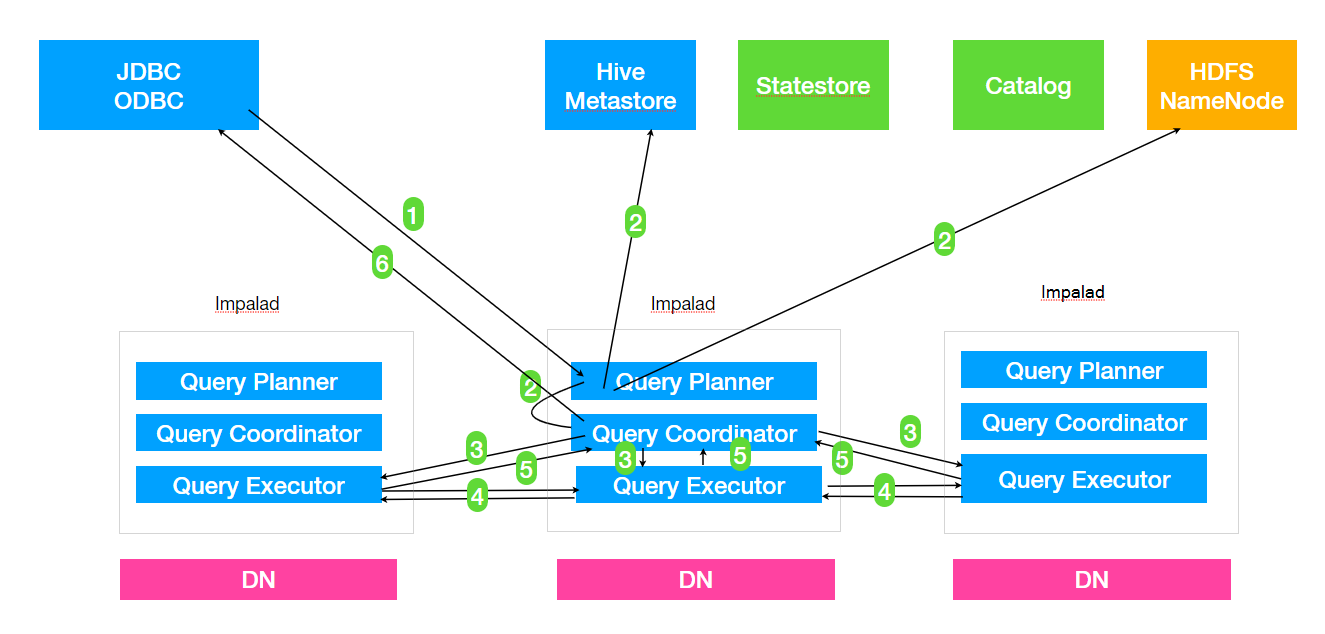
1. Client提交任务

Client发送⼀一个SQL查询请求到任意⼀一个Impalad节点,会返回⼀一个queryId⽤用于之后的客户端操

作。

2. ⽣生成单机和分布式执⾏行行计划

SQL提交到Impalad节点之后,Analyser依次执⾏行行SQL的词法分析、语法分析、语义分析等操作;

从MySQL元数据库中获取元数据,从HDFS的名称节点中获取数据地址,以得到存储这个查询相关

数据的所有数据节点

单机执⾏行行计划: 根据上⼀一步对SQL语句句的分析,由Planner先⽣生成单机的执⾏行行计划,该执⾏行行计

划是有PlanNode组成的⼀一棵树,这个过程中也会执⾏行行⼀一些SQL优化,例例如Join顺序改变、谓

词下推等。

分布式并⾏行行物理理计划:将单机执⾏行行计划转换成分布式并⾏行行物理理执⾏行行计划,物理理执⾏行行计划由⼀一

个个的Fragment组成,Fragment之间有数据依赖关系,处理理过程中需要在原有的执⾏行行计划

之上加⼊入⼀一些ExchangeNode和DataStreamSink信息等。

Fragment : sql⽣生成的分布式执⾏行行计划的⼀一个⼦子任务;

DataStreamSink:传输当前的Fragment输出数据到不不同的节点

3. 任务调度和分发

Coordinator将Fragment(⼦子任务)根据数据分区信息发配到不不同的Impalad节点上执⾏行行。Impalad

节点接收到执⾏行行Fragment请求交由Executor执⾏行行。

4. Fragment之间的数据依赖

每⼀一个Fragment的执⾏行行输出通过DataStreamSink发送到下⼀一个Fragment,Fragment运⾏行行过程中

不不断向coordinator节点汇报当前运⾏行行状态。

5. 结果汇总

查询的SQL通常情况下需要有⼀一个单独的Fragment⽤用于结果的汇总,它只在Coordinator节点运

⾏行行,将多个节点的最终执⾏行行结果汇总,转换成ResultSet信息。

6. 获取结果

客户端调⽤用获取ResultSet的接⼝口,读取查询结果。
优化

⽂文件格式

对于⼤大数据量量来说,Parquet⽂文件格式是最佳的

避免⼩小⽂文件

insert ... values 会产⽣生⼤大量量⼩小⽂文件,避免使⽤用

合理理分区粒度

利利⽤用分区可以在查询的时候忽略略掉⽆无⽤用数据,提⾼高查询效率,通常建议分区数量量在3万以下

(太多的分区也会造成元数据管理理的性能下降)

分区列列数据类型最好是整数类型

分区列列可以使⽤用string类型,因为分区列列的值最后都是作为HDFS⽬目录使⽤用,如果分区列列使⽤用

整数类型可以降低内存消耗

获取表的统计指标:在追求性能或者⼤大数据量量查询的时候,要先获取所需要的表的统计指标

(如:执⾏行行 compute stats )

减少传输客户端数据量量

聚合(如 count、sum、max 等)

过滤(如 WHERE )

limit限制返回条数

返回结果不不要使⽤用美化格式进⾏行行展示(在通过impala-shell展示结果时,添加这些可选参数: -

B、 --output_delimiter )

在执⾏行行之前使⽤用EXPLAIN来查看逻辑规划,分析执⾏行行逻辑

Impala join⾃自动的优化⼿手段就是通过使⽤用COMPUTE STATS来收集参与Join的每张表的统计信

息,然后由Impala根据表的⼤大⼩小、列列的唯⼀一值数⽬目等来⾃自动优化查询。为了了更更加精确地获取

每张表的统计信息,每次表的数据变更更时(如执⾏行行Insert,add partition,drop partition等)最好

都要执⾏行行⼀一遍COMPUTE STATS获取到准确的表统计信息。

感谢阅读!!!

大数据——Impala工具使用 一、Impala概述 Impala是Cloudera公司推出,提供对HDFS、Hbase数据的高性能、低延迟的交互式SQL查询功能。 基于Hive使用内存计算,兼顾数据仓库、具有实时、批处理、多并发等优点 与Apache Hive有相同的元数据、SQL语法、ODBC驱动、用户界面 能直接对存储在HDFS和HBase中的数据提供快速、交互式SQL查询 是CDH平台首选的PB级大数据实时查询分析引擎 二、Impala优点 熟悉的SQL接口 能够在Apache Hadoop中查询大量数据 集群环境 阅读详情

相关推荐

【大数据】大数据OLAP查询引擎选型对比

目前大数据比较常用的OLAP查询引擎包括:Presto、Impala、Druid、Kylin、Doris、Clickhouse、GreenPlum等。不同引擎特点不尽相同,针对不同场景,可能每个引擎的表现也各有优缺点。

wnm23的专栏 8085

OLAP(三):Impala介绍 、 (和hive/spark对比)、COMPUTE STATS

一、Impala概述 Impala是用于处理存储在Hadoop集群中的大量数据的MPP(大规模并行处理)SQL查询引擎。与其他Hadoop的SQL引擎相比,它提供了高性能和低延迟。换句话说,Impala是性能最高的SQL引擎(提供类似RDBMS的体验),它提供了访问存储在Hadoop分布式文件系统中的数据的最快方法。 二、为什么选择Impala?Impala的优点:Impala数据查询效率比Hive快几倍甚至数十倍 Impala通过使用标准组件(如HDFS,HBase.................

. 1万+

大数据分析(Big Data OLAP)引擎Dremel, Tenzing 以及Impala

对于数据分析师来说,SQL是主要的语言。 Hive为Hadoop提供了支持SQL运行的能力,可是目前Hive运行速度达不到实时要求。这是因为Hive将SQL翻译成一个或多个MapReduce任务,而MapReduce原本是大数据批处理计算框架,并不适应实时数据分析的速度要求。   现在有两种思路去提高SQL在大数据平台上的执行速度: 1.      用一种更快的SQL执行引擎取代MapRed

xhanfriend的专栏 5221

Impala的介绍、使用和原理架构

impala是cloudera提供的一款高效率的sql查询工具,提供实时的查询效果,官方测试性能比hive快10到100倍,其sql查询比sparkSQL还要更加快速,号称是当前大数据领域最快的查询sql工具,impala是参照谷歌的新三篇论文(Caffeine–网络搜索引擎、Pregel–分布式图计算、Dremel–交互式分析工具)当中的Dremel实现而来,其中旧三篇论文分别是(BigTable,GFS,MapReduce)分别对应我们即将学的HBase和已经学过的HDFS以及MapReduce。

迷雾总会解 6975

【大数据入门核心技术-Impala】(一)Impala简介

Impala是Cloudera公司主导开发的新型查询系统,它提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据。已有的Hive系统虽然也提供了SQL语义,但由于Hive底层执行使用的是MapReduce引擎,仍然是一个批处理过程,难以满足查询的交互性。相比之下,Impala的最大特点也是最大卖点就是它的快速。

3434

【项目实战】常见的数据仓库Impala

Impala,是Cloudera开发的一款开源的SQL查询引擎。Impala,为Hadoop环境提供了高性能、低延迟的查询能力。Impala,可以直接在Hadoop的HDFS和HBase上运行,而无需将数据移动到关系型数据库中。Impala,采用MPP(Massively Parallel Processing)架构。Impala,能够实现大规模并行处理,提供近实时的查询响应。

奶爸的编程之路,也就一周冷个三天 812

【Impala】基于Hive的快速大数据查询引擎——Impala知识点总结

content Impala简介 Impala系统架构 Impala核心组件 Impala查询执行过程 Impala的优缺点 Impala与Hive的比较       Impala简介 Impala是由Cloudera公司开发的新型查询系统 Imapla提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据 Impala基于MPP (Massively Parallel Processor ,大规模并行处理) Impala最大的卖点就是——快速.

丧心病狂Loli控的博客 2939

手机相机基础技术解析:从硬件到算法的全面指南

手机相机的成像过程可简化为的链路,其核心硬件包括 镜头、CMOS传感器、ISP(图像信号处理器) 以及配套的软件算法。

weixin_44239603的博客 2448

大数据时代快速SQL引擎-Impala

背景随着大数据时代的到来,Hadoop在过去几年以接近统治性的方式包揽的ETL和数据分析查询的工作,大家也无意间的想往大数据方向靠拢,即使每天数据也就几十、几百M也要放到Hadoop上作分析,只会适得其反,但是当面对真正的Big Data的时候,Hadoop就会暴露出它对于数据分析查询支持的弱点。甚至出现《MapReduce: 一个巨大的倒退》此类极端的吐槽,这也怪不得Hadoop,毕竟它的设计就是

Hello World 3万+

RSA 2048/4096 签名校验算法

RSA算法是一种非对称密码算法,所谓非对称,就是指该算法需要一对密钥,使用其中一个加密,则需要用另一个才能解密。 RSA是目前最有影响力和最常用的公钥加密算法,它能够抵抗到目前为止已知的绝大多数密码攻击,已被ISO推荐为公钥数据加密标准。 今天只有短的RSA钥匙才可能被强力方式解破。到2008年为止,世界上还没有任何可靠的攻击RSA算法的方式。只要其钥匙的长度足够长,用RSA加密的信息实际上是不能...

qq_38769551的博客 9497

【论文汇总】Diffusion Models视频生成/视频编辑/可控视频生成/跨模态视频生成

本文总结了Diffusion Models视频生成领域相关的工作,目前共收录142篇,持续更新中。

沉迷单车的追风少年 1671

Hive、Sparksql、Presto、Impala、Hawq、Clickhouse、Greenplum大数据查询引擎对比

导读 现在大数据组件非常多,众说不一,在每个企业不同的使用场景里究竟应该使用哪个引擎呢?这是易观Spark实战营出品的开源Olap引擎测评报告,团队选取了Hive、Sparksql、Presto、Impala、Hawq、Clickhouse、Greenplum大数据查询引擎,在原生推荐配置情况下,在不同场景下做一次横向对比,供大家参考。   每年易观都会发布一次这样的大数据开源测评报告,欢迎...

窗外的屋檐 1万+

华为OD机考双机位C卷 - 风险投资计划(Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 风险投资计划(OD上机考试双机位C卷)。提供Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。

算法大师! 547

Impala与Hive计算引擎

当 Impala 与 YARN 集成时,YARN 负责管理集群中的计算资源,如 CPU 和内存,并根据 Impala 的需求进行资源分配。此外,YARN 还提供了容错机制,可以在节点故障时自动重新分配任务,从而确保 Impala 作业的可靠性。这种动态代码生成技术能够显著提高查询的执行效率,因为生成的代码是专门为该查询定制的,能够充分利用底层硬件的特性。Impalad 是 Impala 的守护进程,它运行在 Hadoop 集群的每个节点上,与 DataNode 运行在同一节点上。

weixin_61006262的博客 1298

虚拟网络的“隐形盾”:C#如何用代码把DDoS踢出门?

本文分享了如何用C#防御DDoS攻击的实战经验。通过三种核心防御策略:1)基于IP的速率限制中间件,使用滑动时间窗口算法控制请求流量;2)自动IP封禁服务,通过特征检测识别恶意IP并加入黑名单;3)优化数据库连接池和HTTP客户端连接池,合理配置资源参数。文中提供了详细的C#代码实现,包括限流中间件、IP封禁服务和连接池优化方案,并分享了生产环境中的调优经验,如配合Redis实现分布式限流、使用fail2ban自动封禁等技巧,帮助开发者构建更健壮的防御体系。

墨夶的博客 329

【TC3xx芯片】TC3xx芯片UCB详解

TC3xx芯片UCB详解

qq_36056498的博客 1万+

【Big Data】Apache Impala 实时大数据分析引擎

Apache Impala 是一个开源的、高性能的分布式 SQL 查询引擎,专为 Hadoop 生态系统设计,能够直接查询存储在 HDFS 或 HBase 中的大数据集。Impala 采用大规模并行处理(MPP)架构,通过绕过 MapReduce 框架,直接访问数据存储系统,实现了低延迟的交互式分析能力,填补了 Hadoop 生态中实时查询的空白。

愚者Turbo的博客 1963

ofd转pdf报错:org.ofdrw.reader.ZipUtil.unZipFileByApacheCommonCompress【已解决】

ofd转pdf报错:java.lang.NoClassDefFoundError:org/apache/commons/io/function/IOIterator at org.ofdrw.reader.ZipUtil.unZipFileByApacheCommonCompress,java.lang.NoSuchMethodError:org.apache.commons.compress.archivers.zip.ZipArchiveInputStream.getNextEntry()

黄团团的个人博客 1283

大数据Hadoop之——基于Hive的内存型SQL查询引擎Impala(Impala环境部署)

文章目录一、概述 一、概述 Impala的服务端是一个分布式的、大规模并行处理(MPP:Massively Parallel Processing)数据库引擎。不像hive,impala的服务端天然就是分布式的,在架构层面上,它在安装时就会跟DN计算节点放在一起。Impala官方文档 ...

匠人精神,持之以恒! 3263

【软件系统架构】系列四:嵌入式技术

嵌入式系统是以应用为中心、以计算机技术为基础,并将可配置与可裁剪的软硬件集成于一体的专用计算机系统。它需要满足功能、可靠性、成本、体积、功耗等方面的严格要求。 嵌入式系统一般由以下组成部分构成:

moton2017的博客 999

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Impala查询引擎一篇应该够用额

impala是cloudera提供的一款高效率的sql查询工具,提供实时的查询效果,官方测试性能比hive快10到100倍,其sql查询比sparkSQL还要更加快速,号称是当前大数据领域最快的查询sql工具

我的博客 1894

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

大数据之Impala安装使用

Kylin和Impala区别: 既然在线分析已经使用了kylin,为啥还用impala呢? 因为kylin不够灵活,只能分析简单的星型/雪花模型,impala可以通过窗口函数,进行复杂的行为数据分析; 反之,当数据量大的时候,impala比较慢,所以只用kylin进行预计算。 一、 ...

大数据同盟会的博客 8121

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

大数据计算引擎:impala对比hive

Hive: 采用推的方式,每一个计算节点计算完成后将数据主动推给后续节点。 Impala: 采用拉的方式,后续节点通过getNext主动向前面节点要数据,以此方式数据可以流式的返回给客户端,且只要有1条数据被处理完,就可以立即展现出来,而不用等到全部处理完成,更符合SQL交互式查询使用。

独木不成林,单弦不成音。 1万+

大数据技术入门:impala查询引擎,三年经验月薪50k我是怎么做到的

一、概述二、技术特性三、功能特性四、Impala 工作原理五、日常运维指令一、概述=================================================================Impala是Cloudera公司主导开发的新型查询系统,它提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据。已有的Hive系统虽然也提供了SQL语义,但由于Hive底层执行使用的是MapReduce引擎,仍然是一个批处理过程,难以满足查询的交互性。相比之下,Impal

2401_84181070的博客 760

Impala:基于内存的MPP查询引擎

Impala是Cloudera公司主导研发的高性能、低延迟的交互式SQL查询引擎,它提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据。Impala主要用于解决Hadoop生态圈无法支持交互式查询数据的痛点,Impala是CDH平台首选的PB级大数据实时交互式查询分析引擎2015年11月,Cloudera将Impala捐赠给了Apache基金会,2017年11月,Impala从Apache孵化器毕业。

Java/Python大数据随笔 2262

大数据技术入门:impala查询引擎

Impala是Cloudera公司主导开发的新型查询系统,它提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据。已有的Hive系统虽然也提供了SQL语义,但由于Hive底层执行使用的是MapReduce引擎,仍然是一个批处理过程,难以满足查询的交互性。相比之下,Impala的最大特点也是最大卖点就是它的快速。----来源于百度百科Impala核心能力Impala是性能最高的SQL引擎(提供类似RDBMS的体验),它提供了访问存储在Hadoop分布式文件系统中的数据的最快方法。Im

我这么骄傲的一个人。 1458
上一篇: 大数据计算引擎(三)——Elasticsearch入门
下一篇: Hadoop技术栈(八)Hbase
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值