sklearn cross_validation交叉验证

【模型评估】k折交叉验证和sklearn运用实战(cross validation) k折交叉验证(cross validation) 留一法是特殊的k折交叉验证。k折交叉验证主要用于判断是否过拟合。k折交叉验证一般采用分层采样法取得训练集和验证集。分层采样是指,每个类按照比例在总体中随机取数据。 k折交叉验证(cross validation)实例 这是之前用过的逻辑回归的例子,重点放在后面的交叉验证上。 用sklearn中的数据集iris 导入需要的包 from sklearn... 阅读详情
from sklearn import datasets
from sklearn.cross_validation import train_test_split
from sklearn.neighbors import KNeighborsClassifier

# cross_validation交叉验证

iris = datasets.load_iris()
X = iris.data
y = iris.target

X_train, X_test, y_train, y_test = train_test_split(X,y,test_size=0.3)
# n_neightbors 综合附近5个点来考虑y的值
knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train,y_train)
print(knn.score(X_test,y_test))

结果:0.9555555555555556
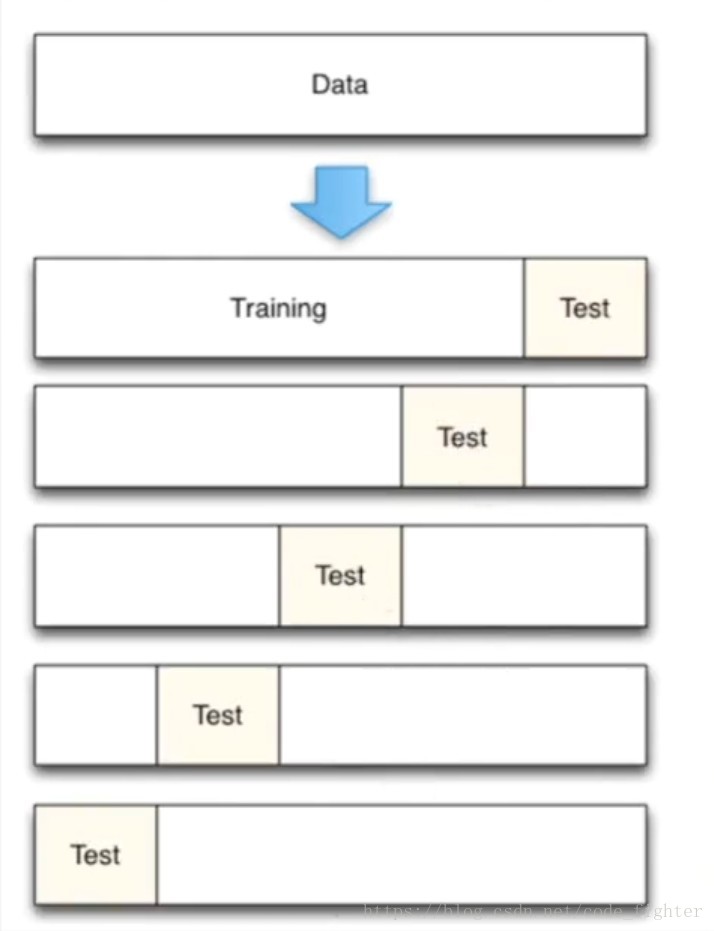
这里写图片描述

from sklearn import datasets
from sklearn.cross_validation import train_test_split
from sklearn.neighbors import KNeighborsClassifier

# cross_validation交叉验证

iris = datasets.load_iris()
X = iris.data
y = iris.target

from sklearn.cross_validation import cross_val_score
knn = KNeighborsClassifier(n_neighbors=5)
# 使用的model是knn 但是X,y 被自动分成5组,
# 每组的test_data和train_data 是不一样的
scores = cross_val_score(knn,X,y,cv=5,scoring='accuracy')
print(scores.mean())

结果:0.9733333333333334

from sklearn import datasets
from sklearn.cross_validation import train_test_split
from sklearn.neighbors import KNeighborsClassifier

# cross_validation交叉验证

iris = datasets.load_iris()
X = iris.data
y = iris.target

from sklearn.cross_validation import cross_val_score
import matplotlib.pyplot as plt

k_range = range(1,31)
k_score = []
for k in k_range:
    knn = KNeighborsClassifier(n_neighbors=k)
    scores = cross_val_score(knn,X,y,cv=10,scoring='accuracy')# for classification
    #loss = -cross_val_score(knn,X,y,cv=10,scoring='mean_squared_error')# for regression
    k_score.append(scores.mean())

plt.plot(k_range, k_score)
plt.xlabel('Value of K for KNN')
plt.ylabel('Corss-Validated Accuracy')
plt.show()
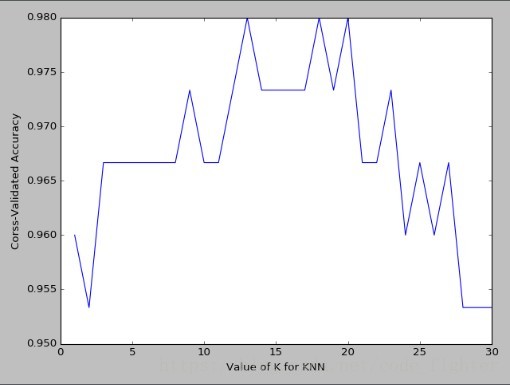

这里写图片描述

[机器学习] sklearn交叉验证(Cross-validation) https://blog.youkuaiyun.com/guanyuqiu/article/details/86006474 交叉验证(Cross Validation)用来验证分类器的性能一种统计分析方法, 原始数据(dataset)进行分组,一部分用来为训练集(train set),另一部分做为验证集(validation set)。 利用训练集训练分类器,然后利用验证集验证模型,记录最后的分类准确率为此分类器的性能指标。 那么什么时候才需要交叉验证呢?交叉验证用在数据不是很充足的时候。 如果数据样本量小于 一万条 阅读详情

相关推荐

Python教程:一文了解Python的深拷贝与浅拷贝

理解 Python 中的深拷贝(deep copy)和浅拷贝(shallow copy)是非常重要的,特别是在处理嵌套结构的数据时。让我们深入探讨这两个概念,并通过代码示例进行说明。

旦莫的博客 3968

Sklearn——交叉验证(Cross Validation)

文章目录1.前言2.非交叉验证实验3.交叉验证实验4.准确率与平方误差4.1.准确率实验 1.前言 Sklearn 中的 Cross Validation (交叉验证)对于我们选择正确的 Model 和 Model 的参数是非常有帮助的, 有了它的帮助,我们能直观的看出不同 Model 或者参数对结构准确度的影响。 2.非交叉验证实验 from sklearn.datasets import lo...

weixin_37763870的博客 3313

飞牛fnNAS搭建Web网页版OFFICE(WPS)软件

本文介绍了如何在飞牛NAS上通过Docker容器部署WPS Office办公软件。主要内容包括:启用Docker服务、准备项目文件夹结构、使用Compose方式构建容器、解决端口冲突问题、配置中文输入法和字体库,以及通过ZeroTier实现远程访问。文章详细说明了每个步骤的操作方法,包括容器启动、输入法设置、字体添加和文件存储位置配置。最后还介绍了使用ZeroTier内网穿透技术实现远程访问NAS上WPS服务的方法,让用户可以在不同设备上随时编辑NAS中的文件。整个部署过程完整清晰,为NAS用户提供了便捷的

dgnankai的专栏 1702

sklearn中的交叉验证(Cross-Validation)

这个repo 用来记录一些python技巧、书籍、学习链接等,欢迎star github地址 sklearn是利用python进行机器学习中一个非常全面和好用的第三方库,用过的都说好。今天主要记录一下sklearn中关于交叉验证的各种用法,主要是对sklearn官方文档 Cross-validation: evaluating estimator performance进行讲解,英文水平好...

Great haste makes great waste 13万+

5、基于模型的系统工程(MBSE)全面解析

本文全面解析了基于模型的系统工程(MBSE),介绍了模型在系统工程中的核心地位,以及如何通过视图和符号表示法实现信息的可视化。文章还详细阐述了MBSE的方法构成,包括框架(本体和视图点)和流程集,探讨了MBSE的实施流程、关键要素、应用策略以及未来发展趋势。通过合理应用MBSE,组织可以提高系统开发的效率和质量,降低成本与风险,实现成功部署。

nft7creator的博客 127

多跳问答技术解析:从原理到金融领域实践

多跳问答(Multi-hop QA)是自然语言处理中的高级任务,要求系统通过多步推理整合分散信息来回答问题。其核心技术在于理解文档间的复杂关联,相比单跳问答需要更精细的数据集设计和模型架构。在金融、医疗等专业领域,多跳问答能有效处理如'腾讯大股东投资的港股上市公司'这类需要串联多个信息点的问题。典型实现方案包括MR-Search框架的三级检索器设计,分别处理实体召回、关系匹配和数值比较。当前最佳实践表明,结合稠密检索与稀疏检索的混合策略,配合动态路由机制,能在保持较高精度的同时控制计算成本。这类技术在金融风

weixin_42566072的博客 607

一文学会sklearn中的交叉验证方法,cross_validate和KFlod实战案例

在机器学习中,我们经常需要评估模型的性能。而为了准确评估模型的性能,我们需要使用一种有效的评估方法。五折交叉验证(5-fold cross-validation)就是其中一种常用的模型评估方法,用于评估机器学习模型的性能和泛化能力。在本文中,我们将介绍五折交叉验证的原理和实现方法,并探讨其在模型评估中的重要性。在机器学习中,我们通常需要将数据集分为训练集和测试集。训练集用于训练模型,而测试集用于评估模型的性能。

高级数据分析师,分享Python知识 2689

PPT制作能力在职场中真的重要吗?一定要美术功底才能学好PPT吗?

我推出PPT技能培训专栏啦!好的PPT可以让你事半功倍、2023拥有PPT能力还可以让你具备一门极有价值的斜杠能力。更多内容请进:梦幻训练营专栏。专栏内会用本人积累的近10年的PPT学习方法论在短时间内教会你如何制作出精美绝伦的PPT,每篇教程后还会免费赠送一些小福利,不可多得。

打造全国最全的AI Agent开发知识领域的博客 728

sklearn中的交叉验证(Cross-Validation)_使用sklearn库进行预测结果的交叉验证,需要导入一下哪个包( )。

(img-Ps8nCt6s-1715792064412)](img-a6gvGSfQ-1715792064412)]#使用KFold实现LeaveOneOtut。

2401_85011985的博客 1301

【知识分享】IBIS 建模指南 04

文章详细阐述了将缓冲器数据转换为IBIS模型格式的核心步骤与规范要求。主要内容包括:1)IBIS文件三大结构(文件头信息、组件引脚映射、缓冲器行为描述)及其关键词定义;2)四种关键I-V表(上下拉、电源/地钳位)的数据处理规则,强调需避免重复计算效应;3)切换特性描述方法,指出V-T波形表优于Ramp数据的三大优势;4)差分缓冲器通过[DiffPin]关键词实现建模的特殊流程。文中特别强调数据外推校验、参考电压基准转换、工艺角数据排序等易错环节的处理技巧,为创建符合IBIS 4.0规范的精确模型提供指导。

一只豌豆象的博客 2054

如何给数据添加高斯白噪声?

首先测试集应该是加噪声的,至于训练集需不需要加噪声就见仁见智了。我个人测试的结果是,训练集如果不加噪声的话效果特别差,如果加噪声的话效果就比较好接受,大家可以自己试试看。在轴承故障研究中免不了要涉及到给数据主动加入噪声的情况,一般我们加的是高斯白噪声。由于热噪声是由大量自由电子的运动产生的,其统计特性服从高斯分布,故常将热噪声称为高斯白噪声。的频谱是均匀分布的,好像白光的频谱在可见光的频谱范围内均匀分布那样,所以热噪声又常称为。定义一:如果一个噪声,它的瞬时值服从。又是均匀分布的,则称它为高斯白噪声。

weixin_50642818的博客 5220

python sklearn包——3.1cross validation笔记

preface:做实验少不了交叉验证,平时常用from sklearn.cross_validation import train_test_split,用train_test_split()函数将数据集分为训练集和测试集,但这样还不够。当需要调试参数的时候便要用到K-fold。scikit给我们提供了函数,我们只需要调用即可。 sklearn包中cross validation的介绍:在这里。

无限大地NLP_空木的专栏 1万+

SoulX-FlashHead 加速实践,提升3倍。

SoulX-FlashHead 加速实践,提升3倍。

jacke121的专栏 224

机器学习笔记——sklearn 交叉验证(Cross-validation)

sklearn cross validation:https://scikit-learn.org/stable/modules/cross_validation.html 交叉验证(Cross Validation)用来验证分类器的性能一种统计分析方法,基本思想是把在某种意义下降原始数据(dataset)进行分组,一部分用来为训练集(train set),另一部分做为验证集(validatio...

sunny的专栏 3万+

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

sklearn交叉验证法(Cross Validation)

sklearn交叉验证法(Cross Validation) import numpy as np from sklearn import datasets from sklearn.cross_validation import train_test_split from sklearn.neighbors import KNeighborsC...

哎呀妈呀脑壳疼脑壳疼 749

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

5折交叉验证_8. Sklearn — 交叉验证(Cross-Validation)

总结:交叉验证(Cross validation),交叉验证用于防止模型过于复杂而引起的过拟合.有时亦称循环估计, 是一种统计学上将数据样本切割成较小子集的实用方法。于是可以先在一个子集上做分析, 而其它子集则用来做后续对此分析的确认及验证。 一开始的子集被称为训练集。而其它的子集则被称为验证集或测试集。交叉验证是一种评估统计分析、机器学习算法对独立于训练数据的数据集的泛化能力(generaliz...

weixin_39892481的博客 1719

python 利用sklearn.cross_validation的KFold构造交叉验证数据集

KFold通过提供index来给你确定不同组的训练集以及测试的index,来构造交叉验证数据集。参数(n, n_folds=3, shuffle=False, random_state=None) n为总数 n_folds为分为多少个交叉验证集 shuffle为是否随机 random_state设置随机因子from sklearn.cross_validation import KFoldimpor

hxshine的博客 2万+

k折交叉验证matlab 流程_8. Sklearn — 交叉验证(Cross-Validation)

总结:交叉验证(Cross validation),交叉验证用于防止模型过于复杂而引起的过拟合.有时亦称循环估计, 是一种统计学上将数据样本切割成较小子集的实用方法。于是可以先在一个子集上做分析, 而其它子集则用来做后续对此分析的确认及验证。 一开始的子集被称为训练集。而其它的子集则被称为验证集或测试集。交叉验证是一种评估统计分析、机器学习算法对独立于训练数据的数据集的泛化能力(generaliz...

weixin_42353258的博客 1560

sklearn FKold K折交叉验证 k-fold cross validation

C:\Users\pcl>conda activate torch38 (torch38) C:\Users\pcl>python Python 3.8.11 (default, Aug 6 2021, 09:57:55) [MSC v.1916 64 bit (AMD64)] :: Anaconda, Inc. on win32 Type "help", "copyright", "credits" or "license" for more information. >>&g.

power的专栏 497

sklearn炼丹术之——交叉验证Cross-validation: evaluating estimator performance

https://scikit-learn.org/stable/modules/cross_validation.html#

周迪新的博客 238
上一篇: sklearn normalization 数据标准化
下一篇: sklearn 保存训练模型的两种方法
jeffery0628
博客等级 码龄11年 39粉丝 112原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值