大数据之实时处理SparkStreaming

从0开始学大数据15-流式计算的代表:Storm、Flink、SparkStreaming 我前面介绍的大数据技术主要是处理、计算存储介质上的大规模数据,这类计算也叫大数据批处理计算。顾名思义,数据是以批为单位进行计算,比如一天的访问日志、历史上所有的订单数据等。这些数据通常通过HDFS存储在磁盘上,使用MapReduce或者Spark这样的批处理大数据计算框架进行计算,一般完成一次计算需要花费几分钟到几小时的时间。此外,还有一种大数据技术,针对实时产生的大规模数据进行即时计算处理,我们比较熟悉的有摄像头采集的实时视频数据、淘宝实时产生的订单数据等。 阅读详情
1. Spark Streaming基础知识

Spark Streaming是spark核心API的一个扩展,可以实现高吞吐量、有容错机制的实时流数据处理。
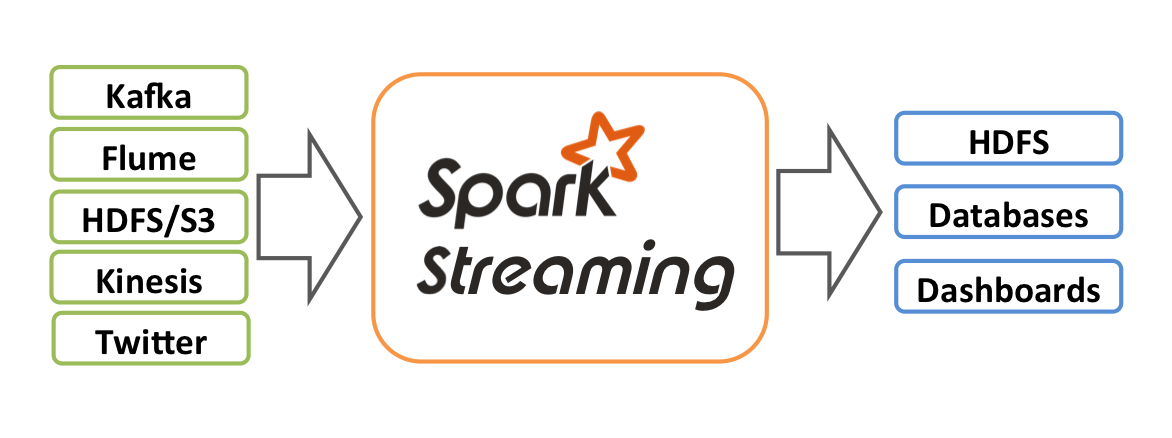
支持多种数据源获取数据:Spark Streaming接收Kafka、Flume、HDFS等各种来源的实时输入数据,进行处理后保存在HDFS、DataBase等。
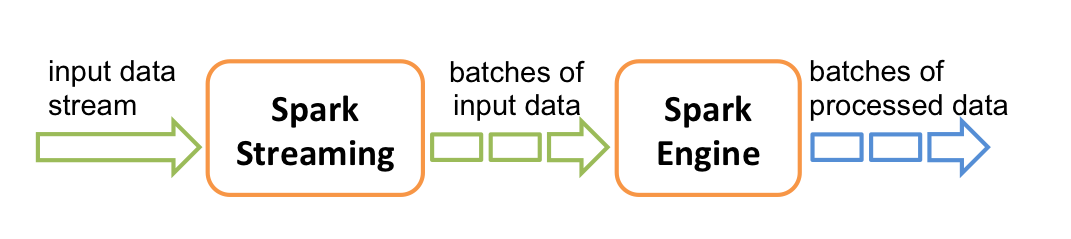
Spark Streaming将接收的实时流数据,按照一定时间间隔,对数据进行批次划分,交给Spark Engine引擎处理,最终得到一批批的结果。
Dstream可以看做一组RDDs,即RDD的一个序列
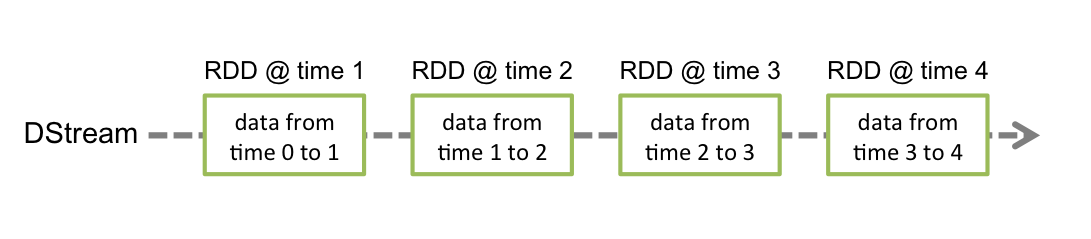
Dstream:Spark Streaming提供了表示连续数据流、高度抽象的被称为离散流的Dstream;
任何对Dstream的操作都会转变为对底层RDD的操作;
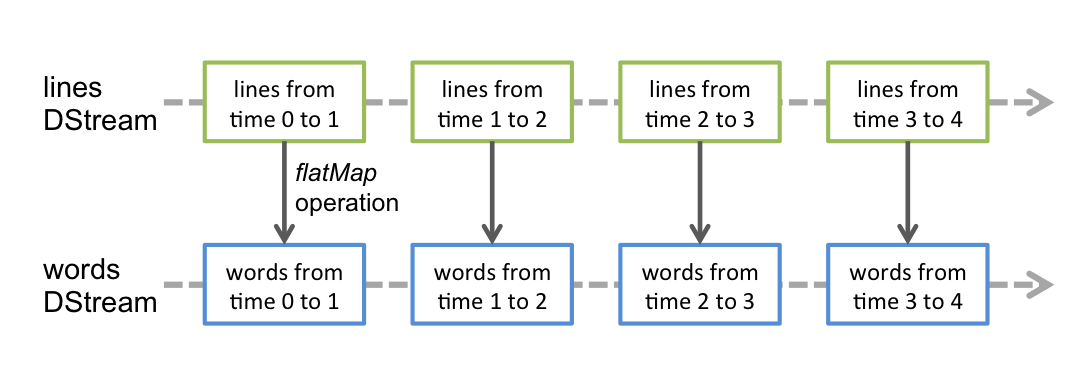
spark streaming任务的两个重要部分

  • 一个静态的 RDD DAG 的模板,来表示处理逻辑;
  • 一个动态的工作控制器,将连续的 streaming data 切分数据片段,并按照模板复制出新的 RDD DAG 的实例,对数据片段进行处理;

我们在考虑的时候,可以认为,RDD 加上 batch 维度就是 DStream,DStream 去掉 batch 维度就是 RDD —— 就像 RDD = DStream at batch T。

Dstream之间的转换所形成的依赖关系全部保存在DstreamGraph中,DstreamGraph简化了DAG scheduler,去除了多余的关系,只保留有用的依赖关系。DstreamGraph是RDD Graph的模板。

整体架构由3个模块组成:

  • Master:记录Dstream之间的依赖关系,并负责任务调度以生成新的RDD
  • Worker:从网络接收数据并存储到executor 执行RDD计算
  • Client:负责向Spark Streaming中传输数据
窗口操作

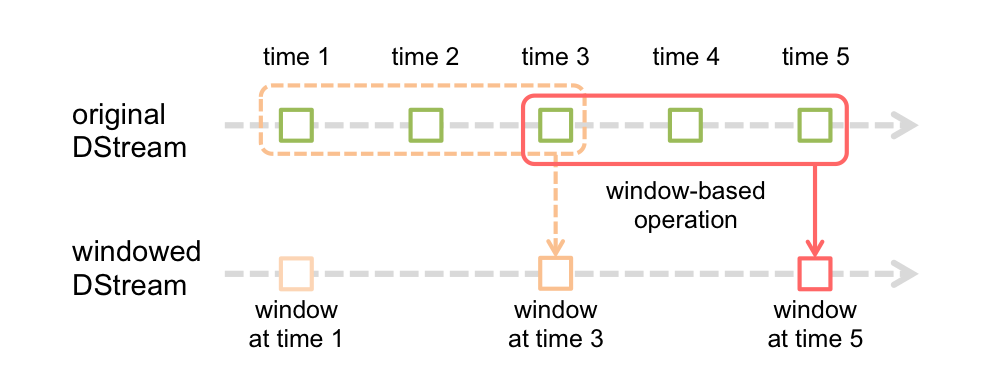
spark提供了一组窗口操作,通过滑动窗口技术对大规模数据的增量更新进行统计分析
Window Operation:定时进行一定时间段内的数据处理
全局统计量

全局统计量需要使用updataStateByKey算子,必须设置一个checkpoint目录,开启checkpoint机制以便在内存数据丢失的情况下可以从checkpoint中恢复数据。

2. 容错性

实时的流式处理系统必须是7*24运行的,同时可以从各种各样的系统错误中恢复,在设计之处,Spark Streaming就支持driver和worker节点的错误恢复。

  • Worker容错:spark和rdd的设计保证了集群中worker节点的容错性。spark streaming构建在spark之上,所以它的worker节点也是同样的容错机制。
  • Driver容错:依赖WAL机制持久化日志
2.1 Write Ahead Logs

WAL使用在文件系统和数据库中用于数据操作的持久性,先把数据写到一个持久化的日志中,然后对数据做操作,如果操作过程中系统挂了,恢复的时候可以重新读取日志文件再次进行操作。
值得注意的是WAL开启了以后会减少Spark Streaming处理数据的吞吐,因为所有接收的数据会被写到容错的文件系统上,这样文件系统的吞吐和网络带宽将成为瓶颈。

启动WAL需要做如下的配置

  1. 给streamingContext设置checkpoint的目录,该目录必须是Hadoop支持的文件系统hdfs,用来保存WAL和做Streaming的checkpoint
  2. spark.streaming.receiver.writeAheadLog.enable 设置为true (只有receiver方式才有WAL机制)

实现细节

下面讲解下WAL的工作原理。过一下Spark Streaming的架构

当一个Spark Streaming应用启动了(例如driver启动), 相应的StreamingContext使用SparkContet去启动receiver,receiver是一个长时间执行的作业,这些接收器接收并保存这些数据到Spark的executor进程的内存中,这些数据的生命周期如下图所示:

  1. 蓝色的箭头表示接收的数据,接收器把数据流打包成块,存储在executor的内存中,如果开启了WAL,将会把数据写入到存在容错文件系统的日志文件中
  2. 青色的箭头表示提醒driver, 接收到的数据块的元信息发送给driver中的StreamingContext, 这些元数据包括:executor内存中数据块的引用ID和日志文件中数据块的偏移信息
  3. 红色箭头表示处理数据,每一个批处理间隔,StreamingContext使用块信息用来生成RDD和jobs. SparkContext执行这些job用于处理executor内存中的数据块
  4. 黄色箭头表示checkpoint这些计算,以便于恢复。流式处理会周期的被checkpoint到文件中

当一个失败的driver重启以后,恢复流程如下

  1. 黄色的箭头用于恢复计算,checkpointed的信息是用于重启driver,重新构造上下文和重启所有的receiver
  2. 青色箭头恢复块元数据信息,所有的块信息对已恢复计算很重要
  3. 重新生成未完成的job(红色箭头),会使用到2恢复的元数据信息
  4. 读取保存在日志中的块(蓝色箭头),当job重新执行的时候,块数据将会直接从日志中读取,
  5. 重发没有确认的数据(紫色的箭头)。缓冲的数据没有写到WAL中去将会被重新发送。
2.2 checkpoint机制

Spark Streaming周期性的把应用数据存储在HDFS/S3这样的可靠存储系统中以供恢复时使用的机制被称为检查点机制

3. Spark Streaming接收数据的两种方式
3.1 Receiver-based Approach

Receiver-based的Kafka读取方式是基于Kafka高阶(high-level) api来实现对Kafka数据的消费。kafka数据流由Receiver来接收,首先读入到executor进程的memory中,开启WAL机制后数据会被预写持久化到日志中(HDFS)。然后将数据块的元信息发送到driver中,同样的,元信息会预写到HDFS中,streaming context会将Dstream Graph和元数据信息相结合转化为一个streaming任务逻辑任务并被checkpoint机制记录在本地文件系统HDFS中以保证容错性。接下来,streaming任务被转化为一个spark context任务,由底层的spark来执行,将spark任务发送到指定的worker上开始运行任务。存储在zookeeper中,由Receiver来维护。当通过WAL机制将数据成功预写到HDFS之后,Receivers会相应更新ZooKeeper的offsets。

3.2 Direct Approach

Direct方式采用Kafka简单的consumer api方式来读取数据,无需经由ZooKeeper,此种方式不再需要Receiver来持续不断读取数据。kafka看做一个底层文件系统,当batch数据的offsetRange(topic、partition、fromOffset、untilOffset)元数据传送给spark driver之后,batch任务被触发,由Executor使用pull模式拉取相应offset range范围的数据,并参与其他Executor的数据计算。offset由kafka自己来维护,driver来决定读取多少offsets,并将offsets交由checkpoints来维护。从此过程可以发现Direct方式无需Receiver读取数据,而是需要计算时再读取数据。

  1. Direct的方式直接操作kafka底层的元数据信息
  2. 由于直接操作的是kafka,kafka相当于底层的文件系统
  3. 由于底层是直接读数据,没有所谓的Receiver,直接是周期性的查询kafka,处理数据的时候,我们会使用基于kafka原生的Consumer api来获取kafka特定offset范围的数据
  4. 读取多少个kafka partition,Spark也会创建相应的RDD的partition。RDD的partition和kafka的partition是一一对应的。
  5. 不需要开启WAL机制,从数据丢失的角度来看,极大地提升了效率,节省磁盘空间。从kafka获取数据,比从hdfs获取数据,速度更快(zero-copy)
3.3 kafka partition和RDD的partition之间的关系

Receiver方式:Topic中partition负载均衡平均分配到读入到consumer group并将partition的数据读入到executor进程中,然后,为每一个partition分配一个或多个task线程

Direct方式:Topic中partition负载均衡平均分配到读入到consumer group。kafka partition和RDD的partition是一一对应关系。每一个partition由一个task线程来执行,相应的partition产生对应的offset,偏移量被记录在ZooKeeper。

Topic每一个partition对应的offset目录为:/consumers/group_test/offsets/badou/0

4. 从容错性角度分析

Receiver:失败的情况下,有些数据很可能会被不止一次的接收。接收的数据通过WAL机制被保存到HDFS中,但是还没来得及更新zookeeper中的对应partition的offset就发生故障,导致数据不一致性。streaming知道数据被接收,但是kafka认为数据没有被接收。当系统恢复正常时,kafka会重新发送这些数据。(at least once)

Direct:给出每个batch范围需要读取的偏移量,每个batch的job被运行时,对应offset range的数据会被拉取,数据处理完成后,offset信息被可靠地存储(checkpoint)。失败后重新恢复时可以直接读取这些偏移量信息。(exactly once)

SparkStreaming的数据源与接口 SparkStreaming的数据源与接口 1. 背景介绍 1.1 大数据实时处理的重要性 在当今大数据时代,海量数据以前所未有的速度不断产生。企业需要对这些实时数据进行快速分析和处理,以便及时洞察业务趋势,优化决策过程。 阅读详情

相关推荐

scala实现 SparkStreaming 实时处理日志写入Kudu

import kafka.serializer.StringDecoder import org.apache.kudu.spark.kudu.KuduContext import org.apache.log4j.Logger import org.apache.spark.sql.SQLContext import org.apache.spark.streaming.kafka.Kafka...

杨鑫newlife的专栏 3743

怎样利用Spark Streaming和Hadoop实现近实时的会话连接

怎样利用Spark Streaming和Hadoop实现近实时的会话连接  [复制链接]     poppowerlb2 13 主题 40 帖子 966 积分 实习版主 积分 966 收听

张伟的专栏 1126

STM32F4实战:手把手教你实现USB OTG双模式切换(Host/Slave)

本文详细介绍了如何在STM32F4上实现USB OTG双模式切换(Host/Slave),包括硬件架构解析、软件实现机制、主机模式下的U盘读写以及从机模式下的自定义设备开发。通过实战案例和优化技巧,帮助开发者快速掌握USB双角色功能,提升嵌入式系统开发的灵活性和效率。

u9v0w的博客 730

spark学习(11)之SparkStreaming实时计算

Spark Streaming基础: Spark Streaming makes it easy to build scalable fault-tolerant streaming applications. Spark Streaming使得大规模容错型的流失计算应用变得十分容易 它的特点: (1)支持多种语言:java scala python sql (2)容易集成:当部署好spark的时候就spark Streaming已经集成了 (3)容错机制:核型数据模型就是DataStream,DataSt

枣泥馅的博客 2063

已解决-Parallels Desktop 16 网络初始化失败:您的虚拟机将继续正常运作,但将无法连接网络

我是月球挖掘机,相信不少打工人为了尝鲜已经更新了MacOS 11 Big Sur,当然,苹果每次的系统大更新,都会给我们软件的功能无法使用惊喜,这次的也不例外。 这个问题是我在更新macOS Big Sur之后,Parallels Desktop打开虚拟机后,提示: 报错信息 网络初始化失败:您的虚拟机将继续正常运作,但将无法连接网络 这是我的软件版本: 起初我以为是我的虚拟机坏了,结果重装了一遍虚拟机,没有任何用处。我开始在网上找方法,只能找到那个使用命令行打开软件的命令,除此之外没有了

月球挖掘机 5万+

计算机组成原理汉字编码与校验设计实验报告(汉字国标码转区位码实验、汉字机内码获取实验、海明编码电路设计与海明解码)

这次实验利用logisim进行设计,进行了以下这四个实验,其中分为汉字国标码转区位码实验、汉字机内码获取实验、海明编码电路设计与海明解码,实验报告分为四个部分,在这四个部分中依次对四个实验的方案设计,设计思路进行了介绍

zhang2gongzi的博客 6万+

Spark Streaming + Kafka构建实时数据流

因为在这个例子中,数据是实时流式处理的,而不是一次处理一个批次的静态数据。流式数据的实时特性意味着数据不断更新,因此很难保持缓存的数据与最新的数据的一致性。所以在流处理中,更有效的性能优化方法是使用更高效的算法,并通过对流数据的精细控制来调整计算中的批大小和触发机制,而不是简单地使用缓存方法。这个是老师根据某个比赛修改了赛题给大伙布置的任务,数据在上面方式可见,想着用java写实在是太麻烦了,改用了spark读取并模拟数据的实时性上传到Kafka,然后用sparkStreaming接收并处理数据。

weixin_63880640的博客 2931

Log4Shell漏洞复现:从原理到实战的完整指南

日志记录是软件开发中用于追踪应用状态和排查问题的关键技术。然而,当日志组件对用户输入进行不当解析时,可能引发严重的安全风险。Log4j2作为Java生态中广泛使用的日志框架,其Lookup功能允许在日志中动态插入变量,这一设计初衷虽为便利,却因递归解析机制埋下了隐患。攻击者通过构造特定的JNDI(Java命名和目录接口)查询字符串,可诱使应用加载并执行远程恶意代码,从而实现远程命令执行。这种漏洞的价值在于其极低的利用门槛和极高的潜在危害,常被用于渗透测试和安全评估中,以验证系统的防御能力。本文以CVE-20

weixin_30496999的博客 275

【spark学习 | sparkstreaming 与kafka】使用sparkstreaming与kafka相结合进行实时处理数据(文件流)

System.err.println("用法: KafkaWordProducer ")// Kafka生产者属性// 文件路径val filePath = "/home/hadoop/bilibili/streaming/data/part2.txt" // 假设数据文件名为 part2.txt// 记录已发送的行数// 等待一段时间再次检查文件是否有新内容// 不会执行到这里,因为循环会一直运行。

个人博客地址为http://elikhb.top/ 672

RK3588芯片:ALSA音频通路下HDMI与耳机自动切换的技术探索

摘要:本文详细探讨了基于RK3588芯片的HDMI与耳机自动切换方案。文章首先剖析了ALSA音频架构的核心组件与工作原理,接着介绍了RK3588芯片的硬件特性及音频处理优势。重点阐述了自动切换的实现原理,包括硬件检测机制、ALSA驱动处理逻辑和软件控制流程,并提供了详细的配置步骤。同时针对常见问题如切换异常、音频质量下降等给出了解决方案。该方案通过合理配置设备树和ALSA文件,实现了音频输出的智能切换,提升了用户体验,展现了RK3588在音频处理领域的强大性能。未来随着AI音频技术的发展,该方案在智能家居、

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 266

5步上手Quartz.NetUI:.NET Core定时任务的开箱即用解决方案

Quartz.NetUI是一个基于.NET Core + Quartz.NET + Vue + IView的开箱即用的定时任务UI解决方案。它结合了Quartz.NET的强大功能和Vue.js的易用性,提供了一个不依赖数据库、只需在界面进行简单配置即可使用的定时任务管理系统。通过上述步骤,你已经学会了如何使用Quartz.NetUI在.NET Core项目中实现定时任务。Quartz.NetUI不仅功能强大,而且使用简单,非常适合那些需要快速实现定时任务管理的开发者。

java专栏 2407

spark大数据工程实战:实时数据流处理

大数据工程实战:实时数据流处理 在/usr/local/flume/conf下新建一个配置文件 streaming_project.conf,配置source、sink、Channel的 各项参数,连接各个组件,其配置内容如下: 第五行是一行!!! exec-memory-kafka.sources = exec-source exec-memory-kafka.sinks = kafka-sink exec-memory-kafka.channels = memory-channel exec-me

m0_48858192的博客 2252

【FPGA教程案例89】编译码2——使用vivado核实现RS信道编译码

RS编码,又称里所码,即Reed-solomon codes,是一种前向纠错的信道编码,对由校正过采样数据所产生的多项式有效。当接收器正确的收到足够的点后,它就可以恢复原来的多项式,即使接收到的多项式上有很多点被噪声干扰失真。

FPGA/MATLAB学习教程/源码/项目合作开发 3540

Kafka+SparkStreaming简单demo

<properties> <scala-version>2.10</scala-version> <spark-version>2.0.2</spark-version> </properties> <dependencies> <dependency> &am

slyang的博客 1846

点云配准3:3d-ndt算法在pcl上的实现以及参数设置

3d-ndt算法在pcl上的使用方法以及参数设置

诺有缸的高飞鸟的博客 7891

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SparkStreaming例题

取材自官网http://Spark.apache.org 案例1:和集群搭配使用 package SparkStreaming import java.io.{BufferedReader, InputStreamReader} import java.net.Socket import java.nio.charset.StandardCharsets import org.apach...

橙以的博客 920

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

SparkStreaming在实时处理的两个场景示例,字节跳动架构师讲解大数据开发开发

TCP环境下,实时监控日志的输出,可用于监控设备状态、环境变化等。当监测到异常情况时,可以实时发出警报。在执行代码前,向创建名为spark_kafka的topic。运行过程中消费的offset会一直被提交到每一个分区。类似消息队列的有redis、kafka等核心组件。本文以kafka为例,向kafka中实时抓取数据,向spark_kafka 主题进行随机推数。此时在数据库中查看,数据已经实时落地到库中。pom.xml中添加以下依赖。创建项目编写以下代码实现功能。

2401_84166794的博客 447

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

流式计算的代表:Storm、Flink、SparkStreaming

目前业内比较知名的大数据流计算框架有Storm、Spark Streaming、Flink,接下来逐一看看它们的架构原理和使用方法。 Storm 其实大数据实时处理的需求很早就存在,那个时候主要使用MQ来实现大数据的实时处理,如果处理起来比较复杂,那么就需要很多个消息队列,将实现不同业务逻辑的生产者和消费者串起来。架构图如下: 图中的消息队列负责完成数据的流转;处理逻辑既是消费者也是生产者,也就...

weixin_44240370的博客 2623

大数据流处理框架:Spark Streaming与Storm

大数据计算的第一代框架Hadoop,是致力于解决离线计算的问题而产生的,在离线批处理上性能优异,但是在实时流处理上,一直被诟病。Hadoop之后,Spark和Storm在流处理上成为对手。今天的大数据入门分享,我们就主要来讲讲,流处理框架Spark Streaming与Storm。 Apache Spark流处理 Spark框架的出现,是在Hadoop MapReduce基础上继承研发而来,本质上来说,还是采用的批处理的思想,但是对于数据计算的中间流程做了优化,由此提升了数据处理效率,得到了比原生的

shuimuzh123的博客 380

SparkStreaming在实时处理的两个场景示例,2024年最新一线互联网架构师筑基必备技能之大数据开发篇

/设置日志等级为ERROR,避免日志增长导致的磁盘膨胀。.setAppName(“spark_kafka”) // 设置应用程序名称。(img-peU9kTJp-1713324083938)]]") // 设置 Spark master 为本地模式,[辄止,不再深入研究,那么很难做到真正的技术提升。// 创建 Spark 配置。// 创建 Spark 配置。]表示使用所有可用核心。

2401_84166458的博客 984

大数据入门:Spark Streaming实际应用

作为Spark负责流计算的核心组件,Spark Streaming是整个Spark学习流程当中非常重要的一块。对于Spark Streaming,作为Spark流计算的实际承载组件,我们也需要更全面的掌握。今天的大数据入门分享,我们就来讲讲Spark Streaming实际应用。 一、关于Spark Streaming 实际上来说,Spark进行数据计算处理,是继承了Hadoop MapReduce的理念,因此从实质定性来说,Spark仍然是一个批处理框架,而非流处理框架。 Spark Strea

shuimuzh123的博客 439

SparkStreaming学习札记2-2020-2-13--SparkStreaming实时流处理项目实战

第9章 Spark Streaming整合Flume 1.Receiver方式整合 1)启动zk ./zkServer.sh start 2)启动Kafka ./kafka-server-start.sh -daemon /home/hadoop/app/kafka_2.11-0.9.0.0/config/server.properties 其中-daemon是指后台运行 3)创建topic ./...

qq_36956082的博客 163

学习大数据的第六天

Spark Streaming是基于Apache Spark的实时流式处理引擎,它可以通过对持续输入的数据进行微批处理的方式来实现低延迟的数据分析和处理。Spark Streaming可以与Hadoop、Kafka、Flume、Twitter、ZeroMQ等多种数据源进行集成,支持广泛的数据操作和转换操作。Tableau 基于直观的拖放界面设计,使得用户可以快速创建交互式和具有仪表盘功能的数据视图,并进行数据可视化和探索。Python语言简洁易读,拥有庞大的社区和生态系统,并支持广泛的库和框架。

GP0000968523的专栏 781

15 | 流式计算的代表:Storm、Flink、Spark Streaming

前面介绍的大数据技术主要是处理、计算存储介质上的大规模数据,这类计算也叫大数据批处理计算。顾名思义,数据是以批为单位进行计算,比如一天的访问日志、历史上所有的订单数据等。这些数据通常通过 HDFS 存储在磁盘上,使用 MapReduce 或者 Spark 这样的批处理大数据计算框架进行计算,一般完成一次计算需要花费几分钟到几小时的时间。此外,还有一种大数据技术,针对实时产生的大规模数据进行即时计算处理,我们比较熟悉的有摄像头采集的实时视频数据、淘宝实时产生的订单数据等。

qq_37756660的博客 753

Spark Streaming初步使用以及工作原理详解

在大数据的各种框架中,hadoop无疑是大数据的主流,但是随着电商企业的发展,hadoop只适用于一些离线数据的处理,无法应对一些实时数据的处理分析,我们需要一些实时计算框架来分析数据。因此出现了很多流式实时计算框架,比如Storm,Spark Streaming,Samaz等框架,本文主要讲解Spark Streaming的工作原理以及如何使用。 一、流式计算 1.什么是流? ...

不清不慎的博客 1万+
上一篇: Yarn集群资源管理
下一篇: 矩阵分解SVD原理
code__online
博客等级 码龄9年 142粉丝 37原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值