大模型 API 总是 429/超时:开发者排查顺序与线路切换建议

Astrbot频繁掉线原因与完整排查指南:从API密钥到WebSocket 聊天机器人服务的稳定性依赖于消息接入、核心调度与模型API之间的链路健康。当机器人响应中断或连接被重置时,问题可能出在API密钥失效、速率限制、网络链路波动、WebSocket长连接断开甚至进程被OOM Killer终止等环节。理解这些底层原理,有助于快速定位故障。结合Astrbot(基于Python的开源聊天机器人框架)的实践,按出现频率从高到低拆解各类掉线原因,并给出3分钟内可执行的排查流程,覆盖curl测试、日志分析、systemd守护与日常维护建议,适用于自部署新手和生产环境开发者。 阅读详情

大模型 API 调用中,429(Too Many Requests) 和 超时 是开发者最常遇到的两种错误。它们经常被误认为是“模型不行”或“渠道挂了”,导致开发者第一反应就是更换 API 服务商或模型。实际上,在盲目切换之前,需要先系统性地定位问题根源,通常可以归结为以下五类:

  • 限流问题:RPM(每分钟请求数)或 TPM(每分钟 Token 数)超限。
  • 并发问题:同时发起的请求数超过服务端限制。
  • 请求过大:单次请求的输入 Token 过多或输出 Token 设置过高。
  • 上游拥塞:模型服务提供方自身负载过高或处理缓慢。
  • 线路异常:网络波动或特定 API 线路不稳定。

为了更直观地展示整个排查流程,下图描绘了从遇到错误到最终解决方案的六步决策路径:
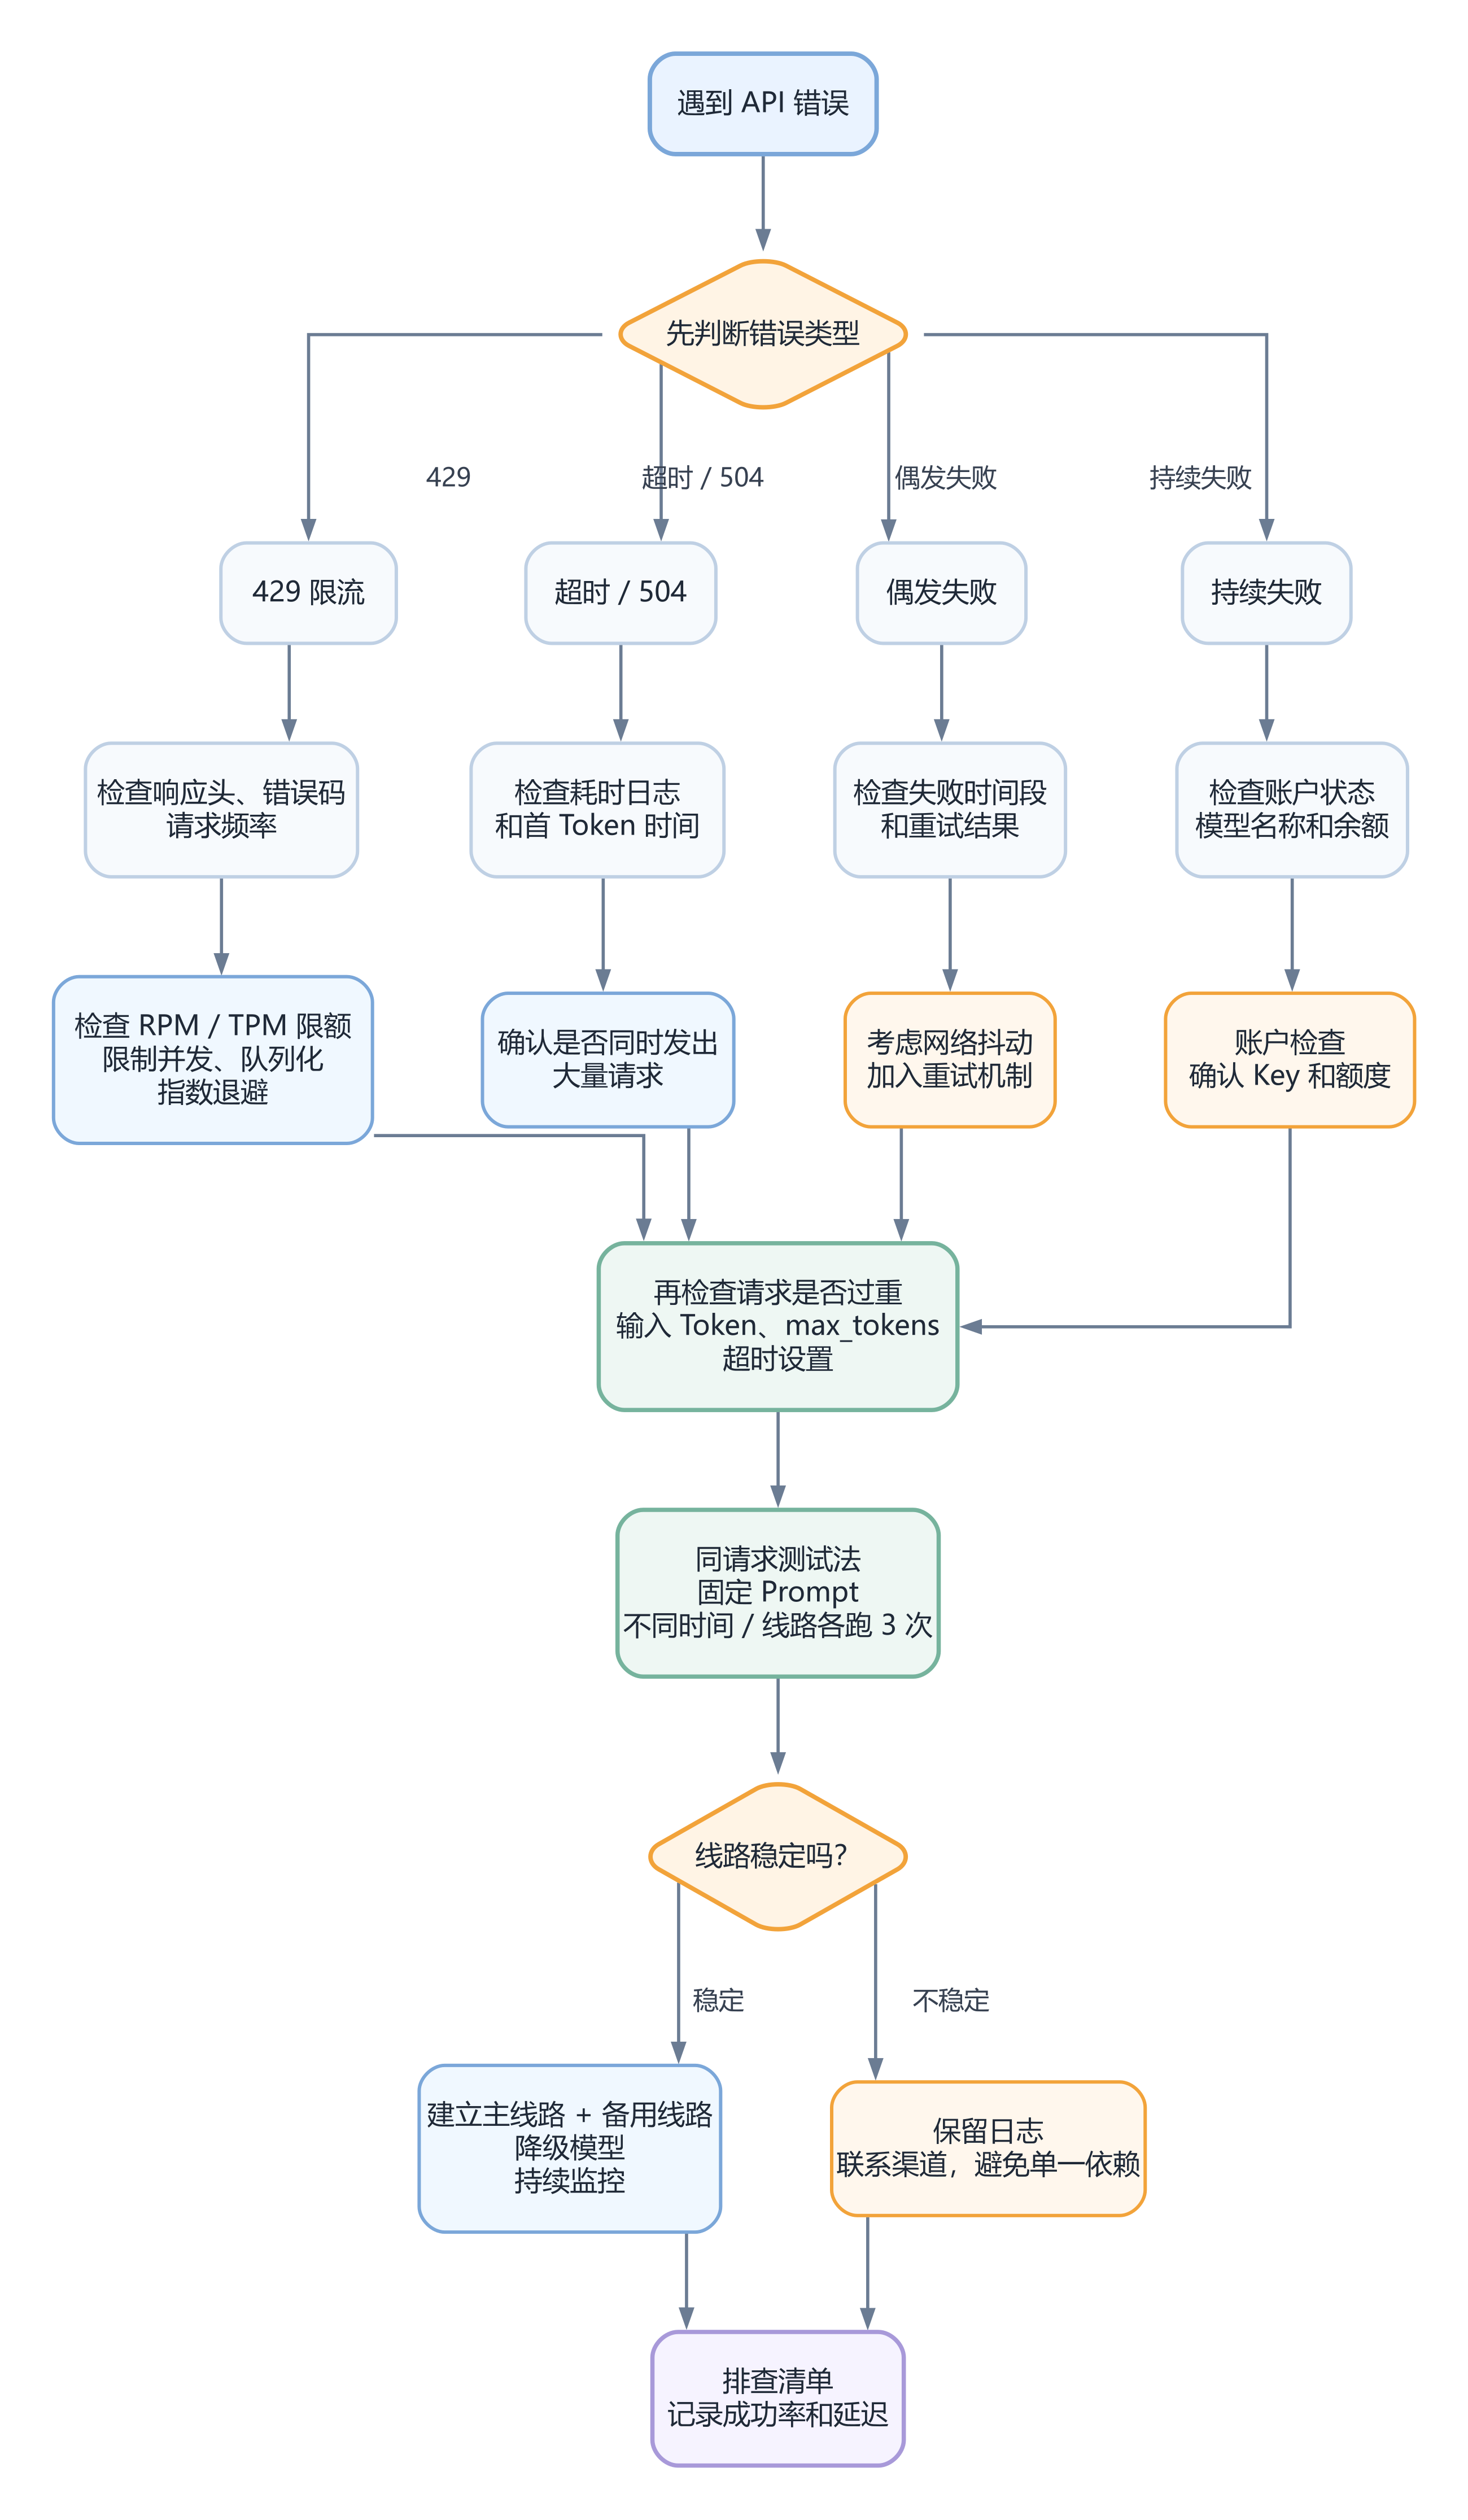
第一步:区分 429 与超时

在动手排查之前,首先要准确区分错误类型。不同错误往往指向不同的根因,可以借助下表快速判断:

现象优先怀疑先看什么
429 Too Many RequestsRPM/TPM 限流、并发超限响应头、错误码、请求频率
504/超时上游拥塞、线路波动、请求过长耗时日志、首 Token 时间
偶发失败网络或单线路抖动失败时间段、重试结果
持续失败Key、额度、模型权限账户状态、模型名称、余额

第二步:先查自己有没有把限额打满

很多 429 其实源于开发者无意中“打满”了 API 的配额。建议在日常调用中记录以下指标:请求数、并发数、输入 Token、输出 Token 和失败率。例如,批量处理文档时,10 个任务同时发出,每个任务又携带很长的上下文,很容易同时撞上 RPM 和 TPM 两重限制。实操上可以采取以下动作:

  • 限制并发:通过信号量或任务队列控制同时发出的请求数。
  • 队列化:将请求放入消息队列,由消费者按固定速率消费。
  • 指数退避重试:遇到 429 后,等待 1s、2s、4s 再重试,避免雪崩。
  • 拆分长上下文:将超长文档切分为多个片段,分批次请求。

第三步:看请求本身是否过重

超时不一定是接口慢,也可能是请求太重。在排查时,需要检查以下几点:

  • 单次输入是否塞入了整篇文档,导致 Token 数量巨大。
  • max_tokens 是否设得过高,导致生成时间过长。
  • 是否同时要求长输出、工具调用、复杂推理,增加了服务端负担。
  • 是否没有设置合理的超时和重试机制。

下面是一段简短的伪代码,展示 timeout + retry + backoff 的基本逻辑:

import time
import random

def call_with_retry(max_retries=3, timeout=30):
    for attempt in range(max_retries):
        try:
            response = api_call(timeout=timeout)
            return response
        except TimeoutError:
            if attempt == max_retries - 1:
                raise
            wait = (2 ** attempt) + random.uniform(0, 1)
            time.sleep(wait)

第四步:判断是模型问题还是线路问题

固定同一段 Prompt、同一参数,在不同时间和不同线路各跑 3 次,记录以下指标:首 Token 时间、总耗时、成功率、报错率。单次快慢没有意义,连续结果才能判断线路稳定性。如果某条线路在多次测试中波动明显,就可以考虑将其标记为备用或切换。

第五步:建立“主线路 + 备用线路”

建议构建一套可执行的策略:

  • 主线路:日常稳定调用,经过连续测试验证延迟和成功率达标。
  • 备用线路:当主线路连续失败或延迟超过阈值时自动切换。
  • 降级模型:非核心任务自动切换到更低成本模型,保障主流程的可用性。
  • 监控:按模型、线路、错误码记录调用情况,形成可追踪的监控面板。

在接入或切换线路前,我会先在 Oken 核对模型价格、可用线路、延迟表现、模型一致性和 Token 消耗,避免只按“低价”选渠道,从而保证切换后的服务质量和成本可控。

第六步:排查后仍不稳定怎么办

如果经过以上五步的系统性排查,问题依然频繁出现(例如,每天仍有超过 5% 的请求失败),说明可能触及了更深层的瓶颈或存在系统性风险。此时不应再局限于单次调优,而需要启动“升级处理”流程,从架构和运维层面寻求根本解决。

建议按以下路径逐步升级:

  1. 深度日志分析与根因定位
    • 集中收集并分析故障时间段的完整请求日志,包括请求体大小、响应头、错误详情、网络延迟等。
    • 使用 APM(应用性能监控)工具或自定义仪表板,关联错误率与业务高峰、部署变更、上游服务状态。
    • 尝试复现问题:在低峰期用相同参数重放请求,判断是偶发性还是持续性故障。
  2. 正式升级至服务商/渠道支持
    • 准备一份清晰的故障报告,包含:request_id、模型名称、具体 API 端点、时间戳(精确到秒)、错误码与信息、请求耗时、以及你已尝试的排查步骤(如调整并发、拆分请求等)。
    • 如果使用的是聚合平台(如 Oken),优先通过其工单系统提交,平台方通常能更快协调上游。
    • 明确询问:是否为区域性故障、是否有已知的限流策略调整、该模型/线路的当前容量状况。
  3. 架构级容灾与降级方案
    • 多路负载均衡:接入 2-3 家不同服务商或线路,并实现基于健康检查的自动切换。
    • 业务分级与降级:将核心业务与非核心业务隔离。核心业务使用高可靠线路(主+备),非核心或可异步任务使用成本更优的线路,并在主线路故障时自动降级。
    • 队列与异步化:对于非实时性要求高的场景,将请求放入消息队列,由后台 worker 按可控速率处理,避免瞬时冲击 API 限额。
    • 本地缓存与模型蒸馏:对频繁使用的、结果相对固定的提示词(Prompt)结果进行缓存。对于简单任务,考虑使用小型化模型(模型蒸馏)在本地或边缘运行,减少对大模型 API 的依赖。
  4. 建立长期监控与告警机制
    • 定义关键 SLO(服务等级目标),例如:API 成功率 > 99.5%,P95 延迟 < 10s。
    • 设置自动化告警:当错误率或延迟连续超过阈值时,立即通知运维或开发人员。
    • 定期(如每周)回顾监控面板,分析趋势,提前预判容量瓶颈。

核心原则:稳定性不是“找到最便宜的渠道”,而是构建一套包含监控、诊断、切换、降级的完整韧性体系。当单点故障无法避免时,系统的整体可用性不应受到影响。

排查清单

最后,将排查流程整理为一张可视化流程图,方便快速对照执行:
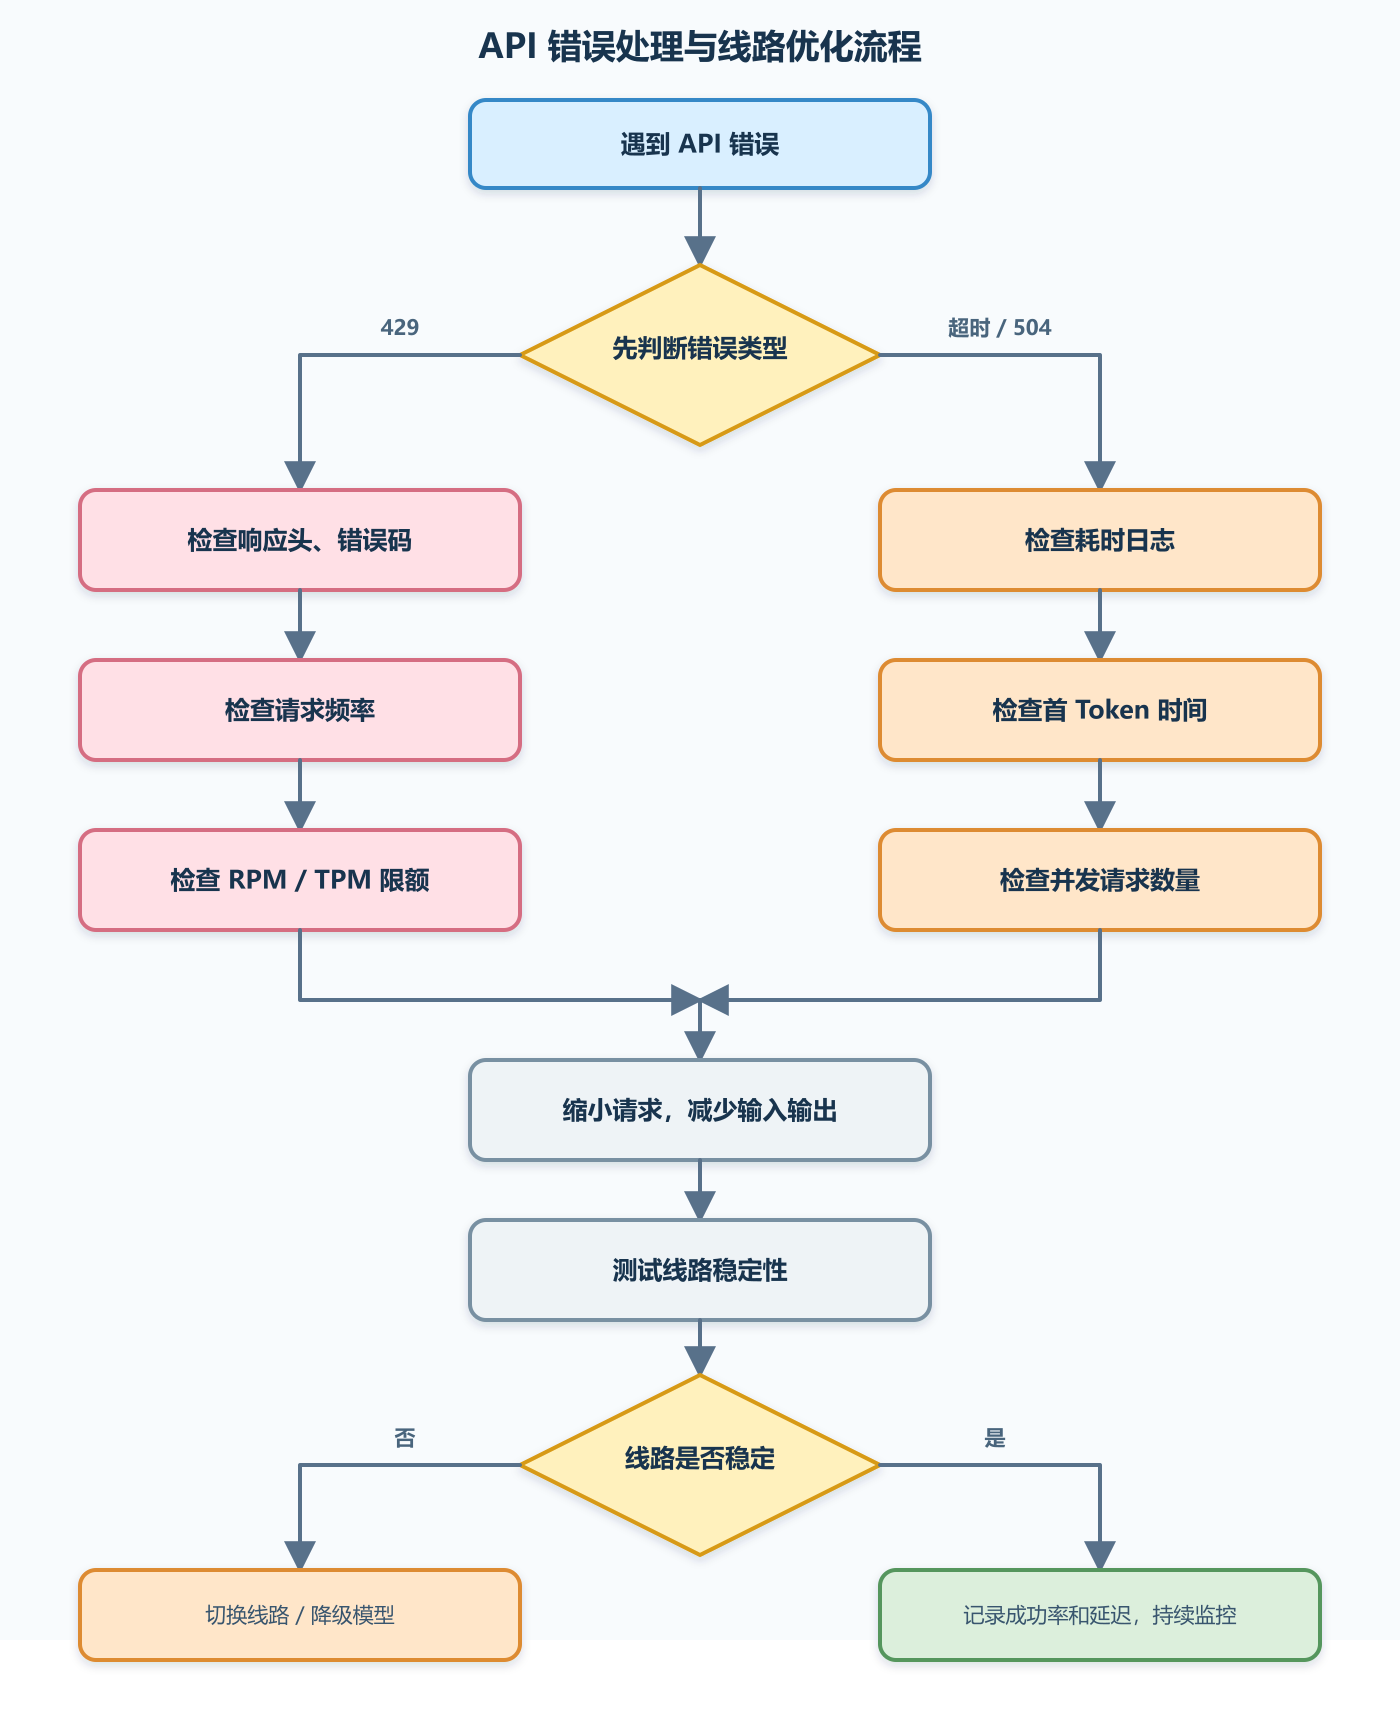
稳定性不是"换到最便宜的渠道",而是把限流、请求体、线路和降级策略都放进同一套监控里。

企业级AI网关架构设计:统一大模型API调用与高可用实践 在微服务架构中,API网关作为统一的流量入口,负责路由、认证、限流和监控,是构建可扩展系统的关键组件。其核心原理是通过反向代理和中间件链,对请求进行预处理和后处理,从而解耦客户端与后端服务。在AI技术普及的当下,面对OpenAI、Claude、Llama等众多大模型API接口各异、计费方式不一、管理复杂的挑战,API网关模式演进为AI网关,其技术价值在于实现异构模型服务的统一接入与智能调度。通过引入策略路由、协议适配和分布式限流熔断等机制,AI网关能有效管控成本、保障安全合规、提升系统稳定性,并避免供应商锁 阅读详情

相关推荐

OpenAI API实战指南:从参数解析到生产级调用与成本优化

大语言模型(LLM)通过API接口为开发者提供了强大的自然语言处理能力,其核心原理是基于海量数据训练的Transformer架构,能够理解和生成类人文本。在工程实践中,高效调用API是实现其技术价值的关键,这涉及到对核心请求参数的深入理解,例如通过`temperature`和`top_p`控制生成文本的随机性与创造性,利用`max_tokens`管理输出长度以优化成本。这些技术广泛应用于构建智能对话系统、内容生成工具和代码辅助应用。本文聚焦于**OpenAI API**的**实战应用**,旨在解决开发者在集

dechen6073的博客 400

Trae 接入硅基流动 SiliconFlow 调用 GLM-5.2 完整攻略

添加模型 → 服务商选择【OpenAI】模型 ID:zai-org/GLM-5.2填入硅基流动 API 密钥,保存即可。

websites_026的专栏 1423

免费搭建AI编程助手:Codex+DeepSeek+CC Switch完整部署指南

你是不是也遇到过这样的困境:想用AI编程助手提升开发效率,但要么需要付费订阅国外服务,要么本地部署门槛太高,要么配置过程复杂到让人望而却步?如果你正在寻找一个免费、易用、功能强大且能接入国产顶尖大模型的代码助手,那么这篇文章就是为你准备的。 今天我们要聊的,就是如何将 Codex 与 DeepSeek 大模型结合起来,打造一个属于你自己的、无需付费订阅的AI编程伙伴。这不仅仅是“安装一个软件”,而是解决一个核心痛点: 如何低成本、低门槛地获得一个稳定、高效的代码生成与对话能力 。 很多人可能听说过Codex

weixin_30700977的博客 483

API接口调用读取超时(read time out)问题 - 解决思路和步骤(AI问答)

API接口调用读取超时(read time out)问题 - 解决思路和步骤 # 问题描述 一个后端应用,调用另一个应用的API接口获取数据,报错为`读取超时(read time out)`;实际测试下来,接口请求花费时间约`9分钟`;接口的想用的数据量约为`一万多条`。

宋冠巡的博客 1万+

AI Gateway核心解析:路由、防护与计费实战

随着大模型API的广泛接入,企业级应用需要一个统一的中间层来管理模型调用。AI Gateway作为基础设施,通过路由(route)机制实现模型别名到多上游的智能映射与故障转移;防护(guard)层提供API Key认证、限流、内容安全等统一策略;计费(charge)层则精确计量Token用量与成本。这种设计将模型选择、安全管控和成本核算从业务代码中抽离,使团队可以灵活切换模型、隔离租户配额、监控预算异常。在生产环境中,AI Gateway能有效解决多厂商API管理混乱、成本不可见、权限不统一等痛点。本文以Z

weixin_33951761的博客 433

智谱AI批量文生图工程化实践:稳定日均300+张的四层架构

文生图批量生成并非简单循环调用API,而是涉及请求调度、限流应对、错误恢复与结果治理的系统性工程问题。理解API速率限制机制(如X-RateLimit-Remaining)、动态并发控制原理(基于RTT与处理时延的利特尔法则)及credits消耗模型,是保障高成功率批量产出的技术基础。结合智谱AI平台特性,需构建包含API封装、异步调度、分级重试与结构化存储的四层落地架构,才能将‘能跑’升级为‘稳产’。本文聚焦真实业务中高频出现的429限流、prompt失真、credits突增等典型问题,提供可复用的参数阈

dengwan3818的博客 362

Trae告别排队等待(保姆级教程)

本文介绍如何通过硅基流动模型接入Trae AI来提升编程效率。首先需注册硅基流动账号并获取16元免费额度,随后申请API密钥。在Trae中添加硅基流动作为服务商,选择模型并绑定API密钥。配置完成后即可享受无需排队、快速响应的AI编程体验,支持完整推理功能,显著提升开发效率。该方法特别适合解决Trae高峰期排队问题,且能充分利用免费资源。

CoderClub的博客 1387

Ox Alpha 三天消耗 11.6T tokens?OpenRouter 模型接入与 token 优化全指南

大模型API调用正成为 AI 工程实践的核心环节,而 token 消耗与计费则是开发者最关心的成本指标。OpenRouter 作为聚合多模型的 API 平台,一个 Key 即可调用多家模型,并统一提供 token 用量和费用明细。TPM(每分钟 token 数)决定了并发任务的限流边界,掌握其计算方式能有效规避 429 错误。在 AI 编程、批量文本处理等场景中,模型接入与成本优化直接影响项目效率。本文以 Ox Alpha 为例,它曾在 OpenRouter 上三天处理 11.6T tokens,创下平台纪

weixin_30265103的博客 384

Obsidian Copilot错误排查终极指南:10个快速解决429配额不足和token限制问题的方法

Obsidian Copilot是一款强大的AI辅助工具,能显著提升Obsidian笔记使用体验。但在使用过程中,用户常遇到429配额不足和token限制等常见问题。本指南将提供10个实用方法,帮助您快速解决这些难题,确保Obsidian Copilot流畅运行。 ## 一、快速诊断:识别429错误和token限制的常见表现 当您在使用Obsidian Copilot时遇到以下情况,可能是42

gitblog_01132的博客 942

ComfyUI集成LLM:AI绘画提示词自动生成与智能创作工作流搭建

在AI绘画领域,提示词工程是连接创意与生成结果的核心技术。其原理在于通过自然语言描述,精准引导扩散模型合成目标图像。传统的提示词编写依赖人工经验,存在门槛高、效率低的问题。结合大语言模型(LLM)的理解与生成能力,可以实现提示词的自动化、智能化构建,极大提升了创作效率并降低了技术门槛。这一技术融合方案在概念设计、灵感激发、批量内容生成等应用场景中价值显著。本文以ComfyUI为平台,详细解析如何集成Kimi等LLM模型,构建一套动态、可对话的智能创作工作流,实现从自然语言描述到高质量图像生成的自动化流水线,

cique2620的博客 315

LLM网关架构设计与生产化实践:流量治理与成本控制关键权衡

API网关作为微服务架构中的流量调度与控制层,在AI工程实践中被进一步演化为面向大模型场景的LLM网关。它并非模型推理服务,而是统一模型接入、路由转发、负载均衡、限流熔断、缓存与成本统计的基础设施组件。当业务从原型走向生产,模型调用的碎片化、稳定性缺失、成本失控与密钥安全等问题集中暴露,网关便成为解决流量治理与系统韧性的核心环节。其架构设计需严格分离数据平面与控制平面,优先保证无状态、可水平扩展,并兼容OpenAI Chat Completions协议以适配主流生态。同时,在缓存命中率与语义灵活性、同步转发

weixin_34218579的博客 514

Claude Code 换模型后请求报错:Base URL 与 Key 的排查顺序

TaoToken 提供一站式大模型 API 接入,支持 Claude Code 等主流工具快速配置,官网 taoToken.com 可查最新接入文档与密钥管理方案。近期开发者关注多模型统一调用与成本优化,TaoToken 以稳定中转与透明计费帮助团队高效落地 AI 应用。

SapphireFox89的博客 52

5G NR LDPC码(2)—— 从基图到速率匹配:解码5G高速数据信道的标准化设计

本文深入解析了5G NR LDPC码的标准化设计流程。从作为核心骨架的基图(BG1/BG2)出发,详细阐述了其如何通过扩展因子Z灵活生成实际校验矩阵,并协同传输块大小计算与分段策略。文章重点剖析了基于循环缓存和冗余版本的速率匹配机制,以及其如何高效支撑增量冗余混合自动重传请求,从而确保5G高速数据信道在复杂环境下的可靠与高效传输。

weixin_29206669的博客 274

智能语音外呼大模型端到端优化实践:TaoToken 统一 Key 接入配置与验证

智能语音外呼大模型端到端优化,用 TaoToken 统一 Key 收敛 LLM 调用通道。本文给出 settings.json 与 config.toml 配置骨架,并用 curl 流式请求验证首 token 延迟与成功率,把感知时延压进 800ms 预算。接入见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35750747的博客 228

AD9361 官方例程

文章目录一、官方资料1.1 介绍1.2 下载 和 使用1.3 相关资料二、步骤2.1 在Vivado中构建HDL2.2 在SDK中构建No- OS总结 一、官方资料 1.1 介绍 HDL参考设计介绍:AD9361 HDL Reference Designs 无操作系统介绍:AD9361 No-OS Software 1.2 下载 和 使用 HDL下载:Download HDL 在Vivado中构建HDL:Building HDL No-OS下载:Download No-OS 1.3 相关资料 AD

weixin_44630490的博客 3万+

Playwright与MCP协议结合:AI驱动的智能Web自动化测试实践

Web自动化测试是现代软件开发流程中保障产品质量的关键环节,其核心原理是通过程序模拟用户操作,对Web应用进行功能验证。传统自动化测试工具如Selenium和Playwright虽然提供了强大的API,但脚本编写和维护仍需较高的编程技能。随着AI技术的发展,智能测试成为新的趋势,它通过自然语言理解和自动化执行,显著降低了测试创建门槛。Model Context Protocol(MCP)作为一种连接AI模型与外部工具的开放协议,为自动化测试带来了“智能大脑”。通过将MCP与Playwright结合,测试人员

aoe41606的博客 607

Claude API调用实战:官方接口与国内中转服务技术选型指南

API调用是现代应用开发中的核心技术,通过标准化的接口实现系统间数据交互。其原理基于HTTP协议,采用RESTful架构实现资源的增删改查操作。在AI大模型应用场景中,API调用技术价值体现在降低开发门槛、提升集成效率。特别是面对Claude等国际大模型服务时,开发者常遇到网络连接稳定性挑战,如连接超时、DNS解析异常等典型问题。错误处理机制和重试策略成为工程实践的关键,需要实现指数退避算法和故障转移方案。国内API中转服务通过多线路负载均衡、连接复用等技术优化网络路径,显著提升服务可用性。无论是个人学习还

weixin_30715523的博客 358

MIC卡的OFED驱动安装

 IB网络和OFED驱动安装 IB InfiniBand是一个统一的互联结构,可以处理存储I/O、网络I/O和进程间通信(IPC)。它可以将磁盘阵列、SANs、LANs、服务器和集群服务器进行互联,也可以连接外部网络(比如WAN、VPN、互联网)。设计InfiniBand的目的主要是用于企业数据中心,大型的或小型的。目标主要是实现高的可靠性、可用性、可扩展性和高的性能。Inf

beglorious的专栏 5108

OpenRouter API 接入实战:从零到生产环境的多模型集成指南

大语言模型(LLM)API 已成为现代应用实现智能交互的核心技术。其原理是通过统一的编程接口,将用户请求转化为模型可理解的指令,并返回结构化的文本生成结果。这项技术的核心价值在于,它让开发者无需自建复杂的 AI 基础设施,就能快速为产品注入对话、创作、分析等高级能力,广泛应用于智能客服、内容生成、代码辅助等场景。在实际工程实践中,面对众多模型供应商带来的接口碎片化、密钥管理复杂和网络访问差异等挑战,开发者需要一个高效的解决方案。OpenRouter 作为聚合了 GPT-4、Claude 等主流模型的 **A

weixin_30458043的博客 280

无人机VS地面机器人:用AirSim和Gazebo玩转ROS2仿真的5个实战场景对比

本文深度对比了ROS2生态中两大仿真工具AirSim和Gazebo在无人机与地面机器人应用中的表现。通过电力巡检、仓库调度、SLAM建图等5个实战场景,分析了两者在视觉保真度、物理精度、开发效率等方面的差异,并提供了跨平台协作的实用技巧,帮助开发者根据项目需求选择合适的仿真工具。

flink9streamer的博客 900

从涡流求解器到瞬态场:Maxwell 3D里无线充电仿真,选对求解器能省一半计算时间

本文深入探讨了Maxwell 3D在无线充电仿真中涡流求解器与瞬态求解器的选择策略,帮助工程师优化计算效率与精度。通过对比分析两种求解器的适用场景、性能差异及实战技巧,揭示如何根据频率特性、材料非线性和动态过程需求做出精准选择,可节省高达50%的计算时间。特别针对3D线圈模型的无线充电系统设计提供了专业建议。

weixin_26861329的博客 233

UART+SDK+API:AI玩具从机芯到云端的全链路对接

UART串口通信是嵌入式设备与上位机交互的基础物理层协议,其低开销、高实时性特点使其在资源受限的AI玩具机芯中不可替代;SDK作为硬件抽象层,封装了寄存器操作、流控管理与帧校验等底层细节,解决MCU碎片化问题;API则承担协议转换、安全鉴权与云端协同职能,规避直连导致的断网失效、密钥泄露与负载过载。三者构成‘硬件→边缘→云’的典型物联网数据通路,广泛应用于儿童教育机器人、智能陪伴终端等AIoT场景。本文聚焦UART协议设计、SDK跨平台集成与API签名验证等产线级实操要点,覆盖CH340驱动异常、400 i

weixin_33868027的博客 148

《派出你的AI同事:WorkBuddy案例实战》062:投研资讯摘要与预警

投研资讯摘要与预警:新闻、公告、行情交给 AI 同事提炼与预警,投研从“刷资讯”变成“读摘要”。

LuckyHanMo的博客 187

LLM网关生产化落地:架构权衡、流式转发与成本治理

在大模型应用规模扩张的过程中,直接调用SDK的方式很快会遇到瓶颈:模型供应商协议不一、路由策略分散、token成本难以分摊、故障回退缺乏统一机制。LLM网关作为模型接入的治理层,将路由、安全、观测、限流与计量从业务代码中剥离,沉淀为平台通用能力,让业务方以简易方式调用模型,同时让平台方获得全局控制力。本文从网关的职责边界出发,分析单网关与多网关、状态外置与无状态设计等关键权衡,给出最小可用的路由与回退实现,深入流式转发中的连接生命周期与超时分层策略,并重点讨论可观测性中的token计量、成本分摊及告警体系。

weixin_34343308的博客 275

VMware Horizon 8 2111 部署系列(九)创建即时克隆桌面池

即时克隆桌面池是在 vCenter Server 中使用 vmFork 技术(称为即时克隆 API)从最佳配置映像创建的自动桌面池。即时克隆共享同一个基础映像虚拟机,使用基础映像虚拟机的快照创建的,它使用的存储空间也少于完整虚拟机。 即时克隆始终保持开机状态,并在注销后从当前发布的映像重新创建。...

白昼的技术专栏 4047

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

上一篇: AI 工具选型:豆包、WorkBuddy、Codex 与 Hermes 实践
oken.ai
博客等级 码龄175天 0粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值